
Last chance! 50% off DataCamp Premium
Sale ends in
सांख्यिकी में केन्द्रीय प्रवृत्ति एक अत्यंत महत्वपूर्ण अवधारणा है, जो उस सामान्य मान का वर्णन करती है जिसके आसपास डेटा समूहित होने की प्रवृत्ति रखता है। यह पूरे डेटासेट का सार प्रस्तुत करने वाला एक एकल, प्रतिनिधि संख्या प्रदान करता है, जिससे विशाल जानकारी को समझना और तुलना करना आसान हो जाता है।
ऐतिहासिक रूप से, “केंद्रीय मान” का विचार सदियों में विकसित हुआ है। प्राचीन विद्वान, जैसे यूनानी, साधारण औसत पर विचार करते थे, जबकि 17वीं और 18वीं शताब्दी के गणितज्ञों ने औसत (mean), माध्यिका (median), और बहुलक (mode) को औपचारिक सांख्यिकीय उपकरणों के रूप में स्थापित किया। 20वीं शताब्दी में और परिष्कार आया, जिसमें झुके हुए (skewed) या अपवादों (outliers) से प्रभावित डेटा के लिए विशिष्ट माप प्रस्तुत किए गए। आज, सामाजिक विज्ञान और अर्थशास्त्र से लेकर इंजीनियरिंग और मशीन लर्निंग तक, केन्द्रीय प्रवृत्ति व्यापक क्षेत्रों में अत्यंत महत्वपूर्ण है।
रूपांतरों पर जाने से पहले, कुछ शब्दावली की समीक्षा कर लेते हैं। इस विषय और अन्य बातों पर और निकट व व्यापक दृष्टि के लिए, हमारे Introduction to Statistics कोर्स में नामांकन करें।
केन्द्रीय प्रवृत्ति उस सांख्यिकीय माप को संदर्भित करती है जो किसी डेटासेट के भीतर एक केंद्रीय बिंदु की पहचान करती है। यह एक सार-सांख्य (summary statistic) के रूप में काम करती है, यह दर्शाते हुए कि वितरण में अधिकांश मान कहाँ समूहित होने की प्रवृत्ति रखते हैं। एक एकल, प्रतिनिधि मान प्रदान करके, यह कच्चे डेटा में निहित जटिल परिवर्तनशीलता को सरल बनाती है।
केन्द्रीय प्रवृत्ति का एक प्रमुख उद्देश्य डेटासेट्स के बीच तुलना सक्षम करना है। उदाहरण के लिए, केन्द्रीय मापों का उपयोग करके, हम शहरों के बीच औसत आय की तुलना कर सकते हैं और सामाजिक-आर्थिक पैटर्न को शीघ्रता से उजागर कर सकते हैं। महत्त्वपूर्ण रूप से, केन्द्रीय प्रवृत्ति प्रसरण (dispersion) के मापों से भिन्न है, जो यह बताते हैं कि डेटा केंद्र के आसपास कैसे फैला है। जहाँ औसत या माध्यिका यह दर्शाते हैं कि डेटा का केंद्र कहाँ है, वहीं प्रसरण और मानक विचलन जैसे माप यह प्रकट करते हैं कि डेटा उस केंद्र के आसपास कितना कसा हुआ या ढीला बंटा है।
वर्णनात्मक सांख्यिकी में, केन्द्रीय प्रवृत्ति का उपयोग बड़े डेटासेट्स का प्रभावी सार प्रस्तुत करने के लिए किया जाता है। चाहे परीक्षा अंकों, उत्पादन समय, या ग्राहक रेटिंग्स का विश्लेषण हो, सामान्य मान जानना रुझानों की व्याख्या के लिए अमूल्य है।
केन्द्रीय प्रवृत्ति का परिवर्तनशीलता के मापों के साथ घनिष्ठ अंतःक्रिया होती है। उदाहरण के लिए, दो डेटासेट्स का औसत समान हो सकता है लेकिन फैलाव में बहुत भिन्नता हो सकती है, जो यह प्रभावित करती है कि सार-सांख्य के रूप में वह औसत वास्तव में कितना विश्वसनीय है।
वास्तविक दुनिया के परिदृश्यों में, केन्द्रीय प्रवृत्ति नीतिनिर्माताओं, व्यावसायिक नेताओं, और शोधकर्ताओं को प्रतिनिधि मूल्यों के आधार पर निर्णय लेने में मदद करती है। एक रिटेलर औसत बिक्री का विश्लेषण कर इन्वेंटरी रणनीतियाँ विकसित कर सकता है, जबकि एक स्वास्थ्य शोधकर्ता उपचार की प्रभावशीलता का आकलन करने के लिए माध्यिक जीवित रहने के समय की जाँच कर सकता है।
उपयुक्त केन्द्रीय प्रवृत्ति के माप का चयन काफी हद तक डेटा के प्रकार पर निर्भर करता है। डेटा चार व्यापक श्रेणियों में आते हैं:
प्रत्येक प्रकार के डेटा के लिए सबसे उपयुक्त केन्द्रीय प्रवृत्ति के माप इस प्रकार हैं:
उदाहरण के लिए, घरेलू आय की माध्यिका अक्सर रिपोर्ट की जाती है क्योंकि आय का डेटा अत्यधिक उच्च कमाई करने वालों के कारण झुका हुआ होता है, जबकि मानव कद की सामान्य वितरण वाली ऊँचाइयों के लिए औसत उपयुक्त है।
केन्द्रीय प्रवृत्ति के तीन प्राथमिक माप हैं: अंकगणितीय औसत, माध्यिका और बहुलक। आइए प्रत्येक पर विचार करें, विशेषकर उनकी ताकत और सीमाओं पर ध्यान देते हुए।
अंकगणितीय औसत, जिसे अक्सर सरलतः औसत या mean कहा जाता है, डेटासेट के सभी मानों का योग कर प्रेक्षणों की संख्या से भाग देकर निकाला जाता है:
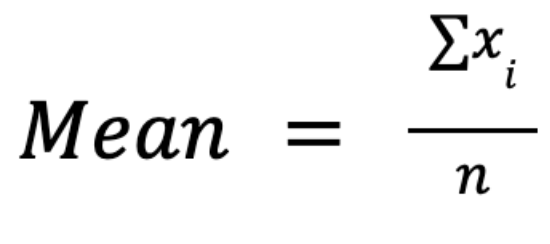
इस माप का मुख्य लाभ इसके गणितीय गुण हैं: यह बीजगणितीय रूप से प्रबंधनीय है, जिससे अनुमेय सांख्यिकी, परिकल्पना परीक्षण, और प्रतिगमन विश्लेषण में सुंदर सूत्रीकरण संभव होते हैं। उदाहरण के लिए, यह प्रसरण और मानक विचलन की गणनाओं में सहजता से समाहित हो जाता है।
हालाँकि, औसत अपवाद मानों के प्रति अत्यधिक संवेदनशील है: कुछ अत्यधिक मान इसे काफी विकृत कर सकते हैं, जिससे यह झुके हुए वितरणों के लिए प्रतिनिधिक नहीं रहता। उदाहरण के लिए, आय डेटा में, कुछ अरबपति औसत को अधिकांश लोगों की कमाई से कहीं ऊपर ले जा सकते हैं।
औसत की बात करते समय, जनसंख्या औसत (μ) और नमूना औसत (x̄) में अंतर करना महत्त्वपूर्ण है। पहला पूरे जनसंख्या का वर्णन करता है, जबकि दूसरा उसके एक उपसमुच्चय से उसका आकलन करता है। पूरी जनसंख्या के बारे में निष्कर्ष निकालने के लिए हम डेटा के एक नमूने से statistical inference नामक प्रक्रिया का उपयोग करते हैं।
वे परिस्थितियाँ जहाँ औसत का उपयोग नहीं करना चाहिए, उनमें अत्यधिक झुके हुए वितरण, महत्वपूर्ण अपवाद मानों वाला डेटा, या क्रमबद्ध (ordinal) डेटा शामिल हैं, जहाँ रैंकों का औसत निकालना व्यावहारिक अर्थ नहीं रखता।
माध्यिका किसी क्रमबद्ध डेटासेट के मध्य मान का प्रतिनिधित्व करती है। मानों की संख्या विषम होने पर यह एकल मध्य मान होता है। सम संख्या होने पर मध्य के दो मानों का औसत लिया जाता है।
माध्यिका की गणना के लिए, हमें:
माध्यिका की प्रमुख मजबूती इसकी अपवादों के प्रति स्थिरता है: वितरण के किसी भी सिरे पर चरम मान इसका मान प्रभावित नहीं करते, जिससे यह आय या संपत्ति कीमतों जैसे झुके हुए डेटा के लिए आदर्श है।
हालाँकि, माध्यिका गणितीय रूप से औसत की तुलना में कम प्रबंधनीय है। जटिल सांख्यिकीय सूत्रों या मॉडलिंग में यह कम उपयोगी है और बीजगणितीय हेरफेर में सहजता से समाहित नहीं होती।
बहुलक वह मान है जो किसी डेटासेट में सबसे अधिक बार आता है। औसत और माध्यिका के विपरीत, इसे नामात्र डेटा के साथ भी उपयोग किया जा सकता है, जिससे यह विभिन्न डेटा प्रकारों में लागू होता है।
बहुलक उच्च-आवृत्ति श्रेणियों की पहचान में सहायक होता है, जैसे सबसे लोकप्रिय उत्पाद रंग या सबसे सामान्य ग्राहक शिकायत। हालाँकि, इसकी कुछ सीमाएँ हैं:
बहुलक निर्धारित करने में आवृत्ति वितरण तालिका अक्सर सहायक होती है। उदाहरण के लिए, नीचे दी गई सेब के रंगों की आवृत्ति तालिका में “हरा” बहुलक है:
|
सेब का रंग |
आवृत्ति |
|
लाल |
5 |
|
हरा |
8 |
|
पीला |
3 |
सांख्यिकी में औसत, माध्यिका और बहुलक के प्रदर्शन और उपयुक्तता में भेद समझना अत्यंत महत्वपूर्ण है। आइए उनकी तुलना करें:
तीनों मापों में, औसत अपवाद मानों के प्रति सबसे अधिक संवेदनशील है: एक भी चरम मान औसत को काफ़ी विकृत कर सकता है। इसके विपरीत, माध्यिका स्थिर रहती है, जब तक कि पर्याप्त चरम मान मध्य बिंदु को स्थानांतरित न कर दें। बहुलक पूरी तरह से अपवाद मानों से असंवेदनशील है क्योंकि यह केवल आवृत्ति पर निर्भर करता है।
स्क्यूनेस (झुकाव) भी इन मापों को प्रभावित करती है। दाएँ-झुके हुए वितरणों में (जैसे, आय डेटा), सामान्यतः औसत माध्यिका से अधिक होता है और माध्यिका बहुलक से अधिक।(यहाँ बहुलक से तात्पर्य सतत वितरण में उस मोड से है जहाँ बहुलक संभाव्यता घनत्व वक्र के शिखर के अनुरूप होता है, बशर्ते वह अस्तित्व में हो।)
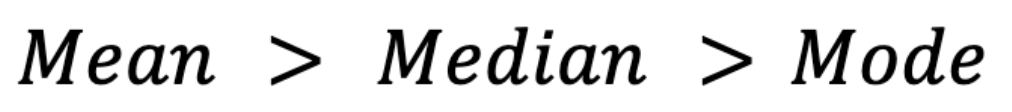
इसके विपरीत, बाएँ-झुके हुए वितरणों में (जैसे, ऐसे टेस्ट स्कोर जहाँ अधिकांश छात्र उच्च अंक लाते हैं), औसत माध्यिका और बहुलक से नीचे रहता है:
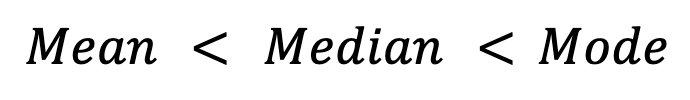
सममित वितरणों में, जैसे सामान्य वितरण, आदर्श रूप से तीनों माप समान होते हैं:
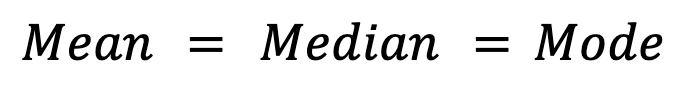
व्यवहार में, हालाँकि, सममित वितरणों में भी सैम्पलिंग परिवर्तनशीलता के कारण छोटे विचलन हो सकते हैं।
पिछले खंड में, हमने सामान्य और झुके हुए वितरणों में औसत, माध्यिका और बहुलक के बीच समग्र संबंध देखे हैं। सामान्य रूप से, इन तीनों मापों के बीच के संबंध स्क्यूनेस के लिए एक नैदानिक उपकरण के रूप में काम करते हैं। प्रायोगिक अध्ययनों में, सांख्यिकीविद अक्सर पियर्सन का दूसरा स्क्यूनेस गुणांक लागू करते हैं:
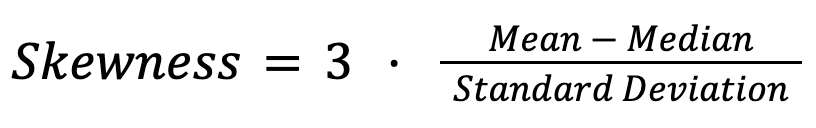
उदाहरण के लिए, वेतन वितरणों में औसत और माध्यिका के बीच बड़ा अंतर आय असमानता का संकेत देता है। इसी तरह, आवास बाजारों में, माध्यिका घर कीमत अक्सर सामान्य लागतों को औसत की तुलना में बेहतर दर्शाती है, जिसे कुछ अत्यधिक महँगी संपत्तियाँ झुका सकती हैं।
विभिन्न केन्द्रीय प्रवृत्ति के माप अलग-अलग डेटा प्रकारों के लिए उपयुक्त होते हैं। नीचे दी गई तालिका प्रत्येक माप के लिए सर्वोत्तम उपयोग मामलों और सीमाओं का सार प्रस्तुत करती है।
|
डेटा प्रकार |
सर्वोत्तम माप |
टिप्पणियाँ |
|
नाममात्र |
बहुलक |
औसत और माध्यिका सार्थक नहीं |
|
क्रमबद्ध |
माध्यिका, बहुलक |
असमान अंतरालों के कारण औसत अक्सर अनुपयुक्त |
|
इंटरवल/अनुपात |
औसत, माध्यिका, बहुलक |
चयन वितरण के आकार और अपवाद मानों पर निर्भर |
जैसा कि हम देखते हैं, सांख्यिकीय माप को डेटा की प्रकृति के साथ संरेखित करना महत्वपूर्ण है।
प्राथमिक मापों के अलावा, ऐसे विशिष्ट विकल्प भी हैं जो स्क्यूनेस, अपवाद मान, और डेटा स्केलिंग जैसी विशिष्ट चुनौतियों का समाधान करते हैं।
एक ट्रिम्ड औसत औसत निकालने से पहले डेटासेट के दोनों सिरों से निश्चित प्रतिशत के चरम मानों को हटा देता है। उदाहरण के लिए, 10% ट्रिम्ड औसत सबसे कम 10% और सबसे अधिक 10% मानों को निकाल देता है।
विनसोराइज़्ड औसत चरम मानों को हटाता नहीं है, बल्कि उन्हें निकटतम शेष मानों से प्रतिस्थापित करता है। यह माप वित्त, विनिर्माण और सर्वे विश्लेषण जैसे क्षेत्रों में उपयोगी है जहाँ डेटा में दुर्लभ किंतु प्रभावशाली चरम मान हो सकते हैं।
दोनों तकनीकें अपवाद मानों के प्रभाव को कम करती हैं, औसत की संवेदनशीलता और माध्यिका की दृढ़ता को मिलाकर मजबूती और डेटा संरक्षण के बीच संतुलन साधती हैं।
ज्यामितीय औसत सभी डेटा बिंदुओं का गुणन करता है और n-वें मूलम (जहाँ n डेटा बिंदुओं की संख्या है) को लेता है। यह गुणात्मक (multiplicative) प्रक्रियाओं में विशेष रूप से उपयोगी है, जैसे वृद्धि दर, निवेश रिटर्न, और जैविक माप। ज्यामितीय औसत की गणना का सूत्र निम्न है:
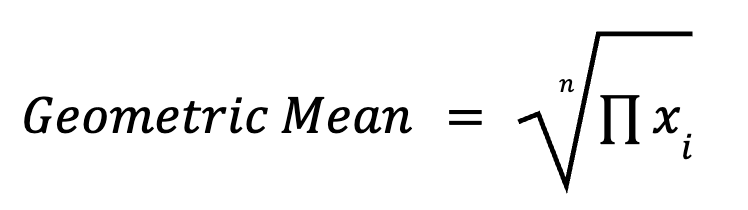
उदाहरण के लिए, कई वर्षों में औसत वृद्धि को अंकगणितीय औसत से बेहतर तरीके से ज्यामितीय औसत सारांशित करता है।
हार्मोनिक औसत की गणना इस प्रकार की जाती है:
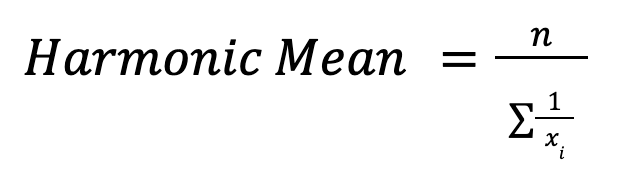
यह दरों का औसत निकालते समय मूल्यवान है, जैसे गति या वित्तीय अनुपात। उदाहरण के लिए, अलग-अलग दूरियों पर औसत गति की गणना में हार्मोनिक औसत सही समग्र दर प्रदान करता है।
एक वेटेड औसत डेटा बिंदुओं को भिन्न-भिन्न महत्त्व प्रदान करता है। उदाहरण के लिए, किसी छात्र का अंतिम ग्रेड परीक्षा अंकों और coursework को अलग-अलग वज़न देकर संयोजित कर सकता है। यह माप पक्षपात को समायोजित करता है और सुनिश्चित करता है कि अधिक महत्त्वपूर्ण प्रेक्षणों का अधिक प्रभाव हो।
ट्राइमीन माध्यिका और क्वार्टाइल्स को संयोजित करता है:
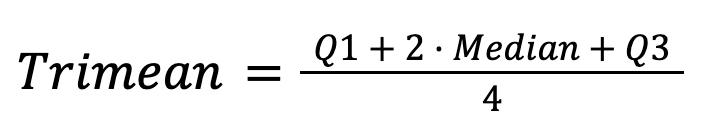
यह माध्यिका की मजबूती को डेटा के फैलाव की जानकारी के साथ मिलाकर एक स्थिर और सूझबूझ भरा केन्द्रीय प्रवृत्ति अनुमान प्रस्तुत करता है।
अपनी सांख्यिकीय सोच को निपुण करने के लिए, निम्नलिखित कोर्स में नामांकन करें:
मजबूती से तात्पर्य किसी केन्द्रीय प्रवृत्ति माप की अपवाद मानों या गैर-सामान्य वितरणों से विकृति के प्रति प्रतिरोधक क्षमता से है। इस अध्याय में, हम इस अवधारणा को और गहराई से समझेंगे।
ब्रेकडाउन पॉइंट यह इंगित करता है कि कोई सांख्यिकीय मान कितना प्रदूषण (contamination) सहन कर सकता है, इससे पहले कि वह अत्यंत गलत परिणाम देने लगे। उदाहरण के लिए:
ब्रेकडाउन पॉइंट्स को समझना डेटा विश्लेषकों को संभावित डेटा प्रदूषण से निपटते समय उपयुक्त सांख्यिकी चुनने में मदद करता है।
माध्यिका जैसे मजबूत माप कुछ सांख्यिकीय दक्षता का त्याग करते हैं, यानी समान परिशुद्धता प्राप्त करने के लिए उन्हें औसत जैसे कम मजबूत मापों की तुलना में बड़े सैंपल आकारों की आवश्यकता हो सकती है।
उदाहरण के लिए, माध्यिका मजबूत है, लेकिन सामान्य वितरणों के लिए कम दक्ष है। इसके विपरीत, औसत सामान्य वितरणों के लिए दक्ष है, परंतु झुके हुए डेटा के प्रति संवेदनशील है। डेटा विश्लेषकों को डेटा की विशेषताओं के आधार पर मजबूती और दक्षता के बीच संतुलन साधना होता है।
व्यावहारिक परिदृश्यों में, जहाँ डेटा विसंगतियाँ सामान्य हैं और जोखिम बड़े हैं—जैसे वित्त या बायोमेडिकल अनुसंधान—वहाँ दक्षता की तुलना में मजबूती को प्राथमिकता दी जाती है।
आधुनिक डेटा की चुनौतियाँ केन्द्रीय प्रवृत्ति के विश्लेषण को पारंपरिक तरीकों से आगे बढ़ाती हैं। आइए कुछ उन्नत विषयों पर निकट दृष्टि डालें।
स्क्यूनेस मूल रूप से केन्द्रीय प्रवृत्ति मापों की व्याख्या को प्रभावित करती है। किसी झुके हुए डेटासेट में केवल औसत रिपोर्ट करना भ्रामक हो सकता है। डेटा की विषमता को बेहतर परिलक्षित करने के लिए, सर्वोत्तम प्रथा है कि औसत और माध्यिका दोनों रिपोर्ट किए जाएँ। उदाहरण के लिए, आय अध्ययनों में माध्यिका अक्सर “सामान्य” कमाई की स्पष्ट तस्वीर देती है।
बहु-शिखरी वितरणों में कई शिखर होते हैं, जिनमें से प्रत्येक संभवतः किसी अलग उपसमूह का प्रतिनिधित्व करता है। केवल औसत जैसे एकल माप पर निर्भर रहना महत्त्वपूर्ण अंतर्दृष्टियों को छिपा सकता है।
उदाहरण के लिए, किसी विश्वविद्यालय के परीक्षा अंकों में दो बहुलक यह इंगित कर सकते हैं कि छात्र दो समूहों में बँटे हैं: जिन्होंने सामग्री को अच्छी तरह समझा और जिन्होंने संघर्ष किया। ऐसे मामलों में, बहुलकों को अलग से रिपोर्ट करना या क्लस्टर-विशिष्ट माध्यिकाएँ प्रस्तुत करना इन पैटर्न्स को उजागर करने में मदद करता है।
नाममात्र और क्रमबद्ध डेटा प्रायः पारंपरिक संख्यात्मक सार-संक्षेपण को कठिन बना देते हैं। नाममात्र डेटा के लिए, बहुलक प्राथमिक उपकरण बना रहता है। हालाँकि, उन्नत विधियाँ जैसे मोडल श्रेणी एंट्रॉपी श्रेणीबद्ध डेटा के भीतर categorical data में विविधता और निश्चितता का आकलन करती हैं, तथा यह मात्राबद्ध करती हैं कि प्रतिक्रियाएँ श्रेणियों में कितनी केंद्रित या बिखरी हुई हैं।
क्रमबद्ध डेटा के लिए, संचयी प्रतिशत या माध्यिका रैंक जैसी तकनीकें केन्द्रीय प्रवृत्ति में गहरी अंतर्दृष्टि प्रदान करती हैं, क्रम को संरक्षित रखते हुए समान अंतराल मानकर नहीं चलतीं।
उभरती कम्प्यूटेशनल विधियाँ और डेटा साइंस तकनीकें केन्द्रीय प्रवृत्ति की हमारी समझ को परिष्कृत करती रहती हैं। नई पद्धतियाँ जटिल, उच्च-आयामी डेटासेट्स में भी अधिक सूक्ष्म विश्लेषण सक्षम करती हैं। भविष्य में, केन्द्रीय प्रवृत्ति के क्षेत्र में अनुसंधान और विकास ऐसे अनुकूली मापों पर केंद्रित हो सकता है जो स्वचालित रूप से स्क्यूनेस या डेटा प्रदूषण के लिए समायोजित हों, जिससे और भी अधिक मजबूती और व्याख्येयता सुनिश्चित हो।
यदि आप अपनी डेटा स्किल्स सुधारने में रुचि रखते हैं और Python तथा R में सांख्यिकी की बुनियाद का अधिक ठोस आधार चाहते हैं, तो हमारे निम्नलिखित स्किल ट्रैक्स पर विचार करें, जिनकी मैं अत्यधिक अनुशंसा करता/करती हूँ:
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
