
Last chance! 50% off DataCamp Premium
Sale ends in
Pemusatan adalah salah satu konsep paling penting dalam statistika, yang menggambarkan nilai khas tempat data cenderung berkumpul. Ini memberikan satu angka representatif yang merangkum seluruh himpunan data, sehingga sejumlah besar informasi menjadi mudah dipahami dan dibandingkan.
Secara historis, gagasan tentang “nilai pusat” telah berkembang selama berabad-abad. Cendekiawan kuno seperti orang Yunani mempertimbangkan rata-rata sederhana, sementara para matematikawan pada abad ke-17 dan ke-18 memformalkan mean, median, dan modus sebagai alat statistik. Abad ke-20 menghadirkan penyempurnaan lebih lanjut dengan memperkenalkan ukuran khusus untuk bekerja dengan data yang miring atau rentan terhadap pencilan. Saat ini, pemusatan tetap krusial di berbagai bidang, dari ilmu sosial dan ekonomi hingga teknik dan machine learning.
Sebelum membahas variannya, mari meninjau beberapa istilah. Untuk bahasan yang lebih dekat dan komprehensif tentang ini dan lainnya, daftarlah di kursus Introduction to Statistics kami.
Pemusatan mengacu pada ukuran statistik yang mengidentifikasi titik pusat dalam sebuah himpunan data. Ini berfungsi sebagai statistik ringkasan, yang menunjukkan di mana sebagian besar nilai dalam distribusi cenderung berkumpul. Dengan menawarkan satu nilai representatif, ukuran ini menyederhanakan keragaman kompleks yang melekat pada data mentah.
Salah satu tujuan utama pemusatan adalah untuk memungkinkan perbandingan antarhimpunan data. Misalnya, dengan ukuran pemusatan, kita dapat membandingkan pendapatan rata-rata antar kota dan dengan cepat mengungkap pola sosial ekonomi. Penting untuk dicatat, pemusatan berbeda dari ukuran penyebaran, yang menggambarkan bagaimana data menyebar di sekitar pusat. Sementara mean atau median menunjukkan letak pusat data, ukuran seperti varians dan simpangan baku mengungkap seberapa rapat atau renggang data terdistribusi di sekitar pusat tersebut.
Dalam statistik deskriptif, pemusatan digunakan untuk meringkas himpunan data besar secara efektif. Baik saat menganalisis nilai ujian, waktu produksi, atau penilaian pelanggan, mengetahui nilai khas sangat berharga untuk menafsirkan tren.
Pemusatan berinteraksi erat dengan ukuran keragaman. Misalnya, dua himpunan data mungkin memiliki mean yang sama tetapi berbeda secara drastis dalam penyebaran, yang memengaruhi seberapa andal mean tersebut sebagai statistik ringkasan.
Dalam skenario dunia nyata, pemusatan membantu pembuat kebijakan, pemimpin bisnis, dan peneliti membuat keputusan berdasarkan nilai representatif. Pengecer dapat menganalisis penjualan rata-rata untuk menyusun strategi persediaan, sementara peneliti kesehatan mungkin menelaah median waktu kelangsungan hidup untuk menilai efektivitas pengobatan.
Memilih ukuran pemusatan yang sesuai sangat bergantung pada jenis data. Data terbagi dalam empat kategori besar:
Berikut ukuran pemusatan yang paling sesuai untuk setiap jenis data:
Sebagai contoh, median pendapatan rumah tangga sering dilaporkan karena data pendapatan condong akibat pendapatan sangat tinggi, sedangkan mean tinggi badan masuk akal untuk tinggi manusia yang berdistribusi normal.
Ada tiga ukuran pemusatan utama: mean aritmetika, median, dan modus. Mari meninjau masing-masingnya, dengan memberi perhatian khusus pada kekuatan dan keterbatasannya.
Mean aritmetika, sering kali disebut sebagai rata-rata atau mean, dihitung dengan menjumlahkan semua nilai dalam himpunan data dan membaginya dengan jumlah observasi:
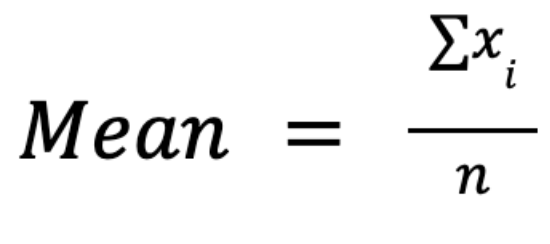
Keunggulan utama ukuran ini terletak pada sifat matematisnya: dapat dimanipulasi secara aljabar, memungkinkan perumusan elegan dalam statistika inferensial, pengujian hipotesis, dan analisis regresi. Misalnya, mean terintegrasi mulus ke dalam perhitungan varians dan simpangan baku.
Namun, mean sangat sensitif terhadap pencilan: beberapa nilai ekstrem dapat sangat menggeserkannya, sehingga tidak representatif untuk distribusi yang miring. Misalnya, dalam data pendapatan, beberapa miliarder dapat menaikkan mean jauh di atas apa yang diperoleh kebanyakan orang.
Saat membahas mean, penting membedakan antara mean populasi (μ) dan mean sampel (x̄). Yang pertama menggambarkan seluruh populasi, sedangkan yang kedua mengestimasinya dari subset. Untuk menarik kesimpulan tentang seluruh populasi dari sampel data, kita menggunakan proses yang disebut inferensi statistik.
Skenario ketika mean sebaiknya tidak digunakan mencakup distribusi yang sangat miring, data dengan pencilan signifikan, atau data ordinal, di mana merata-ratakan peringkat tidak memiliki makna praktis.
Median merepresentasikan nilai tengah dari himpunan data yang diurutkan. Untuk jumlah nilai ganjil, median adalah nilai pusat tunggal. Untuk himpunan data genap, median adalah rata-rata dari dua nilai tengah.
Untuk menghitung median, kita perlu:
Kekuatan utama median adalah ketahanannya terhadap pencilan: nilai ekstrem di kedua ujung distribusi tidak memengaruhi nilainya, sehingga ideal untuk data yang miring seperti pendapatan atau harga properti.
Namun, secara matematis median kurang mudah diolah dibandingkan mean. Median kurang berguna dalam rumus statistik yang kompleks atau pemodelan dan tidak mudah diintegrasikan ke dalam manipulasi aljabar.
Modus adalah nilai yang paling sering muncul dalam sebuah himpunan data. Berbeda dengan mean dan median, modus dapat digunakan juga pada data nominal, sehingga berlaku di berbagai jenis data.
Modus membantu mengidentifikasi kategori berfrekuensi tinggi, seperti warna produk terpopuler atau keluhan pelanggan yang paling umum. Namun, ada beberapa keterbatasan:
Tabel distribusi frekuensi sering membantu menentukan modus. Misalnya, dalam tabel distribusi frekuensi warna apel di bawah ini, “hijau” adalah modus:
|
Warna apel |
Frekuensi |
|
Merah |
5 |
|
Hijau |
8 |
|
Kuning |
3 |
Memahami bagaimana mean, median, dan modus berbeda dalam kinerja dan kesesuaian sangat penting dalam statistika. Mari kita bandingkan:
Di antara ketiganya, mean paling sensitif terhadap pencilan: satu nilai ekstrem dapat sangat mendistorsi mean. Sebaliknya, median tetap stabil kecuali cukup banyak nilai ekstrem menumpuk sehingga menggeser titik tengah. Modus sama sekali tidak sensitif terhadap pencilan karena sepenuhnya bergantung pada frekuensi.
Kemiringan (skewness) juga memengaruhi ukuran ini. Dalam distribusi miring ke kanan (misalnya data pendapatan), mean biasanya lebih tinggi daripada median, yang pada gilirannya lebih tinggi daripada modus.(Dengan modus di sini, yang dimaksud adalah modus pada distribusi kontinu, di mana modus adalah puncak kurva densitas probabilitas, dengan asumsi puncak tersebut ada.)
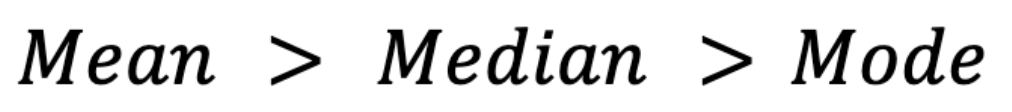
Sebaliknya, dalam distribusi miring ke kiri (misalnya nilai ujian saat sebagian besar siswa mendapat nilai tinggi), mean berada di bawah median dan modus:
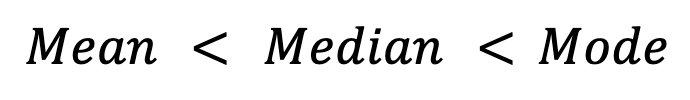
Distribusi simetris, seperti distribusi normal, secara ideal menunjukkan kesetaraan di antara ketiga ukuran tersebut:
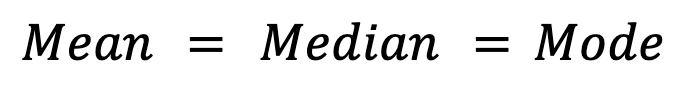
Namun dalam praktik, penyimpangan kecil mungkin terjadi pada distribusi simetris akibat variabilitas pengambilan sampel.
Pada bagian sebelumnya, kita telah melihat hubungan umum antara mean, median, dan modus dalam distribusi normal dan miring. Secara umum, hubungan ketiga ukuran tersebut berfungsi sebagai alat diagnostik untuk kemiringan. Dalam studi empiris, ahli statistik sering menerapkan koefisien kemiringan kedua Pearson:
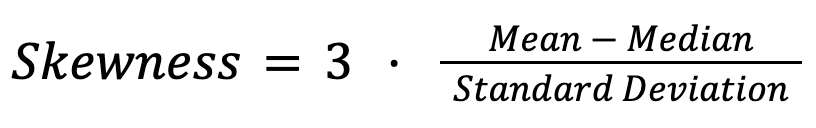
Sebagai contoh, dalam distribusi gaji, kesenjangan besar antara mean dan median menandakan ketimpangan pendapatan. Demikian pula, di pasar perumahan, harga rumah median sering kali lebih mencerminkan biaya khas daripada mean, yang dapat terdistorsi oleh beberapa properti yang sangat mahal.
Berbagai ukuran pemusatan cocok untuk berbagai jenis data. Tabel di bawah merangkum kasus penggunaan optimal dan keterbatasan untuk tiap ukuran.
|
Jenis data |
Ukuran terbaik |
Komentar |
|
Nominal |
Modus |
Mean dan median tidak bermakna |
|
Ordinal |
Median, Modus |
Mean sering tidak tepat karena interval tidak sama |
|
Interval/Rasio |
Mean, Median, Modus |
Pilihan bergantung pada bentuk distribusi dan pencilan |
Seperti yang terlihat, penting untuk menyelaraskan ukuran statistik dengan sifat data.
Selain ukuran pemusatan utama, ada alternatif khusus yang mengatasi tantangan data tertentu seperti kemiringan, pencilan, dan penskalaan data.
Mean terpotong (trimmed mean) mengecualikan persentase tetap nilai ekstrem dari kedua ujung himpunan data sebelum menghitung rata-rata. Misalnya, trimmed mean 10% menghapus 10% nilai terendah dan 10% nilai tertinggi.
Sebuah winsorized mean tidak menghilangkan nilai ekstrem tetapi menggantinya dengan nilai tersisa terdekat. Ukuran ini berguna di bidang seperti keuangan, manufaktur, dan analisis survei di mana data dapat mencakup kejadian langka namun berpengaruh.
Kedua teknik ini mengurangi pengaruh pencilan, mencapai keseimbangan antara ketahanan dan pelestarian data dengan menggabungkan sensitivitas mean dan ketangguhan median.
Mean geometri mengalikan semua titik data dan mengambil akar ke-n (di mana n adalah jumlah titik data). Mean ini sangat berguna dalam proses multiplikatif, seperti laju pertumbuhan, imbal hasil investasi, dan pengukuran biologis. Rumus untuk menghitung mean geometri adalah sebagai berikut:
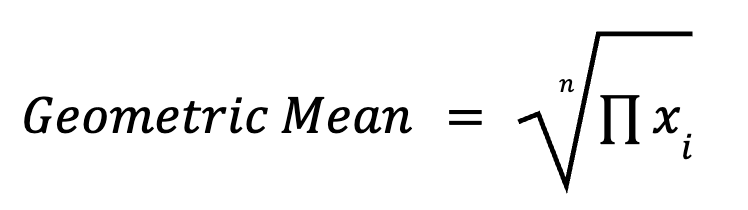
Misalnya, pertumbuhan rata-rata selama beberapa tahun lebih baik diringkas dengan mean geometri daripada mean aritmetika.
Mean harmonik dihitung sebagai:
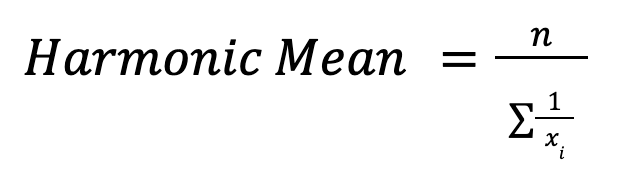
Mean ini bernilai saat merata-ratakan laju, seperti kecepatan atau rasio keuangan. Misalnya, dalam menghitung kecepatan rata-rata pada jarak yang berbeda, mean harmonik memberikan laju keseluruhan yang benar.
Mean berbobot memberikan bobot berbeda pada titik data. Misalnya, nilai akhir seorang siswa dapat menggabungkan nilai ujian dan tugas dengan bobot yang berbeda. Ukuran ini menyesuaikan bias dan memastikan observasi yang lebih signifikan memiliki pengaruh lebih besar.
Trimean menggabungkan median dan kuartil:
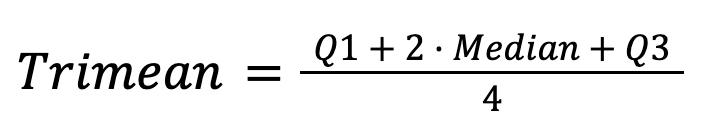
Ukuran ini menawarkan estimasi pemusatan yang stabil dan informatif dengan memadukan ketangguhan median dan informasi tentang penyebaran data.
Untuk menguasai keterampilan berpikir statistik Anda, daftarlah pada kursus berikut:
Ketahanan (robustness) menggambarkan daya tahan suatu ukuran pemusatan terhadap distorsi dari pencilan atau distribusi nonnormal. Pada bab ini, kita akan menelaah konsep ini lebih dalam.
Breakdown point menunjukkan jumlah kontaminasi yang dapat ditangani suatu statistik sebelum mulai memberikan hasil yang sangat tidak akurat. Misalnya:
Memahami breakdown point membantu analis data memilih statistik yang tepat saat menangani potensi kontaminasi data.
Ukuran yang tangguh seperti median mengorbankan sebagian efisiensi statistik, artinya mungkin memerlukan ukuran sampel yang lebih besar untuk mencapai presisi yang sama dibanding ukuran yang kurang tangguh seperti mean.
Misalnya, meskipun median tangguh, median kurang efisien untuk distribusi normal. Sebaliknya, mean efisien untuk distribusi normal tetapi sensitif terhadap data yang miring. Analis data harus menyeimbangkan ketahanan dan efisiensi, bergantung pada karakteristik data.
Dalam praktik, ketahanan lebih diutamakan daripada efisiensi di bidang seperti keuangan atau penelitian biomedis, di mana anomali data umum terjadi dan risikonya besar.
Tantangan data modern mendorong analisis pemusatan melampaui metode tradisionalnya. Mari meninjau lebih dekat beberapa topik lanjutan.
Kemiringan secara fundamental memengaruhi penafsiran ukuran pemusatan. Melaporkan hanya mean dalam himpunan data yang miring dapat menyesatkan. Untuk lebih mencerminkan asimetri data, praktik terbaik merekomendasikan melaporkan mean dan median. Misalnya, dalam studi pendapatan, median sering memberikan gambaran yang lebih jelas tentang pendapatan “tipikal” daripada mean.
Distribusi multimodal memiliki beberapa puncak, masing-masing berpotensi mewakili subkelompok yang berbeda. Hanya bergantung pada satu ukuran seperti mean dapat menyembunyikan wawasan penting.
Sebagai contoh, dalam nilai ujian universitas, dua modus dapat menunjukkan dua kelompok mahasiswa: mereka yang memahami materi dengan baik dan mereka yang kesulitan. Dalam kasus seperti ini, melaporkan beberapa modus atau median khusus klaster membantu mengungkap pola tersebut.
Data nominal dan ordinal sering membuat peringkasan numerik tradisional menjadi sulit. Untuk data nominal, modus tetap menjadi alat utama. Namun, metode lanjutan seperti entropi kategori modal menilai keragaman dan kepastian dalam data kategorikal, yang mengukur seberapa terkonsentrasi atau tersebar respons di seluruh kategori.
Untuk data ordinal, teknik seperti persentase kumulatif atau peringkat median menawarkan wawasan lebih dalam tentang pemusatan, dengan tetap mempertahankan urutan tanpa mengasumsikan interval yang sama.
Metode komputasi yang berkembang dan teknik data science terus menyempurnakan pemahaman kita tentang pemusatan. Pendekatan baru memungkinkan analisis yang lebih bernuansa bahkan pada himpunan data yang kompleks dan berdimensi tinggi. Penelitian dan pengembangan di masa depan dalam bidang pemusatan mungkin berfokus pada ukuran adaptif yang secara otomatis menyesuaikan untuk kemiringan atau kontaminasi data, sehingga memastikan ketahanan dan keterjelasan yang lebih besar.
Jika Anda tertarik meningkatkan keterampilan data, dan menginginkan landasan yang lebih menyeluruh dalam dasar-dasar statistika di Python dan R, pertimbangkan untuk mengambil skill track kami, yang sangat saya rekomendasikan:
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



