
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Centrale neiging is een van de belangrijkste concepten in de statistiek en beschrijft de typische waarde waar data omheen clusteren. Het biedt één representatief getal dat een volledige dataset samenvat, waardoor grote hoeveelheden informatie behapbaar en vergelijkbaar worden.
Historisch gezien is het idee van een “centrale waarde” door de eeuwen heen geëvolueerd. Oude geleerden, zoals de Grieken, gebruikten eenvoudige gemiddelden, terwijl wiskundigen in de 17e en 18e eeuw het gemiddelde, de mediaan en de modus formaliseerden als statistische hulpmiddelen. De 20e eeuw bracht verdere verfijning met gespecialiseerde maatstaven om te werken met scheve data of data die gevoelig is voor uitschieters. Vandaag blijft centrale neiging cruciaal in tal van vakgebieden, van sociale wetenschappen en economie tot engineering en machine learning.
Voordat ik de varianten behandel, lopen we even de terminologie door. Voor een diepere en meer complete blik hierop en meer, schrijf je in voor onze cursus Introduction to Statistics.
Centrale neiging verwijst naar de statistische maat die een centraal punt in een dataset identificeert. Het fungeert als samenvattende statistiek en geeft aan waar de meeste waarden in de verdeling geneigd zijn te clusteren. Door één representatieve waarde te bieden, vereenvoudigt het de complexe variabiliteit die inherent is aan ruwe data.
Een belangrijk doel van centrale neiging is het mogelijk maken van vergelijkingen tussen datasets. Met centrale maatstaven kunnen we bijvoorbeeld gemiddelde inkomens tussen steden vergelijken en snel sociaal-economische patronen blootleggen. Belangrijk is dat centrale neiging verschilt van spreidingsmaten, die beschrijven hoe data zich rond het centrum verspreiden. Terwijl gemiddelde of mediaan laat zien waar het centrum ligt, onthullen maten als variantie en standaarddeviatie hoe strak of losjes data rond dat centrum is verdeeld.
In de beschrijvende statistiek wordt centrale neiging gebruikt om grote datasets effectief samen te vatten. Of je nu toetsscores, productietijden of klantbeoordelingen analyseert, het kennen van de typische waarde is van onschatbare waarde voor het interpreteren van trends.
Centrale neiging hangt nauw samen met variabiliteitsmaten. Twee datasets kunnen bijvoorbeeld hetzelfde gemiddelde hebben maar sterk verschillen in spreiding, wat beïnvloedt hoe betrouwbaar dat gemiddelde werkelijk is als samenvattende statistiek.
In praktijksituaties helpt centrale neiging beleidsmakers, bedrijfsleiders en onderzoekers om beslissingen te nemen op basis van representatieve waarden. Een retailer kan gemiddelde verkopen analyseren om voorraadstrategieën te ontwikkelen, terwijl een gezondheidszorgonderzoeker mediane overlevingstijden kan bekijken om de effectiviteit van behandelingen te beoordelen.
Het kiezen van een geschikte maat voor centrale neiging hangt sterk af van het datatype. Data vallen in vier brede categorieën:
Dit zijn de meest geschikte maatstaven van centrale neiging voor elk datatype:
Zo wordt het mediane huishoudinkomen vaak gerapporteerd omdat inkomensdata scheef zijn door extreem hoge verdieners, terwijl het gemiddelde lengtecijfer zinvol is voor normaal verdeelde menselijke lengtes.
Er zijn drie primaire maatstaven van centrale neiging: het rekenkundig gemiddelde, de mediaan en de modus. Laten we ze elk bekijken, met speciale aandacht voor hun sterke en zwakke punten.
Het rekenkundig gemiddelde, vaak simpelweg het gemiddelde of de mean genoemd, wordt berekend door alle waarden in een dataset op te tellen en te delen door het aantal observaties:
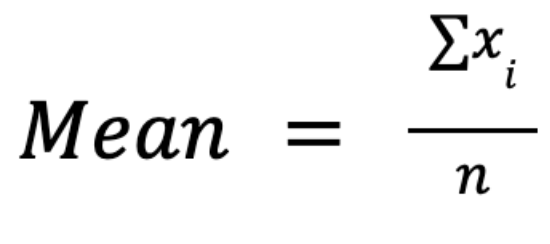
Het belangrijkste voordeel van deze maat zit in zijn wiskundige eigenschappen: hij is algebraïsch manipuleerbaar, wat elegante formuleringen mogelijk maakt in inferentiële statistiek, hypothesetoetsing en regressieanalyse. Zo past hij naadloos in berekeningen van variantie en standaarddeviatie.
Het gemiddelde is echter zeer gevoelig voor uitschieters: een paar extreme waarden kunnen het sterk scheeftrekken, waardoor het onrepresentatief wordt voor scheve verdelingen. In inkomensdata kunnen enkele miljardairs bijvoorbeeld het gemiddelde ver boven het inkomen van de meeste mensen tillen.
Bij het bespreken van het gemiddelde is het cruciaal onderscheid te maken tussen het populatiegemiddelde (μ) en het steekproefgemiddelde (x̄). De eerste beschrijft de volledige populatie, terwijl de tweede deze schat op basis van een subset. Om conclusies te trekken over de hele populatie uit een steekproef data, gebruiken we een proces dat statistical inference wordt genoemd.
Situaties waarin je het gemiddelde beter niet gebruikt, zijn sterk scheve verdelingen, data met significante uitschieters of ordinale data, waarbij het middelen van rangen geen praktische betekenis heeft.
De mediaan is de middelste waarde van een geordende dataset. Bij een oneven aantal waarden is het de middelste waarde. Bij een even aantal waarden is het het gemiddelde van de twee middelste waarden.
Om de mediaan te berekenen, moeten we:
Het belangrijkste voordeel van de mediaan is de robuustheid tegen uitschieters: extreme waarden aan beide uiteinden van de verdeling hebben geen invloed op de waarde, wat haar ideaal maakt voor scheve data zoals inkomens of huizenprijzen.
De mediaan is echter wiskundig minder hanteerbaar dan het gemiddelde. Ze is minder bruikbaar in complexe statistische formules of modellering en integreert niet gemakkelijk in algebraïsche bewerkingen.
De modus is de waarde die het vaakst voorkomt in een dataset. In tegenstelling tot gemiddelde en mediaan kan ze ook met nominale data worden gebruikt, waardoor ze toepasbaar is op verschillende datatypen.
De modus helpt categorieën met hoge frequentie te identificeren, zoals de populairste productkleur of de meest voorkomende klantklacht. Maar er zijn enkele beperkingen:
Een frequentietabel helpt vaak om de modus te bepalen. In de onderstaande frequentietabel van appelkleuren is “groen” bijvoorbeeld de modus:
|
Appelkleur |
Frequentie |
|
Rood |
5 |
|
Groen |
8 |
|
Geel |
3 |
Begrijpen hoe gemiddelde, mediaan en modus verschillen in prestaties en geschiktheid is cruciaal in de statistiek. Laten we ze vergelijken:
Van de drie is het gemiddelde het meest gevoelig voor uitschieters: één extreme waarde kan het gemiddelde aanzienlijk vertekenen. De mediaan blijft daarentegen stabiel, tenzij genoeg extreme waarden zich opstapelen om het middelpunt te verschuiven. De modus is volledig ongevoelig voor uitschieters omdat ze puur van frequentie afhangt.
Scheefheid beïnvloedt deze maatstaven ook. In rechts-scheve verdelingen (bijv. inkomensdata) ligt het gemiddelde doorgaans hoger dan de mediaan, die op haar beurt hoger is dan de modus. (Met modus bedoel ik hier de modus in een continue verdeling, waar de modus de piek van de kansdichtheidskromme is, ervan uitgaande dat die bestaat.)
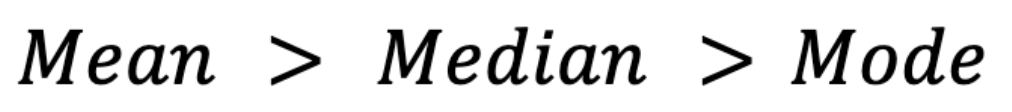
Omgekeerd ligt in links-scheve verdelingen (bijv. toetsresultaten waarbij de meeste studenten hoog scoren) het gemiddelde onder de mediaan en de modus:
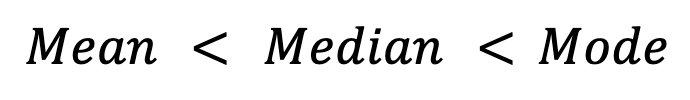
Symmetrische verdelingen, zoals de normale verdeling, laten idealiter gelijkheid tussen alle drie de maatstaven zien:
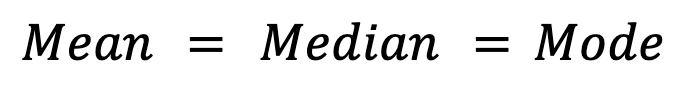
In de praktijk kunnen in symmetrische verdelingen echter kleine afwijkingen optreden door steekproeftrekking-variabiliteit.
In de vorige sectie zagen we al de algemene relaties tussen gemiddelde, mediaan en modus in normale en scheve verdelingen. In het algemeen dienen de relaties tussen de drie als diagnostisch hulpmiddel voor scheefheid. In empirische studies gebruiken statistici vaak de tweede scheefheidscoëfficiënt van Pearson:
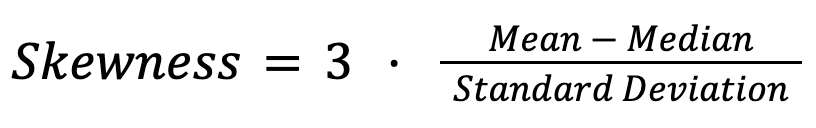
In salarisverdelingen wijst bijvoorbeeld een aanzienlijk verschil tussen het gemiddelde en de mediaan op inkomensongelijkheid. Evenzo weerspiegelt in woningmarkten de mediane huizenprijs vaak beter de typische kosten dan het gemiddelde, dat scheef kan worden getrokken door enkele extreem dure woningen.
Verschillende maatstaven voor centrale neiging passen bij verschillende datatypen. De onderstaande tabel vat optimale gebruikssituaties en beperkingen voor elke maat samen.
|
Datatype |
Beste maat |
Opmerkingen |
|
Nominaal |
Modus |
Gemiddelde en mediaan niet betekenisvol |
|
Ordinaal |
Mediaan, Modus |
Gemiddelde vaak ongeschikt door ongelijke intervallen |
|
Interval/Ratio |
Gemiddelde, Mediaan, Modus |
Keuze hangt af van verdelingsvorm en uitschieters |
Zoals we zien, is het belangrijk om de statistische maat af te stemmen op de aard van de data.
Naast de primaire maatstaven van centrale neiging zijn er gespecialiseerde alternatieven die specifieke data-uitdagingen aanpakken, zoals scheefheid, uitschieters en dataschaling.
Een getrimd gemiddelde sluit een vast percentage extreme waarden aan beide uiteinden van de dataset uit voordat het gemiddelde wordt berekend. Een 10%-getrimd gemiddelde verwijdert bijvoorbeeld de laagste 10% en de hoogste 10% van de waarden.
Een gewinsoriseerd gemiddelde vervangt extreme waarden niet door ze te verwijderen, maar door ze te vervangen door de dichtstbijzijnde overgebleven waarden. Deze maat is nuttig in sectoren als financiën, productie en enquête-analyse, waar data zeldzame maar invloedrijke extremen kan bevatten.
Beide technieken verminderen de invloed van uitschieters en vinden een balans tussen robuustheid en databehoud door de gevoeligheid van het gemiddelde te combineren met de veerkracht van de mediaan.
Het geometrisch gemiddelde vermenigvuldigt alle datapunten en neemt de n-de wortel (waar n het aantal datapunten is). Het is bijzonder nuttig bij multiplicatieve processen, zoals groeipercentages, beleggingsrendementen en biologische metingen. De formule voor het berekenen van het geometrisch gemiddelde is als volgt:
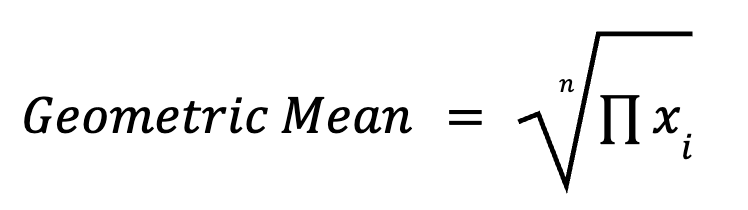
Gemiddelde groei over meerdere jaren wordt bijvoorbeeld beter samengevat met een geometrisch gemiddelde dan met een rekenkundig gemiddelde.
Het harmonisch gemiddelde wordt berekend als:
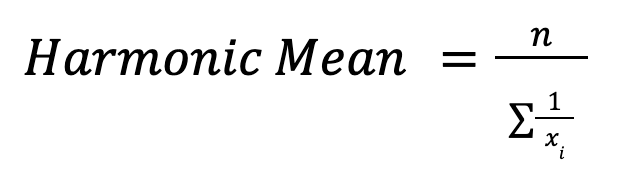
Dit is waardevol bij het middelen van verhoudingen, zoals snelheid of financiële ratio's. Bij het berekenen van de gemiddelde snelheid over verschillende afstanden geeft het harmonisch gemiddelde bijvoorbeeld de juiste totale snelheid.
Een gewogen gemiddelde kent verschillende belangrijkheden toe aan datapunten. Het eindcijfer van een student kan bijvoorbeeld tentamens en opdrachten met verschillende wegingen combineren. Deze maat corrigeert voor bias en zorgt ervoor dat belangrijkere observaties meer invloed hebben.
De trimean combineert de mediaan en kwartielen:
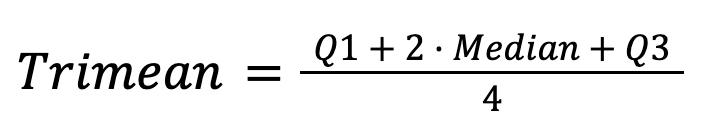
Deze biedt een stabiele en inzichtelijke schatting van de centrale neiging door de robuustheid van de mediaan te combineren met informatie over de spreiding.
Wil je je statistische denkskills meester worden, schrijf je dan in voor de volgende cursussen:
Robuustheid beschrijft de weerstand van een maat voor centrale neiging tegen vertekening door uitschieters of niet-normale verdelingen. In dit hoofdstuk gaan we dieper in op dit concept.
Het breekpunt (breakdown point) geeft aan hoeveel vervuiling een statistiek kan verwerken voordat deze extreem onnauwkeurige resultaten geeft. Bijvoorbeeld:
Inzicht in breekpunten helpt data-analisten om passende statistieken te kiezen bij mogelijke datavervuiling.
Robuuste maten zoals de mediaan leveren wat statistische efficiëntie in, wat betekent dat ze grotere steekproeven kunnen vereisen om dezelfde precisie te bereiken als minder robuuste maten zoals het gemiddelde.
Hoewel de mediaan robuust is, is ze bijvoorbeeld minder efficiënt voor normale verdelingen. Omgekeerd is het gemiddelde efficiënt voor normale verdelingen maar gevoelig voor scheve data. Data-analisten moeten robuustheid en efficiëntie afwegen, afhankelijk van de datakenmerken.
In praktijksituaties krijgt robuustheid vaak de voorkeur boven efficiëntie in domeinen als financiën of biomedisch onderzoek, waar data-anomalieën veel voorkomen en de risico's aanzienlijk zijn.
De uitdagingen van moderne data duwen de analyse van centrale neiging voorbij traditionele methoden. Laten we enkele geavanceerde onderwerpen nader bekijken.
Scheefheid beïnvloedt fundamenteel de interpretatie van maatstaven voor centrale neiging. Alleen het gemiddelde rapporteren in een scheve dataset kan misleidend zijn. Om de asymmetrie van de data beter weer te geven, is het beste gebruik om zowel gemiddelde als mediaan te rapporteren. In inkomensstudies biedt de mediaan bijvoorbeeld vaak een duidelijker beeld van “typische” verdiensten dan het gemiddelde.
Multimodale verdelingen bevatten meerdere pieken, die elk mogelijk een andere subgroep vertegenwoordigen. Alleen op één maat, zoals het gemiddelde, vertrouwen kan cruciale inzichten verbergen.
Bijvoorbeeld: in de toetsscores van een universiteit kunnen twee modi wijzen op twee groepen studenten: degenen die de stof goed begrepen en degenen die moeite hadden. In zulke gevallen helpt het rapporteren van meerdere modi of clusterspecifieke medianen deze patronen bloot te leggen.
Nominale en ordinale data maken traditionele numerieke samenvattingen vaak lastig. Voor nominale data blijft de modus het primaire hulpmiddel. Geavanceerde methoden zoals modale categorie-entropie beoordelen echter de diversiteit en zekerheid binnen categorische data, en kwantificeren hoe geconcentreerd of verspreid antwoorden over categorieën zijn.
Voor ordinale data bieden technieken zoals cumulatieve percentages of mediane rangen diepere inzichten in centrale neiging, waarbij de volgorde behouden blijft zonder gelijke intervallen te veronderstellen.
Opkomende computationele methoden en data science-technieken blijven onze kijk op centrale neiging verfijnen. Nieuwe benaderingen maken meer genuanceerde analyses mogelijk, zelfs in complexe, hoog-dimensionale datasets. Toekomstig onderzoek en ontwikkeling op dit gebied kan zich richten op adaptieve maatstaven die automatisch aanpassen voor scheefheid of datavervuiling, wat zorgt voor nog grotere robuustheid en interpretatiegemak.
Als je je datavaardigheden wilt verbeteren en een grondiger basis in de statistiek met Python en R wilt, overweeg dan onze skill tracks, die ik van harte aanbeveel:
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


