您可能到处都会见到钟形曲线,它有许多名称,如正态分布或高斯分布 ,尤其当您关注统计或数据科学时更是如此。它似乎像是大自然的“巧合”,但其实不然:我们测量的许多事物都是许多小因素相加的结果,这暗示着存在一个潜在的加性模型。
通过将任意正态分布转换为一种称为标准正态分布 的特殊形式,我们可以得到在特定情境下尤其有用的分布,例如计算概率、进行统计推断以及应用统计检验。阅读完本文,您将明确什么是标准正态分布、为何我们要额外进行标准化 这一步,以及这一切与变异性、概率和假设检验 之间的关系。最后,我也希望您能加入我们的R 统计学入门 课程或R 统计推断 技能路径,继续深入本文所介绍的理念。
什么是标准正态分布?
标准正态分布是正态分布的一种特例,其均值为零、标准差为一。我们还应指出该分布是对称的,且当您远离中心时,某些取值的概率会对称地降低。
“标准正态分布” 图片由 Dall-E 生成
让我们更仔细地看看标准正态分布的数学方面。
标准正态分布的 PDF
如果您对概率密度函数(PDF)的概念不熟悉,只需知道它描述了连续型随机变量在可能取值上的概率如何分布。每一种连续型概率分布,如指数分布 、t 分布或柯西分布,都有其自己的概率密度函数来定义曲线。标准正态分布的 PDF 定义如下:
该函数确保曲线下的面积积分为 1。 如果您查看这个方程并代入不同的 x 值,就能得到这些点上曲线的高度。在这个方程中:
x 表示任意实数,是函数的输入变量。 它出现在函数的指数部分,即 −x2 /2,这决定了曲线的形状。 由于 x2 总是不小于 0,且前面有负号,指数总是非正(小于等于 0)。 当 x=0 时,指数最大,使得 f(x) 达到峰值。 当 x 在正负两个方向远离 0 时,x2 增大,使指数更负。 更负的指数 会带来 更小的函数值 ,这与前述性质共同决定了 f(x) 在 x=0 两侧对称下降。 指数的底数为欧拉常数 e,确保当 x 在任一方向远离 0 时,函数快速衰减。 常数 1/√
标准正态分布的 CDF
与给出不同取值相对可能性的 PDF 不同,CDF 告诉您变量小于或等于给定值的概率。与 PDF 一样,每个连续型概率分布都有其自己的 CDF。
这个方程稍微复杂一些,但我们可以逐条理解:
积分意味着 CDF 给出的不是 x 处曲线的高度,而是从 −∞ 到 x 的累计概率。 当 x→−∞ 时,CDF 趋近于 0。 当 x=0 时,CDF 为 0.5 ,因为分布对称,且一半的概率在 0 的左侧。 当 x→∞ 时,CDF 趋近于 1。
我们为何关心标准正态分布
我们的高斯分布 指南对何时希望将数据调整为正态分布给出了不错的建议。但有时,您可能希望将数据专门转换为标准正态。以下是一些常见原因:
标准正态用于假设检验
标准正态分布使得我们的数据更具可比性,并可与某些统计方法配合使用。通过将数据转换为 Z 分数,我们可以比较来自不同正态分布的观测值。尤其是,它构成 Z 检验的基础,用于判断样本均值是否与总体均值存在显著差异。
另一方面,t 检验使用样本标准差来估计总体标准差,因此依赖尾部较标准正态更厚的 t 分布。阅读我们的教程T 检验 vs. Z 检验:各自的使用场景 ,其中讨论了总体与样本方差等内容。
标准正态用于在统一尺度上比较数据
由于不同数据集和变量可能具有不同的单位与量纲,直接比较会很困难。但当您通过减去均值并除以标准差将它们转换为 Z 分数后,就能在不同分布之间轻松比较。对于服从正态分布的数据集,这会得到 标准正态分布。例如,将我预计近似正态的 SAT 与 GRE 分数都转换为 Z 分数,能让我们相对各自的测试人群来比较学生表现。
标准正态用于质量控制
标准正态在制造业产品质量监控中很重要。通过细致关注概率,制造商可以判断质量波动是源于随机变动还是其他潜在问题。这与我们之前提到的假设检验有关,也与下面将介绍的 Z 分数表有关。
标准正态用于统计建模
标准正态分布在评估如线性回归 和时间序列预测 等模型的误差时发挥作用。在这些模型中,我们假设残差(观测值与预测值之差)不仅服从正态分布,而且可以标准化为标准正态分布。
在线性回归中,标准化残差是被转换为标准化数值的残差,它允许我们以标准差为单位衡量误差的极端程度,从而更容易发现离群点。这很有帮助,因为残差中的异方差性 (在模型自变量中可能并不明显)会扭曲对残差的解读。
在时间序列分析中,当误差被恰当地标准化后,常假设其服从标准正态分布。这对于构建预测区间很重要。许多时间序列模型,如 ARIMA ,依赖标准正态分位数来为预测构建置信边界。此外, 在时间序列分解中,表示不规则波动的余项往往被发现服从正态分布。如果您对这个余项进行标准化,就能找出时间序列中并非由趋势-循环或季节性造成的极端值的概率。我们的R 语言预测 课程会讲授这类技术。
标准正态用于机器学习
许多机器学习算法在数据被标准化到统一尺度时表现最佳。我想到的是逻辑回归 、k 均值聚类 以及神经网络 。
我还想到主成分分析 ,它常被用作预处理技术 。在 PCA 中,我们希望输入特征具有零均值和单位方差,以 避免数值较大的特征占主导。 常见的预处理步骤是通过减去均值并除以标准差来标准化数据。这能确保每个特征具有零均值和单位方差,但需要明确的是,这并不强制正态性。不过,在某些情况下,如果原始分布本就接近正态,我预计转换后的数据会近似正态。
标准正态用于概率计算
我们前面提到的标准正态分布的累积分布函数(CDF)已有完善的表格化,也就是说被预先计算并整理成了广泛可用的表格,从而简化了概率计算,因为您只需使用表格查找相应数值即可。
例如,要找出随机选取的身高低于 6 英尺的概率,我们使用总体的正态分布对身高进行标准化,然后在标准正态表中查找相应的 Z 分数。本文末尾放置了一个标准正态表的版本,供您需要时使用。
将数据对齐到标准正态分布的变换
各种变换可以帮助将数据重塑为标准正态分布。粗略而言,这通常是一个两步过程。第一步,我们将数据重塑为正态;第二步,我们进行 Z 分数标准化。
需要注意的是,通常不会把 Z 分数标准化作为第一步,因为极端值会扭曲标准差,毕竟均值和标准差对离群点很敏感。此外,一些变换要求数据为正。如果您先做 Z 分数标准化,中心化后的数值可能包含负数,这会对只适用于正数的变换(我想到的是对数)造成问题。因此,最好按顺序进行:先第 1 步,再第 2 步。
步骤 1:将数据变换为正态
您可以使用的一些变换思路包括:
针对偏态数据的对数变换
当数据正偏时,对数变换可帮助其正态化。例如,对原始值取对数会压缩较大的数值,降低偏度,使分布更加对称。
针对计数数据的平方根变换
对于计数数据或中度偏态的数据集,我们可以尝试平方根变换。该方法在保持更对称结构的同时降低变异性,使数据更接近钟形曲线。
用于灵活调整的 Box-Cox 变换
Box-Cox 变换通过针对数据定制变换向前更进一步。其参数 λ 决定了具体应用的公式,使其在让数据对齐标准正态分布性质方面非常灵活多用。R 特征工程 课程将向您展示 Box-Cox 以及许多其他重要而实用的方法。
步骤 2:执行 Z 分数标准化
一旦应用了某种变换,即可对数据进行标准化,使其符合标准正态分布。这会将数据调整为均值为零、标准差为一。Z 分数的公式为:
其中 X 为变换后的数据, μ 为均值, σ 为标准差。
如果您熟悉总体 Z 分数与样本 Z 分数的区别(我们在R 统计推断 路径中有介绍),您会发现上式是总体 Z 分数的公式。如果您处理的是样本而非整个总体,我们会改为估计均值与标准差:
此处,X-bar 为样本均值,s 为样本标准差。
如果您使用新近正态化数据集的均值和标准差,结果将相同。但有时研究者可能希望通过使用某种基准均值和标准差,将数据相对于更大的参考总体进行比较。
设想研究一个收入数据集(右偏),并进行对数变换以实现正态化。再设想我们希望将收入相对于国家层面的基准进行比较,此时在计算 Z 分数时就会使用全国的均值和标准差,而非样本的均值和标准差。其目的在于便于跨数据集或研究进行有意义的比较。
所以,基本上,如果您使用的是样本,严格来说您得到的是标准化后的正态近似,而非精确的理论标准正态分布。即便对于大数据集差异应当很小,我认为这一点也值得澄清。
可视化标准正态分布
以下是在 R 编程语言中创建理论标准正态分布的一种方法。在这段代码中,我还为标准分数(即 Z 分数)添加了垂直线, 它能告诉我们,对于任意给定的数值,该值相对总体均值高出或低于多少个标准差。
install.packages( "ggplot2" )
library( ggplot2)
ggplot( data.frame( x = c( - 4 , 4 ) ) , aes( x) ) +
stat_function( fun = dnorm, geom = "area" , fill = '#ffe6b7' , color = 'black' , alpha = 0.5 , args = list( mean = 0 , sd = 1 ) ) +
labs( title = "Standard Normal Distribution" , subtitle = "Standard Deviations and Z-Scores" ) +
theme( plot.title = element_text( hjust = 0.5 , face = "bold" ) ) +
theme( plot.subtitle = element_text( hjust = 0.5 ) ) +
geom_vline( xintercept = 1 , linetype = 'dotdash' , color = "black" ) +
geom_vline( xintercept = - 1 , linetype = 'dotdash' , color = "black" ) +
geom_vline( xintercept = 2 , linetype = 'dotdash' , color = "black" ) +
geom_vline( xintercept = - 2 , linetype = 'dotdash' , color = "black" ) +
geom_vline( xintercept = 3 , linetype = 'dotdash' , color = "black" ) +
geom_vline( xintercept = - 3 , linetype = 'dotdash' , color = "black" ) +
geom_text( aes( x= 1 , label= "\n 1 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) +
geom_text( aes( x= 2 , label= "\n 2 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) +
geom_text( aes( x= 3 , label= "\n 3 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) +
geom_text( aes( x= - 1 , label= "\n-1 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) +
geom_text( aes( x= - 2 , label= "\n-2 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) +
geom_text( aes( x= - 3 , label= "\n-3 σ" , y= 0.125 ) , colour= "#376795" , angle= 90 , text= element_text( size= 11 ) ) 技术支持
您应当知道,有些与标准正态相似但并非标准正态的分布:
分布 为何不属于标准正态 t 分布 尾部略重,取决于自由度 逻辑斯蒂分布 尾部略重于正态,形状不同 拉普拉斯分布 峰更尖、尾更重,指数型衰减
标准正态分布与标准正态表
回到我之前提到的一个概念:标准正态表(也称 Z 分数表或 Z 表),用于查找 Z 分数的累计概率。Z 分数表示在标准正态分布中某个数值距离均值有多少个标准差。该表常用于统计学中的假设检验、置信区间与概率计算。 其思想是,您无需手动计算概率,只需查表即可快速确定低于给定 Z 分数的数值占比。
该表需要一些练习才能熟练阅读,而且不同版本之间的样式可能不同。这里展示的是一种二维结构。其目的是便于在处理小数位时查找 Z 分数对应的概率。在这种表格中,最左侧一列包含 Z 分数的整数和第一位小数;顶行表示第二位小数。要找到某个特定 Z 分数对应的概率,先定位到与 Z 分数前两位(整数位和第一位小数)相对应的行,再找到与第二位小数相匹配的列。行与列的交点处的数值就是累计概率,即低于该 Z 分数的数据点所占比例。
最好用一个例子来说明: 例如,假设您为一名学生的测试分数计算得到 Z 分数为 0.32。这意味着该分数高于均值 0.32 个标准差。现在,让我们使用 Z 表来寻找随机选择的数值小于该 Z 分数的概率。
步骤 1: 找到 0.3 所在的行。步骤 2: 找到 0.02 所在的列。步骤 3: 查看 行与列的 交点 :行是 0.3 ,列是 0.02 。该位置的值为 0.6915 。
对于 Z = 0.32 的累计概率是 0.6554 ,这意味着在标准正态分布中,65.54% 的数值 小于高于均值 0.32 个标准差 。如果需要求某个 Z 分数以上的概率,请用 1 减去表中数值,再去查找对应的行和列。
Z 0.01 0.02 0.03 0.04 0.05 0.06 0.07 0.08 0.09 0.1 0.5793 0.6179 0.6554 0.6915 0.7257 0.7580 0.7881 0.8159 0.8413 0.2 0.6179 0.6554 0.6915 0.7257 0.7580 0.7881 0.8159 0.8413 0.8643 0.3 0.6554 0.6915 0.7257 0.7580 0.7881 0.8159 0.8413 0.8643 0.8849 0.4 0.6915 0.7257 0.7580 0.7881 0.8159 0.8413 0.8643 0.8849 0.9032 0.5 0.7257 0.7580 0.7881 0.8159 0.8413 0.8643 0.8849 0.9032 0.9192 0.6 0.7580 0.7881 0.8159 0.8413 0.8643 0.8849 0.9032 0.9192 0.9332 0.7 0.7881 0.8159 0.8413 0.8643 0.8849 0.9032 0.9192 0.9332 0.9452 0.8 0.8159 0.8413 0.8643 0.8849 0.9032 0.9192 0.9332 0.9452 0.9554 0.9 0.8413 0.8643 0.8849 0.9032 0.9192 0.9332 0.9452 0.9554 0.9641 1.0 0.8643 0.8849 0.9032 0.9192 0.9332 0.9452 0.9554 0.9641 0.9713


您可能到处都会见到钟形曲线,它有许多名称,如正态分布或高斯分布,尤其当您关注统计或数据科学时更是如此。它似乎像是大自然的“巧合”,但其实不然:我们测量的许多事物都是许多小因素相加的结果,这暗示着存在一个潜在的加性模型。
通过将任意正态分布转换为一种称为标准正态分布的特殊形式,我们可以得到在特定情境下尤其有用的分布,例如计算概率、进行统计推断以及应用统计检验。阅读完本文,您将明确什么是标准正态分布、为何我们要额外进行标准化这一步,以及这一切与变异性、概率和假设检验之间的关系。最后,我也希望您能加入我们的R 统计学入门课程或R 统计推断技能路径,继续深入本文所介绍的理念。
什么是标准正态分布?
标准正态分布是正态分布的一种特例,其均值为零、标准差为一。我们还应指出该分布是对称的,且当您远离中心时,某些取值的概率会对称地降低。
“标准正态分布” 图片由 Dall-E 生成
理解标准正态分布的方程
让我们更仔细地看看标准正态分布的数学方面。
标准正态分布的 PDF
如果您对概率密度函数(PDF)的概念不熟悉,只需知道它描述了连续型随机变量在可能取值上的概率如何分布。每一种连续型概率分布,如指数分布、t 分布或柯西分布,都有其自己的概率密度函数来定义曲线。标准正态分布的 PDF 定义如下: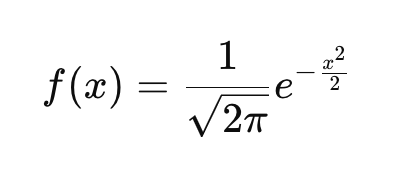
该函数确保曲线下的面积积分为 1。 如果您查看这个方程并代入不同的 x 值,就能得到这些点上曲线的高度。在这个方程中:
标准正态分布的 CDF
与给出不同取值相对可能性的 PDF 不同,CDF 告诉您变量小于或等于给定值的概率。与 PDF 一样,每个连续型概率分布都有其自己的 CDF。
这个方程稍微复杂一些,但我们可以逐条理解:
我们为何关心标准正态分布
我们的高斯分布指南对何时希望将数据调整为正态分布给出了不错的建议。但有时,您可能希望将数据专门转换为标准正态。以下是一些常见原因:
标准正态用于假设检验
标准正态分布使得我们的数据更具可比性,并可与某些统计方法配合使用。通过将数据转换为 Z 分数,我们可以比较来自不同正态分布的观测值。尤其是,它构成 Z 检验的基础,用于判断样本均值是否与总体均值存在显著差异。
另一方面,t 检验使用样本标准差来估计总体标准差,因此依赖尾部较标准正态更厚的 t 分布。阅读我们的教程T 检验 vs. Z 检验:各自的使用场景,其中讨论了总体与样本方差等内容。
标准正态用于在统一尺度上比较数据
由于不同数据集和变量可能具有不同的单位与量纲,直接比较会很困难。但当您通过减去均值并除以标准差将它们转换为 Z 分数后,就能在不同分布之间轻松比较。对于服从正态分布的数据集,这会得到 标准正态分布。例如,将我预计近似正态的 SAT 与 GRE 分数都转换为 Z 分数,能让我们相对各自的测试人群来比较学生表现。
标准正态用于质量控制
标准正态在制造业产品质量监控中很重要。通过细致关注概率,制造商可以判断质量波动是源于随机变动还是其他潜在问题。这与我们之前提到的假设检验有关,也与下面将介绍的 Z 分数表有关。
标准正态用于统计建模
标准正态分布在评估如线性回归和时间序列预测等模型的误差时发挥作用。在这些模型中,我们假设残差(观测值与预测值之差)不仅服从正态分布,而且可以标准化为标准正态分布。
在线性回归中,标准化残差是被转换为标准化数值的残差,它允许我们以标准差为单位衡量误差的极端程度,从而更容易发现离群点。这很有帮助,因为残差中的异方差性(在模型自变量中可能并不明显)会扭曲对残差的解读。
在时间序列分析中,当误差被恰当地标准化后,常假设其服从标准正态分布。这对于构建预测区间很重要。许多时间序列模型,如ARIMA,依赖标准正态分位数来为预测构建置信边界。此外,在时间序列分解中,表示不规则波动的余项往往被发现服从正态分布。如果您对这个余项进行标准化,就能找出时间序列中并非由趋势-循环或季节性造成的极端值的概率。我们的R 语言预测课程会讲授这类技术。
标准正态用于机器学习
许多机器学习算法在数据被标准化到统一尺度时表现最佳。我想到的是逻辑回归、k 均值聚类以及神经网络。
我还想到主成分分析,它常被用作预处理技术。在 PCA 中,我们希望输入特征具有零均值和单位方差,以避免数值较大的特征占主导。常见的预处理步骤是通过减去均值并除以标准差来标准化数据。这能确保每个特征具有零均值和单位方差,但需要明确的是,这并不强制正态性。不过,在某些情况下,如果原始分布本就接近正态,我预计转换后的数据会近似正态。
标准正态用于概率计算
我们前面提到的标准正态分布的累积分布函数(CDF)已有完善的表格化,也就是说被预先计算并整理成了广泛可用的表格,从而简化了概率计算,因为您只需使用表格查找相应数值即可。
例如,要找出随机选取的身高低于 6 英尺的概率,我们使用总体的正态分布对身高进行标准化,然后在标准正态表中查找相应的 Z 分数。本文末尾放置了一个标准正态表的版本,供您需要时使用。
将数据对齐到标准正态分布的变换
各种变换可以帮助将数据重塑为标准正态分布。粗略而言,这通常是一个两步过程。第一步,我们将数据重塑为正态;第二步,我们进行 Z 分数标准化。
需要注意的是,通常不会把 Z 分数标准化作为第一步,因为极端值会扭曲标准差,毕竟均值和标准差对离群点很敏感。此外,一些变换要求数据为正。如果您先做 Z 分数标准化,中心化后的数值可能包含负数,这会对只适用于正数的变换(我想到的是对数)造成问题。因此,最好按顺序进行:先第 1 步,再第 2 步。
步骤 1:将数据变换为正态
您可以使用的一些变换思路包括:
针对偏态数据的对数变换
当数据正偏时,对数变换可帮助其正态化。例如,对原始值取对数会压缩较大的数值,降低偏度,使分布更加对称。
针对计数数据的平方根变换
对于计数数据或中度偏态的数据集,我们可以尝试平方根变换。该方法在保持更对称结构的同时降低变异性,使数据更接近钟形曲线。
用于灵活调整的 Box-Cox 变换
Box-Cox 变换通过针对数据定制变换向前更进一步。其参数 λ 决定了具体应用的公式,使其在让数据对齐标准正态分布性质方面非常灵活多用。R 特征工程课程将向您展示 Box-Cox 以及许多其他重要而实用的方法。
步骤 2:执行 Z 分数标准化
一旦应用了某种变换,即可对数据进行标准化,使其符合标准正态分布。这会将数据调整为均值为零、标准差为一。Z 分数的公式为:
其中 X 为变换后的数据,μ 为均值,σ 为标准差。
如果您熟悉总体 Z 分数与样本 Z 分数的区别(我们在R 统计推断路径中有介绍),您会发现上式是总体 Z 分数的公式。如果您处理的是样本而非整个总体,我们会改为估计均值与标准差:
此处,X-bar 为样本均值,s 为样本标准差。
如果您使用新近正态化数据集的均值和标准差,结果将相同。但有时研究者可能希望通过使用某种基准均值和标准差,将数据相对于更大的参考总体进行比较。
设想研究一个收入数据集(右偏),并进行对数变换以实现正态化。再设想我们希望将收入相对于国家层面的基准进行比较,此时在计算 Z 分数时就会使用全国的均值和标准差,而非样本的均值和标准差。其目的在于便于跨数据集或研究进行有意义的比较。
所以,基本上,如果您使用的是样本,严格来说您得到的是标准化后的正态近似,而非精确的理论标准正态分布。即便对于大数据集差异应当很小,我认为这一点也值得澄清。
可视化标准正态分布
以下是在 R 编程语言中创建理论标准正态分布的一种方法。在这段代码中,我还为标准分数(即 Z 分数)添加了垂直线,它能告诉我们,对于任意给定的数值,该值相对总体均值高出或低于多少个标准差。
您应当知道,有些与标准正态相似但并非标准正态的分布:
标准正态分布与标准正态表
回到我之前提到的一个概念:标准正态表(也称 Z 分数表或 Z 表),用于查找 Z 分数的累计概率。Z 分数表示在标准正态分布中某个数值距离均值有多少个标准差。该表常用于统计学中的假设检验、置信区间与概率计算。其思想是,您无需手动计算概率,只需查表即可快速确定低于给定 Z 分数的数值占比。
该表需要一些练习才能熟练阅读,而且不同版本之间的样式可能不同。这里展示的是一种二维结构。其目的是便于在处理小数位时查找 Z 分数对应的概率。在这种表格中,最左侧一列包含 Z 分数的整数和第一位小数;顶行表示第二位小数。要找到某个特定 Z 分数对应的概率,先定位到与 Z 分数前两位(整数位和第一位小数)相对应的行,再找到与第二位小数相匹配的列。行与列的交点处的数值就是累计概率,即低于该 Z 分数的数据点所占比例。
最好用一个例子来说明:例如,假设您为一名学生的测试分数计算得到 Z 分数为 0.32。这意味着该分数高于均值 0.32 个标准差。现在,让我们使用 Z 表来寻找随机选择的数值小于该 Z 分数的概率。
对于 Z = 0.32 的累计概率是 0.6554,这意味着在标准正态分布中,65.54% 的数值小于高于均值 0.32 个标准差。如果需要求某个 Z 分数以上的概率,请用 1 减去表中数值,再去查找对应的行和列。
结语
希望您喜欢这次对标准正态分布的探索。欢迎继续在 DataCamp 学习。我提到了我们的R 统计学入门课程和R 统计推断技能路径。如果您更偏好 Python,我们的Python 统计思维课程以及Python 实验设计课程也是很好的选择。