
{count, plural, one {Corso} other {Corsi}}
Introduzione alla statistica
{hours} ore
162.7K
La tendenza centrale è uno dei concetti più importanti della statistica: descrive il valore tipico attorno al quale i dati tendono a raggrupparsi. Fornisce un singolo numero rappresentativo che riassume un intero dataset, rendendo gestibili e confrontabili grandi quantità di informazioni.
Storicamente, l’idea di un “valore centrale” si è evoluta nel corso dei secoli. Gli studiosi antichi, come i greci, consideravano medie semplici, mentre i matematici dei secoli XVII e XVIII hanno formalizzato media, mediana e moda come strumenti statistici. Il XX secolo ha portato ulteriore sofisticazione, introducendo misure specializzate per lavorare con dati asimmetrici o soggetti a valori anomali. Oggi la tendenza centrale rimane cruciale in un’ampia gamma di campi, dalle scienze sociali e l’economia all’ingegneria e al machine learning.
Prima di entrare nelle varianti, rivediamo un po’ di terminologia. Per un approfondimento più completo su questo e altro, iscriviti al nostro corso Introduction to Statistics.
La tendenza centrale è la misura statistica che identifica un punto centrale all’interno di un dataset. Funziona come statistica riassuntiva, indicando dove la maggior parte dei valori della distribuzione tende a concentrarsi. Offrendo un valore unico e rappresentativo, semplifica la complessa variabilità insita nei dati grezzi.
Uno scopo chiave della tendenza centrale è consentire confronti tra dataset. Per esempio, grazie alle misure centrali possiamo confrontare i redditi medi tra città e far emergere rapidamente schemi socioeconomici. È importante notare che la tendenza centrale è diversa dalle misure di dispersione, che descrivono come i dati si distribuiscono attorno al centro. Mentre media o mediana mostrano dove si trova il centro dei dati, misure come varianza e deviazione standard rivelano quanto strettamente o ampiamente i dati si distribuiscono attorno a quel centro.
Nella statistica descrittiva, la tendenza centrale viene utilizzata per riassumere efficacemente grandi dataset. Che si tratti di analizzare voti d’esame, tempi di produzione o valutazioni dei clienti, conoscere il valore tipico è fondamentale per interpretare le tendenze.
La tendenza centrale interagisce strettamente con le misure di variabilità. Per esempio, due dataset possono avere la stessa media ma differire notevolmente nella dispersione, influenzando quanto quella media sia davvero affidabile come statistica riassuntiva.
Nella pratica, la tendenza centrale aiuta decisori pubblici, manager e ricercatori a prendere decisioni basate su valori rappresentativi. Un rivenditore può analizzare le vendite medie per definire strategie di inventario, mentre un ricercatore in ambito sanitario può esaminare i tempi mediani di sopravvivenza per valutare l’efficacia di un trattamento.
La scelta di una misura di tendenza centrale appropriata dipende fortemente dal tipo di dati. I dati rientrano in quattro grandi categorie:
Ecco le misure di tendenza centrale più adatte per ciascun tipo di dato:
Per esempio, il reddito familiare mediano è spesso riportato perché i redditi sono asimmetrici a causa di pochi grandi percettori, mentre la media dell’altezza è ragionevole per le altezze umane distribuite normalmente.
Esistono tre misure principali di tendenza centrale: media aritmetica, mediana e moda. Vediamole, con particolare attenzione ai loro punti di forza e ai limiti.
La media aritmetica, spesso semplicemente chiamata media, si calcola sommando tutti i valori in un dataset e dividendo per il numero di osservazioni:
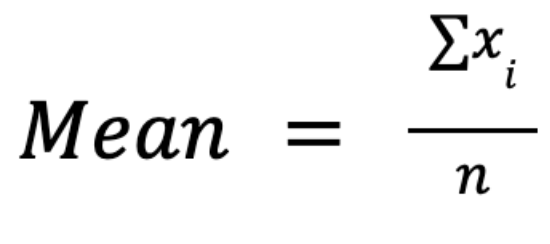
Il principale vantaggio di questa misura risiede nelle sue proprietà matematiche: è manipolabile algebricamente, consentendo formulazioni eleganti nella statistica inferenziale, nei test di ipotesi e nell’analisi di regressione. Per esempio, si integra perfettamente nei calcoli di varianza e deviazione standard.
Tuttavia, la media è altamente sensibile agli outlier: pochi valori estremi possono distorcerla significativamente, rendendola non rappresentativa per distribuzioni asimmetriche. Ad esempio, nei redditi, alcuni miliardari possono far salire la media ben oltre ciò che guadagna la maggior parte delle persone.
Parlando di media, è fondamentale distinguere tra media della popolazione (μ) e media del campione (x̄). La prima descrive l’intera popolazione, mentre la seconda la stima a partire da un sottoinsieme. Per trarre conclusioni sull’intera popolazione da un campione di dati, utilizziamo un processo chiamato inferenza statistica.
Gli scenari in cui la media non dovrebbe essere usata includono distribuzioni fortemente asimmetriche, dati con outlier significativi o dati ordinali, dove fare la media dei ranghi non ha alcun significato pratico.
La mediana rappresenta il valore centrale di un dataset ordinato. Con un numero dispari di valori, è il singolo valore centrale. Con un numero pari di valori, è la media dei due valori centrali.
Per calcolare la mediana, occorre:
Il principale punto di forza della mediana è la sua robustezza agli outlier: i valori estremi a entrambe le estremità della distribuzione non ne influenzano il valore, rendendola ideale per dati asimmetrici come redditi o prezzi degli immobili.
Tuttavia, la mediana è meno gestibile dal punto di vista matematico rispetto alla media. È meno utile in formule statistiche complesse o nella modellizzazione e non si integra facilmente in manipolazioni algebriche.
La moda è il valore che si presenta più frequentemente in un dataset. A differenza di media e mediana, può essere usata anche con dati nominali, risultando applicabile a diversi tipi di dati.
La moda aiuta a identificare categorie ad alta frequenza, come il colore di prodotto più popolare o il reclamo più comune dei clienti. Tuttavia, presenta alcune limitazioni:
Una tabella di distribuzione di frequenza aiuta spesso a determinare la moda. Ad esempio, nella seguente tabella di frequenza dei colori delle mele, “verde” è la moda:
|
Colore della mela |
Frequenza |
|
Rosso |
5 |
|
Verde |
8 |
|
Giallo |
3 |
Capire come media, mediana e moda differiscono in termini di prestazioni e adeguatezza è fondamentale in statistica. Confrontiamole:
Tra le tre misure, la media è la più sensibile agli outlier: un singolo valore estremo può distorcerla in modo significativo. La mediana, al contrario, rimane stabile a meno che non si accumulino abbastanza valori estremi da spostare il punto centrale. La moda è completamente insensibile agli outlier perché dipende esclusivamente dalla frequenza.
L’asimmetria influisce anche su queste misure. Nelle distribuzioni asimmetriche a destra (es. dati sui redditi), la media è tipicamente superiore alla mediana, che a sua volta è superiore alla moda.(Per moda qui intendo la moda in una distribuzione continua, dove la moda è il picco della curva di densità di probabilità, assumendo che esista.)
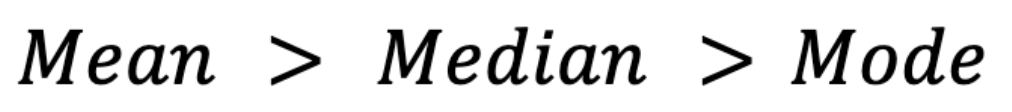
Al contrario, nelle distribuzioni asimmetriche a sinistra (es. voti in cui la maggior parte degli studenti ottiene punteggi alti), la media è inferiore a mediana e moda:
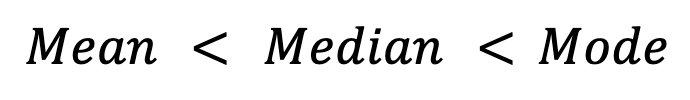
Le distribuzioni simmetriche, come la distribuzione normale, idealmente mostrano uguaglianza tra tutte e tre le misure:
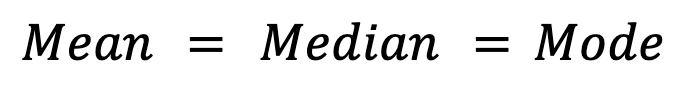
Nella pratica, però, possono verificarsi piccole deviazioni anche nelle distribuzioni simmetriche a causa della variabilità da campione (sampling).
Nella sezione precedente abbiamo già visto le relazioni generali tra media, mediana e moda nelle distribuzioni normali e asimmetriche. In generale, le relazioni tra le tre misure fungono da strumento diagnostico per l’asimmetria. Negli studi empirici, gli statistici applicano spesso il secondo coefficiente di asimmetria di Pearson:
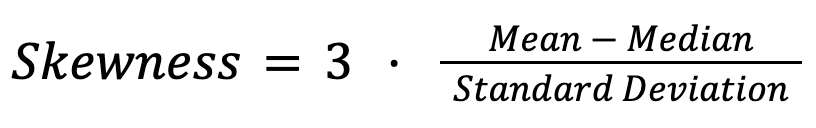
Per esempio, nelle distribuzioni salariali, un divario significativo tra media e mediana segnala disuguaglianza di reddito. Allo stesso modo, nei mercati immobiliari, il prezzo mediano delle case spesso riflette meglio i costi tipici rispetto alla media, che può essere distorta da poche proprietà estremamente costose.
Diverse misure di tendenza centrale si adattano a diversi tipi di dati. La tabella seguente riassume casi d’uso ottimali e limitazioni per ciascuna misura.
|
Tipo di dato |
Miglior misura |
Commenti |
|
Nominale |
Moda |
Media e mediana non significative |
|
Ordinale |
Mediana, Moda |
Media spesso inappropriata per via degli intervalli non uguali |
|
Intervallo/Rapporto |
Media, Mediana, Moda |
La scelta dipende dalla forma della distribuzione e dagli outlier |
Come si vede, è importante allineare la misura statistica alla natura dei dati.
Oltre alle misure principali di tendenza centrale, esistono alternative specializzate che affrontano sfide specifiche come asimmetria, outlier e scalatura dei dati.
Una media troncata esclude una percentuale fissa di valori estremi da entrambe le estremità del dataset prima di calcolare la media. Ad esempio, una media troncata al 10% rimuove il 10% più basso e il 10% più alto dei valori.
Una media winsorizzata non elimina i valori estremi, ma li sostituisce con i valori rimanenti più vicini. Questa misura è utile in ambiti come finanza, manifattura e analisi di sondaggi, dove i dati possono includere estremi rari ma influenti.
Entrambe le tecniche riducono l’influenza degli outlier, raggiungendo un equilibrio tra robustezza e conservazione dei dati, combinando la sensibilità della media con la resilienza della mediana.
La media geometrica moltiplica tutti i punti dati e ne estrae la radice n-esima (dove n è il numero di punti). È particolarmente utile in processi moltiplicativi, come tassi di crescita, rendimenti degli investimenti e misure biologiche. La formula per calcolare la media geometrica è la seguente:
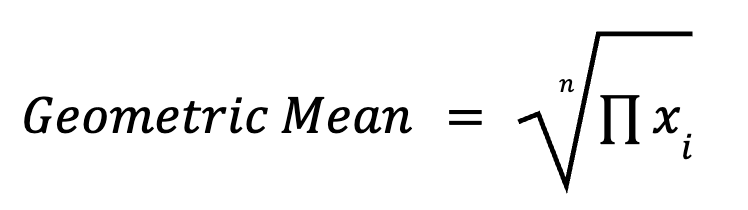
Per esempio, la crescita media su più anni è meglio riassunta con una media geometrica che con una media aritmetica.
La media armonica si calcola come segue:
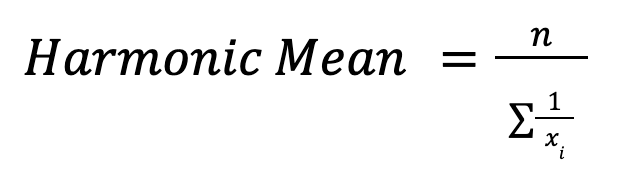
È preziosa quando si fanno medie di tassi, come velocità o rapporti finanziari. Ad esempio, nel calcolo della velocità media su distanze diverse, la media armonica fornisce il tasso complessivo corretto.
Una media pesata assegna importanza variabile ai punti dati. Per esempio, il voto finale di uno studente può combinare esami e lavori con pesi diversi. Questa misura corregge bias e garantisce che le osservazioni più significative abbiano maggiore influenza.
La trimediana combina mediana e quartili:
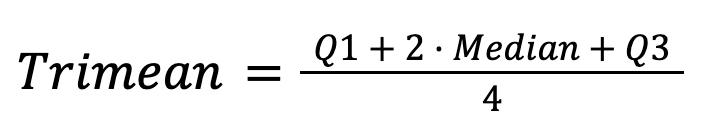
Offre una stima della tendenza centrale stabile e informativa, fondendo la robustezza della mediana con informazioni sulla dispersione dei dati.
Per padroneggiare il tuo pensiero statistico, iscriviti ai seguenti corsi:
La robustezza descrive la resistenza di una misura di tendenza centrale alla distorsione dovuta a outlier o distribuzioni non normali. In questo capitolo approfondiremo il concetto.
Il punto di rottura indica la quantità di contaminazione che una statistica può sopportare prima di fornire risultati estremamente inaccurati. Per esempio:
Comprendere i punti di rottura aiuta gli analisti a scegliere statistiche appropriate quando si affronta una possibile contaminazione dei dati.
Le misure robuste come la mediana sacrificano parte dell’efficienza statistica, il che significa che possono richiedere campioni più grandi per raggiungere la stessa precisione di misure meno robuste come la media.
Per esempio, sebbene la mediana sia robusta, è meno efficiente per distribuzioni normali. Al contrario, la media è efficiente per distribuzioni normali ma sensibile a dati asimmetrici. Gli analisti devono bilanciare robustezza ed efficienza in base alle caratteristiche dei dati.
Nella pratica, la robustezza è preferita all’efficienza in ambiti come finanza o ricerca biomedica, dove le anomalie nei dati sono comuni e i rischi sono considerevoli.
Le sfide dei dati moderni spingono l’analisi della tendenza centrale oltre i metodi tradizionali. Diamo uno sguardo più da vicino ad alcuni temi avanzati.
L’asimmetria influisce profondamente sull’interpretazione delle misure di tendenza centrale. Riportare solo la media in un dataset asimmetrico può essere fuorviante. Per riflettere meglio l’asimmetria dei dati, le buone pratiche raccomandano di riportare sia media che mediana. Per esempio, negli studi sui redditi, la mediana offre spesso un quadro più chiaro dei guadagni “tipici” rispetto alla media.
Le distribuzioni multimodali contengono più picchi, ciascuno potenzialmente rappresentativo di un sottogruppo diverso. Affidarsi a una sola misura come la media può nascondere insight cruciali.
Per esempio, nei voti d’esame di un’università, due mode potrebbero indicare due gruppi di studenti: chi ha compreso bene il materiale e chi ha avuto difficoltà. In questi casi, riportare più mode o mediane specifiche per cluster aiuta a rivelare questi schemi.
I dati nominali e ordinali rendono spesso difficile una sintesi numerica tradizionale. Per i dati nominali, la moda resta lo strumento principale. Tuttavia, metodi avanzati come l’entropia della categoria modale valutano la diversità e la certezza al interno dei dati categorici, quantificando quanto le risposte siano concentrate o disperse tra le categorie.
Per i dati ordinali, tecniche come percentuali cumulative o ranghi mediani offrono approfondimenti più ricchi sulla tendenza centrale, preservando l’ordine senza supporre intervalli uguali.
I metodi computazionali emergenti e le tecniche di data science continuano a perfezionare la nostra comprensione della tendenza centrale. Nuovi approcci consentono analisi più sfumate anche in dataset complessi e ad alta dimensionalità. Le ricerche e gli sviluppi futuri nel campo della tendenza centrale potrebbero concentrarsi su misure adattive che si regolano automaticamente per asimmetria o contaminazione dei dati, garantendo ancora maggiore robustezza e interpretabilità.
Se ti interessa migliorare le tue competenze sui dati e vuoi una base più solida di statistica in Python e R, prendi in considerazione i nostri percorsi di competenze, che consiglio vivamente:
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



