在求学期间,我有机会参与多个机器学习研究项目。这些项目既包括对概率模型的研究,也涵盖了更贴近实际的自然语言处理场景。我所做工作的共同点在于:问题定义清晰,且有大量干净的数据集可用。
过去一年,我在微软担任数据科学家,为企业客户解决问题。跨行业的实践以多种方式检验了我的能力,无论是数据科学视角还是问题解决视角。项目中很大一部分时间通常花在问题定义、构建数据集和清洗数据上,而且大型数据集几乎总是难以获得。
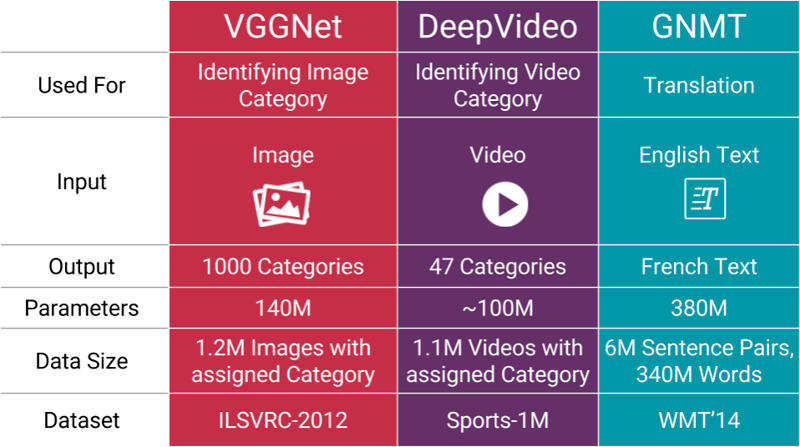 不同研究领域使用的数据集规模示例。来源
在这篇博文中,我将分享一些心得体会,以及您在“真实环境”中做数据科学项目时可能遇到的陷阱。很多陷阱几乎总会出现,往往需要一些“创意”来化解。
陷阱
描述性、预测性与规范性分析
利用数据改进业务流程有多种方式。您通常从客户那里接到的任务是“解决业务问题X”。一个具体的例子是“提升营销活动的盈利能力”。
一个常见陷阱是没有按“正确”的顺序处理问题。如果要改进流程,您需要先彻底理解它,再考虑自动化其中的部分。客户往往对自己的数据了解有限,也没有数据科学经验。因此,非常有必要从数据科学的角度,向他们清晰解释可选方案。
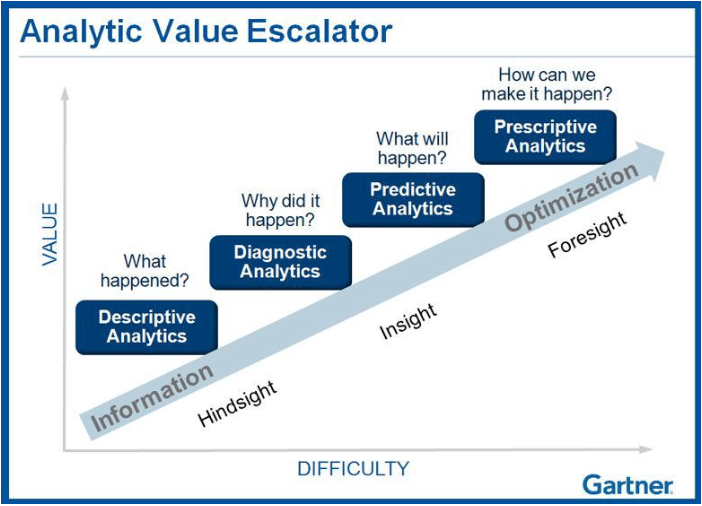 数据分析的价值:从描述性到规范性分析 来源
很多时候,项目从数据清洗与分析开始。当您旨在汇总数据并理解其中变量之间关系时,通常会用到“描述性与诊断性”分析。您会构建可视化,并使用(无监督)机器学习技术对数据点进行聚类或寻找相关变量。基于这一过程的结果,您可以制作报告或仪表板,列出并分析与业务问题相关的一组KPI。针对营销活动,您可以关联销售与营销数据,以理解活动为何成功。结论(例如“价格更低会带来更多销售”)也许并非“高深结论”,但能让客户用自己的数据验证假设。此外,这也有助于他们发现异常行为,并判断自己是否拥有合适类型的数据。
预测性与规范性分析关注预测未来,并基于预测采取行动。预测性分析会使用历史数据,训练一个机器学习模型来预测未来的数据点(在某个误差范围内)。在营销中,新的活动创意往往通过预测模型来估计预期销量以进行验证。完成前面的描述性与诊断性阶段后,您应当对性能预期有清晰认识。如果数据质量不足以构建稳健模型,应当向客户发出预警,并以他们提供的数据作为依据支撑您的判断。
规范性分析的目标是基于预测采取行动,优化流程的特定方面。与其验证活动创意,不如构建一个优化引擎,自动生成“最佳未来活动”清单。构建此类系统需要大量高质量数据。请注意,数据科学的要义是“少承诺,多交付”,所以从小处着手,再逐步扩展!
概念验证(PoC)与试点(Pilot)
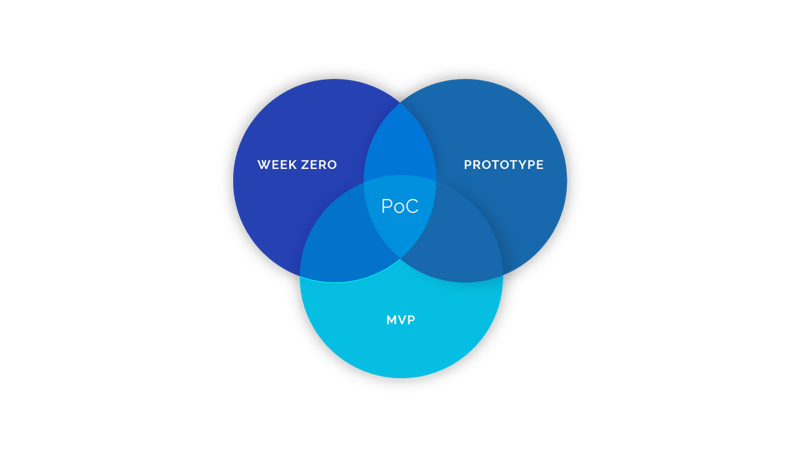
客户常常希望先做概念验证,以探索“数据科学”能做什么。通常这意味着他们会提供一部分数据,想先得到一些初步结果。尽管客户一般明白PoC的性能不会太好,但这仍是常见诉求。然而,PoC的弊端在于:数据子集往往无法代表完整数据集与问题。您也许能在PoC上得到“极好”的性能,却无法在全量数据上复现。客户可能只选取很短的时间片段来构建数据集,这会让PoC模型产生严重偏差。
 来源
如果客户想要试验,更好的选择是做试点。在试点中,您会使用全量数据,并跑通数据科学流水线的初始迭代(数据清洗、建模等)。使用全量数据可以显著降低项目风险。由于时间有限,模型性能可能仍不理想,但至少能够得到具有代表性的结论。
具有代表性的数据集
虽然这个陷阱与前一个相似,但并不相同。特别是在处理非结构化数据(如图像、文本等)时,客户可能在您介入之前就已经收集了一批数据。数据集中一个关键但常被忽视的要素是:它是否能代表真实用例。如果需要采集数据,采集方式应与模型最终的使用方式保持一致。
例如,如果您想用计算机视觉做库存管理,就必须获取模型将要使用场景中的图像,如店内或冰箱中的物品图像。目录式图片并不能训练出稳健模型,因为它们无法代表真实用例。模型必须学到稳健特征,才能在实际环境中检测到目标物体。
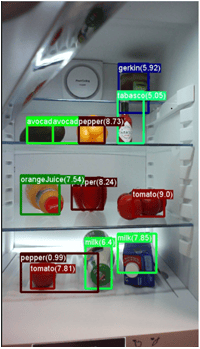
很难想象终端用户的冰箱会这么干净!
 左图对右侧用例的代表性并不强!
数据科学的金科玉律是:当问题一开始就出现异常高的性能(>90%)时,要保持警惕。项目初期的高性能可能意味着存在“泄露”变量或“泄露”的数据集。泄露变量是与目标变量高度相关、且在推理时不太可能可用的变量。如果目标是预测销量,您不能把其他产品的销量作为特征,因为推理时拿不到这类数据。“泄露”的数据集则是指只反映了某个特定(时间)片段的数据集。待解决的问题会变得容易得多,模型很可能拟合到数据噪声,而不是实际信号。
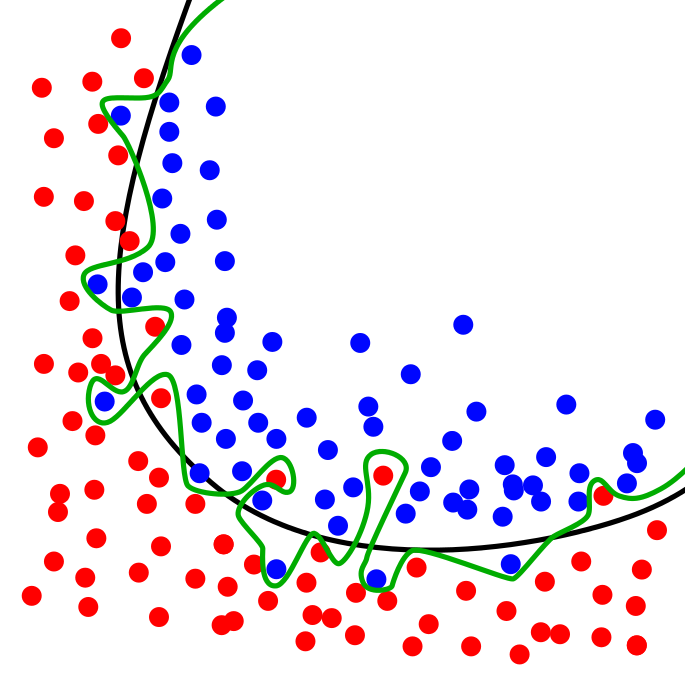 机器学习中最容易做成的事就是过拟合!来源
高性能当然好,但前提是它在一套全新且随机的数据集上也同样出色!
将相关性误解为因果性
我非常喜欢这篇关于统计谬误的博文。把相关性当作因果性只是常见错误之一,要想避免这些错误,牢固掌握其背后的统计学至关重要。
模型与数据的可解释性
如果客户要依据模型的输出采取行动,他们总是更偏好可解释、可理解的解决方案。在这篇博文中,我深入讨论了为何模型可解释性至关重要,并更详细介绍了可用的不同技术。
结论
本文只触及了6个潜在的数据科学陷阱,但我相信在过去一年里我犯过的错误远不止这些。如果您在数据科学项目上有经验,并愿意分享常见问题,欢迎在评论区留言。我在Medium和Twitter上更新博文,欢迎关注!
欢迎查看 DataCamp 的教程:如何防止机器学习中的过拟合。
如果您想进一步学习数据科学,欢迎查看 DataCamp 的R 入门和Python 入门课程。


在求学期间,我有机会参与多个机器学习研究项目。这些项目既包括对概率模型的研究,也涵盖了更贴近实际的自然语言处理场景。我所做工作的共同点在于:问题定义清晰,且有大量干净的数据集可用。
过去一年,我在微软担任数据科学家,为企业客户解决问题。跨行业的实践以多种方式检验了我的能力,无论是数据科学视角还是问题解决视角。项目中很大一部分时间通常花在问题定义、构建数据集和清洗数据上,而且大型数据集几乎总是难以获得。
在这篇博文中,我将分享一些心得体会,以及您在“真实环境”中做数据科学项目时可能遇到的陷阱。很多陷阱几乎总会出现,往往需要一些“创意”来化解。
陷阱
描述性、预测性与规范性分析
利用数据改进业务流程有多种方式。您通常从客户那里接到的任务是“解决业务问题X”。一个具体的例子是“提升营销活动的盈利能力”。
一个常见陷阱是没有按“正确”的顺序处理问题。如果要改进流程,您需要先彻底理解它,再考虑自动化其中的部分。客户往往对自己的数据了解有限,也没有数据科学经验。因此,非常有必要从数据科学的角度,向他们清晰解释可选方案。
很多时候,项目从数据清洗与分析开始。当您旨在汇总数据并理解其中变量之间关系时,通常会用到“描述性与诊断性”分析。您会构建可视化,并使用(无监督)机器学习技术对数据点进行聚类或寻找相关变量。基于这一过程的结果,您可以制作报告或仪表板,列出并分析与业务问题相关的一组KPI。针对营销活动,您可以关联销售与营销数据,以理解活动为何成功。结论(例如“价格更低会带来更多销售”)也许并非“高深结论”,但能让客户用自己的数据验证假设。此外,这也有助于他们发现异常行为,并判断自己是否拥有合适类型的数据。
预测性与规范性分析关注预测未来,并基于预测采取行动。预测性分析会使用历史数据,训练一个机器学习模型来预测未来的数据点(在某个误差范围内)。在营销中,新的活动创意往往通过预测模型来估计预期销量以进行验证。完成前面的描述性与诊断性阶段后,您应当对性能预期有清晰认识。如果数据质量不足以构建稳健模型,应当向客户发出预警,并以他们提供的数据作为依据支撑您的判断。
规范性分析的目标是基于预测采取行动,优化流程的特定方面。与其验证活动创意,不如构建一个优化引擎,自动生成“最佳未来活动”清单。构建此类系统需要大量高质量数据。请注意,数据科学的要义是“少承诺,多交付”,所以从小处着手,再逐步扩展!
概念验证(PoC)与试点(Pilot)
客户常常希望先做概念验证,以探索“数据科学”能做什么。通常这意味着他们会提供一部分数据,想先得到一些初步结果。尽管客户一般明白PoC的性能不会太好,但这仍是常见诉求。然而,PoC的弊端在于:数据子集往往无法代表完整数据集与问题。您也许能在PoC上得到“极好”的性能,却无法在全量数据上复现。客户可能只选取很短的时间片段来构建数据集,这会让PoC模型产生严重偏差。
如果客户想要试验,更好的选择是做试点。在试点中,您会使用全量数据,并跑通数据科学流水线的初始迭代(数据清洗、建模等)。使用全量数据可以显著降低项目风险。由于时间有限,模型性能可能仍不理想,但至少能够得到具有代表性的结论。
具有代表性的数据集
虽然这个陷阱与前一个相似,但并不相同。特别是在处理非结构化数据(如图像、文本等)时,客户可能在您介入之前就已经收集了一批数据。数据集中一个关键但常被忽视的要素是:它是否能代表真实用例。如果需要采集数据,采集方式应与模型最终的使用方式保持一致。
例如,如果您想用计算机视觉做库存管理,就必须获取模型将要使用场景中的图像,如店内或冰箱中的物品图像。目录式图片并不能训练出稳健模型,因为它们无法代表真实用例。模型必须学到稳健特征,才能在实际环境中检测到目标物体。
很难想象终端用户的冰箱会这么干净!
高性能与过拟合
数据科学的金科玉律是:当问题一开始就出现异常高的性能(>90%)时,要保持警惕。项目初期的高性能可能意味着存在“泄露”变量或“泄露”的数据集。泄露变量是与目标变量高度相关、且在推理时不太可能可用的变量。如果目标是预测销量,您不能把其他产品的销量作为特征,因为推理时拿不到这类数据。“泄露”的数据集则是指只反映了某个特定(时间)片段的数据集。待解决的问题会变得容易得多,模型很可能拟合到数据噪声,而不是实际信号。
高性能当然好,但前提是它在一套全新且随机的数据集上也同样出色!
将相关性误解为因果性
我非常喜欢这篇关于统计谬误的博文。把相关性当作因果性只是常见错误之一,要想避免这些错误,牢固掌握其背后的统计学至关重要。
模型与数据的可解释性
如果客户要依据模型的输出采取行动,他们总是更偏好可解释、可理解的解决方案。在这篇博文中,我深入讨论了为何模型可解释性至关重要,并更详细介绍了可用的不同技术。
结论
本文只触及了6个潜在的数据科学陷阱,但我相信在过去一年里我犯过的错误远不止这些。如果您在数据科学项目上有经验,并愿意分享常见问题,欢迎在评论区留言。我在Medium和Twitter上更新博文,欢迎关注!
欢迎查看 DataCamp 的教程:如何防止机器学习中的过拟合。
如果您想进一步学习数据科学,欢迎查看 DataCamp 的R 入门和Python 入门课程。