कोर्स
Understanding Machine Learning
2 घंटा
311.6K
अपनी पढ़ाई के दौरान मुझे कई मशीन लर्निंग शोध परियोजनाओं पर काम करने का अवसर मिला। ये परियोजनाएँ प्रायिकता मॉडल का अध्ययन करने से लेकर प्राकृतिक भाषा संसाधन के अधिक व्यावहारिक परिदृश्यों तक फैली हुई थीं। मेरे काम का एक सामान्य तत्व था—अच्छी तरह परिभाषित समस्याओं की उपलब्धता और साफ-सुथरे डेटासेट्स की प्रचुरता।
पिछले वर्ष से, मैं Microsoft में डेटा साइंटिस्ट के रूप में काम कर रहा हूँ, जहाँ एंटरप्राइज़ ग्राहकों की समस्याएँ सुलझाता हूँ। विभिन्न उद्योगों में काम करने से मिली सीख ने मेरी क्षमताओं को कई तरह से परखा—डेटा साइंस के नजरिए से भी और समस्या-समाधान के नजरिए से भी। आम तौर पर समय का बड़ा हिस्सा समस्या को परिभाषित करने, डेटासेट बनाने और डेटा की सफाई में जाता है, और बड़े डेटासेट्स लगभग हमेशा कम ही मिलते हैं।
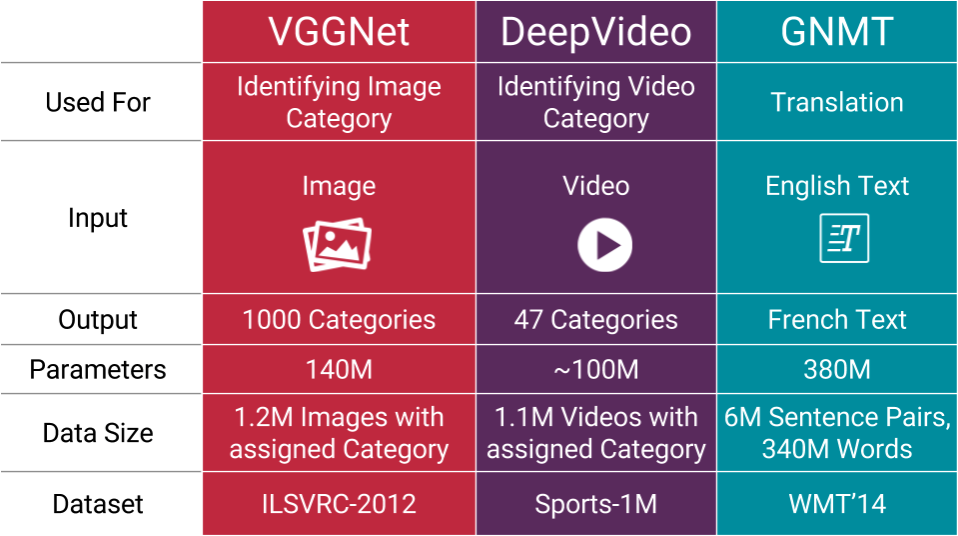
इस ब्लॉग पोस्ट में मैं कुछ सीखी हुई बातें और वे गलतियाँ साझा कर रहा हूँ जिनका सामना आपको डेटा साइंस प्रोजेक्ट्स पर ‘वास्तविक दुनिया’ में काम करते हुए हो सकता है। इनमें से कई गलतियाँ लगभग हमेशा मौजूद रहती हैं, और अक्सर इन्हें सुलझाने के लिए ‘रचनात्मक’ होना पड़ता है।
व्यावसायिक प्रक्रियाओं में सुधार के लिए डेटा का लाभ उठाने के कई तरीके हैं। ग्राहक से आपको आमतौर पर जो असाइनमेंट मिलता है वह होता है ‘व्यवसाय समस्या X को हल करें’। एक ठोस उदाहरण है—‘मार्केटिंग अभियानों की लाभप्रदता बढ़ाएँ’।
एक आम गलती है समस्याओं को ‘सही’ क्रम में न सुलझाना। यदि आप किसी प्रक्रिया में सुधार करना चाहते हैं, तो उसके कुछ हिस्सों के स्वचालन के बारे में सोचने से पहले उसे ठीक से समझना आवश्यक है। ग्राहकों को आमतौर पर अपने ही डेटा के बारे में सीमित जानकारी होती है और डेटा साइंस का अनुभव नहीं होता। इसलिए उनके सामने डेटा साइंस के नजरिए से उपलब्ध विकल्पों को स्पष्ट रूप से समझाना बहुत महत्वपूर्ण है।
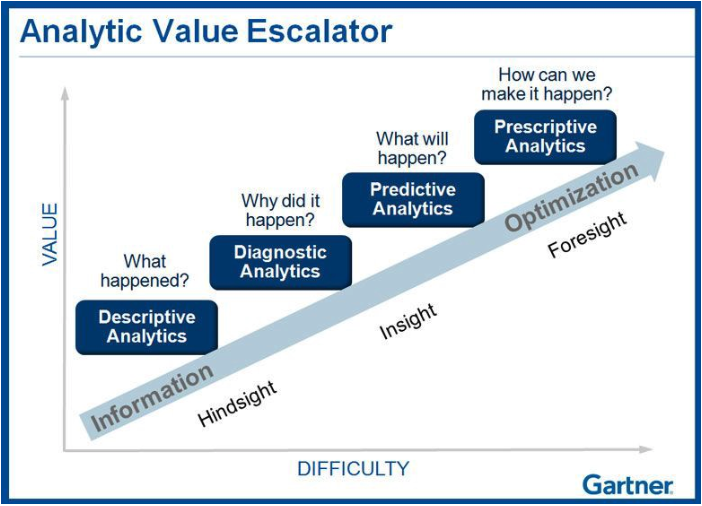
अक्सर, आप परियोजना की शुरुआत डेटा साफ़ करने और उसका विश्लेषण करने से करते हैं। जब आप डेटा के सारांश बनाते हैं और यह समझने की कोशिश करते हैं कि डेटा में विभिन्न चर का आपस में क्या संबंध है, तो ‘वर्णनात्मक और निदानात्मक’ विश्लेषण जैसे शब्दों का उपयोग होता है। आप विज़ुअलाइज़ेशन बनाते हैं और (अनसुपर्वाइज़्ड) मशीन लर्निंग तकनीकों का उपयोग करके डेटा बिंदुओं को क्लस्टर करते हैं या सह-संबंधित चर खोजते हैं। प्रक्रिया के परिणाम के आधार पर, आप उदाहरण के लिए एक रिपोर्ट या डैशबोर्ड बना सकते हैं, जो व्यावसायिक समस्या के लिए उपयोगी KPI’s की सूची बनाता है और उनकी जाँच करता है। मार्केटिंग अभियानों में, आप यह समझने के लिए बिक्री और मार्केटिंग डेटा का सह-संबंध कर सकते हैं कि अभियान सफल क्यों होते हैं। निष्कर्ष (जैसे—कम कीमत से अधिक बिक्री होती है) हमेशा ‘बहुत जटिल’ नहीं लग सकते, लेकिन वे ग्राहक को अपने डेटा का उपयोग करके अपनी परिकल्पनाओं का सत्यापन करने देते हैं। इसके अलावा, यह उन्हें असामान्य व्यवहार को पकड़ने और यह आकलन करने में भी मदद करता है कि उनके पास सही तरह का डेटा है या नहीं।
पूर्वानुमानात्मक और नुस्खानात्मक विश्लेषण भविष्य की भविष्यवाणी करने और उन भविष्यवाणियों के आधार पर कार्रवाई करने के बारे में है। पूर्वानुमानात्मक विश्लेषण में आप ऐतिहासिक डेटा लेते हैं और भविष्य के डेटा बिंदुओं की भविष्यवाणी करने के लिए एक मशीन लर्निंग मॉडल बनाते हैं (एक निश्चित त्रुटि सीमा के भीतर)। मार्केटिंग में, नए अभियान विचारों को अक्सर एक पूर्वानुमानात्मक मॉडल का उपयोग करके अपेक्षित बिक्री का अनुमान लगाकर परखा जाता है। यदि आपने पहले वर्णनात्मक और निदानात्मक चरण पूरा कर लिया है, तो आपको प्रदर्शन के लिहाज़ से क्या अपेक्षित है, इसकी स्पष्ट समझ होनी चाहिए। यदि मज़बूत मॉडल बनाने के लिए डेटा की गुणवत्ता पर्याप्त नहीं है, तो इसे ग्राहक के सामने चिह्नित किया जा सकता है और आप उनके ही प्रदान किए गए डेटा से अपने दावों का समर्थन कर सकते हैं।
नुस्खानात्मक विश्लेषण में लक्ष्य भविष्यवाणियों के आधार पर कार्रवाई करना और प्रक्रिया के कुछ पहलुओं का अनुकूलन करना है। अभियान विचारों को मान्य करने के बजाय, आप उदाहरण के लिए एक ऑप्टिमाइज़ेशन इंजन बना सकते हैं जो ‘सर्वश्रेष्ठ भावी अभियानों’ की सूची जनरेट करे। इस सिस्टम का निर्माण उच्च गुणवत्ता वाले बड़े पैमाने के डेटा की मांग करता है। ध्यान रखें कि डेटा साइंस का सिद्धांत है—कम वादा करें और ज़्यादा डिलीवर करें, इसलिए छोटा शुरू करें और बड़ा बनाएं!
ग्राहक अक्सर यह देखने के लिए कि ‘डेटा साइंस’ से क्या संभव है, प्रूफ ऑफ कॉन्सेप्ट के साथ काम करना पसंद करते हैं। आमतौर पर इसका मतलब होता है कि वे डेटा का कोई उपसमुच्चय प्रदान करते हैं, और वे कुछ प्रारंभिक परिणाम देखना चाहते हैं। भले ही ग्राहक आमतौर पर समझते हैं कि PoC के साथ अच्छा प्रदर्शन नहीं मिलेगा, फिर भी यह एक आम अनुरोध है। हालांकि PoC की कमी यह है कि डेटा का उपसमुच्चय अक्सर पूरे डेटासेट और समस्या का प्रतिनिधि नहीं होता। आपको PoC में अत्यंत अच्छा प्रदर्शन मिल सकता है, पर पूरे डेटासेट पर इसे दोहराना संभव न हो। ग्राहक, उदाहरण के लिए, केवल एक छोटे समय-खंड को देखकर डेटासेट चुनते हैं, जो PoC मॉडल में भारी पक्षपात ला सकता है।
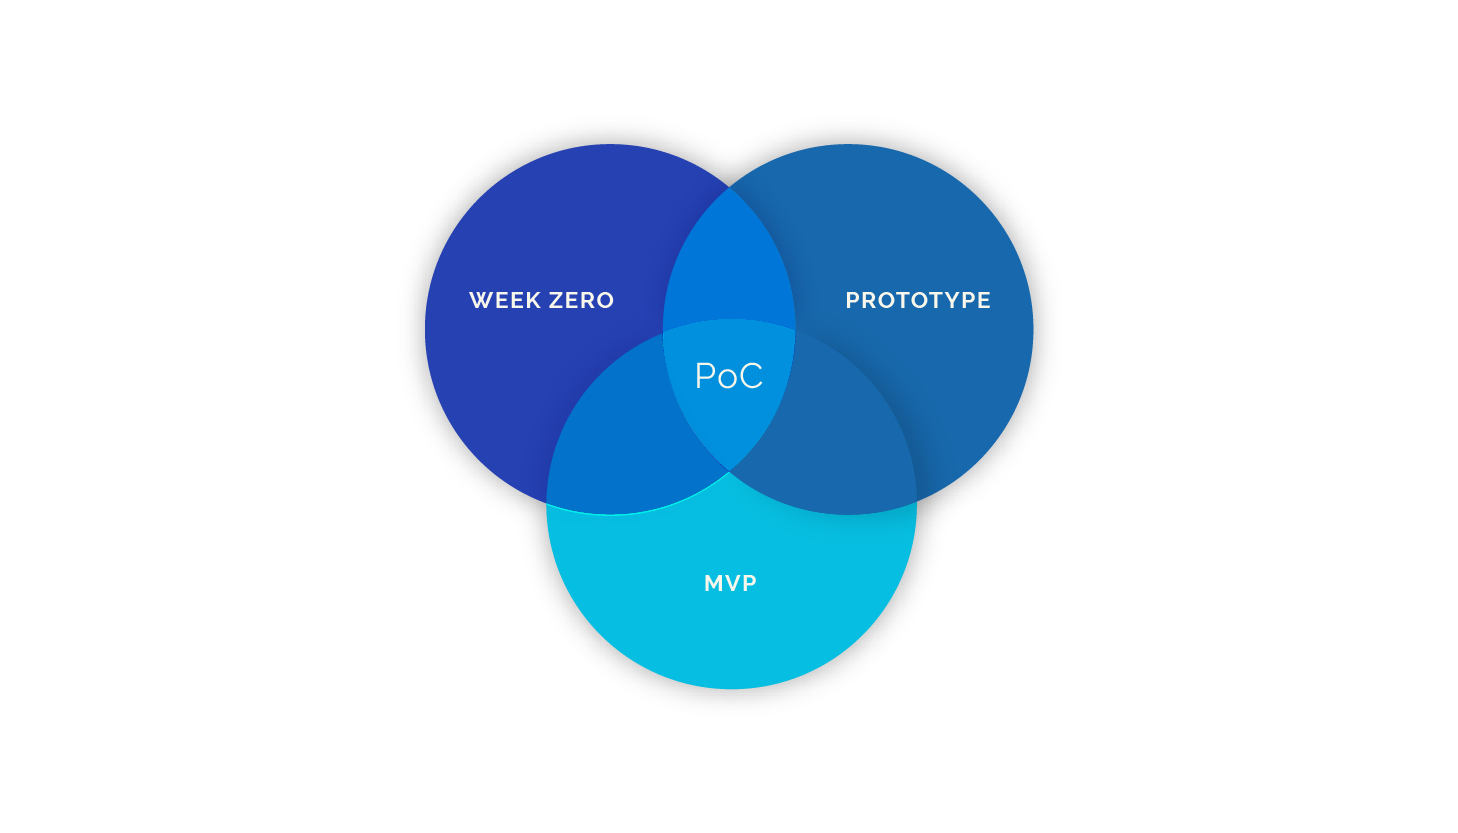
यदि ग्राहक प्रयोग करना चाहता है, तो इससे बेहतर विकल्प है पायलट पर काम करना। पायलट में, आप पूरे डेटासेट के साथ काम करते हैं और डेटा साइंस पाइपलाइन (डेटा सफाई, मॉडलिंग, आदि) का एक प्रारंभिक चक्र चलाते हैं। पूरे डेटासेट के साथ काम करने से परियोजना के कई जोखिम कम हो जाते हैं। सीमित समय के कारण मॉडल का प्रदर्शन अभी भी इष्टतम नहीं होगा, लेकिन कम से कम आपको एक प्रतिनिधि तस्वीर मिल जानी चाहिए।
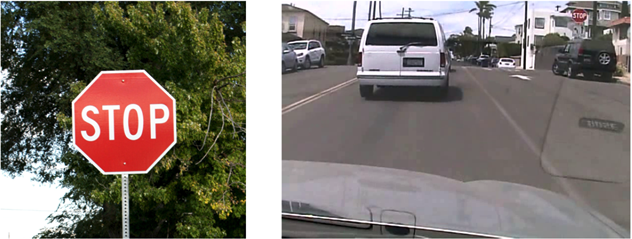
हालाँकि यह गलती पिछली वाली से मिलती-जुलती है, पर वही नहीं है। खासकर जब आप असंरचित डेटा (जैसे—इमेजेस, टेक्स्ट डेटा, आदि) के साथ काम करते हैं, तो संभव है कि परियोजना शुरू करने से पहले ही ग्राहक ने डेटा एकत्र कर रखा हो। डेटासेट का एक महत्वपूर्ण, लेकिन अक्सर नज़रअंदाज़ किया जाने वाला तत्व यह है कि क्या वह उपयोग के मामले का प्रतिनिधि है। यदि डेटासेट इकट्ठा करने हैं, तो उसे उसी तरह इकट्ठा किया जाना चाहिए जैसे अंततः मॉडल का उपयोग होगा।
उदाहरण के लिए, यदि आप कंप्यूटर विज़न का उपयोग करके इन्वेंटरी प्रबंधन करना चाहते हैं, तो यह महत्वपूर्ण है कि उन वस्तुओं की तस्वीरें हों जो स्टोर या फ्रिज में हों—यानी जहाँ मॉडल का उपयोग होगा। कैटलॉग-प्रकार की इमेजेस मज़बूत मॉडल नहीं देंगी, क्योंकि वे उपयोग के मामले का प्रतिनिधित्व नहीं करतीं। मॉडल को पर्यावरण में वस्तु का पता लगाने के लिए मज़बूत फीचर्स सीखने चाहिए।
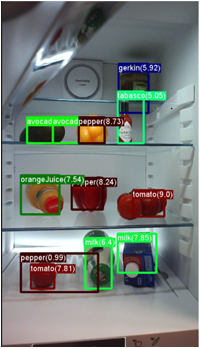
यह कल्पना करना कठिन है कि अंतिम उपयोगकर्ताओं का फ्रिज इतना साफ-सुथरा होगा!
डेटा साइंस का स्वर्ण नियम है—यदि समस्या की शुरुआत में आपको अत्यधिक अच्छा प्रदर्शन (>90%) मिले तो संदिग्ध रहें। परियोजना की शुरुआत में अच्छा प्रदर्शन मिलना ‘लीकी’ वेरिएबल्स या ‘लीकी’ डेटासेट का संकेत हो सकता है। लीकी वेरिएबल्स वे होते हैं जो लक्ष्य चर के साथ अत्यधिक सह-संबंधित हों और अनुमान के समय उपलब्ध होने की संभावना न हो। यदि लक्ष्य बिक्री का पूर्वानुमान लगाना है, तो आप अन्य उत्पादों की बिक्री को फीचर के रूप में उपयोग नहीं कर सकते क्योंकि यह डेटा उपलब्ध नहीं होगा। ‘लीकी’ डेटासेट तब होता है जब डेटासेट केवल किसी एक (समय) खंड को दर्शाता है। सुलझाई जाने वाली समस्या आमतौर पर काफी आसान हो जाती है, और संभव है कि मॉडल असली संकेत की बजाय डेटा के शोर पर फिट होने लगे।
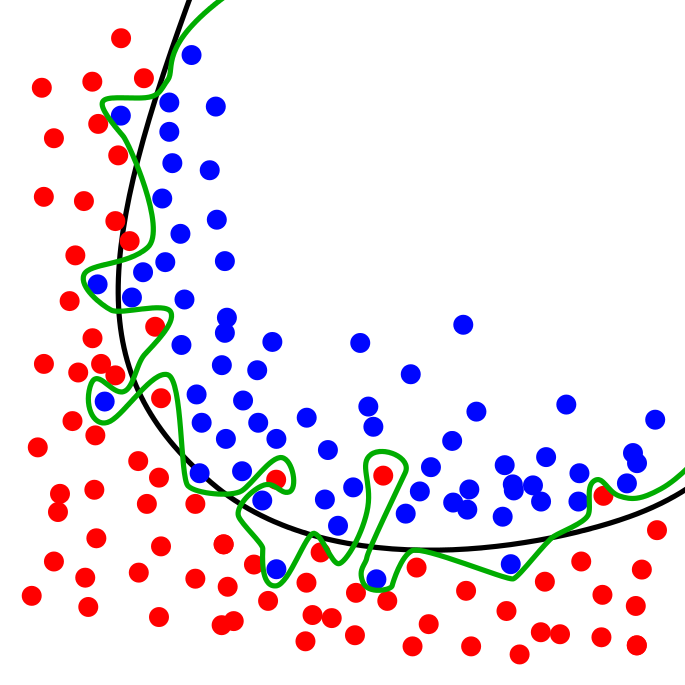
उच्च प्रदर्शन वाला मॉडल बेहतरीन है—लेकिन तभी, जब वह बिल्कुल नए और यादृच्छिक डेटासेट पर भी उतना ही अच्छा प्रदर्शन करे!
मुझे सांख्यिकीय भ्रांतियों पर यह ब्लॉग पोस्ट बहुत पसंद आया। सह-संबंध को कारणता समझ लेना अक्सर होने वाली त्रुटियों में से केवल एक है, और इनके पीछे के आँकड़ों की ठोस समझ होना बहुत अहम है।
यदि कोई ग्राहक मॉडल को कार्रवाई का आधार बनाता है, तो वह हमेशा ऐसे समाधानों को प्राथमिकता देगा जो व्याख्यायोग्य और समझने योग्य हों। इस ब्लॉग पोस्ट में, मैंने विस्तार से बताया है कि मॉडल व्याख्यात्मकता क्यों महत्वपूर्ण है। मैंने उन विभिन्न तकनीकों पर भी गहराई से नज़र डाली है जिनका आप उपयोग कर सकते हैं।
मैंने यहाँ केवल 6 संभावित डेटा साइंस गलतियों को छुआ है, लेकिन मुझे यक़ीन है कि मैंने पिछले वर्ष में इससे कहीं अधिक त्रुटियाँ की होंगी। यदि आपके पास डेटा साइंस प्रोजेक्ट्स का अनुभव है और आप अपनी आम समस्याएँ साझा करना चाहते हैं, तो मुझे उन्हें टिप्पणियों में पढ़कर खुशी होगी। मेरे ब्लॉग पोस्ट के अपडेट पाने के लिए मुझे Medium या Twitter पर फ़ॉलो करें!
DataCamp का ट्यूटोरियल देखें: Machine Learning में Overfitting से बचाव।
यदि आप डेटा साइंस के बारे में और सीखने में रुचि रखते हैं, तो DataCamp के Intro to R और Intro to Python पाठ्यक्रम देखें।
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स