Cours
Comprendre le Machine Learning
2 h
308.2K
Pendant mes études, j’ai eu l’occasion de travailler sur plusieurs projets de recherche en apprentissage automatique. Ces projets allaient de l’étude de modèles probabilistes à des scénarios plus pratiques en traitement automatique du langage naturel. Un point commun à tous ces travaux : des problèmes bien définis et une abondance de jeux de données propres.
Depuis un an, je travaille comme Data Scientist chez Microsoft, où j’aide des clients grands comptes à résoudre leurs problématiques. L’expérience acquise, tous secteurs confondus, a mis mes compétences à l’épreuve sous de multiples angles, à la fois en data science et en résolution de problèmes. Une grande partie du temps consiste à définir le problème, constituer un jeu de données et le nettoyer ; et l’accès à de grands volumes de données de qualité est loin d’être garanti.
Dans cet article, je partage quelques enseignements et pièges que vous risquez de rencontrer en menant des projets de data science « sur le terrain ». Beaucoup de ces écueils sont quasi systématiques, et il faut souvent faire preuve de « créativité » pour les surmonter.
Il existe plusieurs manières d’exploiter les données pour améliorer les processus métiers. La demande client type se résume souvent à « résoudre le problème métier X ». Un exemple concret serait par exemple « améliorer la rentabilité des campagnes marketing ».
Un piège fréquent consiste à ne pas traiter les problèmes dans le « bon » ordre. Si vous souhaitez améliorer un processus, vous devez d’abord bien le comprendre, avant même d’envisager d’en automatiser des parties. Les clients ont généralement une connaissance limitée de leurs propres données et peu d’expérience en data science. Il est donc essentiel de leur expliquer clairement les différentes options possibles d’un point de vue data science.
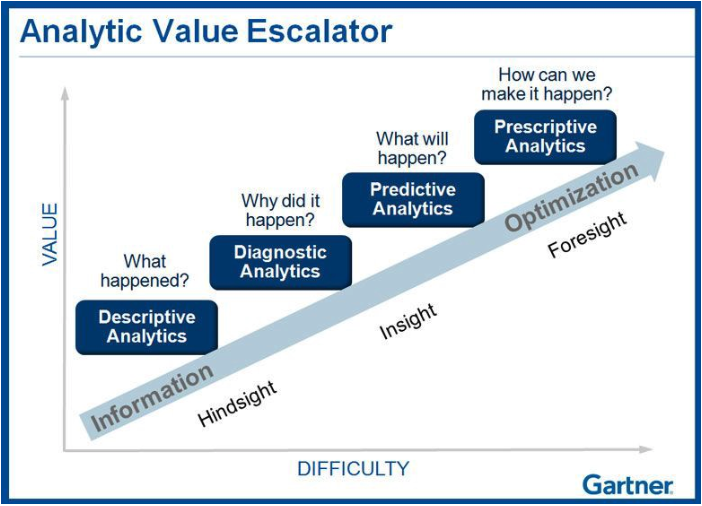
Souvent, vous démarrez le projet par le nettoyage et l’analyse des données. On parle d’analytique « descriptive et diagnostique » lorsqu’il s’agit de produire des synthèses des données et de comprendre comment les variables se relient entre elles. Vous créez des visualisations et utilisez des techniques (non supervisées) d’apprentissage automatique pour regrouper des points de données ou identifier des variables corrélées. À l’issue de ce travail, vous pouvez, par exemple, produire un rapport ou un tableau de bord listant et analysant un ensemble de KPI utiles pour le problème métier. Pour des campagnes marketing, vous pourriez corréler ventes et données marketing afin de comprendre pourquoi certaines campagnes réussissent. Les conclusions (par ex. un prix plus bas génère plus de ventes) n’ont rien de « révolutionnaire », mais elles permettent au client de valider ses hypothèses sur ses propres données. Elles lui permettent aussi de repérer des comportements anormaux et de vérifier qu’il dispose des bonnes données.
L’analytique prédictive et prescriptive consiste à anticiper l’avenir et à agir sur la base de ces prédictions. Avec le prédictif, vous exploitez l’historique pour entraîner un modèle d’apprentissage automatique capable de prévoir de futurs points de données (dans une certaine marge d’erreur). En marketing, de nouvelles idées de campagnes sont souvent évaluées en estimant les ventes attendues via un modèle prédictif. Après la phase descriptive et diagnostique, vous devriez avoir une idée claire des performances auxquelles vous attendre. Si la qualité des données ne permet pas de bâtir un modèle robuste, vous pouvez l’indiquer au client et étayer vos arguments avec ses données.
Avec l’analytique prescriptive, l’objectif est d’agir à partir des prédictions et d’optimiser certains aspects du processus. Plutôt que de valider des idées de campagnes, vous pourriez, par exemple, construire un moteur d’optimisation capable de proposer la liste des « meilleures campagnes futures ». Ce type de système requiert de grandes quantités de données de haute qualité. Rappelons que la data science, c’est avant tout promettre peu et délivrer plus : commencez petit et voyez grand !
Les clients aiment souvent démarrer par un Proof of Concept pour explorer ce que permet la « data science ». Concrètement, ils fournissent un sous-ensemble des données et souhaitent obtenir des premiers résultats. Même s’ils comprennent en général qu’un PoC ne donnera pas d’excellentes performances, cette demande reste courante. Le problème d’un PoC, c’est que l’échantillon fourni est souvent peu représentatif de l’ensemble des données et du problème. Vous pourriez obtenir des performances remarquables sur le PoC, impossibles à reproduire à l’échelle complète. Les clients sélectionnent parfois les données en ne prenant qu’une courte période, ce qui peut fortement biaiser le modèle du PoC.
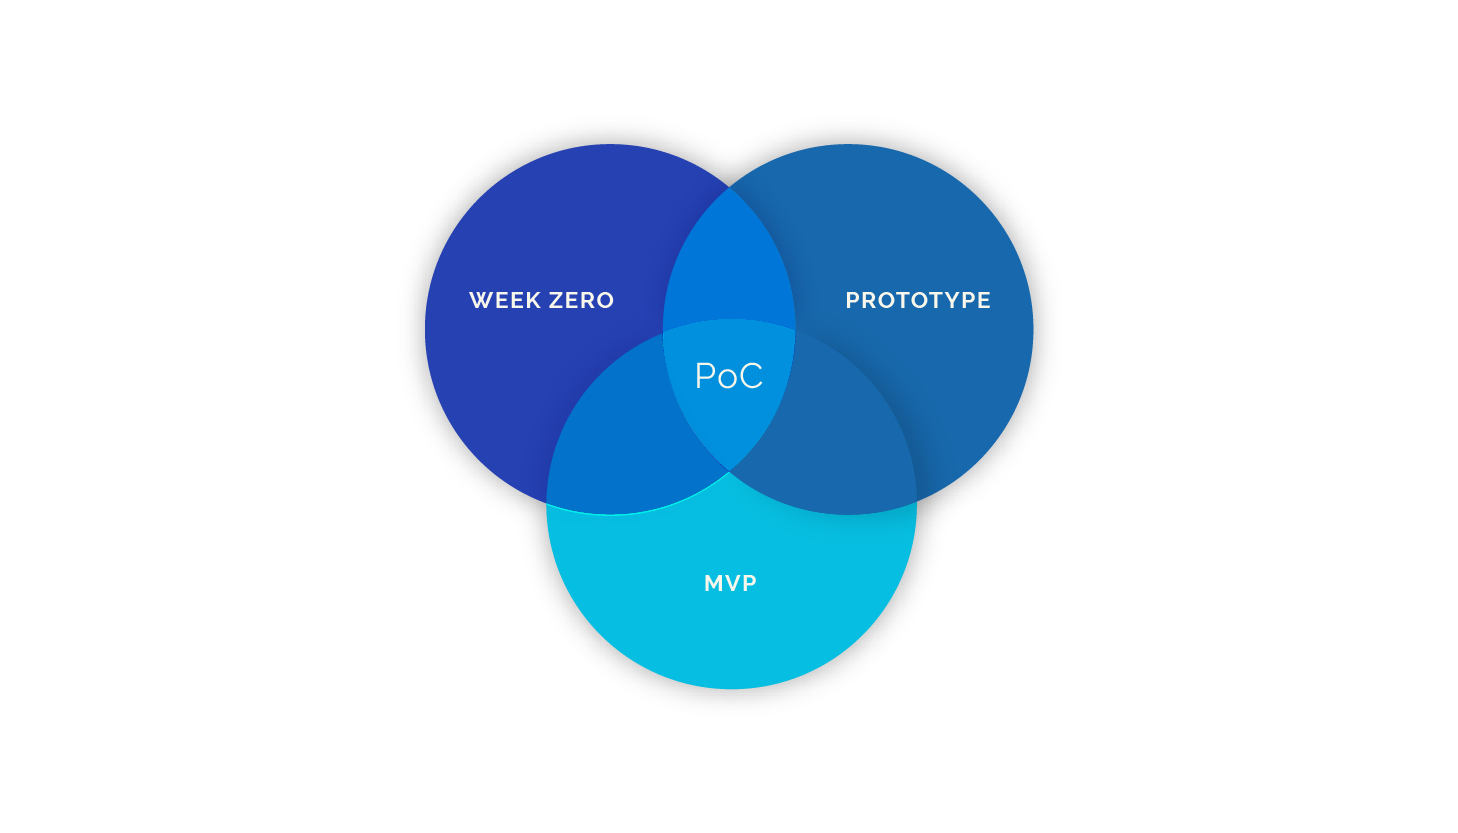
Si le client veut expérimenter, une meilleure option consiste à mener des pilotes. Dans un pilote, vous travaillez sur l’intégralité du jeu de données et vous parcourez une première itération de la chaîne data science (nettoyage, modélisation, etc.). Travailler sur les données complètes réduit fortement les risques du projet. Les performances du modèle ne seront pas encore optimales, faute de temps, mais vous obtiendrez au moins une vision représentative.
Ce piège ressemble au précédent sans être identique. En particulier avec des données non structurées (images, textes, etc.), un client peut avoir collecté des données avant le démarrage. Un point crucial, souvent négligé, est le caractère représentatif des données par rapport au cas d’usage. Si des données doivent être collectées, cela doit se faire dans des conditions similaires à celles de l’usage final du modèle.
Par exemple, si vous souhaitez faire de la gestion des stocks via la vision par ordinateur, il est important d’avoir des images d’objets dans le magasin ou le réfrigérateur, là où le modèle sera utilisé. Des images de type catalogue ne permettront pas d’obtenir un modèle robuste, car elles ne représentent pas le cas d’usage. Le modèle doit apprendre des caractéristiques robustes pour détecter l’objet dans son environnement.
On imagine mal le réfrigérateur des utilisateurs finaux aussi impeccable !
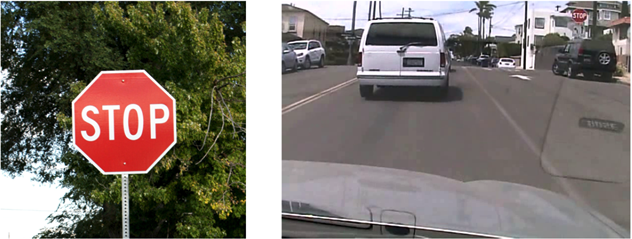
La règle d’or en data science : méfiez-vous des performances trop bonnes (> 90 %) au démarrage. De tels résultats peuvent révéler des variables « fuyardes » (leaky) ou un jeu de données « fuyant ». Les variables fuyardes sont fortement corrélées à la cible, mais peu susceptibles d’être disponibles en production. Si l’objectif est de prédire des ventes, vous ne pouvez pas utiliser les ventes d’autres produits comme variables explicatives si ces données ne seront pas disponibles à l’inférence. Un jeu de données « fuyant » survient quand l’échantillon ne reflète qu’un segment (temporel) particulier. Le problème devient artificiellement plus simple, et le modèle risque de s’ajuster au bruit plutôt qu’au signal.
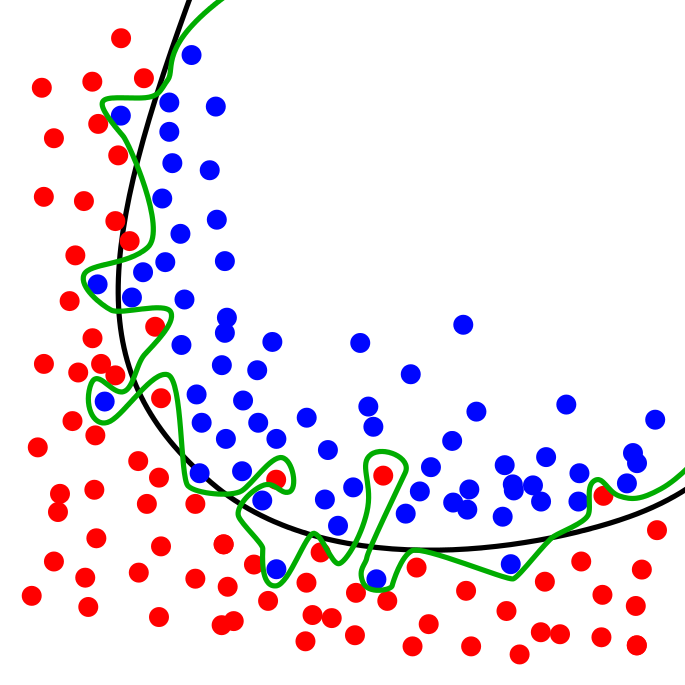
Un modèle très performant, c’est idéal… à condition qu’il soit tout aussi bon sur un nouveau jeu de données aléatoire !
J’ai beaucoup apprécié cet article sur les biais statistiques. Confondre corrélation et causalité n’est qu’un exemple parmi d’autres erreurs fréquentes ; bien en maîtriser les fondements statistiques est essentiel.
Si un client s’appuie sur le modèle pour agir, il privilégiera toujours des solutions interprétables et compréhensibles. Dans cet article, j’explique en détail pourquoi l’interprétabilité des modèles est clé et je présente plusieurs techniques utiles.
Je n’ai évoqué que 6 pièges potentiels en data science, mais je suis convaincu d’en avoir commis bien d’autres cette année. Si vous avez de l’expérience sur des projets de data science et souhaitez partager les problèmes que vous rencontrez souvent, je serai ravi de vous lire en commentaires. Suivez-moi sur Medium ou Twitter pour être informé de mes prochains billets !
Découvrez le tutoriel de DataCamp sur la prévention du surapprentissage en apprentissage automatique.
Si vous souhaitez en savoir plus sur la data science, consultez les cours de DataCamp Intro to R et Intro to Python.
Approfondissez vos connaissances en apprentissage automatique
Cours
Cours
Cours