Kurs
Machine Learning'i Anlamak
2 sa
311.4K
Öğrenimim sırasında çeşitli makine öğrenmesi araştırma projelerinde çalışma fırsatı buldum. Bu projeler, olasılıksal modellerin incelenmesinden doğal dil işlemedeki daha pratik senaryolara kadar uzanıyordu. Yaptığım işte ortak bir unsur, iyi tanımlanmış problemlerin ve bol miktarda temiz veri kümesinin bulunmasıydı.
Geçtiğimiz yıl, Microsoft’ta Veri Bilimci olarak çalıştım ve kurumsal müşterilerin problemlerini çözdüm. Sektörler arası çalışmanın kazandırdığı deneyim, becerilerimi hem veri bilimi hem de problem çözme perspektifinden çok çeşitli şekillerde sınadı. Zamanın büyük bir kısmı genellikle problemi tanımlamak, bir veri kümesi oluşturmak ve veriyi temizlemekle geçiyor ve büyük veri kümelerine ulaşmak neredeyse her zaman daha zor oluyor.
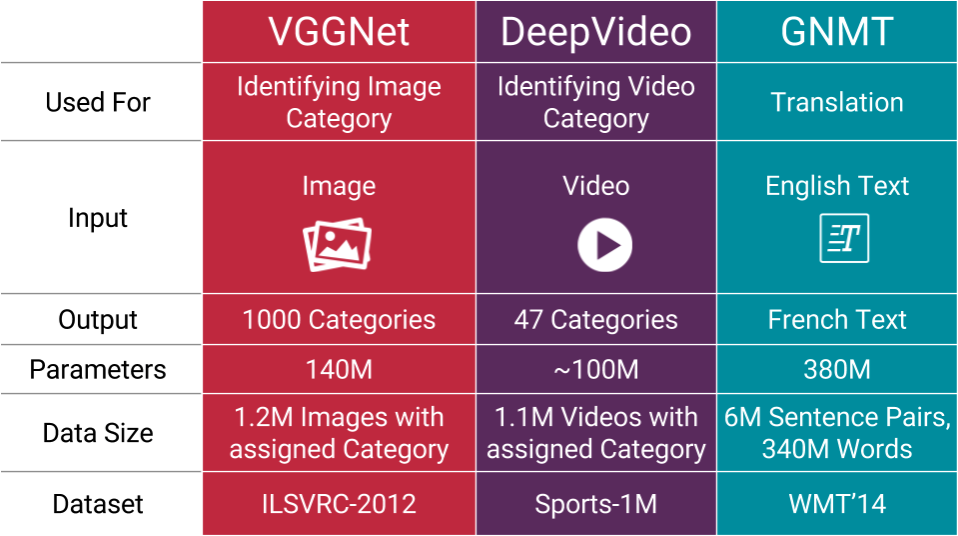
Bu blog yazısında, ‘sahada’ veri bilimi projelerinde çalışırken edindiğim bazı dersleri ve karşılaşabileceğiniz tuzakları paylaşıyorum. Bu tuzakların çoğu neredeyse her zaman karşınıza çıkar ve bunları çözmek için sıklıkla ‘yaratıcı’ olmak gerekir.
Veriler, iş süreçlerini iyileştirmek için çeşitli şekillerde kullanılabilir. Müşteriden genellikle aldığınız görev ‘İş problemi X’i çözmek’tir. Somut bir örnek olarak ‘pazarlama kampanyalarının kârlılığını artırmak’ verilebilir.
Yaygın bir tuzak, problemleri ‘doğru’ sırayla ele almamaktır. Bir süreci iyileştirmek istiyorsanız, onu otomatikleştirmeyi düşünmeden önce doğru şekilde anlamanız gerekir. Müşterilerin genellikle kendi verileri hakkında sınırlı bilgisi ve veri bilimi konusunda deneyimi yoktur. Bu nedenle veri bilimi açısından farklı seçeneklerin neler olduğunu onlara açıkça anlatmak çok önemlidir.
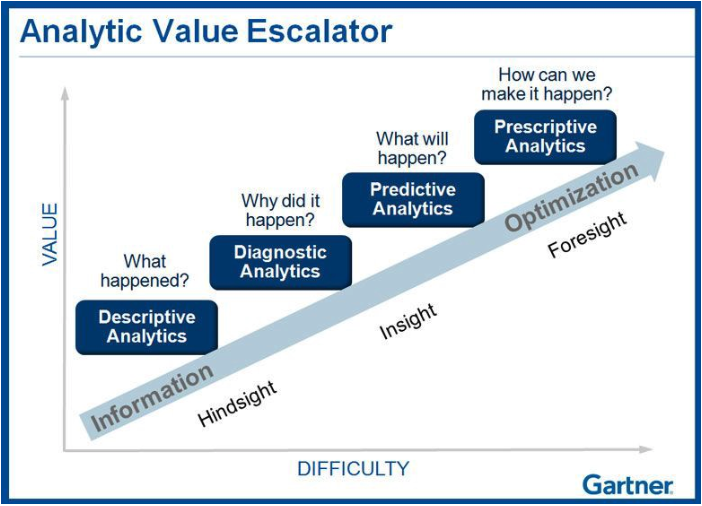
Çoğu zaman projeye veriyi temizleyip analiz ederek başlarsınız. Verinin özetlerini oluşturmayı ve veri içindeki farklı değişkenlerin nasıl ilişkili olduğunu anlamayı hedeflediğinizde ‘betimleyici ve teşhis edici’ analitik terimleri kullanılır. Görselleştirmeler yapar ve veri noktalarını kümelemek ya da ilişkili değişkenleri bulmak için (gözetimsiz) makine öğrenmesi tekniklerini kullanırsınız. Sürecin sonucuna dayanarak, örneğin iş problemine faydalı bir dizi KPI’yı listeleyen ve inceleyen bir rapor veya gösterge paneli oluşturabilirsiniz. Pazarlama kampanyalarında, kampanyaların neden başarılı olduğunu anlamak için satış ve pazarlama verilerini ilişkilendirebilirsiniz. Çıkarımlar (ör. daha düşük fiyat daha fazla satış getirir) her zaman ‘çok çarpıcı’ olmayabilir; ancak müşterinin hipotezlerini kendi verileriyle doğrulamasını sağlar. Buna ek olarak, anormal davranışları tespit etmelerine ve doğru türde veriye sahip olup olmadıklarını görmelerine de yardımcı olur.
Öngörücü ve reçeteci analitik, geleceği tahmin etmeye ve bu tahminlere dayanarak eylem almaya odaklanır. Öngörücü analitikte geçmiş veriyi alır ve gelecekteki veri noktalarını (belirli bir hata payı içinde) tahmin etmek için bir makine öğrenmesi modeli kurarsınız. Pazarlamada, yeni kampanya fikirleri genellikle öngörücü bir modelle beklenen satış tahmin edilerek doğrulanır. Önceki betimleyici ve teşhis edici aşamayı tamamladıktan sonra, performans açısından ne bekleyebileceğinize dair net bir fikriniz olur. Verinin kalitesi sağlam bir model kurmaya yetmiyorsa, bunu müşteriye işaret edebilir ve iddialarınızı onların sağladığı verilerle destekleyebilirsiniz.
Reçeteci analitikte amaç, tahminlere dayanarak eyleme geçmek ve sürecin belirli yönlerini optimize etmektir. Kampanya fikirlerini doğrulamak yerine, örneğin ‘en iyi gelecekteki kampanyalar’ listesini üretebilen bir optimizasyon motoru oluşturabilirsiniz. Bu sistemi kurmak, yüksek kalitede büyük miktarda veri gerektirir. Veri biliminin özünde beklentiyi düşük tutup fazlasını sunmak vardır; bu yüzden küçük başlayın, büyüterek ilerleyin!
Müşteriler, ‘veri bilimi’ ile nelerin mümkün olduğunu görmek için sıkça bir Kavram Kanıtı ile çalışmayı sever. Genellikle bu, verinin bir alt kümesini sağlamaları ve bazı ön sonuçlar görmek istemeleri anlamına gelir. Müşteri PoC ile iyi bir performans elde edemeyeceğinizi genellikle anlar; yine de bu sık rastlanan bir taleptir. Ancak PoC’nin dezavantajı, veri alt kümesinin çoğu zaman tüm veri kümesini ve problemi temsil etmemesidir. PoC’den son derece iyi performans alabilirsiniz; fakat bunu tam veri kümesi üzerinde tekrarlayamayabilirsiniz. Müşteriler, örneğin yalnızca kısa bir zaman dilimine bakarak veri kümesini seçebilir; bu da PoC modelini ciddi biçimde yanlı hale getirebilir.
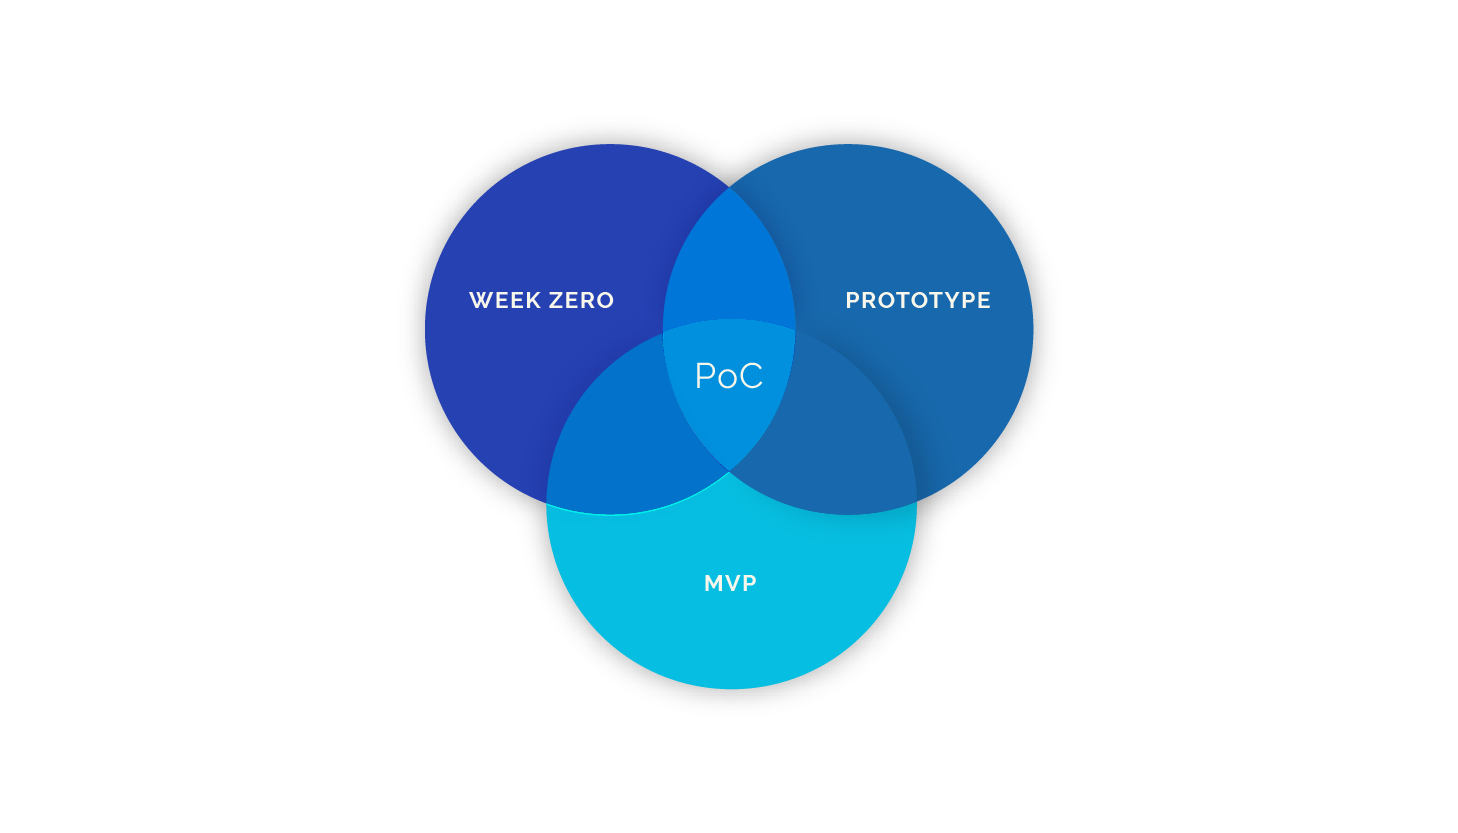
Müşteri denemek istiyorsa daha iyi bir seçenek, pilotlarla çalışmaktır. Pilotlarda, tam veri kümesiyle çalışır ve veri bilimi hattının ilk yinelemesini (veri temizleme, modelleme vb.) yürütürsünüz. Tam veri kümesiyle çalışmak, projedeki pek çok riski azaltır. Zamanınız sınırlı olduğundan modelin performansı yine de optimal olmayacaktır; ancak en azından temsil gücü yüksek bir tablo elde etmiş olmalısınız.
Bu tuzak öncekiyle benzer olsa da aynı değildir. Özellikle yapılandırılmamış verilerle (ör. görüntüler, metin verisi vb.) çalışıyorsanız, müşteri projeye başlamadan önce veriyi toplamış olabilir. Veri kümesinin kritik ama sıkça gözden kaçan bir unsuru, kullanım senaryosunu temsil edip etmediğidir. Veri kümeleri toplanacaksa, modelin nihayetinde kullanılacağı biçimde toplanmalıdır.
Örneğin, bilgisayarlı görü kullanarak stok yönetimi yapmak istiyorsanız, modelin kullanılacağı mağaza ya da buzdolabındaki nesnelerin görüntülerine sahip olmak önemlidir. Katalog türü görüntüler kullanım senaryosunu temsil etmedikleri için sağlam bir model üretmez. Modelin, nesneyi bulunduğu ortamda tespit edebilmek için sağlam özellikler öğrenmesi gerekir.
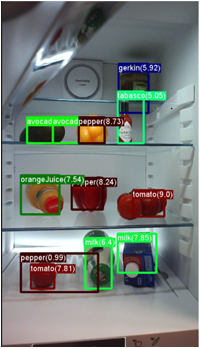
Son kullanıcıların buzdolabının bu kadar düzenli olduğunu hayal etmek zor!
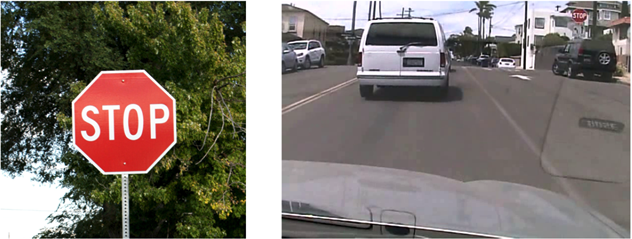
Veri biliminin altın kuralı, problemin başında olağanüstü iyi bir performans (>%90) elde ettiğinizde şüpheci olmaktır. Projenin başındaki iyi performans, ‘sızıntılı’ değişkenlerin veya ‘sızıntılı’ bir veri kümesinin göstergesi olabilir. Sızıntılı değişkenler, hedef değişkenle yüksek korelasyona sahip olan ve çıkarım anında bulunması beklenmeyen değişkenlerdir. Amaç satışları tahmin etmekse, diğer ürünlerin satışlarını özellik olarak kullanamazsınız; çünkü bu veriler kullanılabilir olmayacaktır. ‘Sızıntılı’ bir veri kümesi ise yalnızca belirli bir (zaman) kesitini yansıttığında ortaya çıkar. Çözülmesi gereken problem genellikle önemli ölçüde daha kolaylaşır ve modelin, gerçek sinyal yerine verideki gürültüye uyum sağlaması epey olasıdır.
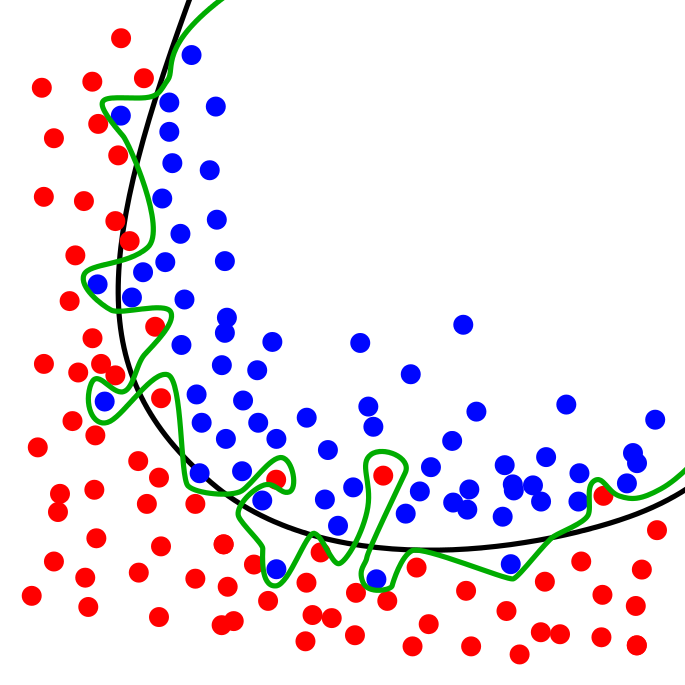
Yüksek performanslı bir model harikadır; ancak yalnızca tamamen yeni ve rastgele bir veri kümesinde de aynı derecede iyi performans gösteriyorsa!
istatistiksel safsatalar üzerine bu blog yazısını büyük keyifle okudum. Korelasyonu nedensellik olarak yorumlamak, sık yapılan hata türlerinden yalnızca biridir ve bunların ardındaki istatistiği güçlü şekilde kavramak kilittir.
Bir müşteri modeli eylemlerinin temeli olarak kullanıyorsa, her zaman yorumlanabilir ve anlaşılır çözümleri tercih eder. Bu blog yazısında, model yorumlanabilirliğinin neden kilit önemde olduğuna derinlemesine girdim. Ayrıca kullanılabilecek farklı tekniklere daha ayrıntılı bir bakış da sundum.
Yalnızca 6 olası veri bilimi tuzağına değindim; ancak geçtiğimiz yıl muhtemelen çok daha fazla hata yaptığıma eminim. Veri bilimi projelerinde deneyiminiz varsa ve sık karşılaştığınız problemleri paylaşmak isterseniz, yorumlarda okumaktan memnuniyet duyarım. Blog yazılarımdan haberdar olmak isterseniz beni Medium veya Twitter’da takip edin!
DataCamp’in Makine Öğrenmesinde Aşırı Uyumu Önleme öğreticisine göz atın.
Veri bilimi hakkında daha fazla bilgi edinmekle ilgileniyorsanız, DataCamp’in R’ye Giriş ve Python’a Giriş kurslarına göz atın.
Makine Öğrenmesi hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




