
Last chance! 50% off DataCamp Premium
Sale ends in
Selama studi saya, saya berkesempatan mengerjakan beberapa proyek riset machine learning. Proyek-proyek tersebut berkisar dari mengkaji model probabilistik hingga skenario yang lebih praktis dalam pemrosesan bahasa alami. Satu unsur umum dalam pekerjaan yang saya lakukan adalah ketersediaan masalah yang terdefinisi dengan baik dan kelimpahan dataset yang bersih.
Selama setahun terakhir, saya bekerja sebagai Data Scientist di Microsoft, memecahkan masalah pelanggan tingkat perusahaan. Pengalaman yang saya peroleh dari bekerja lintas industri menguji keterampilan saya dalam berbagai cara, baik dari perspektif data science maupun pemecahan masalah. Porsi besar waktu biasanya dihabiskan untuk mendefinisikan masalah, membuat dataset, dan membersihkan data, dan dataset berukuran besar hampir selalu lebih sulit didapat.
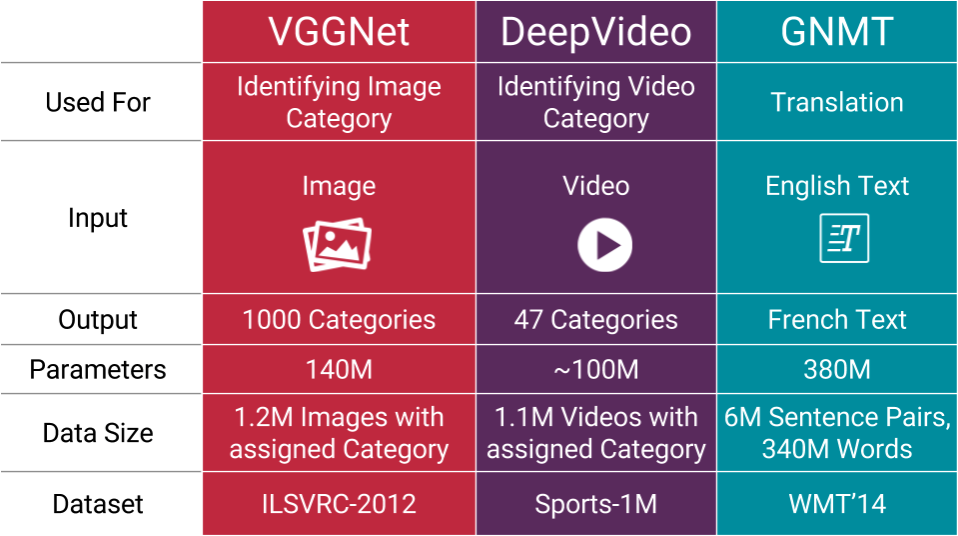
Dalam postingan blog ini saya berbagi beberapa pelajaran yang dipetik dan kesalahan yang mungkin Anda alami saat mengerjakan proyek data science ‘di dunia nyata’. Banyak dari kesalahan ini hampir selalu ada, dan sering kali diperlukan untuk menjadi ‘kreatif’ agar dapat mengatasinya.
Ada beberapa cara berbeda data dapat dimanfaatkan untuk meningkatkan proses bisnis. Tugas yang biasanya Anda dapatkan dari pelanggan adalah ‘memecahkan masalah bisnis X’. Contoh konkretnya misalnya ‘meningkatkan profitabilitas kampanye pemasaran’.
Kesalahan umum adalah tidak menanganinya dalam urutan yang ‘benar’. Jika Anda ingin meningkatkan sebuah proses, Anda perlu memahaminya dengan baik, sebelum memikirkan untuk mengotomatisasi sebagian proses tersebut. Pelanggan biasanya memiliki pengetahuan terbatas tentang data mereka sendiri dan tidak memiliki pengalaman dengan data science. Karena itu sangat penting untuk menjelaskan dengan jelas kepada mereka apa saja opsi yang tersedia dari perspektif data science.
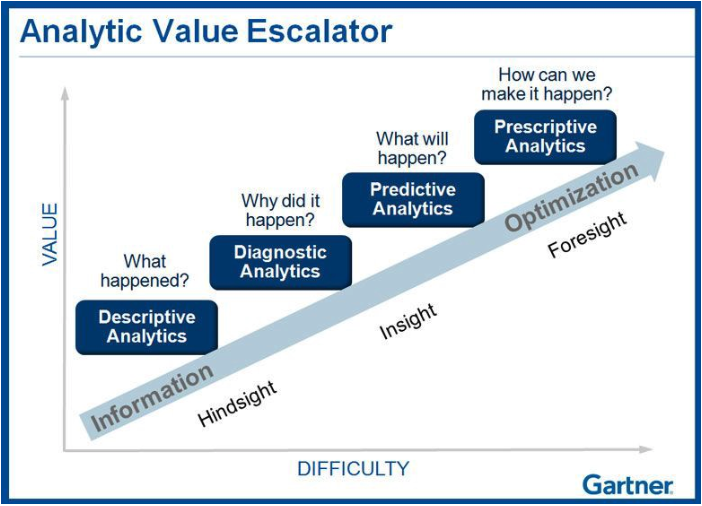
Sering kali, Anda memulai proyek dengan membersihkan dan menganalisis data. Istilah ‘deskriptif dan diagnostik’ digunakan ketika Anda bertujuan membuat ringkasan data dan mencoba memahami bagaimana variabel-variabel dalam data saling berkaitan. Anda membuat visualisasi dan menggunakan teknik machine learning (unsupervised) untuk mengelompokkan titik data atau menemukan variabel yang berkorelasi. Berdasarkan hasil proses ini, Anda bisa, misalnya, membuat laporan atau dasbor yang mencantumkan dan menelaah serangkaian KPI yang berguna untuk masalah bisnis. Dalam kampanye pemasaran, Anda dapat mengorelasikan data penjualan dan pemasaran untuk memahami mengapa kampanye berhasil. Kesimpulan (misalnya harga lebih rendah menghasilkan lebih banyak penjualan) mungkin bukan ‘penemuan besar’, tetapi memungkinkan pelanggan memvalidasi hipotesis mereka menggunakan data mereka sendiri. Selain itu, ini juga memungkinkan mereka mendeteksi perilaku anomali dan menilai apakah mereka memiliki jenis data yang tepat.
Analitik prediktif dan preskriptif berkaitan dengan memprediksi masa depan dan mengambil tindakan berdasarkan prediksi tersebut. Dengan analitik prediktif, Anda menggunakan data historis dan membangun model machine learning untuk memprediksi titik data di masa depan (dengan rentang galat tertentu). Dalam pemasaran, ide kampanye baru sering divalidasi dengan memperkirakan penjualan yang diharapkan menggunakan model prediktif. Setelah menjalani fase deskriptif dan diagnostik sebelumnya, Anda seharusnya memiliki gambaran jelas tentang apa yang dapat diharapkan dalam hal kinerja. Jika kualitas data tidak cukup baik untuk membangun model yang andal, hal ini dapat ditandai kepada pelanggan dan Anda dapat mendukung klaim menggunakan data yang mereka sediakan.
Dengan analitik preskriptif, tujuannya adalah mengambil tindakan berdasarkan prediksi, dan mengoptimalkan aspek-aspek tertentu dari proses. Alih-alih hanya memvalidasi ide kampanye, Anda dapat, misalnya, membangun mesin optimisasi yang dapat menghasilkan daftar ‘kampanye terbaik di masa depan’. Membangun sistem ini memerlukan data berkualitas tinggi dalam jumlah besar. Perlu dicatat bahwa data science adalah tentang menjanjikan lebih sedikit dan memberikan lebih banyak, jadi mulailah dari yang kecil dan kembangkan menjadi besar!
Pelanggan sering ingin bekerja dengan Proof of Concept untuk menyelidiki apa yang mungkin dilakukan dengan ‘data science’. Biasanya, ini berarti mereka menyediakan sebagian data, dan mereka ingin menentukan beberapa hasil awal. Meskipun pelanggan umumnya memahami Anda tidak akan mendapatkan kinerja yang baik dengan PoC, permintaan ini tetap umum. Namun, kelemahan PoC adalah subset data sering kali tidak representatif terhadap keseluruhan dataset dan masalahnya. Anda mungkin mendapatkan kinerja yang sangat baik dari PoC, tetapi tidak dapat mereplikasinya pada keseluruhan dataset. Pelanggan memilih dataset dengan, misalnya, hanya melihat segmen waktu yang kecil, yang dapat sangat membiasakan model PoC.
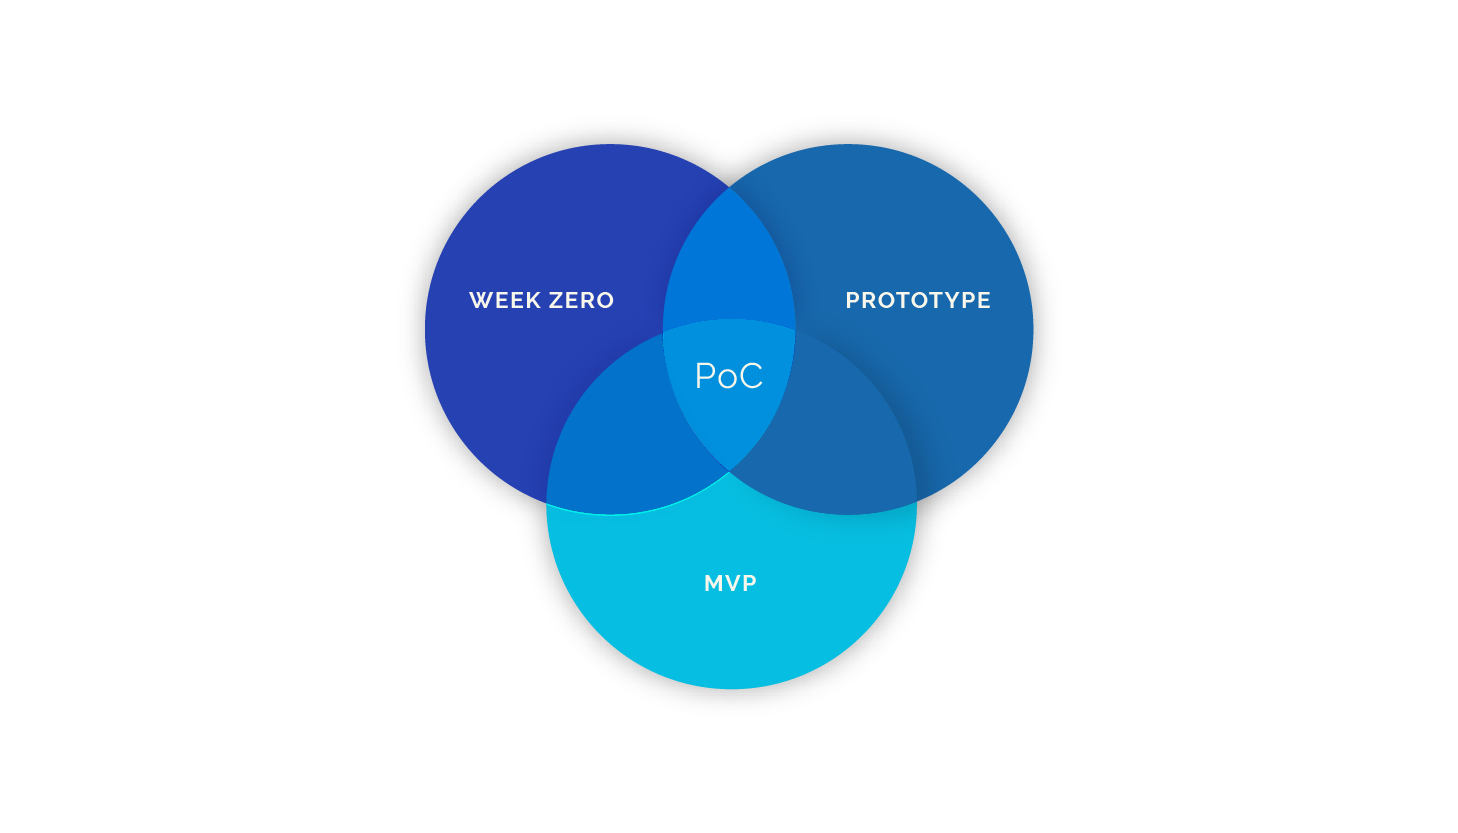
Opsi yang lebih baik, jika pelanggan ingin bereksperimen, adalah bekerja dengan pilot. Dalam pilot, Anda bekerja dengan keseluruhan dataset, dan menjalankan iterasi awal dari pipeline data science (pembersihan data, pemodelan, dan seterusnya). Bekerja dengan keseluruhan dataset mengurangi banyak risiko dalam proyek. Kinerja model masih belum optimal, karena waktu Anda terbatas, tetapi setidaknya Anda seharusnya dapat memperoleh gambaran yang representatif.
Meskipun kesalahan ini mirip dengan yang sebelumnya, ini tidak sama. Terutama jika Anda bekerja dengan data tidak terstruktur (misalnya gambar, data teks, dan sebagainya), pelanggan mungkin sudah mengumpulkan data sebelum Anda memulai proyek. Unsur penting tetapi sering diabaikan dari dataset adalah apakah dataset tersebut representatif terhadap kasus penggunaan. Jika dataset perlu dikumpulkan, pengumpulannya harus dilakukan dengan cara yang sama seperti model nantinya akan digunakan.
Misalnya, jika Anda ingin melakukan manajemen inventaris menggunakan computer vision, penting untuk memiliki gambar objek di toko atau lemari es, tempat model akan digunakan. Gambar jenis katalog tidak akan menghasilkan model yang andal, karena tidak merepresentasikan kasus penggunaan. Model harus mempelajari fitur yang tangguh untuk mendeteksi objek dalam lingkungannya.
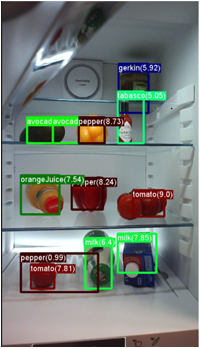
Sulit membayangkan lemari es pengguna akhir akan sebersih ini!
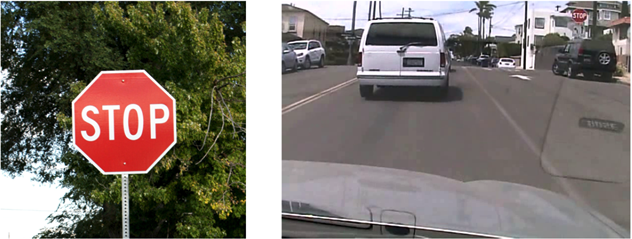
Aturan emas data science adalah curigalah ketika Anda mendapatkan kinerja yang sangat baik (>90%) di awal masalah. Kinerja baik di awal proyek bisa menjadi indikator variabel ‘bocor’ atau dataset yang ‘bocor’. Variabel bocor adalah variabel yang sangat berkorelasi dengan variabel target, dan kecil kemungkinannya tersedia saat inferensi. Jika tujuannya memprediksi penjualan, Anda tidak dapat menggunakan penjualan produk lain sebagai fitur karena data ini tidak akan tersedia. Dataset ‘bocor’ terjadi ketika dataset hanya merefleksikan segmen (waktu) tertentu. Masalah yang perlu dipecahkan biasanya menjadi jauh lebih mudah, dan cukup mungkin bahwa model akan menyesuaikan diri pada derau dalam data, bukannya sinyal sebenarnya.
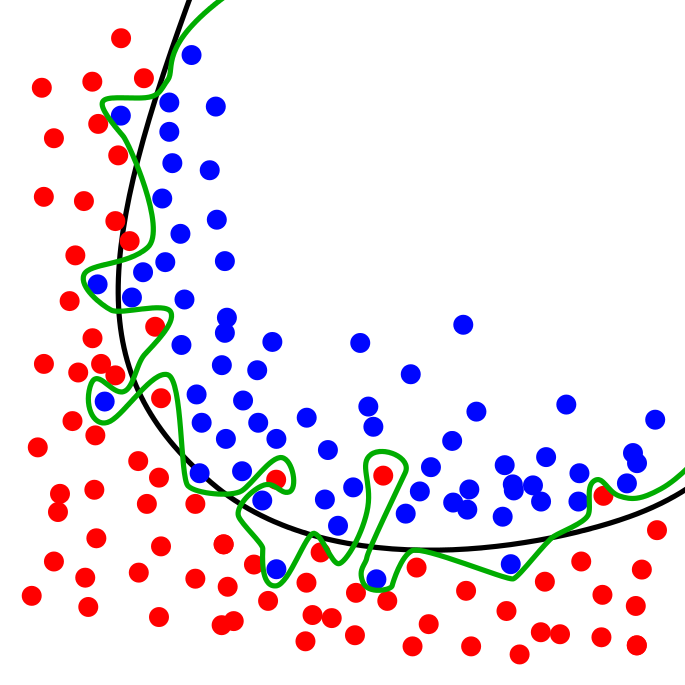
Model dengan kinerja tinggi itu bagus, tetapi hanya jika kinerjanya sama baiknya pada dataset baru dan acak sepenuhnya!
Saya sangat menikmati postingan blog tentang sesat pikir statistik ini. Menafsirkan korelasi sebagai kausalitas hanyalah salah satu jenis kesalahan yang sering dibuat, dan memahami secara kuat statistika di baliknya adalah kuncinya.
Jika pelanggan menggunakan model sebagai dasar tindakan, mereka akan selalu lebih menyukai solusi yang dapat ditafsirkan dan dipahami. Dalam postingan blog ini, saya membahas secara mendalam alasan mengapa kemampuan interpretasi model itu penting. Saya juga memberikan tinjauan lebih mendalam tentang teknik-teknik berbeda yang dapat Anda gunakan.
Saya hanya menyinggung 6 potensi kesalahan dalam data science, tetapi saya yakin saya mungkin membuat jauh lebih banyak kesalahan dalam setahun terakhir. Jika Anda memiliki pengalaman pada proyek data science, dan ingin membagikan masalah yang sering Anda temui, saya akan senang membacanya di kolom komentar. Ikuti saya di Medium atau Twitter jika Anda ingin menerima pembaruan tentang postingan blog saya!
Lihat tutorial DataCamp tentang Mencegah Overfitting dalam Machine Learning.
Jika Anda tertarik mempelajari lebih lanjut tentang data science, lihat kursus DataCamp Pengantar R dan Pengantar Python.
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



