Cursus
Inzicht in Machine Learning
2 uur
310.7K
Tijdens mijn studie kreeg ik de kans om aan verschillende machinelearning-onderzoeksprojecten te werken. Deze projecten varieerden van probabilistische modellen bestuderen tot meer praktische scenario’s in natural language processing. Een gemeenschappelijk element in het werk dat ik deed, was de beschikbaarheid van duidelijk gedefinieerde problemen en een overvloed aan schone datasets.
Het afgelopen jaar heb ik als Data Scientist bij Microsoft gewerkt aan problemen van enterprise-klanten. De ervaring die ik opdeed over verschillende sectoren heen, testte mijn vaardigheden op allerlei manieren, zowel vanuit data-scienceperspectief als vanuit probleemoplossend vermogen. Een groot deel van de tijd gaat doorgaans op aan het definiëren van het probleem, het creëren van een dataset en het opschonen van de data, en grote datasets zijn bijna altijd lastig te bemachtigen.
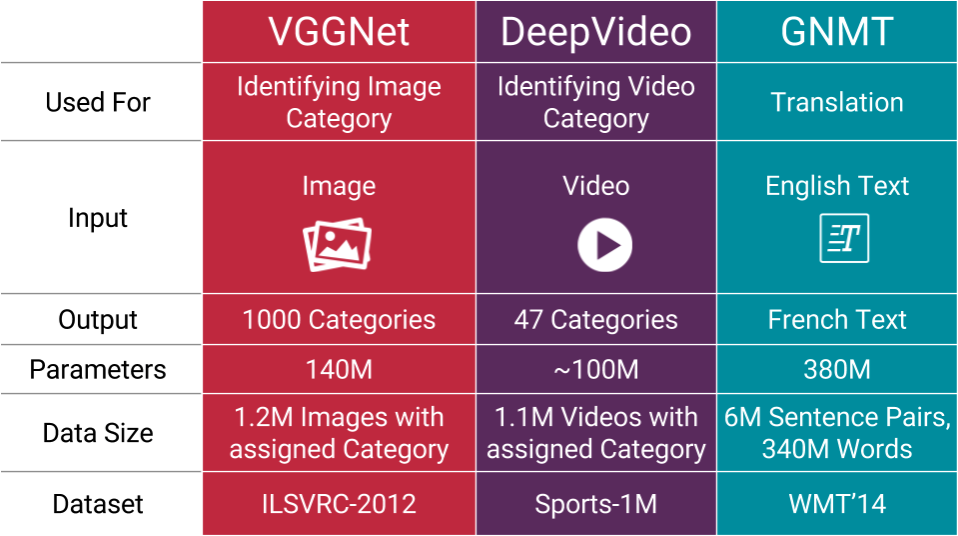
In deze blogpost deel ik een aantal lessen en valkuilen die je kunt tegenkomen wanneer je aan data-scienceprojecten ‘in het wild’ werkt. Veel van deze valkuilen zijn bijna altijd aanwezig, en het is vaak nodig om ‘creatief’ te zijn om ze op te lossen.
Er zijn verschillende manieren waarop data kan worden benut om bedrijfsprocessen te verbeteren. De opdracht die je doorgaans van een klant krijgt, is om ‘bedrijfsprobleem X op te lossen’. Een concreet voorbeeld is bijvoorbeeld ‘verbeter de winstgevendheid van de marketingcampagnes’.
Een veelvoorkomende valkuil is problemen niet in de ‘juiste’ volgorde aanpakken. Als je een proces wilt verbeteren, moet je het eerst goed begrijpen, nog voordat je eraan denkt delen ervan te automatiseren. Klanten hebben meestal beperkte kennis van hun eigen data en geen ervaring met data science. Het is daarom heel belangrijk om helder uit te leggen wat de verschillende opties zijn vanuit data-scienceperspectief.
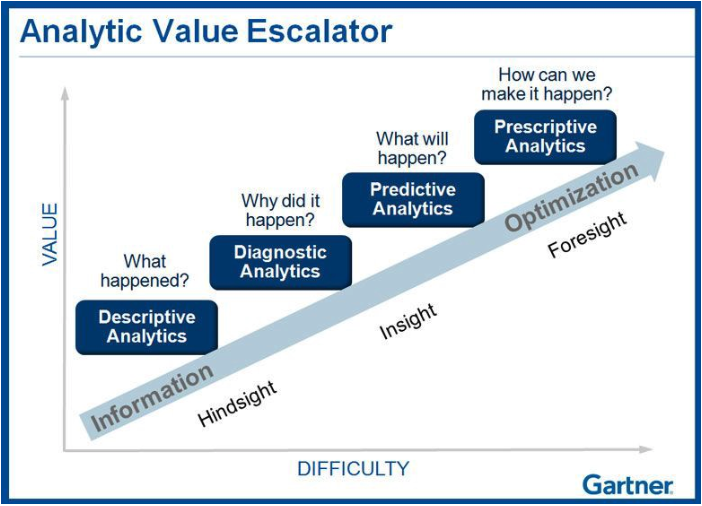
Vaak begin je het project met het opschonen en analyseren van de data. De termen ‘descriptive and diagnostic’ analytics worden gebruikt wanneer je samenvattingen van de data bouwt en probeert te begrijpen hoe de verschillende variabelen zich tot elkaar verhouden. Je maakt visualisaties en gebruikt (unsupervised) machinelearningtechnieken om datapunten te clusteren of gecorreleerde variabelen te vinden. Op basis van de uitkomst van dit proces kun je bijvoorbeeld een rapport of dashboard bouwen waarin een set KPI’s wordt opgesomd en onderzocht die nuttig zijn voor het bedrijfsprobleem. Bij marketingcampagnes kun je verkoop- en marketingdata correleren om te begrijpen waarom campagnes succesvol zijn. De conclusies (bijv. een lagere prijs leidt tot meer verkoop) zijn misschien niet ‘rocket science’, maar ze stellen de klant in staat om hun hypothesen te valideren met hun eigen data. Bovendien helpt het hen ook om afwijkend gedrag te spotten en te beoordelen of ze het juiste type data hebben.
Predictieve en prescriptieve analytics gaan over de toekomst voorspellen en op basis daarvan acties ondernemen. Bij predictieve analytics neem je de historische data en bouw je een machinelearningmodel om toekomstige datapunten te voorspellen (binnen een bepaalde foutmarge). In marketing worden nieuwe campagne-ideeën vaak gevalideerd door de verwachte omzet te schatten met een predictief model. Door de eerdere descriptieve en diagnostische fase achter de rug te hebben, heb je een duidelijk beeld van wat je qua prestaties kunt verwachten. Als de datakwaliteit niet goed genoeg is om een robuust model te bouwen, kun je dit aan de klant signaleren en je beweringen staven met de door hen aangeleverde data.
Bij prescriptieve analytics is het doel om op basis van voorspellingen acties te ondernemen en bepaalde aspecten van het proces te optimaliseren. In plaats van campagne-ideeën te valideren, zou je bijvoorbeeld een optimalisatie-engine kunnen bouwen die de lijst met ‘beste toekomstige campagnes’ kan genereren. Voor het bouwen van dit systeem zijn grote hoeveelheden data van hoge kwaliteit nodig. Onthoud dat data science draait om underpromising en overdeliveren, dus begin klein en bouw groot!
Klanten werken vaak graag met een Proof of Concept om te onderzoeken wat er mogelijk is met ‘data science’. Doorgaans betekent dit dat ze een subset van de data aanleveren en dat ze alvast enkele voorlopige resultaten willen bepalen. Hoewel een klant meestal begrijpt dat je met de PoC geen geweldige prestaties zult behalen, is het toch een veelvoorkomend verzoek. Het nadeel van een PoC is echter dat een subset van de data vaak niet representatief is voor de volledige dataset en het volledige probleem. Je kunt uit de PoC extreem goede prestaties halen, maar die mogelijk niet kunnen worden gerepliceerd op de volledige dataset. Klanten selecteren de dataset bijvoorbeeld door slechts naar een kleine tijdsperiode te kijken, wat het PoC-model sterk kan vertekenen.
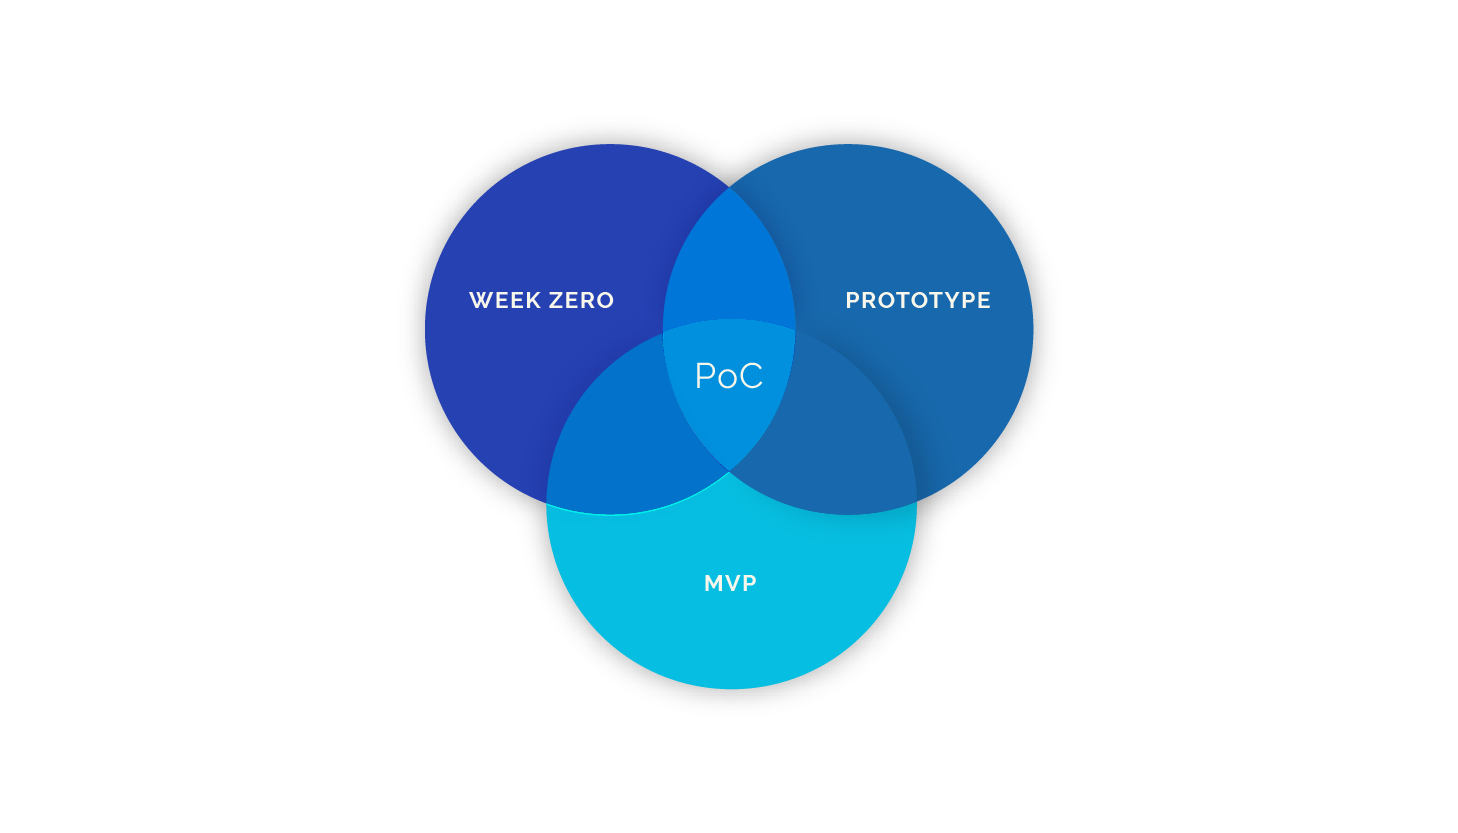
Een betere optie, als de klant wil experimenteren, is werken met pilots. In pilots werk je met de volledige dataset en doorloop je een eerste iteratie van de data-sciencepijplijn (data opschonen, modelleren, enz.). Werken met de volledige dataset beperkt veel risico in het project. De modelprestaties zullen nog steeds niet optimaal zijn, omdat je maar beperkte tijd had, maar je zou in elk geval een representatief beeld moeten hebben gekregen.
Hoewel deze valkuil lijkt op de vorige, is het niet hetzelfde. Zeker als je met ongestructureerde data werkt (bijv. afbeeldingen, tekstdata, enz.), kan het zijn dat een klant al data heeft verzameld voordat jij met het project begint. Een cruciaal, maar vaak over het hoofd gezien element van de dataset is of deze representatief is voor de usecase. Als datasets moeten worden verzameld, moet dat gebeuren op dezelfde manier als waarop het model uiteindelijk gebruikt zal worden.
Als je bijvoorbeeld voorraadbeheer met computervisie wilt doen, is het belangrijk om afbeeldingen te hebben van objecten in de winkel of de koelkast, waar het model gebruikt zal worden. Afbeeldingen van catalogustype leveren geen robuust model op, omdat ze de usecase niet vertegenwoordigen. Het model moet robuuste kenmerken leren om het object in de omgeving te detecteren.
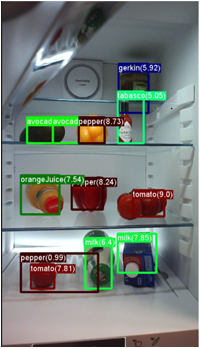
Het is moeilijk voor te stellen dat de koelkast van eindgebruikers zó schoon is!
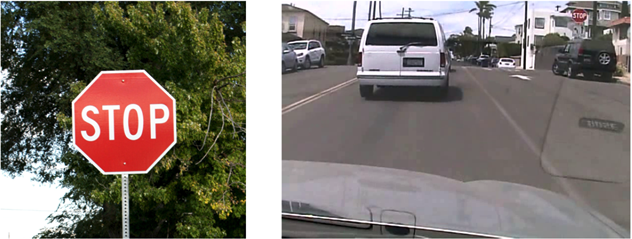
De gouden regel van data science is om argwanend te zijn wanneer je aan het begin van het probleem extreem goede prestaties (>90%) krijgt. Goede prestaties aan het begin van het project kunnen een indicator zijn van ‘lekkende’ variabelen of een ‘lekkende’ dataset. Lekkende variabelen zijn variabelen die sterk correleren met de doelvariabele en die waarschijnlijk niet beschikbaar zijn op inferentietijd. Als het doel is om verkoop te voorspellen, kun je niet de verkoop van andere producten als features gebruiken, omdat die data niet beschikbaar zal zijn. Een ‘lekkende’ dataset ontstaat wanneer de dataset slechts een bepaald (tijd)segment weerspiegelt. Het probleem dat moet worden opgelost is dan doorgaans aanzienlijk eenvoudiger, en de kans is groot dat het model zich gaat aanpassen aan ruis in de data in plaats van aan het werkelijke signaal.
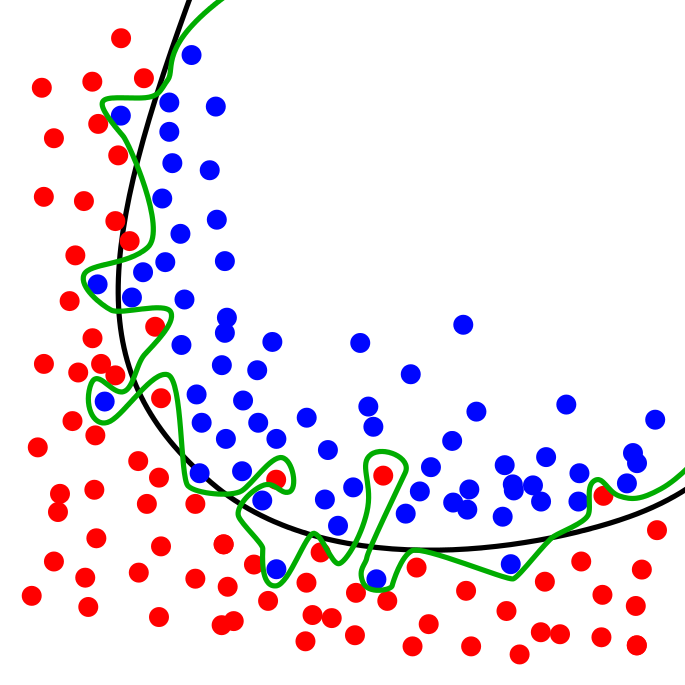
Een model met hoge performance is geweldig, maar alleen als het even goed presteert op een volledig nieuwe en willekeurige dataset!
Ik heb erg genoten van deze blogpost over statistische drogredenen. Correlatie als causaliteit interpreteren is slechts één van de soorten fouten die vaak worden gemaakt, en een goed begrip van de bijbehorende statistiek is cruciaal.
Als een klant het model als basis voor acties gebruikt, geven ze altijd de voorkeur aan oplossingen die interpreteerbaar en begrijpelijk zijn. In deze blogpost ging ik dieper in op de redenen waarom modelinterpreteerbaarheid belangrijk is. Ik gaf ook een uitgebreider overzicht van de verschillende technieken die je kunt gebruiken.
Ik ben hier slechts ingegaan op 6 potentiële data-sciencevalkuilen, maar ik ben ervan overtuigd dat ik het afgelopen jaar aanzienlijk meer fouten heb gemaakt. Als je ervaring hebt met data-scienceprojecten en je veelvoorkomende problemen wilt delen, lees ik die graag in de comments. Volg me op Medium of Twitter als je updates over mijn blogposts wilt ontvangen!
Bekijk de DataCamp-tutorial over Overfitting voorkomen in machine learning.
Als je meer wilt leren over data science, bekijk dan DataCamp’s cursussen Intro to R en Intro to Python.
Leer meer over machine learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

