
Last chance! 50% off DataCamp Premium
Sale ends in
Durante gli studi ho avuto l’opportunità di lavorare su diversi progetti di ricerca nel machine learning. Questi progetti spaziavano dallo studio di modelli probabilistici a scenari più pratici di elaborazione del linguaggio naturale. Un elemento comune del lavoro che ho svolto era la presenza di problemi ben definiti e l’abbondanza di dataset puliti.
Nell’ultimo anno ho lavorato come Data Scientist in Microsoft, risolvendo problemi per clienti enterprise. L’esperienza maturata in diversi settori ha messo alla prova le mie competenze in molti modi, sia dal punto di vista della data science sia del problem solving. Una gran parte del tempo viene in genere spesa per definire il problema, creare un dataset e pulire i dati, e dataset di grandi dimensioni sono quasi sempre più difficili da reperire.
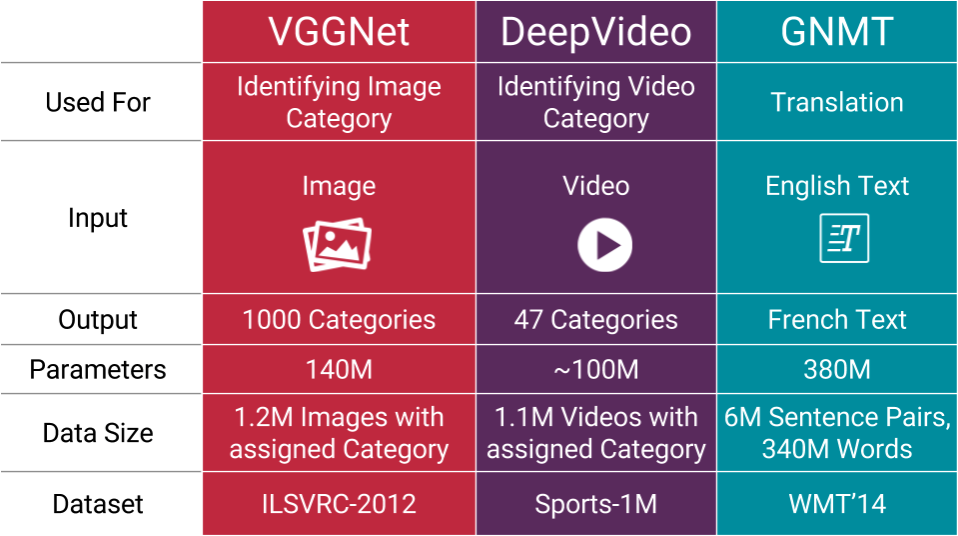
In questo post condivido alcune lezioni imparate ed errori in cui potresti imbatterti lavorando a progetti di data science ‘nel mondo reale’. Molti di questi scogli sono quasi sempre presenti ed è spesso necessario essere ‘creativi’ per superarli.
Ci sono diversi modi in cui i dati possono essere sfruttati per migliorare i processi aziendali. L’incarico che in genere ricevi da un cliente è ‘risolvere il problema di business X’. Un esempio concreto è, ad esempio, ‘migliorare la redditività delle campagne marketing’.
Un errore comune è non affrontare i problemi nel ‘giusto’ ordine. Se vuoi migliorare un processo, devi prima capirlo a fondo, prima ancora di pensare di automatizzarne delle parti. I clienti in genere hanno una conoscenza limitata dei propri dati e nessuna esperienza con la data science. È quindi molto importante spiegare chiaramente quali sono le diverse opzioni dal punto di vista della data science.
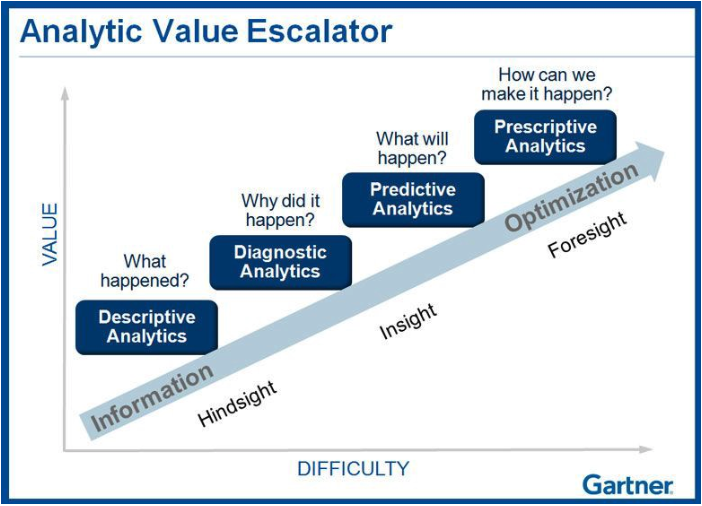
Spesso inizi il progetto pulendo e analizzando i dati. I termini ‘descrittiva e diagnostica’ si usano quando vuoi costruire sintesi dei dati e capire come si relazionano le diverse variabili. Crei visualizzazioni e usi tecniche di machine learning (non supervisionato) per raggruppare i punti dati o trovare variabili correlate. In base all’esito del processo, puoi ad esempio creare un report o una dashboard che elenca e analizza una serie di KPI utili per il problema di business. Con le campagne marketing, potresti correlare dati di vendita e dati di marketing per capire perché le campagne hanno successo. Le conclusioni (ad esempio un prezzo più basso porta a più vendite) potrebbero non essere ‘scienza missilistica’, ma permettono al cliente di validare le proprie ipotesi usando i loro dati. Inoltre, consentono anche di individuare comportamenti anomali e di capire se dispongono del giusto tipo di dati.
L’analytics predittiva e prescrittiva riguarda il prevedere il futuro e agire in base a queste previsioni. Con l’analytics predittiva prendi i dati storici e costruisci un modello di machine learning per prevedere dati futuri (entro un certo margine di errore). Nel marketing, le nuove idee di campagna sono spesso validate stimando le vendite attese con un modello predittivo. Dopo aver svolto la fase descrittiva e diagnostica, dovresti avere un’idea chiara di cosa aspettarti in termini di performance. Se la qualità dei dati non è sufficiente per costruire un modello robusto, lo si può segnalare al cliente e supportare le affermazioni con i dati che ha fornito.
Con l’analytics prescrittiva, l’obiettivo è intraprendere azioni basate sulle previsioni e ottimizzare determinati aspetti del processo. Invece di validare idee di campagna, potresti ad esempio costruire un motore di ottimizzazione in grado di generare l’elenco delle ‘migliori campagne future’. La costruzione di questo sistema richiede grandi quantità di dati di alta qualità. Ricorda che nella data science è fondamentale promettere poco e consegnare tanto: parti in piccolo e costruisci in grande!
Ai clienti spesso piace lavorare con una Proof of Concept per esplorare cosa è possibile con la ‘data science’. In genere, ciò significa che forniscono un sottoinsieme dei dati e vogliono ricavarne alcuni risultati preliminari. Anche se un cliente di solito capisce che con la PoC non otterrai buone performance, è comunque una richiesta frequente. Lo svantaggio, però, è che un sottoinsieme dei dati spesso non è rappresentativo dell’intero dataset e del problema. Potresti ottenere performance estremamente buone nella PoC, ma potresti non riuscire a replicarle sull’intero dataset. I clienti selezionano il dataset ad esempio guardando solo a un piccolo segmento temporale, che potrebbe introdurre un forte bias nel modello PoC.
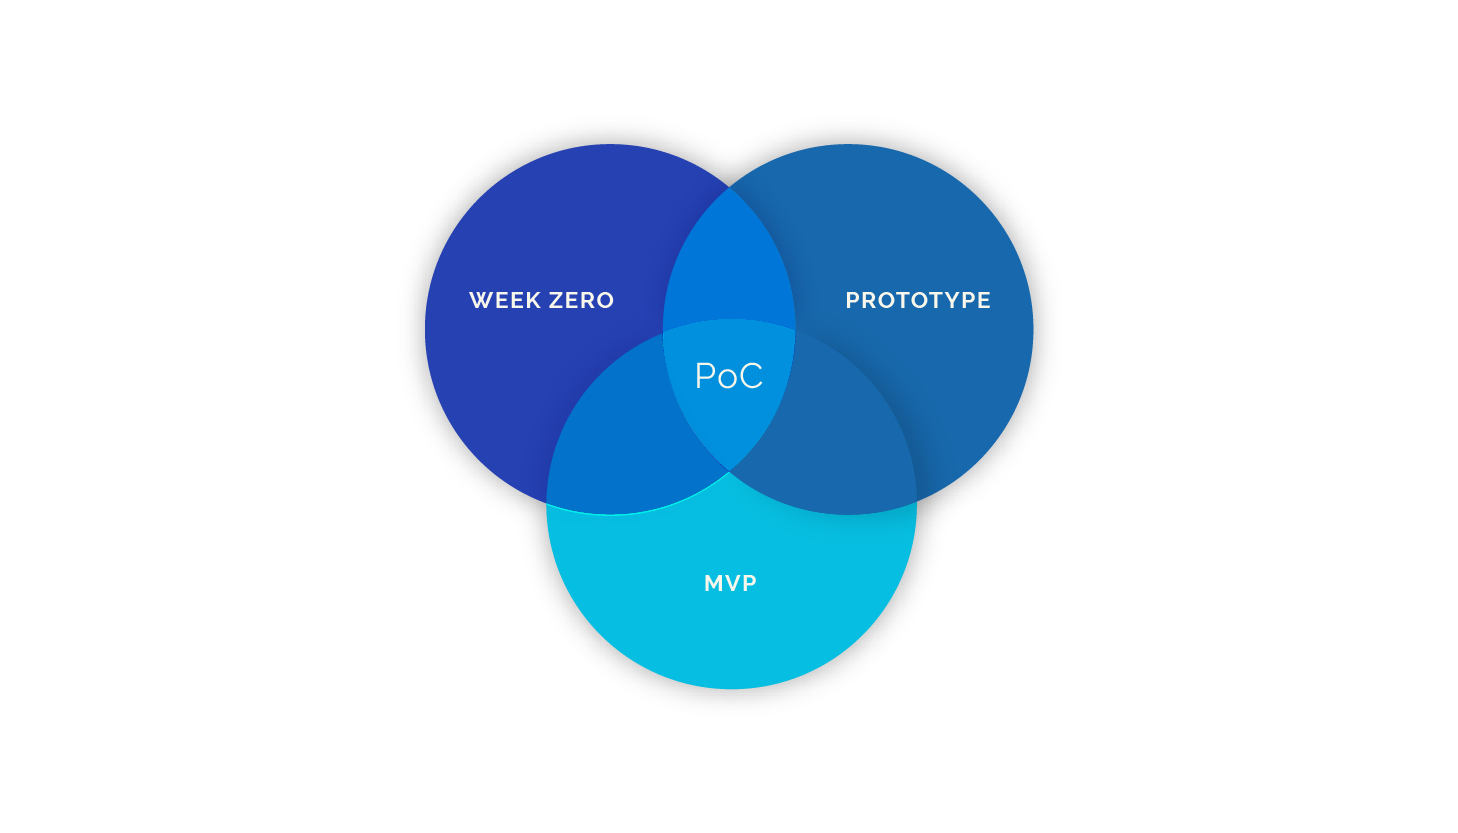
Un’opzione migliore, se il cliente vuole sperimentare, è lavorare con progetti pilota. Nei pilota lavori con l’intero dataset e passi attraverso un’iterazione iniziale della pipeline di data science (pulizia dei dati, modellazione, ecc.). Lavorare con l’intero dataset riduce molti rischi nel progetto. Le performance del modello non saranno comunque ottimali, dato il tempo limitato, ma almeno dovresti riuscire a ottenere un quadro rappresentativo.
Sebbene questo errore sia simile al precedente, non è lo stesso. Soprattutto se lavori con dati non strutturati (ad esempio immagini, testi, ecc.), è possibile che un cliente abbia già raccolto dati prima dell’inizio del progetto. Un elemento critico, ma spesso trascurato, del dataset è se esso sia rappresentativo del caso d’uso. Se i dataset devono essere raccolti, andrebbero raccolti nello stesso modo in cui il modello verrà effettivamente utilizzato.
Per esempio, se vuoi fare inventory management usando la computer vision, è importante avere immagini degli oggetti nel negozio o nel frigorifero, dove il modello verrà usato. Immagini da catalogo non porteranno a un modello robusto, perché non rappresentano il caso d’uso. Il modello deve apprendere caratteristiche robuste per individuare l’oggetto nell’ambiente.
È difficile immaginare che il frigorifero degli utenti finali sia così ordinato!
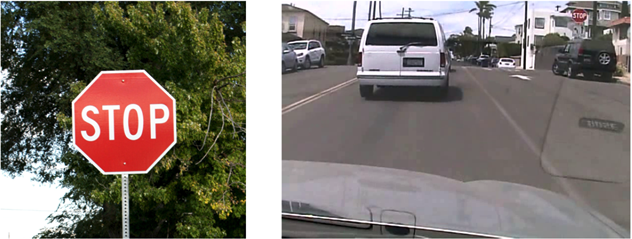
La regola d’oro della data science è diffidare quando ottieni performance estremamente buone (>90%) all’inizio del lavoro. Buoni risultati nelle fasi iniziali potrebbero indicare variabili ‘leaky’ o un dataset ‘leaky’. Leaky variables sono variabili altamente correlate con la variabile target e che è improbabile siano disponibili in fase di inferenza. Se l’obiettivo è prevedere le vendite, non puoi usare le vendite di altri prodotti come feature perché questi dati non saranno disponibili. Un dataset ‘leaky’ si verifica quando il dataset riflette solo un certo segmento (temporale). Il problema da risolvere risulta in genere significativamente più facile ed è probabile che il modello si adatti al rumore nei dati, invece che al segnale reale.
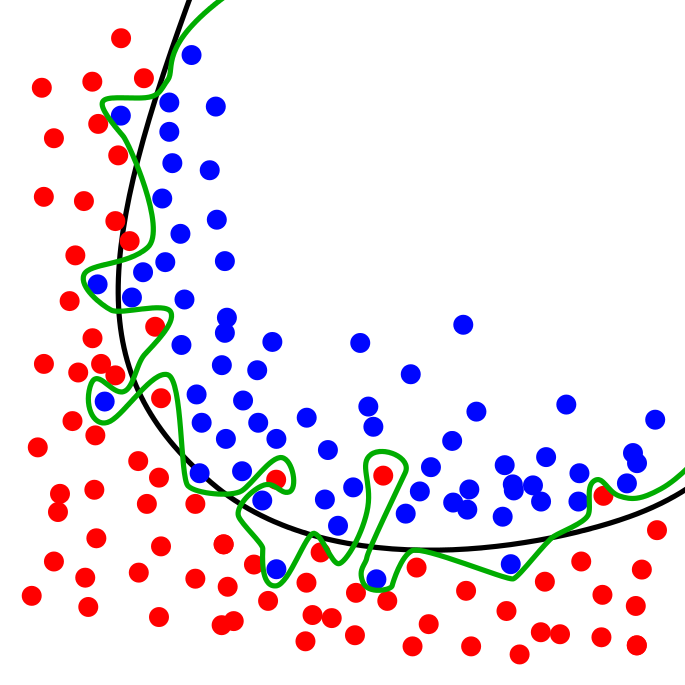
Un modello con alte performance è ottimo, ma solo se si comporta altrettanto bene su un dataset completamente nuovo e casuale!
Mi è piaciuto molto questo post su fallacie statistiche. Interpretare la correlazione come causalità è solo uno dei tipi di errori che si commettono spesso, e comprendere a fondo la statistica dietro a questi casi è fondamentale.
Se un cliente usa il modello come base per agire, preferirà sempre soluzioni interpretabili e comprensibili. In questo post ho approfondito i motivi per cui l’interpretabilità dei modelli è fondamentale. Ho anche offerto uno sguardo più dettagliato alle diverse tecniche che puoi utilizzare.
Ho solo sfiorato 6 potenziali trappole della data science, ma sono convinto di aver commesso molti più errori nell’ultimo anno. Se hai esperienza su progetti di data science e vuoi condividere i problemi che incontri più spesso, sarò felice di leggerli nei commenti. Seguimi su Medium o Twitter se vuoi ricevere aggiornamenti sui miei post!
Dai un’occhiata al tutorial di DataCamp su Come prevenire l’overfitting nel Machine Learning.
Se vuoi saperne di più sulla data science, scopri i corsi di DataCamp Introduzione a R e Introduzione a Python.
Scopri di più sul Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



