Trong thời gian học tập, tôi có cơ hội tham gia một số dự án nghiên cứu về học máy. Các dự án này trải dài từ nghiên cứu các mô hình xác suất đến những kịch bản thực tiễn hơn trong xử lý ngôn ngữ tự nhiên. Điểm chung trong công việc tôi làm là bài toán được xác định rõ ràng và có sẵn các bộ dữ liệu sạch dồi dào.
Năm vừa qua, tôi làm việc tại Microsoft với vai trò Nhà khoa học Dữ liệu, giải quyết bài toán cho khách hàng doanh nghiệp. Trải nghiệm tích lũy được khi làm việc qua nhiều ngành đã thử thách kỹ năng của tôi theo nhiều cách, cả ở góc độ khoa học dữ liệu lẫn giải quyết vấn đề. Phần lớn thời gian thường được dành cho việc xác định bài toán, tạo bộ dữ liệu và làm sạch dữ liệu, và các bộ dữ liệu lớn gần như luôn khó tìm hơn nhiều.
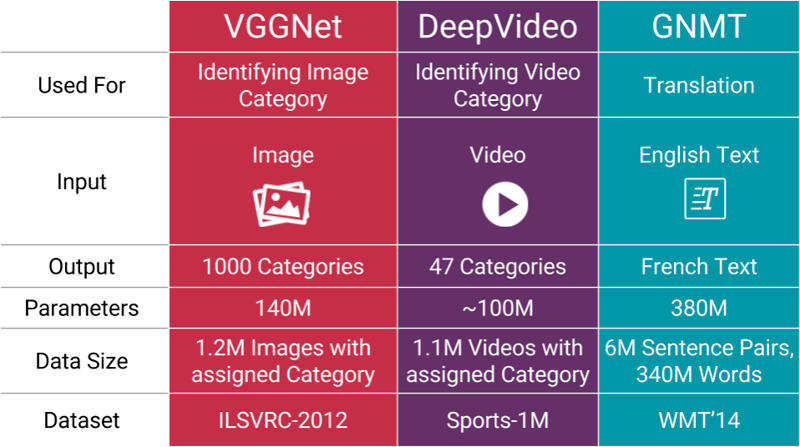 Ví dụ về kích thước bộ dữ liệu dùng trong các lĩnh vực nghiên cứu khác nhau. nguồn
Trong bài viết này, tôi chia sẻ một số bài học và những cạm bẫy bạn có thể gặp khi thực hiện các dự án khoa học dữ liệu ngoài thực tế. Nhiều cạm bẫy gần như luôn hiện hữu, và thường cần sự “sáng tạo” để giải quyết chúng.
Những cạm bẫy
Phân tích mô tả, dự đoán và kê đơn
Có nhiều cách khác nhau để tận dụng dữ liệu nhằm cải thiện quy trình kinh doanh. Nhiệm vụ bạn thường nhận từ khách hàng là “giải quyết bài toán kinh doanh X”. Ví dụ cụ thể như “cải thiện khả năng sinh lời của các chiến dịch marketing”.
Một cạm bẫy phổ biến là không xử lý vấn đề theo “đúng” thứ tự. Nếu muốn cải thiện một quy trình, bạn cần hiểu đúng về nó trước khi nghĩ đến tự động hóa một phần. Khách hàng thường có hiểu biết hạn chế về dữ liệu của chính họ và chưa có kinh nghiệm với khoa học dữ liệu. Vì vậy, rất quan trọng là phải giải thích rõ cho họ các lựa chọn khác nhau dưới góc độ khoa học dữ liệu.
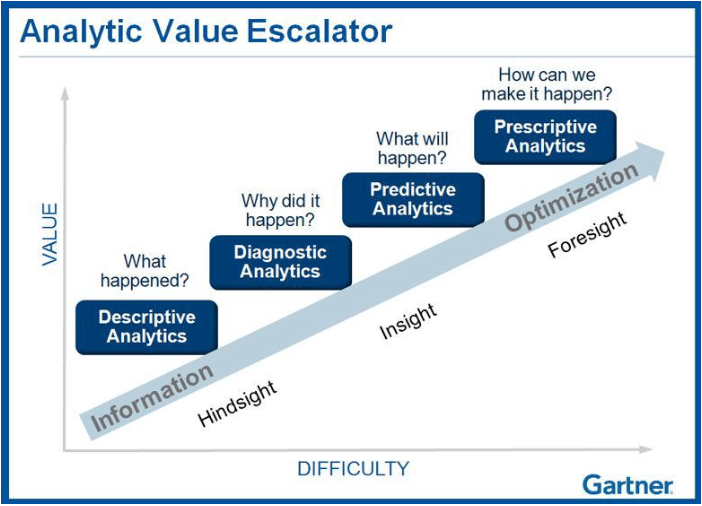 Giá trị của phân tích dữ liệu: từ mô tả đến kê đơn nguồn
Thường thì bạn bắt đầu dự án bằng việc làm sạch và phân tích dữ liệu. Thuật ngữ “mô tả và chẩn đoán” được dùng khi bạn xây dựng tóm lược dữ liệu và cố gắng hiểu các biến khác nhau liên hệ với nhau thế nào. Bạn xây dựng trực quan hóa và dùng các kỹ thuật học máy (không giám sát) để gom cụm điểm dữ liệu hoặc tìm biến tương quan. Dựa trên kết quả, bạn có thể xây dựng báo cáo hoặc bảng điều khiển, liệt kê và phân tích một tập KPI hữu ích cho bài toán kinh doanh. Với các chiến dịch marketing, bạn có thể liên hệ dữ liệu bán hàng và marketing để hiểu vì sao chiến dịch thành công. Kết luận (ví dụ: giá thấp hơn dẫn đến nhiều đơn hàng hơn) có thể không phải là điều “cao siêu”, nhưng cho phép khách hàng kiểm chứng giả thuyết bằng dữ liệu của họ. Ngoài ra, điều này cũng giúp họ phát hiện hành vi bất thường và đánh giá xem họ có đúng loại dữ liệu cần thiết hay không.
Phân tích dự đoán và kê đơn liên quan đến dự báo tương lai và đưa ra hành động dựa trên các dự báo đó. Với phân tích dự đoán, bạn dùng dữ liệu lịch sử và xây dựng mô hình học máy để dự đoán các điểm dữ liệu tương lai (trong một khoảng sai số nhất định). Trong marketing, các ý tưởng chiến dịch mới thường được kiểm chứng bằng cách ước tính doanh số kỳ vọng thông qua mô hình dự đoán. Nhờ đã thực hiện giai đoạn mô tả và chẩn đoán trước đó, bạn sẽ có cái nhìn rõ về hiệu năng có thể kỳ vọng. Nếu chất lượng dữ liệu không đủ tốt để xây dựng mô hình vững, bạn có thể thông báo cho khách hàng và dùng chính dữ liệu họ cung cấp để chứng minh nhận định.
Với phân tích kê đơn, mục tiêu là đưa ra hành động dựa trên dự báo và tối ưu một số khía cạnh của quy trình. Thay vì chỉ kiểm chứng ý tưởng chiến dịch, bạn có thể xây dựng một bộ máy tối ưu hóa có khả năng sinh ra danh sách “những chiến dịch tương lai tốt nhất”. Xây dựng hệ thống này đòi hỏi lượng lớn dữ liệu chất lượng cao. Lưu ý rằng khoa học dữ liệu là về việc hứa ít làm nhiều, nên hãy bắt đầu nhỏ và xây dựng dần!
Bằng chứng khái niệm (PoC) so với thí điểm (pilot)
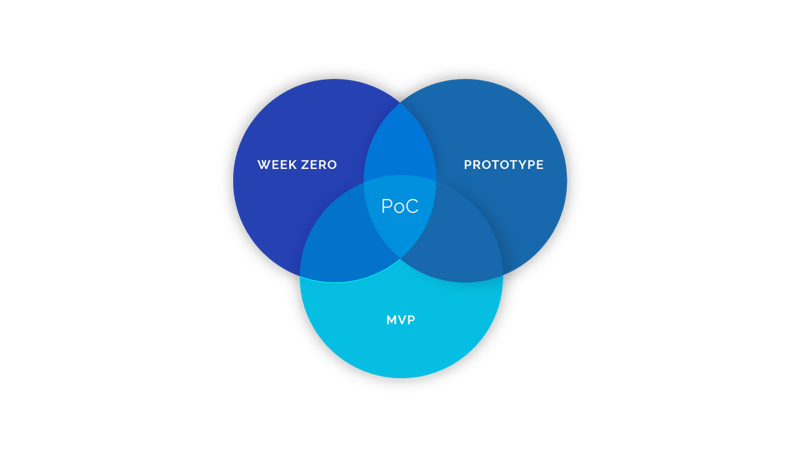
Khách hàng thường thích làm PoC để khảo sát khả năng của “khoa học dữ liệu”. Thông thường, điều này nghĩa là họ cung cấp một tập con dữ liệu và muốn xem một số kết quả sơ bộ. Dù khách hàng thường hiểu rằng hiệu năng với PoC sẽ không cao, đây vẫn là yêu cầu phổ biến. Tuy nhiên, nhược điểm của PoC là tập con dữ liệu thường không đại diện cho toàn bộ bộ dữ liệu và bài toán. Bạn có thể đạt hiệu năng cực tốt với PoC nhưng không thể lặp lại trên toàn bộ dữ liệu. Khách hàng có thể chọn dữ liệu bằng cách chỉ xem một đoạn thời gian nhỏ, điều này có thể làm sai lệch mạnh mô hình PoC.
 nguồn
Một lựa chọn tốt hơn nếu khách hàng muốn thử nghiệm là làm pilot. Trong pilot, bạn làm việc với toàn bộ dữ liệu và chạy một vòng lặp ban đầu của chu trình khoa học dữ liệu (làm sạch dữ liệu, mô hình hóa, v.v.). Làm việc với toàn bộ dữ liệu giúp giảm nhiều rủi ro trong dự án. Hiệu năng mô hình vẫn chưa tối ưu vì thời gian hạn chế, nhưng ít nhất bạn có được bức tranh đại diện.
Bộ dữ liệu mang tính đại diện
Dù cạm bẫy này tương tự cạm bẫy trước, nhưng không hoàn toàn giống. Đặc biệt khi làm với dữ liệu phi cấu trúc (ví dụ: hình ảnh, văn bản, v.v.), khách hàng có thể đã thu thập dữ liệu trước khi bạn bắt đầu dự án. Một yếu tố quan trọng nhưng thường bị bỏ qua là liệu bộ dữ liệu có mang tính đại diện cho trường hợp sử dụng hay không. Nếu cần thu thập dữ liệu, việc thu thập nên được thực hiện theo đúng cách mà sau này mô hình sẽ được sử dụng.
Ví dụ, nếu bạn muốn quản lý tồn kho bằng thị giác máy tính, điều quan trọng là có hình ảnh các vật thể trong cửa hàng hoặc trong tủ lạnh, nơi mô hình sẽ được dùng. Ảnh kiểu danh mục sản phẩm sẽ không cho ra mô hình vững, vì chúng không phản ánh trường hợp sử dụng. Mô hình phải học được các đặc trưng vững để phát hiện đối tượng trong môi trường thực.
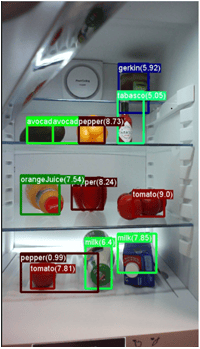
Khó có thể tưởng tượng tủ lạnh của người dùng cuối lại sạch sẽ như thế này!
 Bức ảnh bên trái không đại diện lắm cho trường hợp sử dụng ở bên phải!
Quy tắc vàng của khoa học dữ liệu là hãy nghi ngờ khi bạn đạt hiệu năng cực cao (>90%) ngay từ đầu bài toán. Hiệu năng tốt khi mới bắt đầu có thể là dấu hiệu của các biến “rò rỉ” hoặc một bộ dữ liệu “rò rỉ”. Biến rò rỉ là những biến tương quan rất mạnh với biến đích và khó có khả năng sẵn có ở thời điểm suy luận. Nếu mục tiêu là dự đoán doanh số, bạn không thể dùng doanh số của sản phẩm khác làm đặc trưng vì dữ liệu này sẽ không có sẵn. Bộ dữ liệu “rò rỉ” xảy ra khi dữ liệu chỉ phản ánh một đoạn (thời gian) nhất định. Bài toán khi đó thường dễ hơn nhiều, và rất có thể mô hình sẽ khớp vào nhiễu thay vì tín hiệu thật.
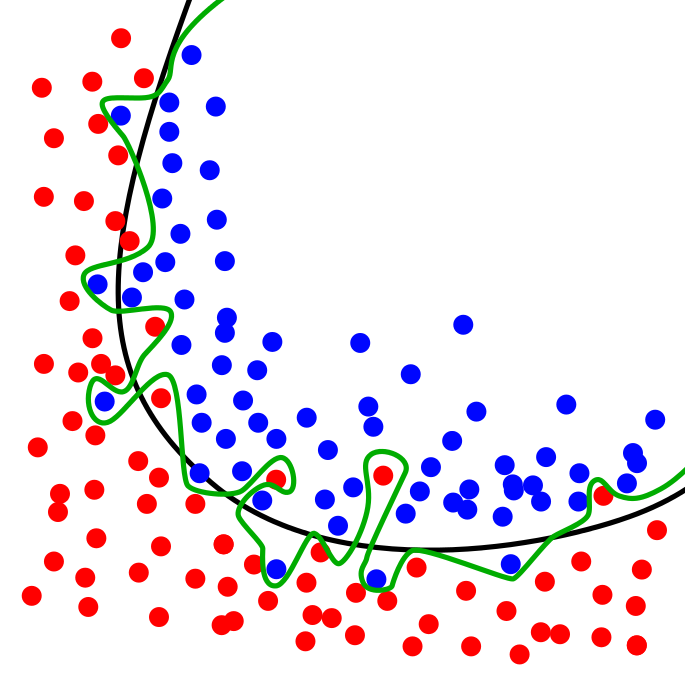 Điều dễ nhất trong học máy là quá khớp! nguồn
Một mô hình có hiệu năng cao là tuyệt vời, nhưng chỉ khi nó hoạt động tốt tương tự trên một bộ dữ liệu hoàn toàn mới và ngẫu nhiên!
Diễn giải tương quan thành quan hệ nhân quả
Tôi rất thích bài viết này về ngụy biện thống kê. Diễn giải tương quan thành quan hệ nhân quả chỉ là một trong những lỗi thường gặp, và việc nắm vững thống kê đằng sau chúng là then chốt.
Tính diễn giải của mô hình và dữ liệu
Nếu khách hàng dùng mô hình làm cơ sở cho hành động, họ sẽ luôn ưu tiên các giải pháp có thể diễn giải và dễ hiểu. Trong bài viết này, tôi đã đi sâu vào lý do vì sao tính diễn giải của mô hình là chìa khóa. Tôi cũng cung cấp cái nhìn sâu hơn về các kỹ thuật bạn có thể sử dụng.
Kết luận
Tôi chỉ đề cập đến 6 cạm bẫy tiềm ẩn trong khoa học dữ liệu, nhưng tôi tin rằng mình còn mắc nhiều lỗi hơn thế trong năm vừa qua. Nếu bạn có kinh nghiệm với các dự án khoa học dữ liệu và muốn chia sẻ những vấn đề thường gặp, tôi rất vui được đọc trong phần bình luận. Theo dõi tôi trên Medium hoặc Twitter nếu bạn muốn nhận cập nhật về các bài viết!
Hãy xem hướng dẫn của DataCamp về Ngăn ngừa Quá khớp trong Học máy.
Nếu bạn muốn tìm hiểu thêm về khoa học dữ liệu, hãy xem các khóa học Nhập môn R và Nhập môn Python của DataCamp.


 Matt Crabtree · 10 min
Trong thời gian học tập, tôi có cơ hội tham gia một số dự án nghiên cứu về học máy. Các dự án này trải dài từ nghiên cứu các mô hình xác suất đến những kịch bản thực tiễn hơn trong xử lý ngôn ngữ tự nhiên. Điểm chung trong công việc tôi làm là bài toán được xác định rõ ràng và có sẵn các bộ dữ liệu sạch dồi dào.
Năm vừa qua, tôi làm việc tại Microsoft với vai trò Nhà khoa học Dữ liệu, giải quyết bài toán cho khách hàng doanh nghiệp. Trải nghiệm tích lũy được khi làm việc qua nhiều ngành đã thử thách kỹ năng của tôi theo nhiều cách, cả ở góc độ khoa học dữ liệu lẫn giải quyết vấn đề. Phần lớn thời gian thường được dành cho việc xác định bài toán, tạo bộ dữ liệu và làm sạch dữ liệu, và các bộ dữ liệu lớn gần như luôn khó tìm hơn nhiều.
Trong bài viết này, tôi chia sẻ một số bài học và những cạm bẫy bạn có thể gặp khi thực hiện các dự án khoa học dữ liệu ngoài thực tế. Nhiều cạm bẫy gần như luôn hiện hữu, và thường cần sự “sáng tạo” để giải quyết chúng.
Những cạm bẫy
Phân tích mô tả, dự đoán và kê đơn
Có nhiều cách khác nhau để tận dụng dữ liệu nhằm cải thiện quy trình kinh doanh. Nhiệm vụ bạn thường nhận từ khách hàng là “giải quyết bài toán kinh doanh X”. Ví dụ cụ thể như “cải thiện khả năng sinh lời của các chiến dịch marketing”.
Một cạm bẫy phổ biến là không xử lý vấn đề theo “đúng” thứ tự. Nếu muốn cải thiện một quy trình, bạn cần hiểu đúng về nó trước khi nghĩ đến tự động hóa một phần. Khách hàng thường có hiểu biết hạn chế về dữ liệu của chính họ và chưa có kinh nghiệm với khoa học dữ liệu. Vì vậy, rất quan trọng là phải giải thích rõ cho họ các lựa chọn khác nhau dưới góc độ khoa học dữ liệu.
Thường thì bạn bắt đầu dự án bằng việc làm sạch và phân tích dữ liệu. Thuật ngữ “mô tả và chẩn đoán” được dùng khi bạn xây dựng tóm lược dữ liệu và cố gắng hiểu các biến khác nhau liên hệ với nhau thế nào. Bạn xây dựng trực quan hóa và dùng các kỹ thuật học máy (không giám sát) để gom cụm điểm dữ liệu hoặc tìm biến tương quan. Dựa trên kết quả, bạn có thể xây dựng báo cáo hoặc bảng điều khiển, liệt kê và phân tích một tập KPI hữu ích cho bài toán kinh doanh. Với các chiến dịch marketing, bạn có thể liên hệ dữ liệu bán hàng và marketing để hiểu vì sao chiến dịch thành công. Kết luận (ví dụ: giá thấp hơn dẫn đến nhiều đơn hàng hơn) có thể không phải là điều “cao siêu”, nhưng cho phép khách hàng kiểm chứng giả thuyết bằng dữ liệu của họ. Ngoài ra, điều này cũng giúp họ phát hiện hành vi bất thường và đánh giá xem họ có đúng loại dữ liệu cần thiết hay không.
Phân tích dự đoán và kê đơn liên quan đến dự báo tương lai và đưa ra hành động dựa trên các dự báo đó. Với phân tích dự đoán, bạn dùng dữ liệu lịch sử và xây dựng mô hình học máy để dự đoán các điểm dữ liệu tương lai (trong một khoảng sai số nhất định). Trong marketing, các ý tưởng chiến dịch mới thường được kiểm chứng bằng cách ước tính doanh số kỳ vọng thông qua mô hình dự đoán. Nhờ đã thực hiện giai đoạn mô tả và chẩn đoán trước đó, bạn sẽ có cái nhìn rõ về hiệu năng có thể kỳ vọng. Nếu chất lượng dữ liệu không đủ tốt để xây dựng mô hình vững, bạn có thể thông báo cho khách hàng và dùng chính dữ liệu họ cung cấp để chứng minh nhận định.
Với phân tích kê đơn, mục tiêu là đưa ra hành động dựa trên dự báo và tối ưu một số khía cạnh của quy trình. Thay vì chỉ kiểm chứng ý tưởng chiến dịch, bạn có thể xây dựng một bộ máy tối ưu hóa có khả năng sinh ra danh sách “những chiến dịch tương lai tốt nhất”. Xây dựng hệ thống này đòi hỏi lượng lớn dữ liệu chất lượng cao. Lưu ý rằng khoa học dữ liệu là về việc hứa ít làm nhiều, nên hãy bắt đầu nhỏ và xây dựng dần!
Bằng chứng khái niệm (PoC) so với thí điểm (pilot)
Khách hàng thường thích làm PoC để khảo sát khả năng của “khoa học dữ liệu”. Thông thường, điều này nghĩa là họ cung cấp một tập con dữ liệu và muốn xem một số kết quả sơ bộ. Dù khách hàng thường hiểu rằng hiệu năng với PoC sẽ không cao, đây vẫn là yêu cầu phổ biến. Tuy nhiên, nhược điểm của PoC là tập con dữ liệu thường không đại diện cho toàn bộ bộ dữ liệu và bài toán. Bạn có thể đạt hiệu năng cực tốt với PoC nhưng không thể lặp lại trên toàn bộ dữ liệu. Khách hàng có thể chọn dữ liệu bằng cách chỉ xem một đoạn thời gian nhỏ, điều này có thể làm sai lệch mạnh mô hình PoC.
Một lựa chọn tốt hơn nếu khách hàng muốn thử nghiệm là làm pilot. Trong pilot, bạn làm việc với toàn bộ dữ liệu và chạy một vòng lặp ban đầu của chu trình khoa học dữ liệu (làm sạch dữ liệu, mô hình hóa, v.v.). Làm việc với toàn bộ dữ liệu giúp giảm nhiều rủi ro trong dự án. Hiệu năng mô hình vẫn chưa tối ưu vì thời gian hạn chế, nhưng ít nhất bạn có được bức tranh đại diện.
Bộ dữ liệu mang tính đại diện
Dù cạm bẫy này tương tự cạm bẫy trước, nhưng không hoàn toàn giống. Đặc biệt khi làm với dữ liệu phi cấu trúc (ví dụ: hình ảnh, văn bản, v.v.), khách hàng có thể đã thu thập dữ liệu trước khi bạn bắt đầu dự án. Một yếu tố quan trọng nhưng thường bị bỏ qua là liệu bộ dữ liệu có mang tính đại diện cho trường hợp sử dụng hay không. Nếu cần thu thập dữ liệu, việc thu thập nên được thực hiện theo đúng cách mà sau này mô hình sẽ được sử dụng.
Ví dụ, nếu bạn muốn quản lý tồn kho bằng thị giác máy tính, điều quan trọng là có hình ảnh các vật thể trong cửa hàng hoặc trong tủ lạnh, nơi mô hình sẽ được dùng. Ảnh kiểu danh mục sản phẩm sẽ không cho ra mô hình vững, vì chúng không phản ánh trường hợp sử dụng. Mô hình phải học được các đặc trưng vững để phát hiện đối tượng trong môi trường thực.
Khó có thể tưởng tượng tủ lạnh của người dùng cuối lại sạch sẽ như thế này!
Hiệu năng cao và quá khớp
Quy tắc vàng của khoa học dữ liệu là hãy nghi ngờ khi bạn đạt hiệu năng cực cao (>90%) ngay từ đầu bài toán. Hiệu năng tốt khi mới bắt đầu có thể là dấu hiệu của các biến “rò rỉ” hoặc một bộ dữ liệu “rò rỉ”. Biến rò rỉ là những biến tương quan rất mạnh với biến đích và khó có khả năng sẵn có ở thời điểm suy luận. Nếu mục tiêu là dự đoán doanh số, bạn không thể dùng doanh số của sản phẩm khác làm đặc trưng vì dữ liệu này sẽ không có sẵn. Bộ dữ liệu “rò rỉ” xảy ra khi dữ liệu chỉ phản ánh một đoạn (thời gian) nhất định. Bài toán khi đó thường dễ hơn nhiều, và rất có thể mô hình sẽ khớp vào nhiễu thay vì tín hiệu thật.
Một mô hình có hiệu năng cao là tuyệt vời, nhưng chỉ khi nó hoạt động tốt tương tự trên một bộ dữ liệu hoàn toàn mới và ngẫu nhiên!
Diễn giải tương quan thành quan hệ nhân quả
Tôi rất thích bài viết này về ngụy biện thống kê. Diễn giải tương quan thành quan hệ nhân quả chỉ là một trong những lỗi thường gặp, và việc nắm vững thống kê đằng sau chúng là then chốt.
Tính diễn giải của mô hình và dữ liệu
Nếu khách hàng dùng mô hình làm cơ sở cho hành động, họ sẽ luôn ưu tiên các giải pháp có thể diễn giải và dễ hiểu. Trong bài viết này, tôi đã đi sâu vào lý do vì sao tính diễn giải của mô hình là chìa khóa. Tôi cũng cung cấp cái nhìn sâu hơn về các kỹ thuật bạn có thể sử dụng.
Kết luận
Tôi chỉ đề cập đến 6 cạm bẫy tiềm ẩn trong khoa học dữ liệu, nhưng tôi tin rằng mình còn mắc nhiều lỗi hơn thế trong năm vừa qua. Nếu bạn có kinh nghiệm với các dự án khoa học dữ liệu và muốn chia sẻ những vấn đề thường gặp, tôi rất vui được đọc trong phần bình luận. Theo dõi tôi trên Medium hoặc Twitter nếu bạn muốn nhận cập nhật về các bài viết!
Hãy xem hướng dẫn của DataCamp về Ngăn ngừa Quá khớp trong Học máy.
Nếu bạn muốn tìm hiểu thêm về khoa học dữ liệu, hãy xem các khóa học Nhập môn R và Nhập môn Python của DataCamp.