Curso
Comprender el machine learning
2 h
308K
Durante mis estudios tuve la oportunidad de trabajar en varios proyectos de investigación de aprendizaje automático. Estos proyectos iban desde el estudio de modelos probabilísticos hasta escenarios más prácticos en procesamiento del lenguaje natural. Un elemento común en mi trabajo era contar con problemas bien definidos y una abundancia de conjuntos de datos limpios.
El último año he trabajado como Data Scientist en Microsoft resolviendo problemas de clientes empresariales. La experiencia de trabajar en distintos sectores puso a prueba mis habilidades de muchas formas, tanto desde la perspectiva de la ciencia de datos como de la resolución de problemas. Una gran parte del tiempo se invierte en definir bien el problema, crear un conjunto de datos y limpiar los datos, y casi siempre es difícil conseguir conjuntos de datos suficientemente grandes.
En esta entrada comparto algunas lecciones aprendidas y errores que puedes encontrarte al trabajar en proyectos de ciencia de datos "en la vida real". Muchos de estos tropiezos aparecen casi siempre, y a menudo hay que ser "creativo" para sortearlos.
Hay varias formas de aprovechar los datos para mejorar procesos de negocio. El encargo típico de un cliente es "resolver el problema de negocio X". Un ejemplo concreto sería: "mejorar la rentabilidad de las campañas de marketing".
Un error común es no abordar los problemas en el orden adecuado. Si quieres mejorar un proceso, primero debes entenderlo bien antes de pensar en automatizar partes. Los clientes suelen tener un conocimiento limitado de sus propios datos y ninguna experiencia en ciencia de datos. Por eso es clave explicarles con claridad qué opciones hay desde la perspectiva de data science.
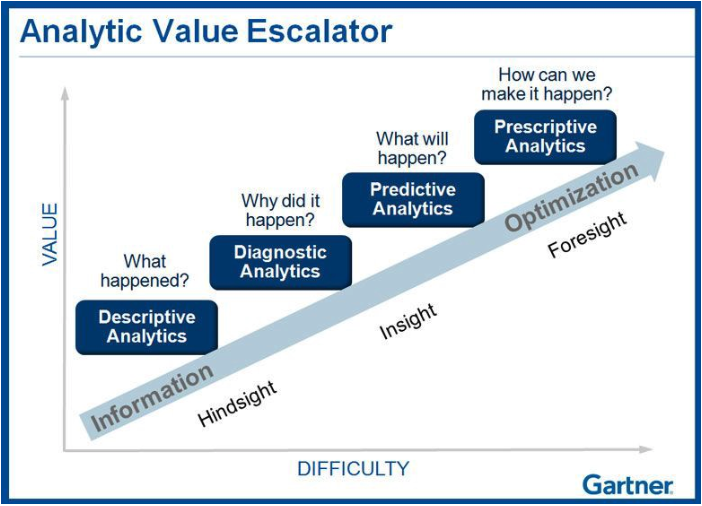
A menudo, empiezas el proyecto limpiando y analizando los datos. Hablamos de analítica "descriptiva y diagnóstica" cuando construyes resúmenes de los datos e intentas entender cómo se relacionan las variables. Creas visualizaciones y usas técnicas de aprendizaje automático no supervisado para agrupar puntos de datos o encontrar variables correlacionadas. Con el resultado, puedes elaborar, por ejemplo, un informe o un panel que recoja e investigue un conjunto de KPI útiles para el problema de negocio. En campañas de marketing, podrías correlacionar datos de ventas y marketing para entender por qué unas campañas funcionan y otras no. Las conclusiones (p. ej., un precio más bajo aumenta las ventas) quizá no sean ciencia de cohetes, pero permiten al cliente validar sus hipótesis con sus propios datos. Además, les ayuda a detectar comportamientos anómalos y a evaluar si disponen del tipo de datos adecuado.
La analítica predictiva y prescriptiva trata de anticipar el futuro y de actuar en base a esas predicciones. Con analítica predictiva tomas los datos históricos y construyes un modelo de aprendizaje automático para predecir datos futuros (dentro de un margen de error). En marketing, las ideas de nuevas campañas suelen validarse estimando las ventas esperadas con un modelo predictivo. Si has pasado por la fase descriptiva y diagnóstica, deberías tener una idea clara de qué rendimiento esperar. Si la calidad de los datos no es suficiente para construir un modelo robusto, puedes avisar al cliente y respaldar tus conclusiones con los datos que te han proporcionado.
Con la analítica prescriptiva, el objetivo es tomar decisiones basadas en las predicciones y optimizar ciertos aspectos del proceso. En lugar de validar ideas de campaña, podrías construir, por ejemplo, un motor de optimización que genere la lista de "mejores campañas futuras". Para crear este sistema se necesitan grandes volúmenes de datos de alta calidad. Recuerda que en ciencia de datos conviene prometer menos y entregar más: empieza en pequeño y crece con paso firme.
A los clientes suele gustarles trabajar con un Proof of Concept (PoC) para explorar qué es posible con la ciencia de datos. Normalmente esto implica que aporten un subconjunto de los datos y que quieran ver resultados preliminares. Aunque entiendan que con un PoC no se logrará un gran rendimiento, sigue siendo una petición habitual. El problema es que un subconjunto de los datos a menudo no es representativo del conjunto completo ni del problema real. Puede que el PoC arroje un rendimiento excelente, pero quizás no puedas replicarlo con todos los datos. A veces el cliente selecciona el dataset mirando solo un periodo muy acotado, lo que puede sesgar en gran medida el modelo del PoC.
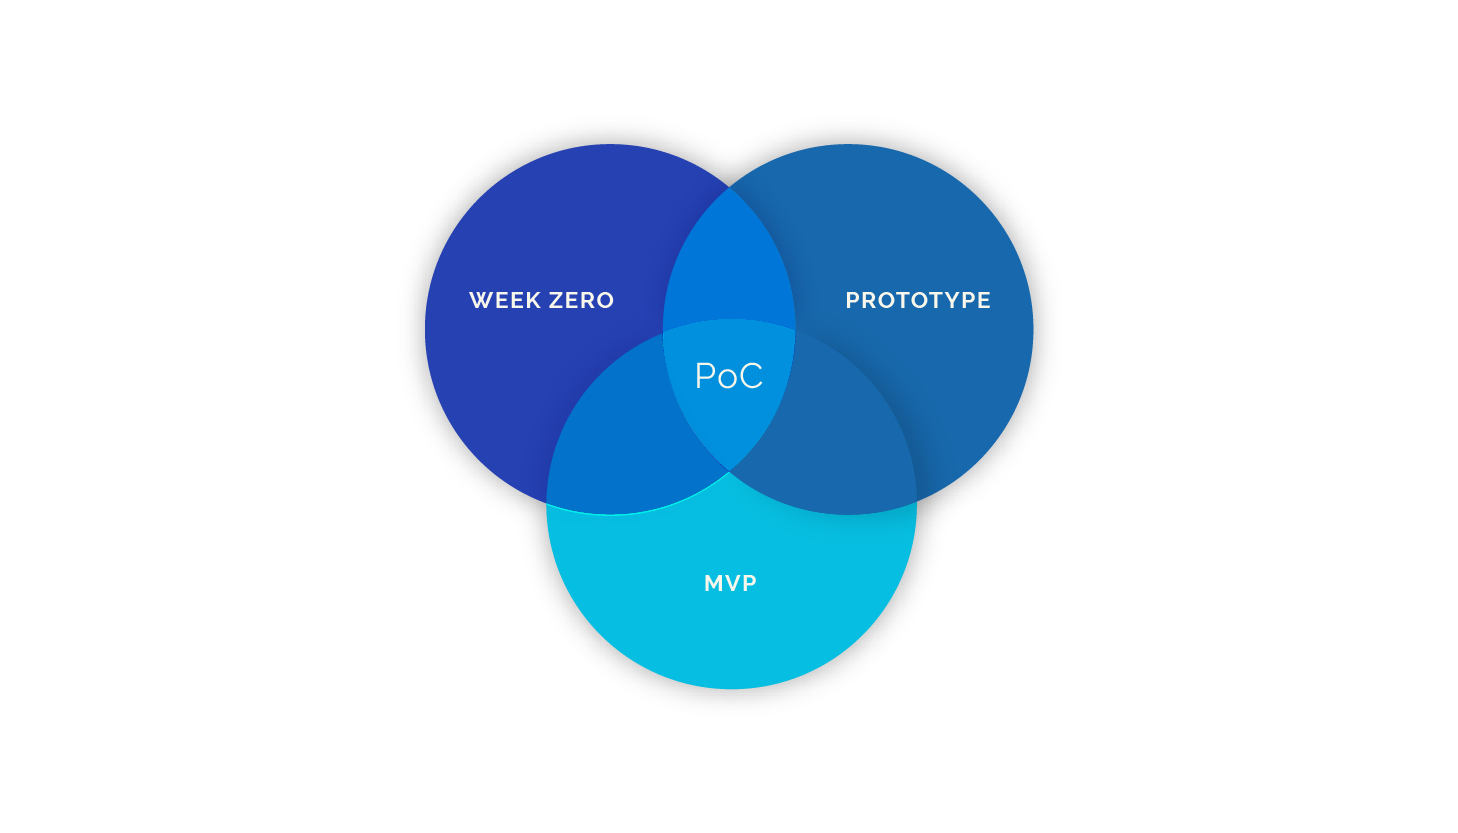
Si el cliente quiere experimentar, una opción mejor es trabajar con pilotos. En los pilotos trabajas con el conjunto de datos completo y recorres una primera iteración del pipeline de ciencia de datos (limpieza, modelado, etc.). Trabajar con todos los datos reduce muchos riesgos del proyecto. El rendimiento del modelo aún no será óptimo porque el tiempo es limitado, pero al menos podrás ofrecer una visión representativa.
Aunque este error se parece al anterior, no es lo mismo. Especialmente si trabajas con datos no estructurados (imágenes, texto, etc.), puede que el cliente ya haya recopilado datos antes de empezar. Un elemento crítico, pero a menudo pasado por alto, es si el conjunto de datos representa realmente el caso de uso. Si hay que recopilar datos, debe hacerse del mismo modo en que se usará el modelo finalmente.
Por ejemplo, si quieres hacer gestión de inventario con visión por computador, es importante contar con imágenes de objetos en la tienda o en la nevera donde se usará el modelo. Las imágenes de catálogo no darán lugar a un modelo robusto porque no representan el caso de uso. El modelo debe aprender rasgos sólidos para detectar el objeto en su entorno.
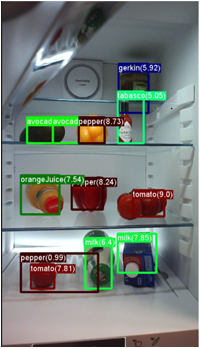
¡Cuesta creer que la nevera de las personas usuarias esté así de impecable!
La regla de oro en ciencia de datos es desconfiar cuando al principio obtienes un rendimiento extremadamente alto (>90%). Un buen rendimiento al inicio puede ser un indicador de variables "con fuga" o de un conjunto de datos "con fuga". Las variables con fuga están muy correlacionadas con la variable objetivo y es poco probable que estén disponibles en inferencia. Si quieres predecir ventas, no puedes usar como características las ventas de otros productos, porque esos datos no estarán disponibles. Un conjunto de datos "con fuga" aparece cuando el dataset solo refleja un segmento (temporal) concreto. El problema se vuelve artificialmente más sencillo y es muy probable que el modelo se ajuste al ruido en lugar de a la señal real.
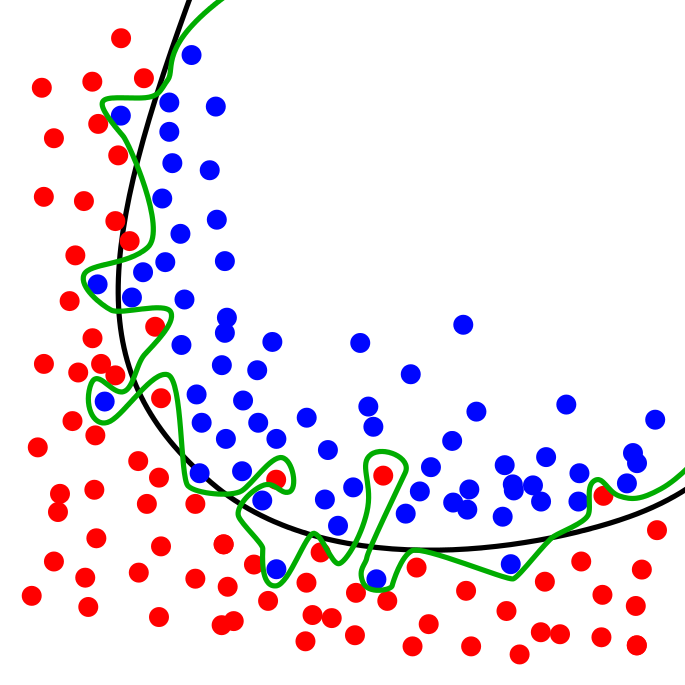
Un modelo con alto rendimiento es estupendo, pero solo si rinde igual de bien en un conjunto de datos completamente nuevo y aleatorio.
Me encantó esta entrada sobre falacias estadísticas. Interpretar la correlación como causalidad es solo uno de los errores comunes; entender bien la estadística detrás de estos sesgos es clave.
Si un cliente usa el modelo como base para tomar decisiones, siempre preferirá soluciones interpretables y comprensibles. En esta entrada profundicé en por qué la interpretabilidad del modelo es fundamental. También repasé con más detalle distintas técnicas que puedes utilizar.
Solo he mencionado 6 posibles errores en ciencia de datos, pero estoy convencido de que en el último año he cometido bastantes más. Si tienes experiencia en proyectos de ciencia de datos y quieres compartir los problemas que te encuentras a menudo, estaré encantado de leerlos en los comentarios. ¡Sígueme en Medium o en Twitter si quieres recibir novedades sobre mis publicaciones!
Echa un vistazo al tutorial de DataCamp sobre cómo prevenir el sobreajuste en machine learning.
Si te interesa aprender más sobre ciencia de datos, prueba los cursos de DataCamp Intro to R e Intro to Python.
Descubre más sobre machine learning
Curso
Curso
Curso
blog
Tim Lu
12 min
blog
Jose Jorge Rodriguez Salgado
12 min
blog
Abid Ali Awan
7 min
Tutorial
Moez Ali
14 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
Abid Ali Awan
9 min