Curso
Entendendo Machine Learning
2 h
308K
Durante meus estudos, tive a oportunidade de trabalhar em vários projetos de pesquisa em machine learning. Esses projetos iam desde o estudo de modelos probabilísticos até cenários mais práticos em processamento de linguagem natural. Um ponto em comum no trabalho que fiz foi a disponibilidade de problemas bem definidos e a abundância de conjuntos de dados limpos.
No último ano, atuei como Data Scientist na Microsoft, resolvendo problemas de clientes corporativos. A experiência adquirida ao trabalhar em diferentes setores colocou minhas habilidades à prova de várias formas, tanto do ponto de vista de ciência de dados quanto de resolução de problemas. Grande parte do tempo costuma ser dedicada a definir o problema, criar um conjunto de dados e fazer a limpeza desses dados, e conjuntos de dados grandes quase sempre são mais difíceis de conseguir.
Neste post do blog, compartilho alguns aprendizados e armadilhas que você pode enfrentar ao trabalhar em projetos de ciência de dados "no mundo real". Muitas dessas armadilhas quase sempre aparecem, e muitas vezes é preciso ser "criativo" para contorná-las.
Existem várias maneiras de usar dados para melhorar processos de negócio. O pedido que você geralmente recebe de um cliente é "resolver o problema de negócio X". Um exemplo concreto seria: "melhorar a rentabilidade das campanhas de marketing".
Uma armadilha comum é não atacar os problemas na ordem "certa". Se você quer melhorar um processo, precisa entendê-lo bem antes mesmo de pensar em automatizar partes dele. Clientes costumam ter pouco conhecimento sobre seus próprios dados e nenhuma experiência com ciência de dados. Por isso, é muito importante explicar claramente quais são as opções do ponto de vista de data science.
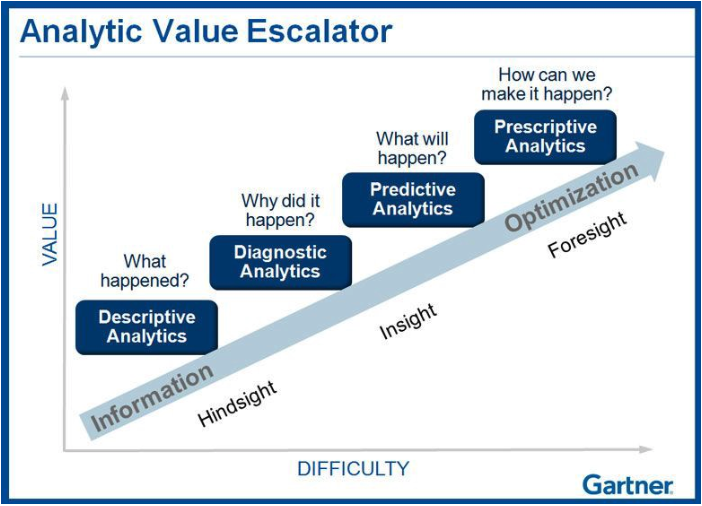
Muitas vezes, você começa o projeto limpando e analisando os dados. Os termos "descritiva e diagnóstica" são usados quando se busca resumir os dados e entender como as variáveis se relacionam. Você cria visualizações e usa técnicas de machine learning (não supervisionadas) para agrupar pontos de dados ou encontrar variáveis correlacionadas. Com base no resultado desse processo, você pode, por exemplo, construir um relatório ou dashboard que liste e investigue um conjunto de KPIs úteis para o problema de negócio. Em campanhas de marketing, você pode correlacionar dados de vendas e marketing para entender por que campanhas são bem-sucedidas. As conclusões (por exemplo, preço menor resulta em mais vendas) podem não ser nenhuma "ciência de foguetes", mas permitem que o cliente valide suas hipóteses usando seus próprios dados. Além disso, isso também ajuda a identificar comportamentos anômalos e a avaliar se eles têm o tipo certo de dado.
Análises preditivas e prescritivas tratam de prever o futuro e tomar ações com base nessas previsões. Com a análise preditiva, você pega os dados históricos e constrói um modelo de machine learning para projetar pontos futuros (dentro de uma certa margem de erro). Em marketing, novas ideias de campanha costumam ser validadas estimando as vendas esperadas com um modelo preditivo. Tendo passado pela etapa descritiva e diagnóstica, você deve ter uma noção clara do que esperar em termos de performance. Se a qualidade dos dados não for suficiente para criar um modelo robusto, isso pode ser sinalizado ao cliente e você consegue embasar suas alegações com os dados que ele forneceu.
Na análise prescritiva, o objetivo é agir com base nas previsões e otimizar certos aspectos do processo. Em vez de apenas validar ideias de campanha, você poderia, por exemplo, construir um motor de otimização que gere a lista das "melhores campanhas futuras". Construir esse sistema exige grandes volumes de dados de alta qualidade. Lembre que ciência de dados é sobre prometer menos e entregar mais, então comece pequeno e escale com consistência!
Clientes muitas vezes gostam de trabalhar com um Proof of Concept para investigar o que é possível com "ciência de dados". Normalmente, isso significa que fornecem um subconjunto dos dados e querem obter alguns resultados preliminares. Embora o cliente geralmente entenda que o desempenho não será ótimo em um PoC, essa ainda é uma solicitação comum. O problema do PoC é que um subconjunto dos dados muitas vezes não representa o dataset completo nem o problema. Você pode obter um desempenho excelente no PoC, mas não conseguir replicar isso no conjunto completo. Às vezes, o cliente escolhe os dados considerando apenas um recorte de tempo pequeno, o que pode enviesar fortemente o modelo do PoC.
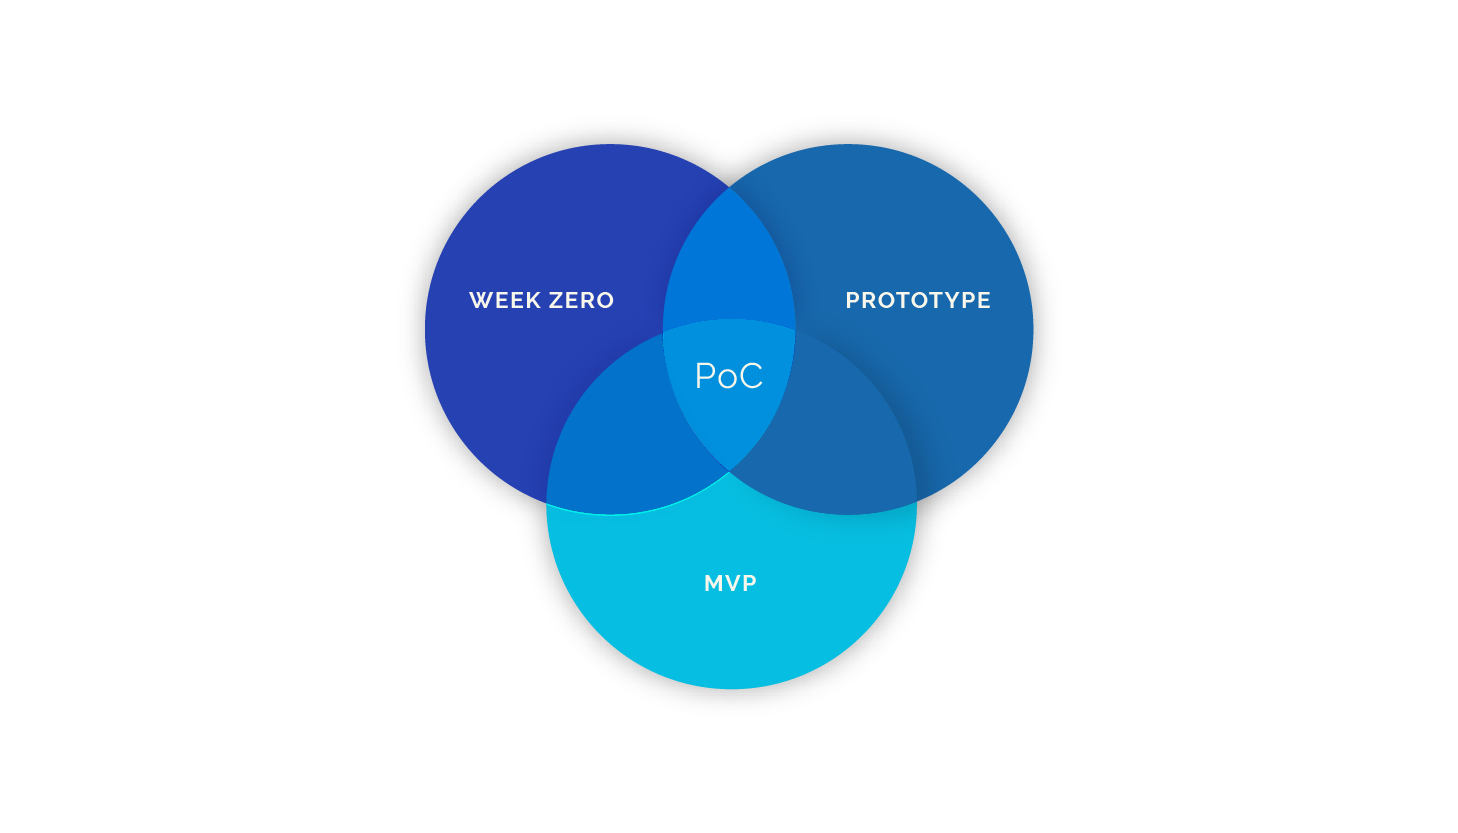
Uma opção melhor, se o cliente quer experimentar, é trabalhar com pilotos. Em pilotos, você usa o dataset completo e percorre uma primeira iteração do pipeline de ciência de dados (limpeza, modelagem etc.). Trabalhar com o conjunto completo reduz muitos riscos no projeto. O desempenho do modelo ainda não será o ideal, pois o tempo é limitado, mas pelo menos você deverá conseguir um retrato representativo.
Embora essa armadilha seja parecida com a anterior, não é a mesma coisa. Especialmente se você trabalha com dados não estruturados (imagens, textos etc.), o cliente pode já ter coletado dados antes de você começar. Um ponto crítico, mas muitas vezes negligenciado, é se o dataset representa o caso de uso. Se for necessário coletar dados, isso deve ser feito da mesma forma como o modelo será usado no fim.
Por exemplo, se você quer fazer gestão de estoque usando visão computacional, é importante ter imagens dos objetos na loja ou na geladeira onde o modelo será usado. Imagens de catálogo não vão gerar um modelo robusto, pois não representam o caso de uso. O modelo precisa aprender características robustas para detectar o objeto no ambiente real.
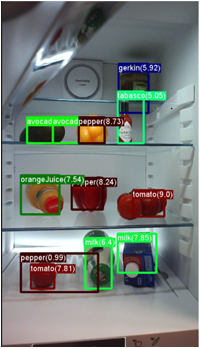
É difícil imaginar que a geladeira dos usuários finais será tão arrumada assim!
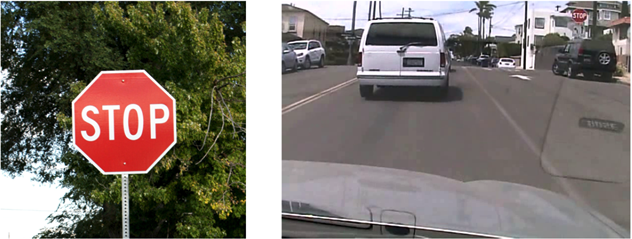
A regra de ouro da ciência de dados é desconfiar quando você obtém uma performance extremamente alta (>90%) logo no início. Um bom desempenho nessa fase pode indicar variáveis "vazadas" ou um dataset "vazado". Variáveis vazadas são altamente correlacionadas com a variável alvo e dificilmente estarão disponíveis no momento da inferência. Se o objetivo é prever vendas, você não pode usar as vendas de outros produtos como features, porque esses dados não estarão disponíveis. Um dataset "vazado" ocorre quando o conjunto reflete apenas um certo recorte (geralmente de tempo). O problema a ser resolvido fica tipicamente muito mais fácil, e é bem provável que o modelo se ajuste ao ruído em vez do sinal.
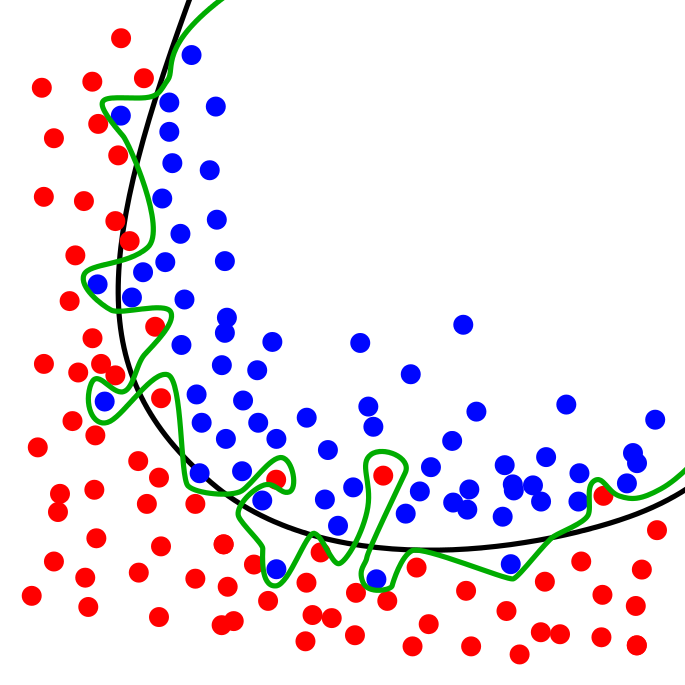
Um modelo com alta performance é ótimo — mas só se ele tiver um desempenho igualmente bom em um dataset totalmente novo e aleatório!
Eu gostei muito deste post sobre falácias estatísticas. Interpretar correlação como causalidade é apenas um dos tipos de erro mais comuns, e entender bem a estatística por trás disso é fundamental.
Se um cliente usa o modelo como base para ações, ele sempre vai preferir soluções interpretáveis e fáceis de entender. Neste post, aprofundei os motivos pelos quais a interpretabilidade de modelos é essencial. Também trouxe uma visão mais detalhada das diferentes técnicas que você pode usar.
Mencionei apenas 6 possíveis armadilhas em ciência de dados, mas tenho certeza de que cometi bem mais erros no último ano. Se você tem experiência em projetos de data science e quiser compartilhar problemas recorrentes, vou adorar ler seus comentários. Siga-me no Medium ou no Twitter para receber novidades dos meus posts!
Confira o tutorial da DataCamp sobre como prevenir overfitting em machine learning.
Se você quer aprender mais sobre ciência de dados, veja os cursos da DataCamp Intro to R e Intro to Python.
Saiba mais sobre machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
7 min
blog
Tim Lu
12 min
blog
Elena Kosourova
15 min
blog
Matt Crabtree
15 min
Tutorial
Moez Ali
14 min