Kurs
Machine Learning verstehen
2 Std.
308K
Während meines Studiums hatte ich die Gelegenheit, an mehreren Machine-Learning-Forschungsprojekten zu arbeiten. Diese Projekte reichten von probabilistischen Modellen bis hin zu praktischeren Szenarien in der Verarbeitung natürlicher Sprache. Ein gemeinsamer Nenner: klar abgegrenzte Problemstellungen und reichlich saubere Datensätze.
Im vergangenen Jahr habe ich als Data Scientist bei Microsoft gearbeitet und Probleme von Unternehmenskunden gelöst. Die Erfahrungen aus verschiedenen Branchen haben meine Kompetenzen auf vielfältige Weise gefordert – sowohl aus Data-Science- als auch aus Problemlösungsperspektive. Ein großer Teil der Zeit fließt in die saubere Problemdefinition, das Erstellen eines Datensatzes und das Datenbereinigen. Große, hochwertige Datensätze sind fast immer Mangelware.
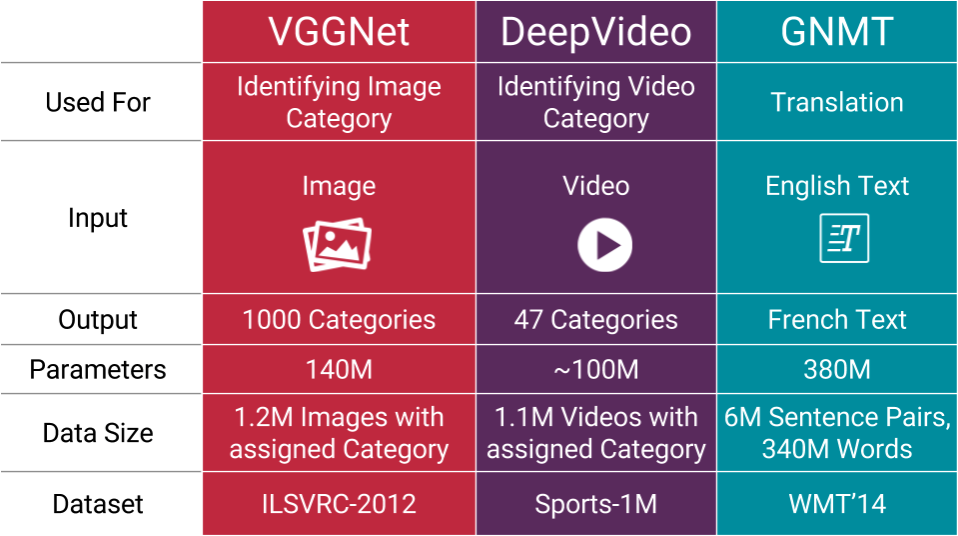
In diesem Blogpost teile ich einige Learnings und typische Fallstricke, die dir bei Data-Science-Projekten „in freier Wildbahn“ begegnen. Viele dieser Stolperfallen sind fast immer präsent – oft braucht es Kreativität, um sie zu umgehen.
Es gibt mehrere Wege, wie sich Daten nutzen lassen, um Geschäftsprozesse zu verbessern. Der Auftrag lautet oft: „Löse Geschäftsproblem X“. Ein konkretes Beispiel wäre etwa: „Steigere die Profitabilität der Marketingkampagnen“.
Ein häufiger Fehler ist, die Probleme nicht in der richtigen Reihenfolge anzugehen. Wer einen Prozess verbessern will, muss ihn erst wirklich verstehen – bevor man überhaupt daran denkt, Teile davon zu automatisieren. Kundinnen und Kunden haben oft nur begrenztes Wissen über ihre eigenen Daten und wenig Data-Science-Erfahrung. Umso wichtiger ist es, die möglichen Ansätze aus Data-Science-Sicht klar und verständlich aufzuzeigen.
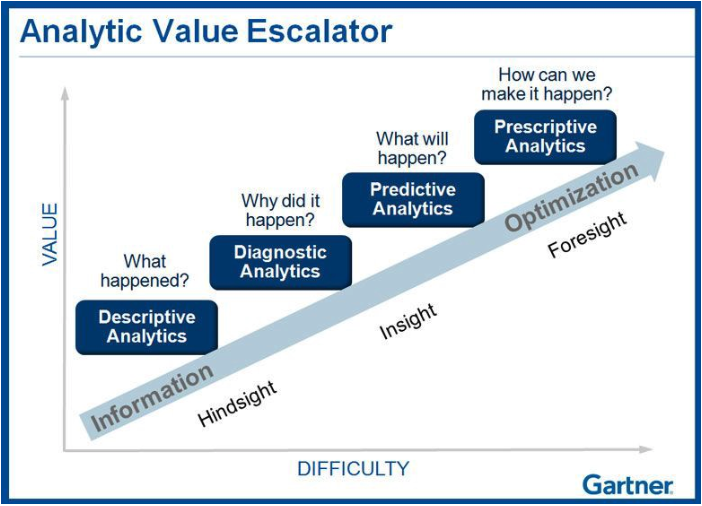
Oft startet ein Projekt mit Datenbereinigung und -analyse. Von „descriptive und diagnostic“ Analytics spricht man, wenn Daten zusammengefasst werden und man verstehen will, wie Variablen zusammenhängen. Du erstellst Visualisierungen und nutzt (unüberwachtes) Machine Learning, um Datenpunkte zu clustern oder korrelierte Variablen zu finden. Basierend darauf kannst du z. B. einen Bericht oder ein Dashboard erstellen, das eine Reihe geschäftsrelevanter KPIs aufführt und untersucht. Bei Marketingkampagnen lässt sich so etwa der Zusammenhang zwischen Sales- und Marketingdaten analysieren, um zu verstehen, warum Kampagnen erfolgreich sind. Die Erkenntnisse (z. B. ein niedrigerer Preis führt zu mehr Verkäufen) sind nicht immer bahnbrechend, ermöglichen aber, Hypothesen mit eigenen Daten zu belegen. Zudem hilft es, Ausreißer zu erkennen und zu prüfen, ob die richtigen Datenarten vorliegen.
Predictive und Prescriptive Analytics drehen sich um Vorhersagen und daraus abgeleitete Aktionen. Bei Predictive Analytics nutzt du historische Daten und trainierst ein Machine-Learning-Modell, um künftige Datenpunkte innerhalb eines Fehlerspielraums vorherzusagen. Im Marketing werden neue Kampagnenideen häufig validiert, indem die erwarteten Verkäufe über ein Vorhersagemodell geschätzt werden. Wenn du die beschreibende und diagnostische Phase vorher sauber gemacht hast, weißt du, welche Performance realistisch ist. Ist die Datenqualität nicht gut genug für ein robustes Modell, kannst du das transparent machen und deine Einschätzung mit den gelieferten Daten untermauern.
Bei Prescriptive Analytics geht es darum, auf Basis der Vorhersagen Maßnahmen abzuleiten und Aspekte des Prozesses zu optimieren. Anstatt Ideen nur zu validieren, könntest du z. B. eine Optimierungs-Engine bauen, die die „besten zukünftigen Kampagnen“ vorschlägt. Dafür braucht es große Mengen hochwertiger Daten. Merke: In der Data Science gilt lieber wenig versprechen und mehr liefern – klein anfangen, groß rauskommen!
Kundinnen und Kunden arbeiten gern mit einem Proof of Concept, um auszuloten, was mit „Data Science“ möglich ist. Meist bedeutet das: Sie liefern einen Datenausschnitt, und man will erste Ergebnisse sehen. Obwohl oft klar ist, dass ein PoC keine Spitzenperformance liefern wird, ist die Anfrage gängig. Der Haken: Ein Teil-Datensatz repräsentiert das Gesamtbild und Problem häufig nicht. Es kann sein, dass der PoC extrem gut performt – sich das aber nicht auf den vollen Datensatz übertragen lässt. Häufig wird z. B. nur ein kurzer Zeitraum gewählt, was das PoC-Modell stark verzerren kann.
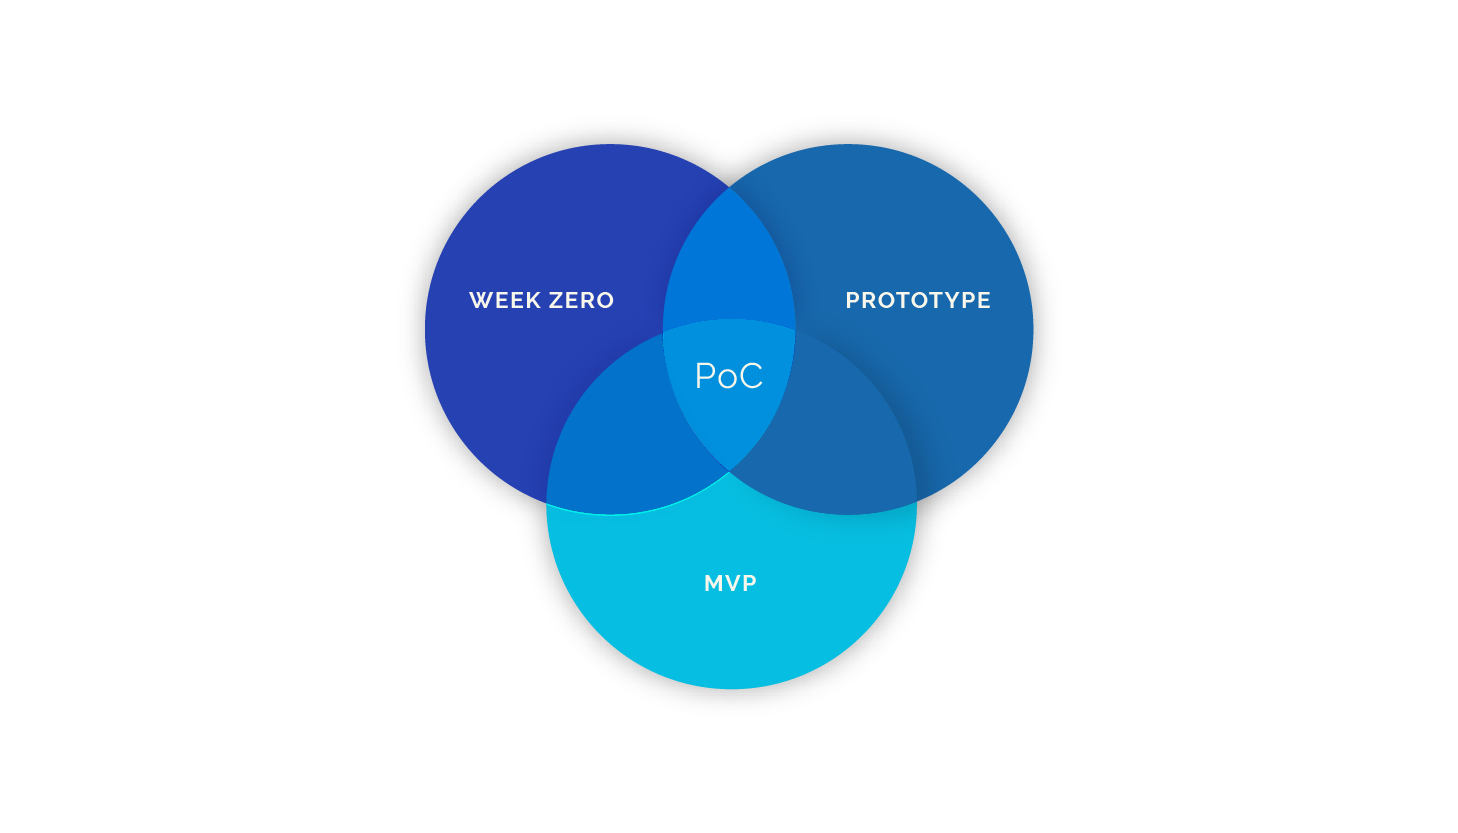
Die bessere Option fürs Experimentieren sind Pilotprojekte. In Piloten arbeitest du mit dem vollständigen Datensatz und durchläufst eine erste Iteration der Data-Science-Pipeline (Datenbereinigung, Modellierung etc.). Mit allen Daten zu arbeiten, reduziert Projektrisiken deutlich. Die Modellleistung ist zwar noch nicht optimal, da die Zeit begrenzt ist, aber du erhältst ein repräsentatives Bild.
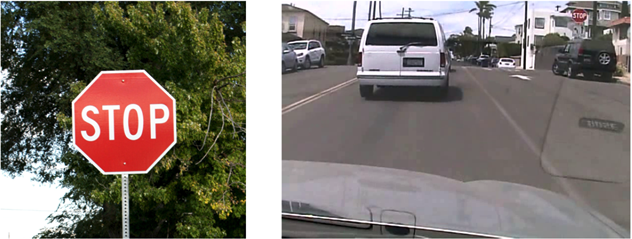
Diese Stolperfalle ist ähnlich, aber nicht identisch. Besonders bei unstrukturierten Daten (z. B. Bilder, Texte) kommt es vor, dass schon Daten gesammelt wurden, bevor das Projekt startet. Ein kritischer, oft übersehener Punkt ist, ob der Datensatz den Anwendungsfall wirklich abbildet. Müssen Daten erst erhoben werden, sollte das so geschehen, wie das Modell später tatsächlich eingesetzt wird.
Beispiel: Willst du Bestandsmanagement per Computer Vision umsetzen, brauchst du Bilder von Objekten im Laden oder Kühlschrank – also dort, wo das Modell laufen wird. Katalogbilder führen nicht zu einem robusten Modell, weil sie den Use Case nicht repräsentieren. Das Modell muss robuste Merkmale lernen, um das Objekt in seiner realen Umgebung zu erkennen.
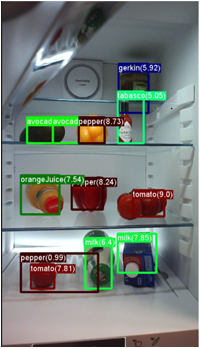
Es ist schwer vorstellbar, dass der Kühlschrank der Endnutzer so ordentlich aussieht!
Die goldene Regel in der Data Science: Sei misstrauisch, wenn du zu Beginn extrem gute Ergebnisse (>90%) siehst. Sehr gute Performance gleich zu Projektstart deutet oft auf „leakige“ Variablen oder einen „leakigen“ Datensatz hin. Leakige Variablen sind stark mit der Zielgröße korreliert, stehen zur Inferenzzeit aber wahrscheinlich nicht zur Verfügung. Wenn du Verkäufe vorhersagen willst, kannst du z. B. die Verkäufe anderer Produkte nicht als Feature nutzen, weil diese Daten später nicht vorliegen. Ein „leakiger“ Datensatz liegt vor, wenn er nur einen bestimmten (Zeit-)Ausschnitt abbildet. Das Problem wirkt dadurch leichter, und das Modell lernt womöglich Rauschen statt Signal.
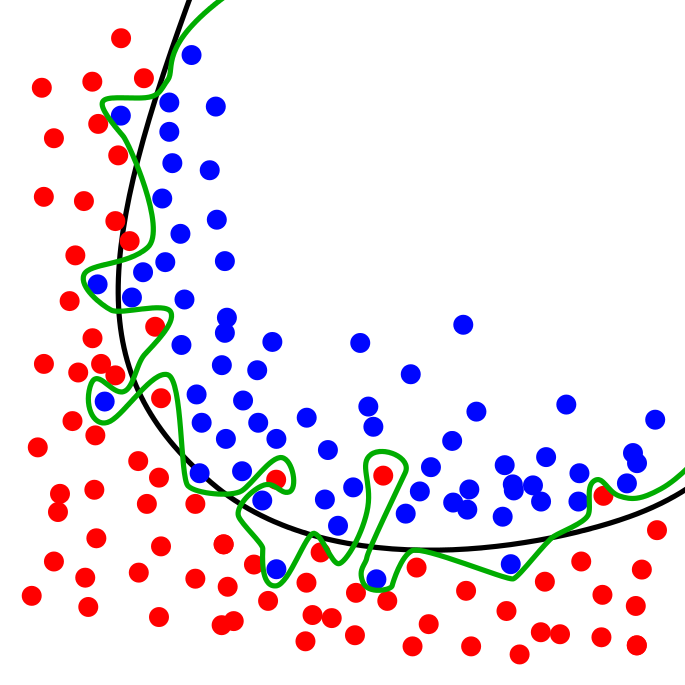
Ein Modell mit hoher Performance ist super – aber nur, wenn es auf komplett neuen, zufälligen Daten genauso gut abschneidet!
Ich kann diesen Blogpost über statistische Trugschlüsse sehr empfehlen. Korrelation als Kausalität zu deuten ist nur einer von vielen häufigen Fehlern – ein solides Statistikverständnis ist hier entscheidend.
Wenn Entscheidungen auf Basis des Modells getroffen werden, sind interpretierbare, nachvollziehbare Lösungen immer bevorzugt. In diesem Blogpost gehe ich ausführlich darauf ein, warum Modellinterpretierbarkeit so wichtig ist, und stelle Techniken vor, die du nutzen kannst.
Ich habe hier nur 6 potenzielle Data-Science-Stolperfallen angerissen – wahrscheinlich habe ich im letzten Jahr deutlich mehr Fehler gemacht. Wenn du Erfahrungen aus Data-Science-Projekten teilen willst und typische Probleme kennst, freue ich mich auf deine Kommentare. Folge mir auf Medium oder Twitter, um Updates zu meinen Blogposts zu erhalten!
Wirf einen Blick auf DataCamps Tutorial zu Overfitting im Machine Learning verhindern.
Wenn du mehr über Data Science lernen willst, schau dir DataCamps Kurse Intro to R und Intro to Python an.
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs