单棵决策树易于解释,但容易过拟合。简单的线性模型泛化性好,却难以捕捉复杂模式。每种模型都有其盲点,限制了其在真实数据上的准确性。
集成方法通过将多个模型组合成一个模型来解决这一问题。它们不依赖单一预测器,而是聚合多个模型的预测,使个体错误相互抵消。结果通常比任何单个模型都更准确。
在本教程中,我将讲解核心集成方法之间的差异,并重点介绍两种最流行的集成算法:Random Forest 和 XGBoost。
您将了解它们各自的工作原理,在一个多分类问题上实现二者,并比较其性能。目标是帮助您在实践中理解何时使用各自的方法,以及如何在自己的项目中进行调参。
如果您想进行更多动手练习,建议查看Ensemble Methods in Python 课程。
什么是集成学习?
集成学习会训练多个模型,并将它们的预测组合成单一输出。思想很简单:不同模型会犯不同的错误,因此对许多模型的预测进行平均或投票,往往能抵消个体错误。
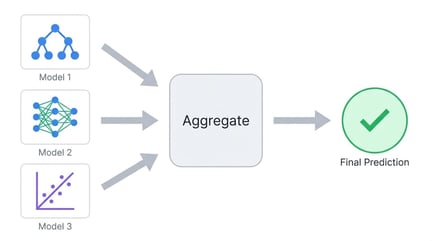
集成学习将多个模型的预测合成为一个聚合输出
考虑一个分类任务,您训练了五棵决策树。每棵树也许能正确预测 80% 的样本,但它们不会在同一批样本上同时失败。当您聚合它们的投票时,即使有一两棵树出错,多数投票仍常常是正确的。这是所有集成方法的核心原理。
集成中的模型称为基学习器。它们可以是任何算法,但决策树最常见,因为其训练速度快,并且在给定不同数据子集时天然会产生多样化的预测。
偏差-方差权衡
模型误差主要来自两个方面:偏差和方差。
偏差(Bias)是由于过度简化问题产生的误差。线性模型试图拟合曲线关系时偏差很高,因为无论有多少数据,它都无法表示真实模式。高偏差模型在不同训练集上产生相似预测,但这些预测始终偏离目标。
方差(Variance)是对训练数据过于敏感产生的误差。记忆训练集的深层决策树方差很高,因为它将噪声与信号一并捕捉。若您在稍微不同的样本上重新训练同一算法,会得到截然不同的预测。该模型在训练数据上表现很好,但在新数据上崩溃。
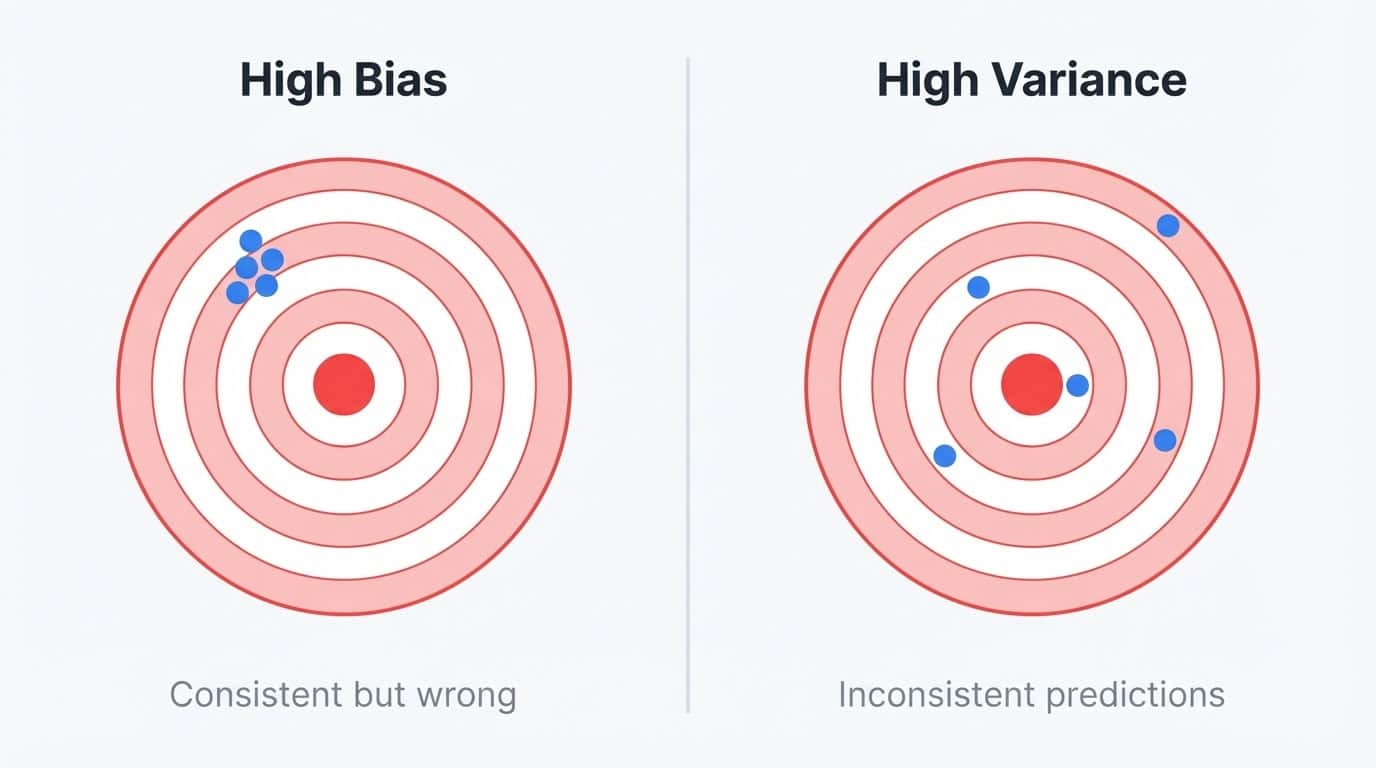
用飞镖盘示意偏差与方差:高偏差表现为稳定但偏离靶心,高方差表现为分散且不稳定
可以把这看作一个稳定性问题。高偏差模型很稳定,但每次都以相同方式出错。高方差模型不稳定,会因所见数据不同而以不同方式出错。
理想模型既稳定又准确,但降低一种误差往往会提升另一种误差。
决策树明显属于高方差阵营。它们使用贪心分裂,这意味着训练数据的微小变化会导致完全不同的树结构。
对同一总体的两个随机样本训练相同的树算法,您可能会得到两棵看起来完全不同的树。这种不稳定性让单棵树不够可靠,但也使其成为构建集成的理想基石。
高方差意味着通过聚合有改进空间。树还具有训练速度快、无需手工特征工程即可处理非线性关系等优势,这就是为什么 Random Forest 和 XGBoost 都使用树,尽管它们从偏差-方差问题的不同方面入手。
集成方法通过组合多个模型来打破这种权衡:
Bagging
Bagging在数据的随机子集上并行训练多个模型,然后对其预测进行平均。这样通过平滑个体模型的“怪癖”来降低方差。直觉是:如果每个模型的错误相对独立,平均就能抵消这些错误。组合的模型越多,最终预测越稳定。这也是 Random Forest 默认使用 100 棵树而非 10 棵的原因。
Boosting
Boosting则是按序训练模型,每个新模型专注于前一批模型的错误。它通过将多个弱学习器“堆叠”成强学习器来降低偏差。
集成学习:Bagging vs Boosting
我们来看看 Bagging 与 Boosting 在实践中的工作方式。
Bagging:并行训练以降低方差
Bagging 是自助聚合(bootstrap aggregating)的缩写。流程分三步:
1. 从原始数据中有放回抽样,创建多个训练集(自助样本)
2. 在每个自助样本上独立训练一个模型
3. 通过平均(回归)或多数投票(分类)来组合预测
自助抽样意味着每个训练集与原始数据集等大,但某些样本会重复出现,而另一些则完全被遗漏。平均来看,每个自助样本包含原始数据约 63% 的不重复样本。剩余约 37% 的样本称为袋外样本,可用于验证。
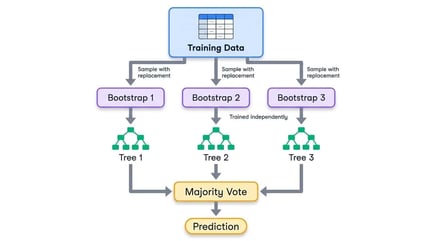
Bagging 工作流:训练数据被分成自助样本,各自训练独立决策树,再通过多数投票合并
由于每个模型看到的数据切片不同,它们会形成不同的“偏好”。一些会在特征空间的某一区域过拟合,另一些则在另一片区域过拟合。当您聚合它们的预测时,这些个体错误往往会相互抵消。集成的预测比任何单个模型都更稳定。
训练是并行进行的,因为这些模型彼此独立。这使得 Bagging 易于在多核 CPU 上扩展。Random Forest(您稍后将在本教程中实现)是最广泛使用的 Bagging 算法。若想深入理论,请参阅 DataCamp 的机器学习 Bagging 指南。
Boosting:顺序训练以降低偏差
Boosting 的思路不同。它不是独立训练模型,而是一个接一个地训练,每个新模型专注于前面模型做错的样本。
一般流程如下:
1. 在完整训练集上训练一个弱模型
2. 找出该模型表现不佳的样本
3. 训练下一个模型,并对这些困难样本给予更高权重
4. 重复上述步骤,添加模型以纠正剩余错误
5. 将所有模型按加权和组合,表现更好的模型获得更高权重
“弱学习器”指仅略好于随机猜测的模型。决策树桩(只有一次分裂的树)很常见。单个树桩几乎没用,但 Boosting 会堆叠上百个,每个都在削减前一批遗留的误差。最终的集成是由许多微小贡献构成的强学习器。
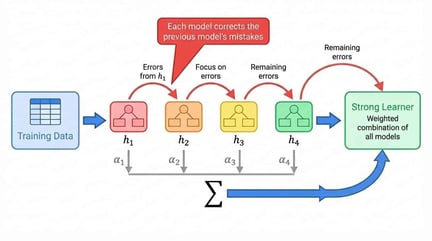
Boosting 工作流:顺序训练、纠错,并按加权和组合
与 Bagging 不同,Boosting 天生是顺序的。在不了解第 1 到第 46 个模型遇到哪些困难样本之前,您无法训练第 47 个模型。这使得 Boosting 训练更慢,但往往更准,因为每个模型都是为修补集成中的特定弱点而生。
XGBoost(您将在本教程后面实现)是一种梯度提升算法,已成为处理表格数据的首选。我推荐这份Boosting 入门指南,其中更详细地讲解了数学原理。
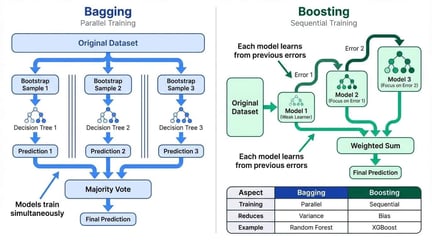
Bagging 与 Boosting 的对比:前者并行降方差,后者顺序降偏差
其他集成学习方法
Bagging 和 Boosting 是最广泛使用的集成策略,但并非唯一选择。在深入 Random Forest 与 XGBoost 之前,了解其他方法也很有价值。
投票与平均
最简单的模型组合方式是投票。硬投票中,每个模型给出一个预测,得票最多的类别胜出。比如有逻辑回归、支持向量机和决策树三种模型,其中两者预测为 A,一者为 B,则集成输出 A。
软投票更进一步,平均预测概率而不是计数离散投票。对类别 A 给出 90% 置信度的模型,会比给出 51% 置信度的模型对最终决策贡献更大。由于能反映模型的不确定性,这通常优于硬投票。
您也可以分配权重,让更强的模型影响更大。如果逻辑回归在验证数据上稳定优于其他模型,可以给它 2 倍权重,而其他模型为 1 倍。
当组合不同建模思路的模型时,投票效果最佳。线性模型、基于树的模型和近邻模型各有不同盲点。它们的组合预测常常优于任何单个模型,即便没有一个模型特别强。scikit-learn 提供了VotingClassifier和VotingRegressor以实现这一点。
Stacking 与 Blending
Stacking 将集成思想更进一步。它不是简单平均预测,而是训练第二层模型(称为元学习器)来组合这些预测。流程是:训练若干基模型,在验证集上收集它们的预测,然后训练元学习器将这些预测映射到正确标签。元学习器会学会在何种情境下信任哪个基模型。
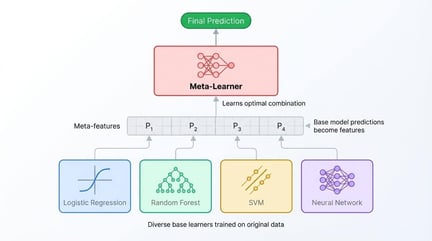
Stacking 架构:多样基模型的预测输入元学习器,组合成最终输出
Blending 是更简单的变体,使用单个留出集而非交叉验证折。它实现更快,但浪费部分训练数据,且更容易对留出集过拟合。
这两种技术能再挤出一点点准确率提升,但相对增加的复杂度通常只换来 0.1–0.5% 的改进。堆叠集成更难调试、更慢训练,也更难向利益相关方解释。它们在 Kaggle 竞赛中大放异彩(每一位小数都重要,训练时间不受限),但在生产中很少值得付出这类开销。
有趣的是,大多数堆叠集成都以 Random Forest 和 XGBoost 作为基学习器。这两种算法太强了,以至于 Stacking 往往只是更复杂的“平均它们的预测”。
为何本教程聚焦 Bagging 与 Boosting
本教程只讨论 Random Forest(Bagging)和 XGBoost(Boosting),因为它们覆盖了绝大多数真实场景下的表格数据问题。与多层堆叠集成相比,它们实现更简单、调参更容易、维护也更直接。
如果您想更深入了解投票与堆叠,DataCamp 的Ensemble Methods in Python课程覆盖了完整技术谱系。接下来,让我们上手数据集。
为集成分类准备数据
本教程使用UCI 机器学习资料库的 Dry Beans 数据集。研究者 Koklu 和 Ozkan(2020)拍摄了来自七个品种的 13,611 粒干豆,并从每张图像中提取了 16 个几何特征,包括面积、周长、轴长和形状因子。任务是根据这些测量将每粒豆子分类到对应品种。
该数据集很适合本教程,因为它是一个干净的多分类问题,且全部为数值特征。没有缺失值,无需类别编码,也无需文本预处理。您可以把精力全部放在集成方法上。
加载与划分数据
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f"Features shape: {X.shape}")
 print(f"Target classes: {pd.Series(y).nunique()}")技术支持
Features shape: (13611, 16)
 Target classes: 7技术支持
X.head()技术支持
|
|
Area
|
Perimeter
|
MajorAxisLength
|
MinorAxisLength
|
AspectRatio
|
Eccentricity
|
ConvexArea
|
EquivDiameter
|
Extent
|
Solidity
|
Roundness
|
Compactness
|
ShapeFactor1
|
ShapeFactor2
|
ShapeFactor3
|
ShapeFactor4
|
|
0
|
28395
|
610.291
|
208.178
|
173.889
|
1.197
|
0.550
|
28715
|
190.141
|
0.764
|
0.989
|
0.958
|
0.913
|
0.007
|
0.003
|
0.834
|
0.999
|
|
1
|
28734
|
638.018
|
200.525
|
182.734
|
1.097
|
0.412
|
29172
|
191.273
|
0.784
|
0.985
|
0.887
|
0.954
|
0.007
|
0.004
|
0.910
|
0.998
|
|
2
|
29380
|
624.110
|
212.826
|
175.931
|
1.210
|
0.563
|
29690
|
193.411
|
0.778
|
0.990
|
0.948
|
0.909
|
0.007
|
0.003
|
0.826
|
0.999
|
|
3
|
30008
|
645.884
|
210.558
|
182.517
|
1.154
|
0.499
|
30724
|
195.467
|
0.783
|
0.977
|
0.904
|
0.928
|
0.007
|
0.003
|
0.862
|
0.994
|
|
4
|
30140
|
620.134
|
201.848
|
190.279
|
1.061
|
0.334
|
30417
|
195.897
|
0.773
|
0.991
|
0.985
|
0.971
|
0.007
|
0.004
|
0.942
|
0.999
|
pd.Series(y).value_counts()技术支持
DERMASON	3546
 SIRA    	2636
 SEKER   	2027
 HOROZ   	1928
 CALI    	1630
 BARBUNYA	1322
 BOMBAY   	522技术支持
各类别的分布较为均衡,其中 Dermason 最多,Bombay 最少。分层抽样划分可在训练集和测试集中保持这些比例:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f"Training set: {X_train.shape[0]} samples")
 print(f"Test set: {X_test.shape[0]} samples")技术支持
Training set: 10888 samples
 Test set: 2723 samples技术支持
Python 中的 Random Forest 分类器
数据准备就绪后,是时候训练第一个集成模型了。本节介绍 Random Forest 的底层原理,带您完成训练与评估,并展示如何调参。
Random Forest 的工作原理
Random Forest 将 Bagging 应用于决策树,并加入一个额外“随机特征子集”的机制。每棵树在一个自助样本上训练(上一节已述),但在每次分裂时,算法只考虑随机抽取的一部分特征,而非全部特征。
这种特征随机化可防止树变得过于相似。否则,相同的强预测因子会主导每棵树,而集成就会变成许多几乎相同模型的复制品。
通过强制每次分裂仅在有限特征中做选择,算法生成彼此差异更大的树,从而犯不同的错误。当这些树共同投票时,个体错误往往相互抵消。
对分类问题,scikit-learn 默认在每次分裂时考虑总特征数的平方根。对于拥有 16 个特征的 Dry Beans 数据集,每次分裂仅评估随机选取的 4 个特征。结果是一个去相关的树集成,其泛化能力优于任何单棵树。
训练与评估
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}")
 print(classification_report(y_test, y_pred_rf))技术支持
Accuracy: 0.9199
           	precision	recall  f1-score   support

 	BARBUNYA   	0.94      0.89  	0.92   	265
   	BOMBAY   	1.00      1.00  	1.00   	104
     	CALI   	0.94      0.94  	0.94   	326
 	DERMASON   	0.90      0.92  	0.91   	709
    	HOROZ   	0.96      0.95  	0.96   	386
    	SEKER   	0.94      0.96  	0.95   	406
     	SIRA   	0.86      0.85  	0.86   	527

 	accuracy                       	0.92 	 2723
    macro avg   	0.93      0.93  	0.93  	2723
 weighted avg   	0.92  	0.92      0.92  	2723技术支持
这段代码创建了一个包含 100 棵决策树的森林,在自助样本上训练,并通过多数投票生成预测。random_state参数固定随机种子以保证结果可复现。
分类报告按类别分解了性能。Precision(精确率)衡量预测为正的样本中有多少是真正,Recall(召回率)衡量实际为正的样本中有多少被找回,F1 值是二者的调和平均。Bombay 豆被完美分类(可能是因为其形态差异明显),而 Sira 豆最难与其他品种区分。
Random Forest 的一个优势是可解释的特征重要性。算法会跟踪每个特征在所有树中降低不纯度(默认 Gini 指数)的贡献,为您提供哪些变量最重要的度量:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()技术支持
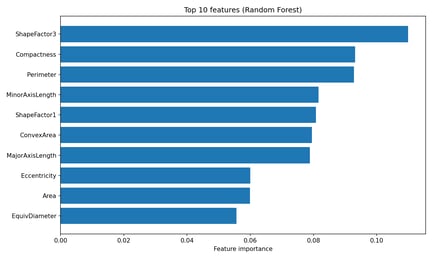
Random Forest 特征重要性
feature_importances_属性返回一个和为 1 的分数数组,值越高表示该特征对分裂决策的贡献越大。ShapeFactor3 和 Compactness 对分类贡献最大,其次是 Perimeter 与 MinorAxisLength 等几何测量。这些形状相关特征捕捉了豆类品种之间的视觉差异,正是原始研究者设计该数据集所要衡量的。
值得调参的超参数
Random Forest 有三个主要超参数值得调优:
n_estimators:森林中树的数量。树越多,预测越稳定,但训练更慢。多数数据集在 200 棵以上收益递减。max_depth:每棵树的最大深度。默认值(None)会持续生长,直到叶子纯净或样本少于 2。较低的取值可防止过拟合。max_features:每次分裂考虑的特征数。默认"sqrt"对分类效果好。使用"log2"可提升多样性,但单棵树精度会下降。
一个快速的网格搜索:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f"Best params: {grid_search.best_params_}")
 print(f"Best CV accuracy: {grid_search.best_score_:.4f}")技术支持
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
 Best CV accuracy: 0.9244技术支持
GridSearchCV会尝试网格中每种参数组合,并通过交叉验证评估。cv=3将训练数据分成 3 折,轮流用 2 折训练、1 折验证。n_jobs=-1会并行利用所有可用 CPU 核心。
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}")技术支持
Tuned test accuracy: 0.9214技术支持
调参将准确率从 92.0% 提升到 92.1%,改进不大。最佳配置对max_depth与max_features沿用默认,仅将树数从 100 提到 200。Random Forest 常常“开箱即用”表现良好,这正是其主要魅力之一。想更深入了解 Random Forest 及其参数,请参阅 DataCamp 的Random Forest 分类教程。
Python 中的 XGBoost 分类器
XGBoost(Extreme Gradient Boosting)与 Random Forest 走的是不同的准确率之路。Random Forest 通过对独立树的平均来降低方差,而 XGBoost 通过顺序训练树、让每棵新树纠正已有集成的错误来降低偏差。本节介绍梯度提升的工作方式、XGBoost 的独特之处,以及如何在 Dry Beans 数据集上训练与调参。
梯度提升的工作原理
梯度提升一次构建一棵树。第一棵树直接拟合原始目标。第二棵树不是拟合原始目标,而是拟合第一棵树的残差误差。第三棵树则拟合在加入第二棵树预测后剩余的残差。如此往复数百轮,每棵新树都在削减残余误差。
“梯度”一词指算法如何决定该拟合什么。在每一步,它会计算当前预测相对于损失函数的梯度。对于平方误差损失的回归,这个梯度就是残差(真实值减预测值)。用于分类时,数学更复杂,但直觉相同:每棵树都被训练为将预测朝着最能降低损失的方向推进。
学习率会在将每棵树加入集成前缩小其贡献。例如学习率为 0.1 时,仅有 10% 的树预测会被加入。这会迫使算法迈出更小的步伐,通常能改善泛化。代价是需要更多的树才能达到同等拟合水平。小学习率 + 多轮树的组合通常优于大学习率 + 少量树。
XGBoost 的不同之处
XGBoost 是众多梯度提升实现之一,同类还有 LightGBM 与 CatBoost。它之所以流行,是因为相较早期实现(如 scikit-learn 的GradientBoostingClassifier)做了不少改进。
主要改进包括:
- 在目标函数中内置 L1 与 L2 正则化,惩罚复杂树、降低过拟合
- 原生处理缺失值:在每次分裂时学习缺失数据的最优归属方向
- 在每轮提升内并行构建树,快于完全顺序的实现
- 列抽样:在每棵树或每次分裂上随机抽样特征(类似 Random Forest 的特征随机化)
这些特性让 XGBoost 相比基础版梯度提升更快、也更抗过拟合。正则化参数让您能直接控制模型复杂度,这在处理噪声大或高维数据时尤其有用。
训练与评估
XGBoost 期望数值化的类别标签而非字符串,因此第一步是对目标变量进行编码:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}")
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))技术支持
Accuracy: 0.9232
           	precision	recall  f1-score   support

 	BARBUNYA   	0.95      0.89  	0.92   	265
   	BOMBAY   	1.00      1.00  	1.00   	104
     	CALI   	0.94      0.94  	0.94   	326
 	DERMASON   	0.90      0.93  	0.91   	709
    	HOROZ   	0.96      0.96  	0.96   	386
    	SEKER   	0.95      0.96  	0.95   	406
     	SIRA   	0.87      0.86  	0.87   	527

 	accuracy                       	0.92 	 2723
    macro avg   	0.94      0.93  	0.93  	2723
 weighted avg   	0.92  	0.92      0.92  	2723技术支持
LabelEncoder会将类名映射为整数(0 到 6),并保存映射以便将预测转换回类名。eval_metric="mlogloss"告诉 XGBoost 在内部评估中使用多分类对数损失。
开箱即用的 XGBoost 达到 92.3% 的准确率,略高于 Random Forest 的 92.0%。各类别的表现模式相似:Bombay 豆被完美分类,而 Sira 豆仍是最难区分的。
XGBoost 提供基于增益(gain)的特征重要性,衡量每个特征在其被使用的所有分裂中平均带来的准确率提升:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()技术支持
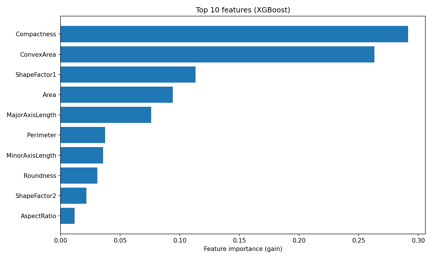
XGBoost 特征重要性
排序与 Random Forest 不同。XGBoost 将 Compactness 与 ConvexArea 排在前列,而 Random Forest 将 ShapeFactor3 排第一。
这种差异反映了两种算法使用特征的方式:Random Forest 关注一个特征在众多独立树中降低不纯度的频率与幅度,而 XGBoost 关注在纠正残差时每个特征带来的精度提升。两种排名都有效,只是反映了特征“有用性”的不同侧面。
值得调参的超参数
相较 Random Forest,XGBoost 的调参旋钮更多,也更灵活。主要参数包括:
learning_rate:对每棵树应用的缩减(默认 0.3)。更低取值需要更多树,但通常泛化更好。max_depth:最大树深(默认 6)。更浅的树可减少过拟合。与 Random Forest 的无限深度相比,XGBoost 的默认更保守。n_estimators:提升轮数。轮数越多,尤其在低学习率下,精细校正空间越大。reg_alpha:叶子权重的 L1 正则(默认 0)。更高取值使权重更稀疏。reg_lambda:叶子权重的 L2 正则(默认 1)。更高取值惩罚较大权重,使预测更平滑。
针对部分参数的网格搜索:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f"Best params: {grid_search_xgb.best_params_}")
 print(f"Best CV accuracy: {grid_search_xgb.best_score_:.4f}")技术支持
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
 Best CV accuracy: 0.9284技术支持
y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}")技术支持
Tuned test accuracy: 0.9251技术支持
最佳配置使用更浅的树(max_depth=4)、更强的正则(reg_lambda=5),以及两倍的提升轮数(n_estimators=200)。这种模式很常见:XGBoost 往往在“更弱的单棵树 + 更多轮数”的组合下表现更好。调参将测试准确率从 92.3% 提升到 92.5%。
想更深入了解 XGBoost 的参数与早停等高级特性,请参阅 DataCamp 的Python 中的 XGBoost 教程。
Random Forest vs XGBoost
在对两种模型都完成训练与调参后,以下是它们在 Dry Beans 数据集上的对比。
性能对比
|
指标
|
Random Forest
|
XGBoost
|
|
准确率(默认)
|
92.0%
|
92.3%
|
|
准确率(调参)
|
92.1%
|
92.5%
|
|
宏平均精确率
|
0.93
|
0.94
|
|
宏平均召回率
|
0.93
|
0.93
|
|
宏平均 F1
|
0.93
|
0.93
|
|
训练时间
|
快
|
中等
|
|
调参工作量
|
低
|
中等
|
从准确率看 XGBoost 略胜一筹,但看宏平均 F1 时差距缩小。两者都达到 0.93,这意味着它们在七个豆类上整体表现相当,而不只是对多数类更好。
按类别的表现也类似:
|
类别
|
Random Forest F1
|
XGBoost F1
|
|
Bombay
|
1.00
|
1.00
|
|
Horoz
|
0.96
|
0.96
|
|
Seker
|
0.95
|
0.95
|
|
Cali
|
0.94
|
0.94
|
|
Barbunya
|
0.92
|
0.92
|
|
Dermason
|
0.91
|
0.91
|
|
Sira
|
0.86
|
0.87
|
两种模型对类别的难易排序一致。Bombay 豆最容易分类(体型最大、形态最明显),Sira 豆最难(其形状与 Dermason 和 Seker 有重叠)。XGBoost 在 Sira 上的 F1 优势只有 1 个百分点。
两者的实际差别不在准确率,而在您愿意投入多少调参精力。Random Forest 几乎不调参就做到了比 XGBoost 低 0.4% 以内的表现;而 XGBoost 需要对学习率、树深与正则做网格搜索才能领先。
何时使用各自算法
|
场景
|
建议
|
|
快速基线
|
Random Forest(默认强、调参少)
|
|
追求最高准确率
|
XGBoost(合理调参后上限更高)
|
|
调参时间有限
|
Random Forest(对超参数不敏感)
|
|
超大数据集
|
XGBoost(内存效率更好,支持 GPU)
|
|
需要可解释性
|
均可(两者都提供特征重要性)
|
|
生产部署
|
均可(都有成熟稳定的库)
|
一个合理的工作流是:先用 Random Forest 建立基线,再在需要进一步提升时尝试 XGBoost。最佳选择取决于您的约束条件,而非某个算法的“放之四海而皆准”的排名。
结语
在本教程中,我展示了 Bagging 与 Boosting 如何将弱模型变强。Bagging 并行训练并平均其错误;Boosting 顺序训练,让后来的模型修正之前的错误。
Random Forest 与 XGBoost 是最常用的实现。在 Dry Beans 数据集上,两者都约为 92% 的准确率。XGBoost 在调参后略胜一筹,但 Random Forest 几乎无需配置就能达到接近水平。真正的取舍在于:Random Forest 维护成本低,而 XGBoost 值得投入额外精力。
当您开始一个新问题时,先拟合 Random Forest。它是一个花几分钟就能建立的可靠基线。如果您需要进一步提升准确率且有时间调参,再切换到 XGBoost。
若想用这些算法进行更多实操练习,推荐 DataCamp 的Machine Learning with Tree-Based Models课程。


单棵决策树易于解释,但容易过拟合。简单的线性模型泛化性好,却难以捕捉复杂模式。每种模型都有其盲点,限制了其在真实数据上的准确性。
集成方法通过将多个模型组合成一个模型来解决这一问题。它们不依赖单一预测器,而是聚合多个模型的预测,使个体错误相互抵消。结果通常比任何单个模型都更准确。
在本教程中,我将讲解核心集成方法之间的差异,并重点介绍两种最流行的集成算法:Random Forest 和 XGBoost。
您将了解它们各自的工作原理,在一个多分类问题上实现二者,并比较其性能。目标是帮助您在实践中理解何时使用各自的方法,以及如何在自己的项目中进行调参。
如果您想进行更多动手练习,建议查看Ensemble Methods in Python 课程。
什么是集成学习?
集成学习会训练多个模型,并将它们的预测组合成单一输出。思想很简单:不同模型会犯不同的错误,因此对许多模型的预测进行平均或投票,往往能抵消个体错误。
集成学习将多个模型的预测合成为一个聚合输出
考虑一个分类任务,您训练了五棵决策树。每棵树也许能正确预测 80% 的样本,但它们不会在同一批样本上同时失败。当您聚合它们的投票时,即使有一两棵树出错,多数投票仍常常是正确的。这是所有集成方法的核心原理。
集成中的模型称为基学习器。它们可以是任何算法,但决策树最常见,因为其训练速度快,并且在给定不同数据子集时天然会产生多样化的预测。
偏差-方差权衡
模型误差主要来自两个方面:偏差和方差。
偏差(Bias)是由于过度简化问题产生的误差。线性模型试图拟合曲线关系时偏差很高,因为无论有多少数据,它都无法表示真实模式。高偏差模型在不同训练集上产生相似预测,但这些预测始终偏离目标。
方差(Variance)是对训练数据过于敏感产生的误差。记忆训练集的深层决策树方差很高,因为它将噪声与信号一并捕捉。若您在稍微不同的样本上重新训练同一算法,会得到截然不同的预测。该模型在训练数据上表现很好,但在新数据上崩溃。
用飞镖盘示意偏差与方差:高偏差表现为稳定但偏离靶心,高方差表现为分散且不稳定
可以把这看作一个稳定性问题。高偏差模型很稳定,但每次都以相同方式出错。高方差模型不稳定,会因所见数据不同而以不同方式出错。
理想模型既稳定又准确,但降低一种误差往往会提升另一种误差。
决策树明显属于高方差阵营。它们使用贪心分裂,这意味着训练数据的微小变化会导致完全不同的树结构。
对同一总体的两个随机样本训练相同的树算法,您可能会得到两棵看起来完全不同的树。这种不稳定性让单棵树不够可靠,但也使其成为构建集成的理想基石。
高方差意味着通过聚合有改进空间。树还具有训练速度快、无需手工特征工程即可处理非线性关系等优势,这就是为什么 Random Forest 和 XGBoost 都使用树,尽管它们从偏差-方差问题的不同方面入手。
集成方法通过组合多个模型来打破这种权衡:
Bagging
Bagging在数据的随机子集上并行训练多个模型,然后对其预测进行平均。这样通过平滑个体模型的“怪癖”来降低方差。直觉是:如果每个模型的错误相对独立,平均就能抵消这些错误。组合的模型越多,最终预测越稳定。这也是 Random Forest 默认使用 100 棵树而非 10 棵的原因。
Boosting
Boosting则是按序训练模型,每个新模型专注于前一批模型的错误。它通过将多个弱学习器“堆叠”成强学习器来降低偏差。
集成学习:Bagging vs Boosting
我们来看看 Bagging 与 Boosting 在实践中的工作方式。
Bagging:并行训练以降低方差
Bagging 是自助聚合(bootstrap aggregating)的缩写。流程分三步:
1. 从原始数据中有放回抽样,创建多个训练集(自助样本)
2. 在每个自助样本上独立训练一个模型
3. 通过平均(回归)或多数投票(分类)来组合预测
自助抽样意味着每个训练集与原始数据集等大,但某些样本会重复出现,而另一些则完全被遗漏。平均来看,每个自助样本包含原始数据约 63% 的不重复样本。剩余约 37% 的样本称为袋外样本,可用于验证。
Bagging 工作流:训练数据被分成自助样本,各自训练独立决策树,再通过多数投票合并
由于每个模型看到的数据切片不同,它们会形成不同的“偏好”。一些会在特征空间的某一区域过拟合,另一些则在另一片区域过拟合。当您聚合它们的预测时,这些个体错误往往会相互抵消。集成的预测比任何单个模型都更稳定。
训练是并行进行的,因为这些模型彼此独立。这使得 Bagging 易于在多核 CPU 上扩展。Random Forest(您稍后将在本教程中实现)是最广泛使用的 Bagging 算法。若想深入理论,请参阅 DataCamp 的机器学习 Bagging 指南。
Boosting:顺序训练以降低偏差
Boosting 的思路不同。它不是独立训练模型,而是一个接一个地训练,每个新模型专注于前面模型做错的样本。
一般流程如下:
1. 在完整训练集上训练一个弱模型
2. 找出该模型表现不佳的样本
3. 训练下一个模型,并对这些困难样本给予更高权重
4. 重复上述步骤,添加模型以纠正剩余错误
5. 将所有模型按加权和组合,表现更好的模型获得更高权重
“弱学习器”指仅略好于随机猜测的模型。决策树桩(只有一次分裂的树)很常见。单个树桩几乎没用,但 Boosting 会堆叠上百个,每个都在削减前一批遗留的误差。最终的集成是由许多微小贡献构成的强学习器。
Boosting 工作流:顺序训练、纠错,并按加权和组合
与 Bagging 不同,Boosting 天生是顺序的。在不了解第 1 到第 46 个模型遇到哪些困难样本之前,您无法训练第 47 个模型。这使得 Boosting 训练更慢,但往往更准,因为每个模型都是为修补集成中的特定弱点而生。
XGBoost(您将在本教程后面实现)是一种梯度提升算法,已成为处理表格数据的首选。我推荐这份Boosting 入门指南,其中更详细地讲解了数学原理。
Bagging 与 Boosting 的对比:前者并行降方差,后者顺序降偏差
其他集成学习方法
Bagging 和 Boosting 是最广泛使用的集成策略,但并非唯一选择。在深入 Random Forest 与 XGBoost 之前,了解其他方法也很有价值。
投票与平均
最简单的模型组合方式是投票。硬投票中,每个模型给出一个预测,得票最多的类别胜出。比如有逻辑回归、支持向量机和决策树三种模型,其中两者预测为 A,一者为 B,则集成输出 A。
软投票更进一步,平均预测概率而不是计数离散投票。对类别 A 给出 90% 置信度的模型,会比给出 51% 置信度的模型对最终决策贡献更大。由于能反映模型的不确定性,这通常优于硬投票。
您也可以分配权重,让更强的模型影响更大。如果逻辑回归在验证数据上稳定优于其他模型,可以给它 2 倍权重,而其他模型为 1 倍。
当组合不同建模思路的模型时,投票效果最佳。线性模型、基于树的模型和近邻模型各有不同盲点。它们的组合预测常常优于任何单个模型,即便没有一个模型特别强。scikit-learn 提供了
VotingClassifier和VotingRegressor以实现这一点。Stacking 与 Blending
Stacking 将集成思想更进一步。它不是简单平均预测,而是训练第二层模型(称为元学习器)来组合这些预测。流程是:训练若干基模型,在验证集上收集它们的预测,然后训练元学习器将这些预测映射到正确标签。元学习器会学会在何种情境下信任哪个基模型。
Stacking 架构:多样基模型的预测输入元学习器,组合成最终输出
Blending 是更简单的变体,使用单个留出集而非交叉验证折。它实现更快,但浪费部分训练数据,且更容易对留出集过拟合。
这两种技术能再挤出一点点准确率提升,但相对增加的复杂度通常只换来 0.1–0.5% 的改进。堆叠集成更难调试、更慢训练,也更难向利益相关方解释。它们在 Kaggle 竞赛中大放异彩(每一位小数都重要,训练时间不受限),但在生产中很少值得付出这类开销。
有趣的是,大多数堆叠集成都以 Random Forest 和 XGBoost 作为基学习器。这两种算法太强了,以至于 Stacking 往往只是更复杂的“平均它们的预测”。
为何本教程聚焦 Bagging 与 Boosting
本教程只讨论 Random Forest(Bagging)和 XGBoost(Boosting),因为它们覆盖了绝大多数真实场景下的表格数据问题。与多层堆叠集成相比,它们实现更简单、调参更容易、维护也更直接。
如果您想更深入了解投票与堆叠,DataCamp 的Ensemble Methods in Python课程覆盖了完整技术谱系。接下来,让我们上手数据集。
为集成分类准备数据
本教程使用UCI 机器学习资料库的 Dry Beans 数据集。研究者 Koklu 和 Ozkan(2020)拍摄了来自七个品种的 13,611 粒干豆,并从每张图像中提取了 16 个几何特征,包括面积、周长、轴长和形状因子。任务是根据这些测量将每粒豆子分类到对应品种。
该数据集很适合本教程,因为它是一个干净的多分类问题,且全部为数值特征。没有缺失值,无需类别编码,也无需文本预处理。您可以把精力全部放在集成方法上。
加载与划分数据
Area
Perimeter
MajorAxisLength
MinorAxisLength
AspectRatio
Eccentricity
ConvexArea
EquivDiameter
Extent
Solidity
Roundness
Compactness
ShapeFactor1
ShapeFactor2
ShapeFactor3
ShapeFactor4
0
28395
610.291
208.178
173.889
1.197
0.550
28715
190.141
0.764
0.989
0.958
0.913
0.007
0.003
0.834
0.999
1
28734
638.018
200.525
182.734
1.097
0.412
29172
191.273
0.784
0.985
0.887
0.954
0.007
0.004
0.910
0.998
2
29380
624.110
212.826
175.931
1.210
0.563
29690
193.411
0.778
0.990
0.948
0.909
0.007
0.003
0.826
0.999
3
30008
645.884
210.558
182.517
1.154
0.499
30724
195.467
0.783
0.977
0.904
0.928
0.007
0.003
0.862
0.994
4
30140
620.134
201.848
190.279
1.061
0.334
30417
195.897
0.773
0.991
0.985
0.971
0.007
0.004
0.942
0.999
各类别的分布较为均衡,其中 Dermason 最多,Bombay 最少。分层抽样划分可在训练集和测试集中保持这些比例:
Python 中的 Random Forest 分类器
数据准备就绪后,是时候训练第一个集成模型了。本节介绍 Random Forest 的底层原理,带您完成训练与评估,并展示如何调参。
Random Forest 的工作原理
Random Forest 将 Bagging 应用于决策树,并加入一个额外“随机特征子集”的机制。每棵树在一个自助样本上训练(上一节已述),但在每次分裂时,算法只考虑随机抽取的一部分特征,而非全部特征。
这种特征随机化可防止树变得过于相似。否则,相同的强预测因子会主导每棵树,而集成就会变成许多几乎相同模型的复制品。
通过强制每次分裂仅在有限特征中做选择,算法生成彼此差异更大的树,从而犯不同的错误。当这些树共同投票时,个体错误往往相互抵消。
对分类问题,scikit-learn 默认在每次分裂时考虑总特征数的平方根。对于拥有 16 个特征的 Dry Beans 数据集,每次分裂仅评估随机选取的 4 个特征。结果是一个去相关的树集成,其泛化能力优于任何单棵树。
训练与评估
这段代码创建了一个包含 100 棵决策树的森林,在自助样本上训练,并通过多数投票生成预测。
random_state参数固定随机种子以保证结果可复现。分类报告按类别分解了性能。Precision(精确率)衡量预测为正的样本中有多少是真正,Recall(召回率)衡量实际为正的样本中有多少被找回,F1 值是二者的调和平均。Bombay 豆被完美分类(可能是因为其形态差异明显),而 Sira 豆最难与其他品种区分。
Random Forest 的一个优势是可解释的特征重要性。算法会跟踪每个特征在所有树中降低不纯度(默认 Gini 指数)的贡献,为您提供哪些变量最重要的度量:
Random Forest 特征重要性
feature_importances_属性返回一个和为 1 的分数数组,值越高表示该特征对分裂决策的贡献越大。ShapeFactor3 和 Compactness 对分类贡献最大,其次是 Perimeter 与 MinorAxisLength 等几何测量。这些形状相关特征捕捉了豆类品种之间的视觉差异,正是原始研究者设计该数据集所要衡量的。值得调参的超参数
Random Forest 有三个主要超参数值得调优:
n_estimators:森林中树的数量。树越多,预测越稳定,但训练更慢。多数数据集在 200 棵以上收益递减。max_depth:每棵树的最大深度。默认值(None)会持续生长,直到叶子纯净或样本少于 2。较低的取值可防止过拟合。max_features:每次分裂考虑的特征数。默认"sqrt"对分类效果好。使用"log2"可提升多样性,但单棵树精度会下降。一个快速的网格搜索:
GridSearchCV会尝试网格中每种参数组合,并通过交叉验证评估。cv=3将训练数据分成 3 折,轮流用 2 折训练、1 折验证。n_jobs=-1会并行利用所有可用 CPU 核心。调参将准确率从 92.0% 提升到 92.1%,改进不大。最佳配置对
max_depth与max_features沿用默认,仅将树数从 100 提到 200。Random Forest 常常“开箱即用”表现良好,这正是其主要魅力之一。想更深入了解 Random Forest 及其参数,请参阅 DataCamp 的Random Forest 分类教程。Python 中的 XGBoost 分类器
XGBoost(Extreme Gradient Boosting)与 Random Forest 走的是不同的准确率之路。Random Forest 通过对独立树的平均来降低方差,而 XGBoost 通过顺序训练树、让每棵新树纠正已有集成的错误来降低偏差。本节介绍梯度提升的工作方式、XGBoost 的独特之处,以及如何在 Dry Beans 数据集上训练与调参。
梯度提升的工作原理
梯度提升一次构建一棵树。第一棵树直接拟合原始目标。第二棵树不是拟合原始目标,而是拟合第一棵树的残差误差。第三棵树则拟合在加入第二棵树预测后剩余的残差。如此往复数百轮,每棵新树都在削减残余误差。
“梯度”一词指算法如何决定该拟合什么。在每一步,它会计算当前预测相对于损失函数的梯度。对于平方误差损失的回归,这个梯度就是残差(真实值减预测值)。用于分类时,数学更复杂,但直觉相同:每棵树都被训练为将预测朝着最能降低损失的方向推进。
学习率会在将每棵树加入集成前缩小其贡献。例如学习率为 0.1 时,仅有 10% 的树预测会被加入。这会迫使算法迈出更小的步伐,通常能改善泛化。代价是需要更多的树才能达到同等拟合水平。小学习率 + 多轮树的组合通常优于大学习率 + 少量树。
XGBoost 的不同之处
XGBoost 是众多梯度提升实现之一,同类还有 LightGBM 与 CatBoost。它之所以流行,是因为相较早期实现(如 scikit-learn 的
GradientBoostingClassifier)做了不少改进。主要改进包括:
这些特性让 XGBoost 相比基础版梯度提升更快、也更抗过拟合。正则化参数让您能直接控制模型复杂度,这在处理噪声大或高维数据时尤其有用。
训练与评估
XGBoost 期望数值化的类别标签而非字符串,因此第一步是对目标变量进行编码:
LabelEncoder会将类名映射为整数(0 到 6),并保存映射以便将预测转换回类名。eval_metric="mlogloss"告诉 XGBoost 在内部评估中使用多分类对数损失。开箱即用的 XGBoost 达到 92.3% 的准确率,略高于 Random Forest 的 92.0%。各类别的表现模式相似:Bombay 豆被完美分类,而 Sira 豆仍是最难区分的。
XGBoost 提供基于增益(gain)的特征重要性,衡量每个特征在其被使用的所有分裂中平均带来的准确率提升:
XGBoost 特征重要性
排序与 Random Forest 不同。XGBoost 将 Compactness 与 ConvexArea 排在前列,而 Random Forest 将 ShapeFactor3 排第一。
这种差异反映了两种算法使用特征的方式:Random Forest 关注一个特征在众多独立树中降低不纯度的频率与幅度,而 XGBoost 关注在纠正残差时每个特征带来的精度提升。两种排名都有效,只是反映了特征“有用性”的不同侧面。
值得调参的超参数
相较 Random Forest,XGBoost 的调参旋钮更多,也更灵活。主要参数包括:
learning_rate:对每棵树应用的缩减(默认 0.3)。更低取值需要更多树,但通常泛化更好。max_depth:最大树深(默认 6)。更浅的树可减少过拟合。与 Random Forest 的无限深度相比,XGBoost 的默认更保守。n_estimators:提升轮数。轮数越多,尤其在低学习率下,精细校正空间越大。reg_alpha:叶子权重的 L1 正则(默认 0)。更高取值使权重更稀疏。reg_lambda:叶子权重的 L2 正则(默认 1)。更高取值惩罚较大权重,使预测更平滑。针对部分参数的网格搜索:
最佳配置使用更浅的树(
max_depth=4)、更强的正则(reg_lambda=5),以及两倍的提升轮数(n_estimators=200)。这种模式很常见:XGBoost 往往在“更弱的单棵树 + 更多轮数”的组合下表现更好。调参将测试准确率从 92.3% 提升到 92.5%。想更深入了解 XGBoost 的参数与早停等高级特性,请参阅 DataCamp 的Python 中的 XGBoost 教程。
Random Forest vs XGBoost
在对两种模型都完成训练与调参后,以下是它们在 Dry Beans 数据集上的对比。
性能对比
指标
Random Forest
XGBoost
准确率(默认)
92.0%
92.3%
准确率(调参)
92.1%
92.5%
宏平均精确率
0.93
0.94
宏平均召回率
0.93
0.93
宏平均 F1
0.93
0.93
训练时间
快
中等
调参工作量
低
中等
从准确率看 XGBoost 略胜一筹,但看宏平均 F1 时差距缩小。两者都达到 0.93,这意味着它们在七个豆类上整体表现相当,而不只是对多数类更好。
按类别的表现也类似:
类别
Random Forest F1
XGBoost F1
Bombay
1.00
1.00
Horoz
0.96
0.96
Seker
0.95
0.95
Cali
0.94
0.94
Barbunya
0.92
0.92
Dermason
0.91
0.91
Sira
0.86
0.87
两种模型对类别的难易排序一致。Bombay 豆最容易分类(体型最大、形态最明显),Sira 豆最难(其形状与 Dermason 和 Seker 有重叠)。XGBoost 在 Sira 上的 F1 优势只有 1 个百分点。
两者的实际差别不在准确率,而在您愿意投入多少调参精力。Random Forest 几乎不调参就做到了比 XGBoost 低 0.4% 以内的表现;而 XGBoost 需要对学习率、树深与正则做网格搜索才能领先。
何时使用各自算法
场景
建议
快速基线
Random Forest(默认强、调参少)
追求最高准确率
XGBoost(合理调参后上限更高)
调参时间有限
Random Forest(对超参数不敏感)
超大数据集
XGBoost(内存效率更好,支持 GPU)
需要可解释性
均可(两者都提供特征重要性)
生产部署
均可(都有成熟稳定的库)
一个合理的工作流是:先用 Random Forest 建立基线,再在需要进一步提升时尝试 XGBoost。最佳选择取决于您的约束条件,而非某个算法的“放之四海而皆准”的排名。
结语
在本教程中,我展示了 Bagging 与 Boosting 如何将弱模型变强。Bagging 并行训练并平均其错误;Boosting 顺序训练,让后来的模型修正之前的错误。
Random Forest 与 XGBoost 是最常用的实现。在 Dry Beans 数据集上,两者都约为 92% 的准确率。XGBoost 在调参后略胜一筹,但 Random Forest 几乎无需配置就能达到接近水平。真正的取舍在于:Random Forest 维护成本低,而 XGBoost 值得投入额外精力。
当您开始一个新问题时,先拟合 Random Forest。它是一个花几分钟就能建立的可靠基线。如果您需要进一步提升准确率且有时间调参,再切换到 XGBoost。
若想用这些算法进行更多实操练习,推荐 DataCamp 的Machine Learning with Tree-Based Models课程。