

कोर्स
Python में Ensemble Methods
4 घंटा
13.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंएक सिंगल डिसीजन ट्री समझने में आसान होता है, लेकिन अक्सर overfit करता है। एक साधारण रैखिक मॉडल अच्छी तरह generalize करता है, पर जटिल पैटर्न पकड़ने में चूक जाता है। हर प्रकार के मॉडल की कुछ सीमाएँ होती हैं, जो वास्तविक दुनिया के डेटा पर उसकी शुद्धता घटा देती हैं।
Ensemble विधियाँ इसे कई मॉडलों को मिलाकर एक एकल मॉडल बनाकर संबोधित करती हैं। एक ही predictor पर निर्भर रहने की बजाय, वे कई मॉडलों की भविष्यवाणियों को एकत्रित करती हैं ताकि व्यक्तिगत त्रुटियाँ आपस में कट जाएँ। नतीजा आमतौर पर किसी एकल मॉडल से अधिक सटीक होता है।
इस ट्यूटोरियल में, मैं आपको मुख्य ensemble विधियों में अंतर सिखाऊँगा और दो सबसे लोकप्रिय एल्गोरिदम पर फोकस करूँगा: Random Forest और XGBoost.
आप सीखेंगे कि ये कैसे काम करते हैं, एक multiclass classification समस्या पर दोनों को लागू करेंगे, और उनके प्रदर्शन की तुलना करेंगे। लक्ष्य है कि आपको यह व्यावहारिक समझ मिले कि कब किस दृष्टिकोण का उपयोग करना है और अपनी परियोजनाओं के लिए इन्हें कैसे ट्यून करना है।
यदि आप और अधिक hands-on अभ्यास चाहते हैं, तो मैं Ensemble Methods in Python कोर्स देखने की सलाह देता हूँ।
Ensemble learning में कई मॉडल ट्रेन किए जाते हैं और उनकी भविष्यवाणियों को मिलाकर एक आउटपुट बनाया जाता है। विचार सरल है: अलग-अलग मॉडल अलग-अलग गलतियाँ करते हैं, इसलिए कई मॉडलों पर औसत या वोटिंग करने से व्यक्तिगत त्रुटियाँ कट जाती हैं।
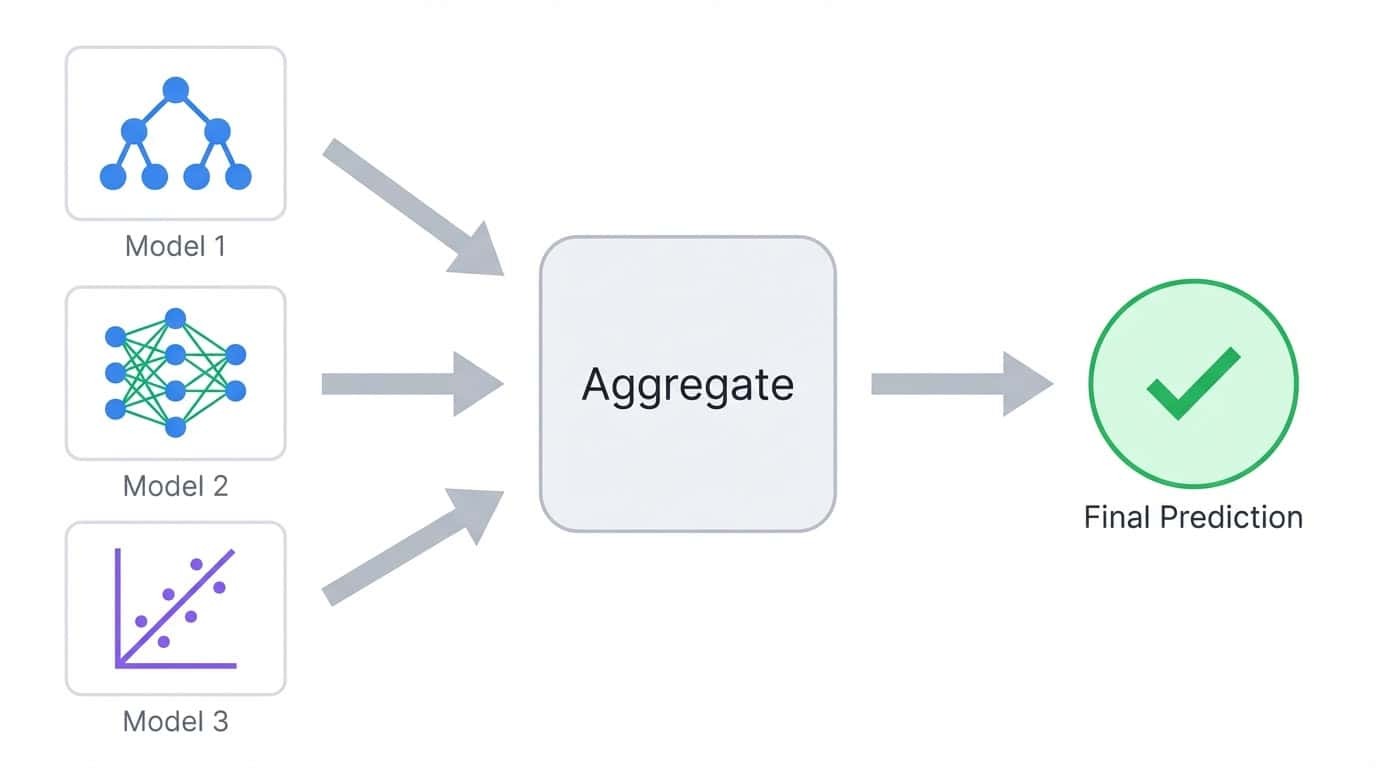
Ensemble learning कई मॉडलों की भविष्यवाणियों को एक संयुक्त आउटपुट में जोड़ता है
एक classification कार्य पर विचार करें जहाँ आप पाँच डिसीजन ट्री ट्रेन करते हैं। हर ट्री लगभग 80% भविष्यवाणियाँ सही कर सकता है, लेकिन वे सब एक ही उदाहरणों पर असफल नहीं होंगे। जब आप उनके वोट एकत्र करते हैं, तो बहुमत अक्सर उसे सही कर देता है, भले ही एक-दो ट्री गलत हों। यही सभी ensemble विधियों का मूल सिद्धांत है।
Ensemble के अंदर के मॉडलों को base learners कहा जाता है। वे कोई भी एल्गोरिदम हो सकते हैं, लेकिन डिसीजन ट्री सबसे आम हैं क्योंकि वे तेज़ी से ट्रेन होते हैं और अलग-अलग डेटा उपसमुच्चयों पर स्वाभाविक रूप से विविध भविष्यवाणियाँ पैदा करते हैं।
मॉडल त्रुटियाँ दो स्रोतों से आती हैं: bias और variance।
Bias समस्या को अत्यधिक सरल बनाने से होने वाली त्रुटि है। एक रैखिक मॉडल जब एक वक्र संबंध को फिट करने की कोशिश करता है तो उसमें उच्च bias होता है क्योंकि वह असली पैटर्न का प्रतिनिधित्व कर ही नहीं सकता, चाहे आप कितना भी डेटा दें। उच्च-bias मॉडल अलग-अलग training सेट पर समान भविष्यवाणियाँ देते हैं, पर वे हमेशा लक्ष्य से चूकते हैं।
Variance प्रशिक्षण डेटा के प्रति अत्यधिक संवेदनशील होने से जुड़ी त्रुटि है। एक गहरा डिसीजन ट्री जो training सेट को याद कर लेता है, उसमें उच्च variance होता है क्योंकि वह सिग्नल के साथ शोर भी पकड़ लेता है। यदि आप उसी ट्री को थोड़ा अलग सैंपल पर दोबारा ट्रेन करें, तो भविष्यवाणियाँ बहुत बदल सकती हैं। मॉडल training डेटा पर अच्छा फिट होता है, पर नए डेटा पर टूट जाता है।
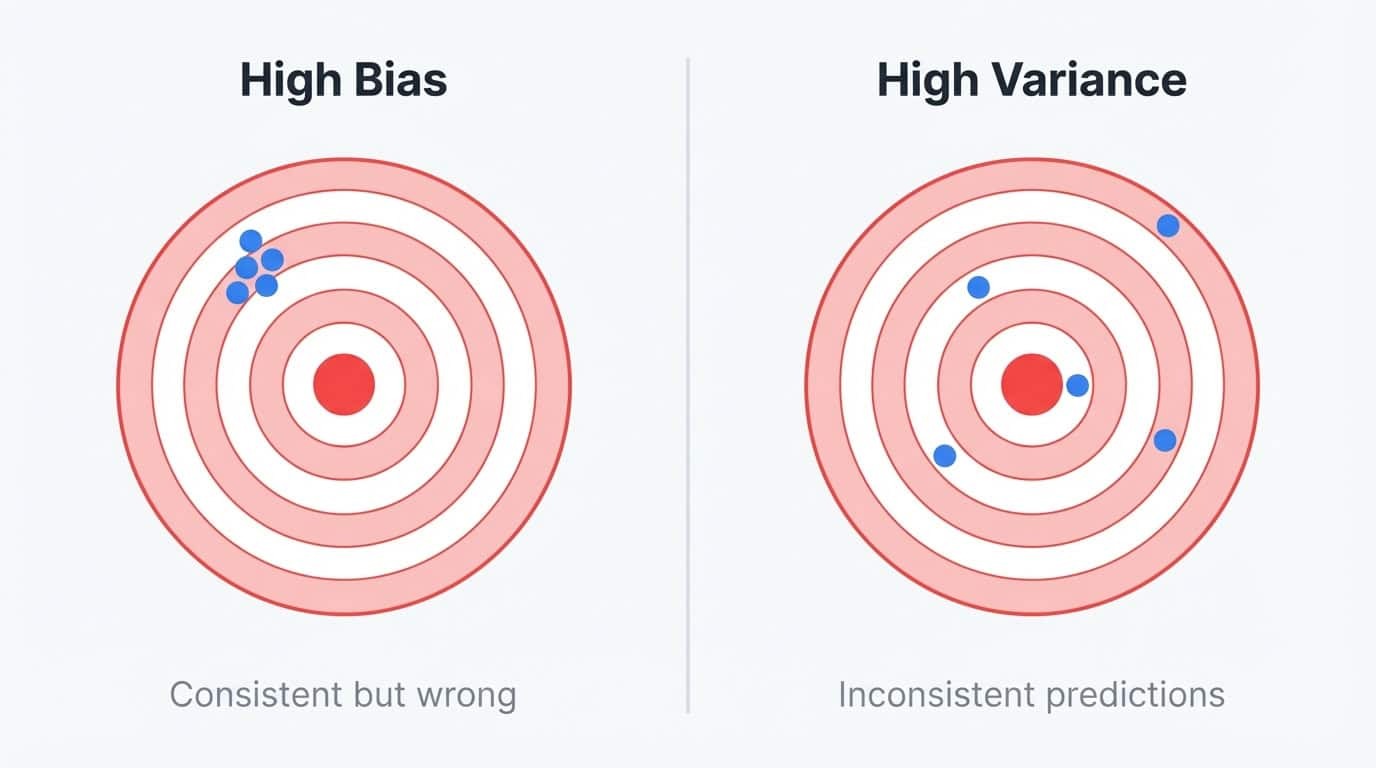
डार्टबोर्ड से bias बनाम variance का चित्रण: उच्च bias में भविष्यवाणियाँ सुसंगत पर लक्ष्य से दूर, उच्च variance में बिखरी और असंगत
आप इसे स्थिरता की समस्या के रूप में सोच सकते हैं। उच्च-bias मॉडल स्थिर होते हैं लेकिन हर बार एक ही तरह से गलत। उच्च-variance मॉडल अस्थिर होते हैं और जो डेटा उन्होंने देखा, उसके अनुसार अलग-अलग तरीकों से गलत होते हैं।
आदर्श मॉडल स्थिर और सटीक दोनों होता है, लेकिन एक प्रकार की त्रुटि को कम करने से अक्सर दूसरी बढ़ जाती है।
डिसीजन ट्री स्पष्ट रूप से high-variance कैंप में आते हैं। वे greedy splitting का उपयोग करते हैं, यानी training डेटा में छोटे परिवर्तन भी बिल्कुल अलग ट्री संरचनाएँ बना सकते हैं।
उसी ट्री एल्गोरिदम को एक ही आबादी से लिए गए दो रैंडम सैंपल पर ट्रेन करें, और आपको दो ऐसे मॉडल मिल सकते हैं जो एक-दूसरे से बिल्कुल अलग दिखते हों। यह अस्थिरता व्यक्तिगत ट्री को अविश्वसनीय बनाती है, लेकिन उन्हें ensembles के लिए आदर्श बिल्डिंग ब्लॉक्स भी बनाती है।
उच्च variance का मतलब है कि एकत्रीकरण के जरिए सुधार की गुंजाइश है। ट्री तेज़ी से ट्रेन होते हैं और बिना मैनुअल फीचर इंजीनियरिंग के non-linear संबंध संभालते हैं, यही वजह है कि Random Forest और XGBoost दोनों, bias-variance समस्या के अलग हिस्सों से निपटते हुए भी, ट्री का उपयोग करते हैं।
Ensemble विधियाँ कई मॉडलों को मिलाकर इस trade-off को तोड़ती हैं:
Bagging में कई मॉडल डेटा के रैंडम उपसमुच्चयों पर समानांतर रूप से ट्रेन होते हैं, फिर उनकी भविष्यवाणियों का औसत लिया जाता है। यह व्यक्तिगत मॉडलों की विचित्रताओं को स्मूथ करके variance घटाता है। सहज समझ यह है: यदि हर मॉडल कुछ हद तक स्वतंत्र त्रुटियाँ करता है, तो औसत लेने से वे त्रुटियाँ कट जाती हैं। जितने अधिक मॉडल आप जोड़ेंगे, अंतिम भविष्यवाणी उतनी ही स्थिर होगी। यही कारण है कि Random Forest 10 की बजाय डिफ़ॉल्ट रूप से 100 ट्री उपयोग करता है।
Boosting में मॉडल क्रमशः ट्रेन होते हैं, जहाँ हर नया मॉडल पिछले मॉडलों की गलतियों पर ध्यान देता है। यह कई कमजोर मॉडलों से मिलकर एक मजबूत लर्नर बनाकर bias घटाता है।
आइए देखें कि व्यवहार में bagging और boosting कैसे काम करते हैं।
Bagging का मतलब है bootstrap aggregating। प्रक्रिया के तीन चरण हैं:
1. मूल डेटा से replacement के साथ सैंपलिंग करके कई training सेट बनाएँ (bootstrap samples)
2. हर bootstrap sample पर एक मॉडल स्वतंत्र रूप से ट्रेन करें
3. भविष्यवाणियों को औसत (regression) या बहुमत वोट (classification) से संयोजित करें
Bootstrap सैंपलिंग का मतलब है कि हर training सेट मूल जितना बड़ा होता है, लेकिन कुछ उदाहरण कई बार आते हैं जबकि कुछ बिल्कुल नहीं आते। औसतन, हर bootstrap sample में मूल डेटा के लगभग 63% अद्वितीय उदाहरण होते हैं। बाकी 37% को out-of-bag samples कहते हैं और उन्हें validation के लिए उपयोग किया जा सकता है।
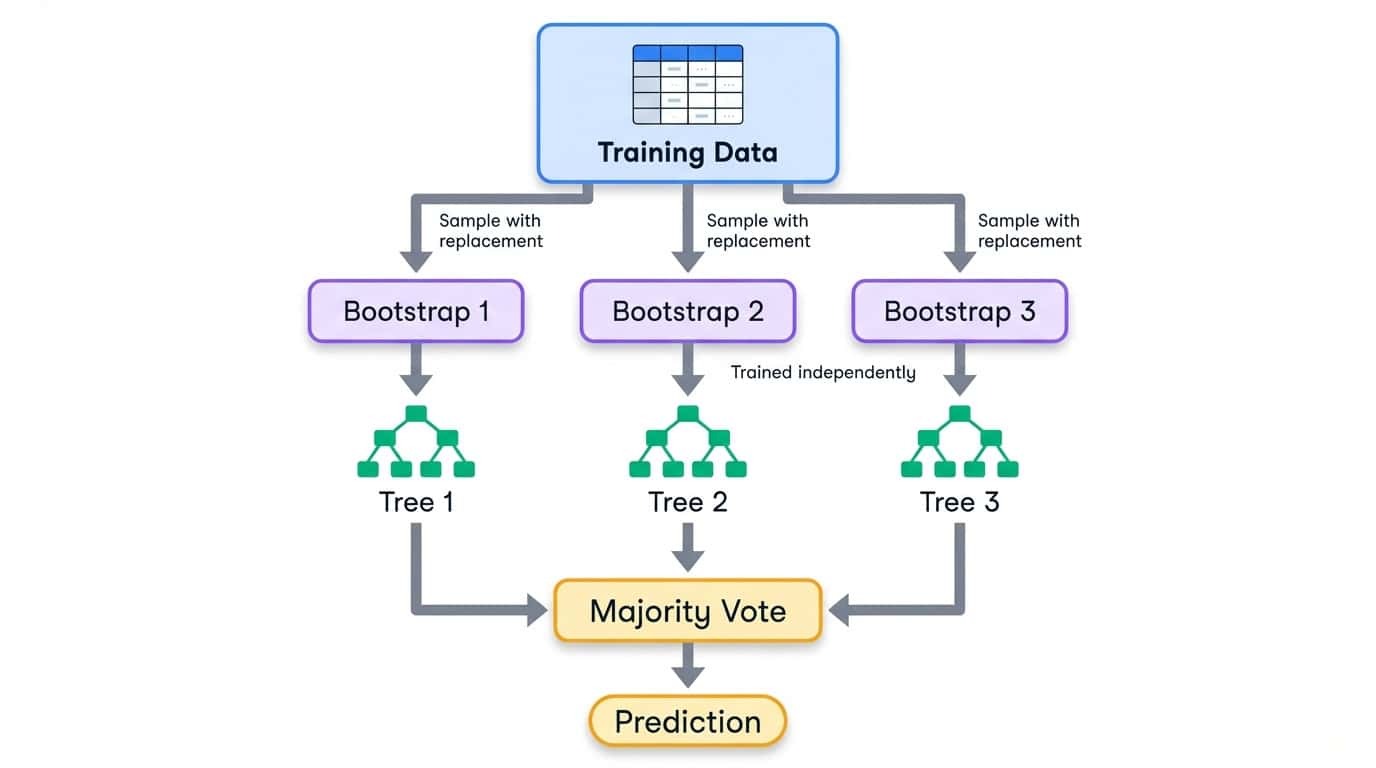
Bagging वर्कफ़्लो: training डेटा को bootstrap samples में बाँटना, हर एक से स्वतंत्र डिसीजन ट्री ट्रेन करना, फिर बहुमत वोट से संयोजन
क्योंकि हर मॉडल डेटा का अलग हिस्सा देखता है, वे अलग-अलग विचित्रताएँ विकसित करते हैं। कुछ फीचर स्पेस के एक क्षेत्र में overfit करते हैं, तो कुछ दूसरे क्षेत्र में। जब आप उनकी भविष्यवाणियाँ मिलाते हैं, तो ये व्यक्तिगत त्रुटियाँ धुल जाती हैं। Ensemble की भविष्यवाणी किसी भी एकल मॉडल से अधिक स्थिर होती है।
प्रशिक्षण समानांतर में होता है क्योंकि मॉडल एक-दूसरे पर निर्भर नहीं होते। इससे bagging को कई CPU कोर पर स्केल करना सरल हो जाता है। Random Forest, जिसे आप आगे इस ट्यूटोरियल में लागू करेंगे, सबसे व्यापक रूप से प्रयुक्त bagging एल्गोरिदम है। सिद्धांत पर गहराई से देखने के लिए DataCamp का मशीन लर्निंग में bagging गाइड देखें।
Boosting अलग रास्ता अपनाता है। स्वतंत्र रूप से मॉडल ट्रेन करने के बजाय, वह उन्हें एक के बाद एक ट्रेन करता है, और हर नया मॉडल उन उदाहरणों पर ध्यान देता है जिन्हें पहले मॉडलों ने गलत किया।
सामान्य प्रक्रिया इस प्रकार दिखती है:
1. पूरे training सेट पर एक कमजोर मॉडल ट्रेन करें
2. वे उदाहरण पहचानें जिन पर मॉडल की भविष्यवाणी खराब रही
3. अगला मॉडल उन कठिन उदाहरणों पर अतिरिक्त जोर के साथ ट्रेन करें
4. दोहराएँ, शेष त्रुटियों को ठीक करने वाले और मॉडल जोड़ते जाएँ
5. सभी मॉडलों को weighted sum में मिलाएँ, जहाँ बेहतर प्रदर्शन करने वालों को अधिक वजन मिले
"Weak learner" का अर्थ है ऐसा मॉडल जो रैंडम गेसिंग से थोड़ा बेहतर करता है। Decision stumps (एकल split वाले ट्री) आम पसंद हैं। अकेले में, stump लगभग बेकार है। लेकिन boosting सैकड़ों stumps को जोड़ता है, जिनमें से हर एक पिछले मॉडलों की बची त्रुटियों को थोड़ा-थोड़ा कम करता है। अंतिम ensemble कई कमजोर योगदानों से बना एक मजबूत लर्नर होता है।
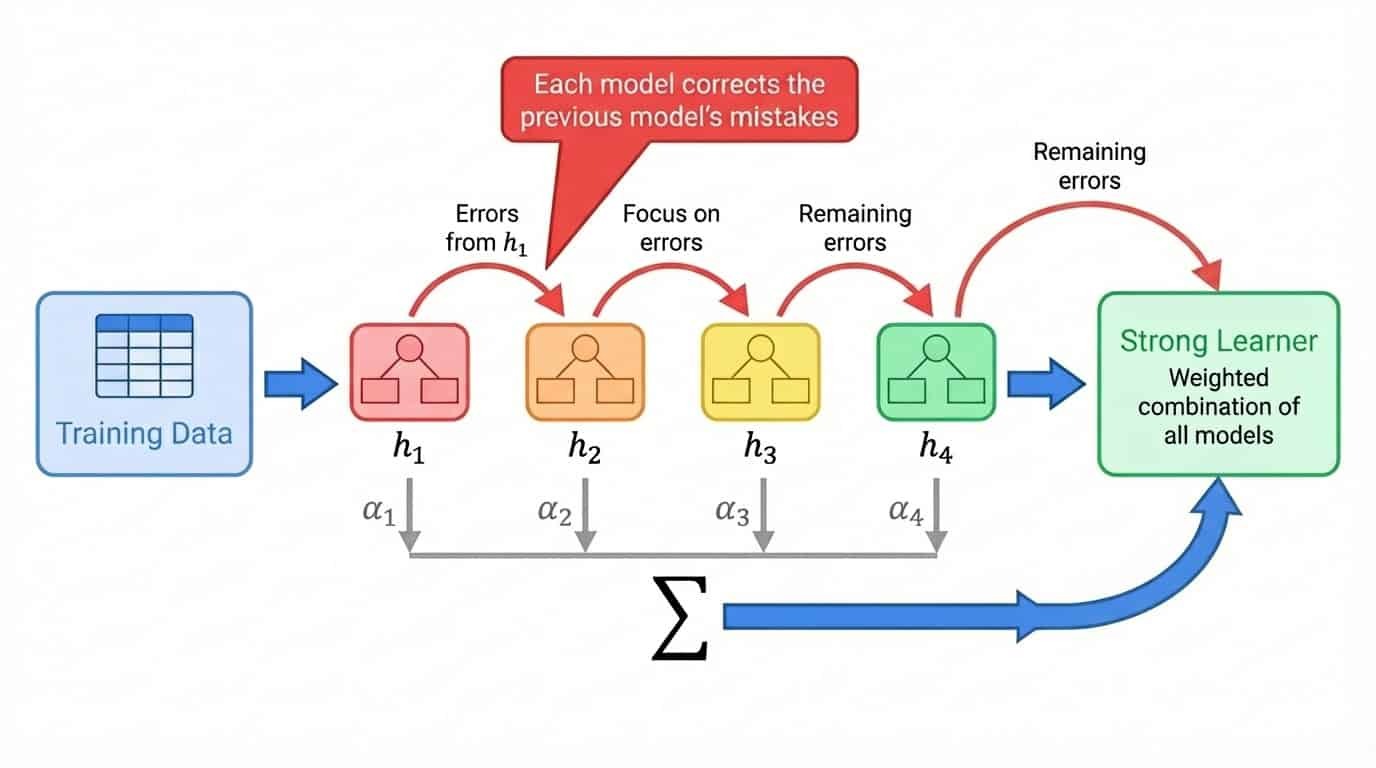
Boosting वर्कफ़्लो: क्रमिक प्रशिक्षण जहाँ हर मॉडल पिछले मॉडल की गलतियाँ सुधारता है, और अंत में weighted sum से संयुक्त किया जाता है
Bagging के विपरीत, boosting स्वभावतः क्रमिक है। जब तक आपको पता न हो कि मॉडल 1 से 46 तक किन उदाहरणों पर संघर्ष कर रहे थे, आप मॉडल 47 को ट्रेन नहीं कर सकते। इससे boosting ट्रेन करने में धीमा होता है, लेकिन अक्सर अधिक सटीकता देता है क्योंकि हर मॉडल ensemble की विशिष्ट कमजोरियों को ठीक करने के लिए बनाया जाता है।
XGBoost, जिसे आप आगे लागू करेंगे, एक gradient boosting एल्गोरिदम है जो tabular डेटा के लिए पसंदीदा विकल्प बन गया है। मैं boosting की परिचयात्मक गाइड की सलाह देता हूँ, जहाँ गणित को विस्तार से कवर किया गया है।
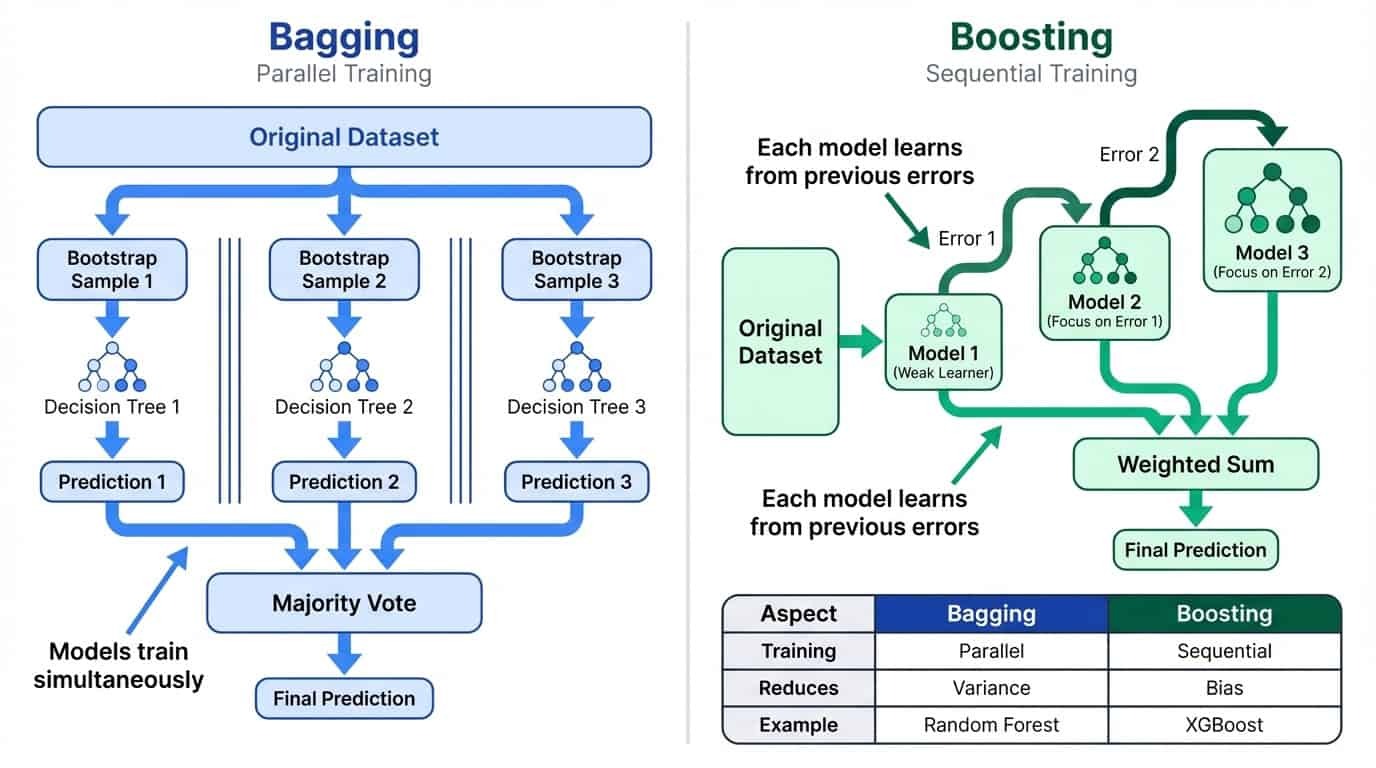
Bagging और boosting का साथ-साथ तुलना: bagging variance घटाने के लिए समानांतर प्रशिक्षण करता है, boosting bias घटाने के लिए क्रमिक प्रशिक्षण करता है
Bagging और boosting सबसे अधिक प्रयुक्त रणनीतियाँ हैं, लेकिन विकल्प यहीं तक सीमित नहीं हैं। Random Forest और XGBoost में उतरने से पहले, यह जानना उपयोगी है कि और क्या मौजूद है।
मॉडलों को मिलाने का सबसे सरल तरीका है उन्हें वोट करने देना। Hard voting में, हर मॉडल एक भविष्यवाणी करता है, और सबसे अधिक वोट वाली क्लास जीतती है। यदि आपके पास logistic regression, support vector machine और decision tree हैं, और उनमें से दो क्लास A बताते हैं जबकि एक क्लास B, तो ensemble का आउटपुट क्लास A होगा।
Soft voting इससे आगे बढ़कर डिस्क्रीट वोट गिनने के बजाय अनुमानित प्रायिकताओं का औसत लेता है। जो मॉडल 90% आत्मविश्वास से क्लास A बताता है, वह अंतिम निर्णय में 51% आत्मविश्वास वाले मॉडल से अधिक योगदान देता है। यह आमतौर पर hard voting से बेहतर होता है क्योंकि यह हर मॉडल की निश्चितता को भी कैप्चर करता है।
आप मजबूत मॉडलों को अधिक वज़न देने के लिए weights भी असाइन कर सकते हैं। यदि आपका logistic regression वैलिडेशन डेटा पर अन्य मॉडलों से लगातार बेहतर है, तो आप उसकी भविष्यवाणियों का weight 2x रख सकते हैं जबकि दूसरों का 1x।
Voting तब सबसे अच्छा काम करता है जब आप समस्या को अलग-अलग ढंग से देखने वाले मॉडलों को मिलाते हैं। एक रैखिक मॉडल, एक ट्री-आधारित मॉडल, और एक nearest-neighbor मॉडल, प्रत्येक के अलग blind spots होते हैं। उनका संयुक्त अनुमान अक्सर किसी भी व्यक्तिगत मॉडल से बेहतर होता है, भले ही कोई एकल मॉडल बहुत मजबूत न हो। scikit-learn इसके लिए VotingClassifier और VotingRegressor उपलब्ध कराता है।
Stacking ensemble विचार को एक स्तर और गहरा ले जाता है। औसत लेने के बजाय, आप एक दूसरा मॉडल (meta-learner) ट्रेन करते हैं जो उन्हें संयोजित करता है। प्रक्रिया ऐसे काम करती है: कई base मॉडल ट्रेन करें, वैलिडेशन सेट पर उनकी भविष्यवाणियाँ इकट्ठा करें, फिर meta-learner को उन भविष्यवाणियों से सही लेबल तक मैप करना सिखाएँ। Meta-learner सीखता है कि किस परिस्थिति में किस base मॉडल पर भरोसा करना है।
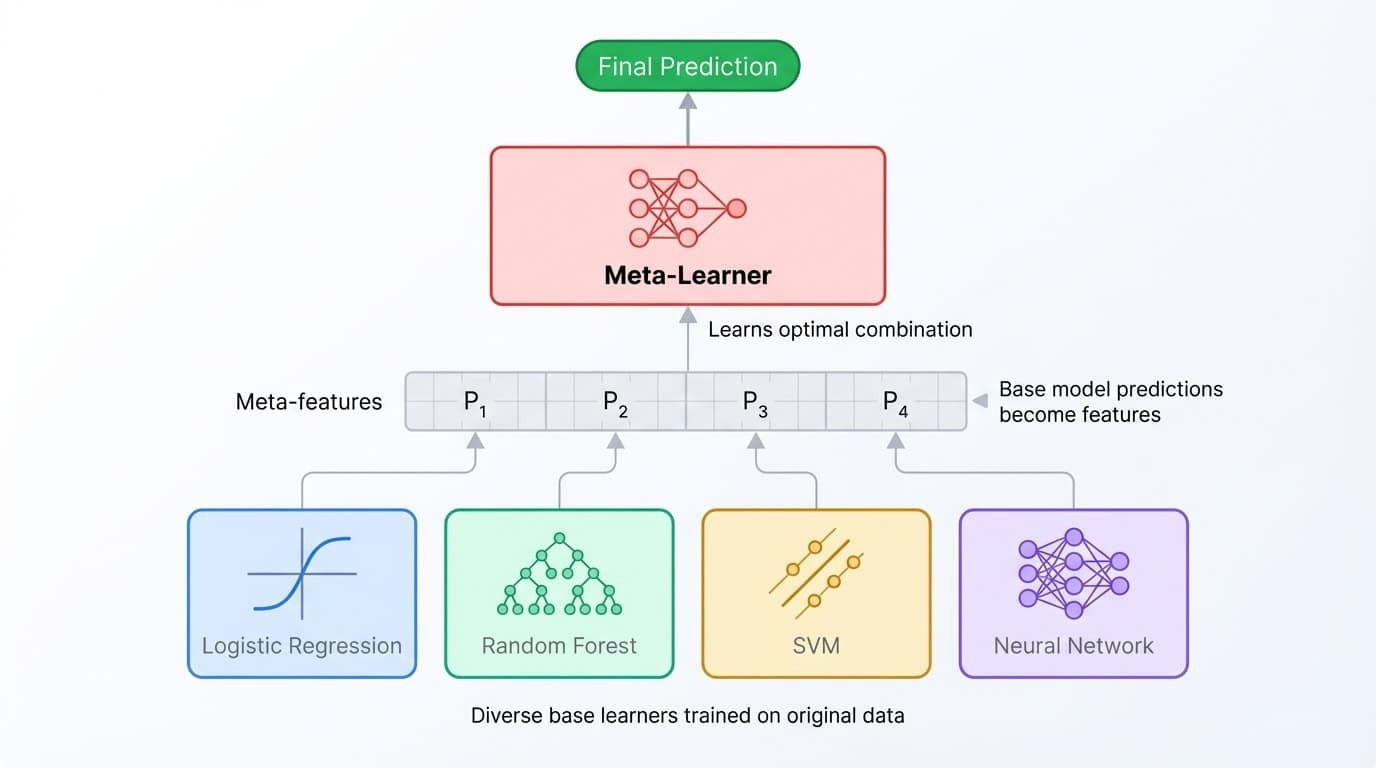
Stacking आर्किटेक्चर: विभिन्न base मॉडल की भविष्यवाणियाँ एक meta-learner को दी जाती हैं, जो उन्हें अंतिम आउटपुट के लिए संयोजित करता है
Blending एक सरल प्रकार है जो cross-validation folds की बजाय एक single holdout सेट उपयोग करता है। इसे लागू करना तेज़ है, लेकिन यह कुछ training डेटा बर्बाद करता है और holdout सेट पर overfitting की आशंका बढ़ा सकता है।
दोनों तकनीकें अतिरिक्त शुद्धता निकाल सकती हैं, लेकिन जटिलता की तुलना में लाभ अक्सर छोटे होते हैं (0.1–0.5% सुधार)। Stacked ensembles को debug करना कठिन, ट्रेन करना धीमा, और stakeholders को समझाना मुश्किल होता है। वे Kaggle प्रतियोगिताओं में चमकते हैं जहाँ हर दशमलव महत्वपूर्ण होता है और training समय असीमित, पर production में अक्सर यह ओवरहेड उचित नहीं होता।
दिलचस्प बात यह है कि अधिकांश stacked ensembles वैसे भी base learners के रूप में Random Forest और XGBoost का उपयोग करते हैं। ये दोनों एल्गोरिदम इतने मजबूत हैं कि stacking अक्सर उनकी भविष्यवाणियों का औसत लेने का विस्तृत तरीका भर रह जाता है।
यह ट्यूटोरियल Random Forest (bagging) और XGBoost (boosting) पर टिका है क्योंकि वे वास्तविक दुनिया के अधिकांश tabular डेटा समस्याओं को संभालते हैं। ये लागू करने में सरल, ट्यून करने में आसान, और multi-level stacked ensembles की तुलना में बनाए रखने में अधिक सीधी-सादी हैं।
यदि आप voting और stacking में गहराई तक जाना चाहते हैं, तो DataCamp का Ensemble Methods in Python कोर्स पूरी रेंज कवर करता है। अभी के लिए, आइए डेटासेट के साथ hands-on हों।
यह ट्यूटोरियल UCI Machine Learning Repository के Dry Beans डेटासेट का उपयोग करता है। शोधकर्ताओं Koklu और Ozkan (2020) ने सात किस्मों के 13,611 सूखे बीन्स की तस्वीरें लीं और हर छवि से 16 ज्यामितीय फीचर्स निकाले, जिनमें area, perimeter, axis lengths, और shape factors शामिल हैं। कार्य है इन मापों के आधार पर हर बीन को उसकी किस्म के अनुसार वर्गीकृत करना।
यह डेटासेट इस ट्यूटोरियल के लिए उपयुक्त है क्योंकि यह सभी संख्यात्मक फीचर्स वाला एक साफ-सुथरा multiclass समस्या है। न missing values, न categorical encoding, न text preprocessing। आप पूरी तरह ensemble विधियों पर ध्यान दे सकते हैं।
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f"Features shape: {X.shape}")
 print(f"Target classes: {pd.Series(y).nunique()}")
Features shape: (13611, 16)
Target classes: 7X.head()|
Area |
Perimeter |
MajorAxisLength |
MinorAxisLength |
AspectRatio |
Eccentricity |
ConvexArea |
EquivDiameter |
Extent |
Solidity |
Roundness |
Compactness |
ShapeFactor1 |
ShapeFactor2 |
ShapeFactor3 |
|
28395 |
610.291 |
208.178 |
173.889 |
1.197 |
0.550 |
28715 |
190.141 |
0.764 |
0.989 |
0.958 |
0.913 |
0.007 |
0.003 |
0.834 |
|
28734 |
638.018 |
200.525 |
182.734 |
1.097 |
0.412 |
29172 |
191.273 |
0.784 |
0.985 |
0.887 |
0.954 |
0.007 |
0.004 |
0.910 |
|
29380 |
624.110 |
212.826 |
175.931 |
1.210 |
0.563 |
29690 |
193.411 |
0.778 |
0.990 |
0.948 |
0.909 |
0.007 |
0.003 |
0.826 |
|
30008 |
645.884 |
210.558 |
182.517 |
1.154 |
0.499 |
30724 |
195.467 |
0.783 |
0.977 |
0.904 |
0.928 |
0.007 |
0.003 |
0.862 |
|
30140 |
620.134 |
201.848 |
190.279 |
1.061 |
0.334 |
30417 |
195.897 |
0.773 |
0.991 |
0.985 |
0.971 |
0.007 |
0.004 |
0.942 |
pd.Series(y).value_counts()DERMASON 3546
SIRA 2636
SEKER 2027
HOROZ 1928
CALI 1630
BARBUNYA 1322
BOMBAY 522क्लासेस उचित रूप से संतुलित हैं, जहाँ Dermason सबसे आम है और Bombay सबसे कम। एक stratified split इन अनुपातों को training और test सेट दोनों में बनाए रखता है:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f"Training set: {X_train.shape[0]} samples")
 print(f"Test set: {X_test.shape[0]} samples")
Training set: 10888 samples
Test set: 2723 samplesडेटा तैयार होने के बाद, अब पहला ensemble मॉडल ट्रेन करने का समय है। इस खंड में Random Forest के अंदरूनी कामकाज, प्रशिक्षण और मूल्यांकन की रूपरेखा, और इसके हाइपरपैरामीटर्स को ट्यून करने का तरीका शामिल है।
Random Forest डिसीजन ट्री पर bagging लागू करता है, साथ में एक अतिरिक्त मोड़। हर ट्री डेटा के bootstrap sample पर ट्रेन होता है (जैसा कि पिछले भाग में कवर किया गया), लेकिन हर split पर एल्गोरिदम सभी फीचर्स की बजाय केवल फीचर्स के एक रैंडम उपसमुच्चय पर विचार करता है।
यह feature randomization ट्री को बहुत समान होने से रोकता है। इसके बिना, वही मजबूत predictors हर ट्री पर हावी हो जाते, और ensemble लगभग एक जैसे मॉडलों की कई प्रतियों जैसा हो जाता।
हर split को सीमित फीचर सेट में से चुनने को मजबूर करके, एल्गोरिदम विविध ट्री बनाता है जो अलग-अलग गलतियाँ करते हैं। जब ये ट्री साथ में वोट करते हैं, तो उनकी व्यक्तिगत गलतियाँ कट जाती हैं।
Classification के लिए, scikit-learn डिफ़ॉल्ट रूप से हर split पर कुल फीचर्स के वर्गमूल पर विचार करता है। Dry Beans डेटासेट में 16 फीचर्स हैं, इसलिए हर split केवल 4 रैंडम फीचर्स का मूल्यांकन करता है। नतीजा है decorrelated ट्री का ensemble, जो किसी भी एकल ट्री से बेहतर generalize करता है।
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}")
 print(classification_report(y_test, y_pred_rf))
Accuracy: 0.9199
precision recall f1-score support
BARBUNYA 0.94 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.92 0.91 709
HOROZ 0.96 0.95 0.96 386
SEKER 0.94 0.96 0.95 406
SIRA 0.86 0.85 0.86 527
accuracy 0.92 2723
macro avg 0.93 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723यह कोड 100 डिसीजन ट्री का एक फॉरेस्ट बनाता है, उन्हें bootstrap samples पर ट्रेन करता है, और बहुमत वोट से भविष्यवाणियाँ जनरेट करता है। random_state पैरामीटर रैंडम सीड फिक्स करता है ताकि परिणाम पुनरुत्पाद्य हों।
Classification रिपोर्ट प्रति-क्लास प्रदर्शन बताती है। Precision बताता है कि अनुमानित positives में से कितने सही थे, recall बताता है कि वास्तविक positives में से कितने पकड़े गए, और F1-score दोनों का हार्मोनिक माध्य है। Bombay बीन्स पूरी तरह classifiy हुए (संभवतः क्योंकि वे भौतिक रूप से अलग हैं), जबकि Sira बीन्स अन्य किस्मों से अलग करना सबसे कठिन रहे।
Random Forest का एक लाभ व्याख्यात्मक feature importances हैं। एल्गोरिदम सभी ट्री में हर फीचर द्वारा impurity (डिफ़ॉल्ट रूप से Gini इंडेक्स) को कितना घटाया गया, इसका ट्रैक रखता है, जिससे आपको यह पता चलता है कि कौन-से वेरिएबल सबसे अधिक महत्वपूर्ण हैं:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()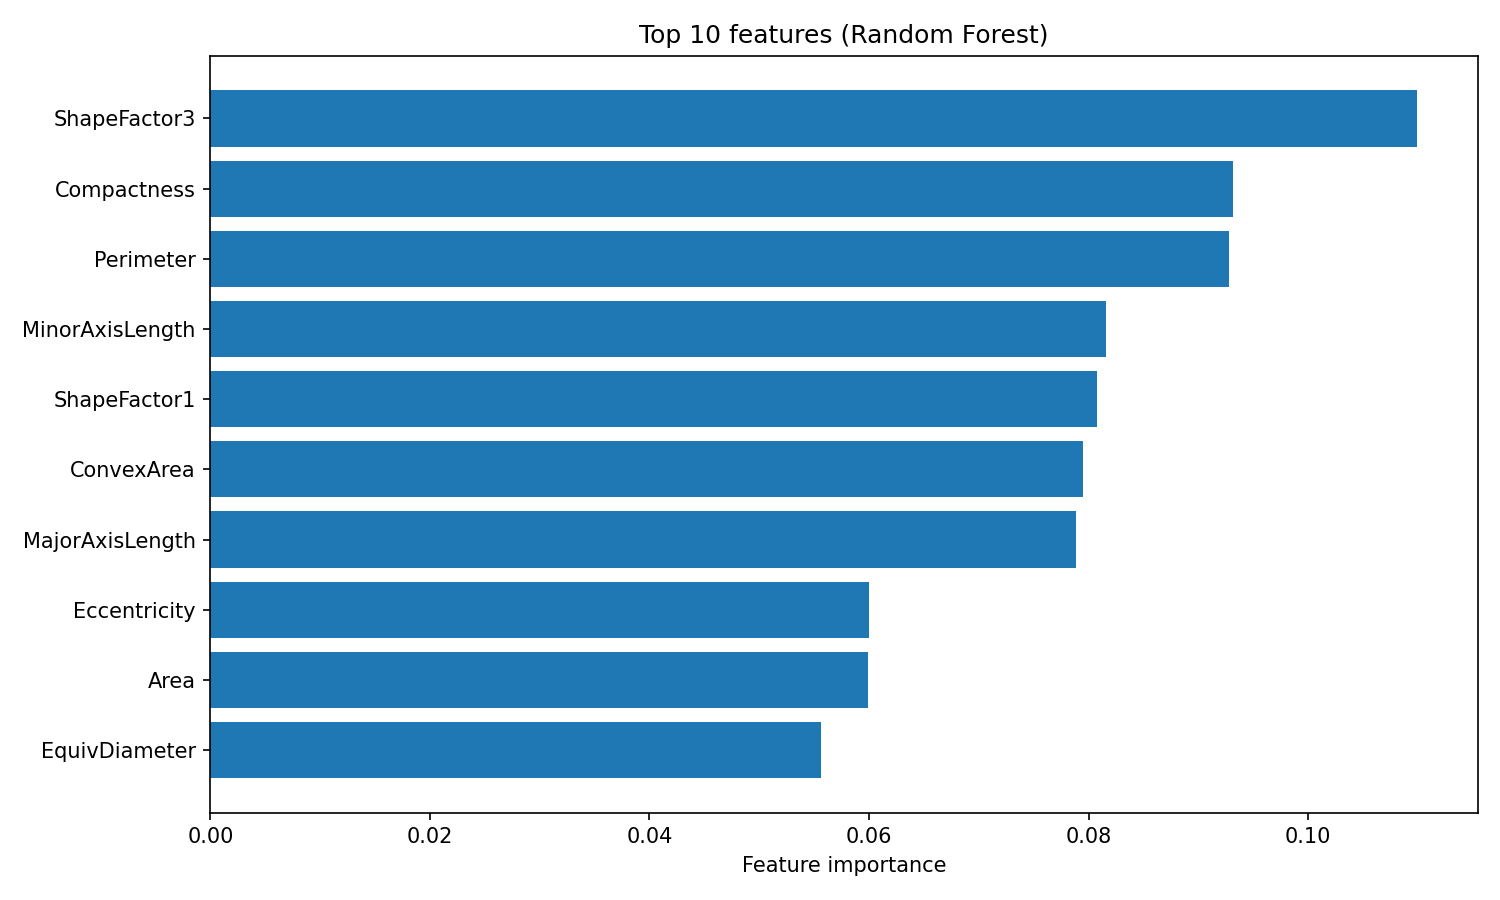
Random Forest फीचर इम्पॉर्टेंस
feature_importances_ एट्रिब्यूट 1 तक योग करने वाले स्कोरों की एक array लौटाता है, जहाँ बड़े मान उन फीचर्स को दर्शाते हैं जिन्होंने splitting निर्णयों में अधिक योगदान दिया। ShapeFactor3 और Compactness वर्गीकरण में सबसे अधिक योगदान देते हैं, इसके बाद Perimeter और MinorAxisLength जैसे ज्यामितीय माप आते हैं। ये shape-आधारित फीचर्स बीन किस्मों के दृश्य अंतर को कैप्चर करते हैं, जिन्हें मापने के लिए मूल शोधकर्ताओं ने डेटासेट डिज़ाइन किया था।
Random Forest में तीन मुख्य हाइपरपैरामीटर्स हैं जिनका ट्यून करना उपयोगी है:
n_estimators: फॉरेस्ट में ट्री की संख्या। अधिक ट्री अधिक स्थिर भविष्यवाणियाँ देते हैं, पर ट्रेनिंग समय बढ़ाते हैं। अधिकांश डेटासेट पर 200 ट्री के बाद रिटर्न कम हो जाते हैं।max_depth: हर ट्री की अधिकतम गहराई। डिफ़ॉल्ट (None) ट्री को तब तक बढ़ाता है जब तक पत्तियाँ शुद्ध न हो जाएँ या उनमें 2 से कम नमूने न रह जाएँ। कम मान overfitting रोक सकते हैं।max_features: हर split पर विचार किए जाने वाले फीचर्स की संख्या। डिफ़ॉल्ट "sqrt" classification के लिए अच्छा काम करता है। "log2" उपयोग करने से विविधता बढ़ती है, लेकिन व्यक्तिगत ट्री की शुद्धता घट सकती है।इन पैरामीटर्स पर एक त्वरित grid search:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f"Best params: {grid_search.best_params_}")
 print(f"Best CV accuracy: {grid_search.best_score_:.4f}")
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
Best CV accuracy: 0.9244GridSearchCV ग्रिड में दिए गए पैरामीटर्स के हर संयोजन को आजमाता है और cross-validation से हर एक का मूल्यांकन करता है। cv=3 आर्गुमेंट training डेटा को 3 folds में बाँटता है, 2 पर ट्रेन और 1 पर वैलिडेशन करता है, और सभी संयोजनों से घुमाता है। n_jobs=-1 फ़्लैग खोज को सभी उपलब्ध CPU कोर पर समानांतर करता है।
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}")
Tuned test accuracy: 0.9214ट्यूनिंग से शुद्धता 92.0% से 92.1% पर पहुँचती है, जो मामूली सुधार है। सर्वोत्तम कॉन्फ़िगरेशन max_depth और max_features के लिए डिफ़ॉल्ट्स रखता है, और 100 की जगह 200 ट्री उपयोग करता है। Random Forest अक्सर बॉक्स से बाहर ही बढ़िया प्रदर्शन करता है, जो इसकी मुख्य खूबियों में से एक है। Random Forest और उसके पैरामीटर्स पर गहराई से देखने के लिए DataCamp का Random Forest classification ट्यूटोरियल देखें।
XGBoost (Extreme Gradient Boosting) Random Forest से अलग रास्ते से सटीकता पाता है। जहाँ Random Forest स्वतंत्र ट्री का औसत लेकर variance घटाता है, वहीं XGBoost क्रमशः ट्री ट्रेन कर bias घटाता है, ताकि हर नया ट्री अब तक के ensemble की गलतियाँ सुधारे। इस खंड में gradient boosting कैसे काम करता है, XGBoost में क्या विशेष है, और Dry Beans डेटासेट पर इसे कैसे ट्रेन व ट्यून करें, शामिल है।
Gradient boosting एक बार में एक ट्री जोड़कर ensemble बनाता है। पहला ट्री मूल टार्गेट पर भविष्यवाणियाँ करता है। दूसरा ट्री मूल टार्गेट पर नहीं, बल्कि पहले ट्री की residual errors पर ट्रेन होता है। तीसरा ट्री दूसरे ट्री की भविष्यवाणियाँ जोड़ने के बाद बची residuals को फिट करता है। यह सैकड़ों राउंड तक चलता है, हर नया ट्री शेष त्रुटि को थोड़ा-थोड़ा घटाता है।
"Gradient" शब्द बताता है कि एल्गोरिदम क्या फिट करे, यह कैसे तय करता है। हर चरण पर, यह वर्तमान भविष्यवाणियों के सापेक्ष loss फ़ंक्शन का gradient निकालता है। squared error loss वाली regression में यह gradient बस residual (actual माइनस predicted) होता है। Classification में गणित अधिक जटिल है, पर अंतर्ज्ञान वही है: हर ट्री भविष्यवाणियों को उस दिशा में ले जाता है जहाँ loss सबसे अधिक घटता है।
एक learning rate पैरामीटर हर ट्री के योगदान को ensemble में जोड़ने से पहले छोटा करता है। उदाहरण के लिए 0.1 के learning rate के साथ, हर ट्री की भविष्यवाणी का केवल 10% जोड़ा जाता है। यह एल्गोरिदम को छोटे-छोटे कदम लेने को बाध्य करता है और सामान्यतः generalization सुधारता है। समझौता यह है कि उसी स्तर के फिट तक पहुँचने के लिए अधिक ट्री चाहिए। छोटा learning rate + अधिक ट्री, आमतौर पर बड़े learning rate + कम ट्री से बेहतर परिणाम देता है।
XGBoost gradient boosting के कई implementations में से एक है, LightGBM और CatBoost के साथ। यह लोकप्रिय इसलिए हुआ क्योंकि इसने scikit-learn के GradientBoostingClassifier जैसे पहले के implementations पर कई सुधार जोड़े।
मुख्य जोड़ हैं:
ये विशेषताएँ XGBoost को साधारण gradient boosting की तुलना में तेज़ और overfitting के प्रति अधिक प्रतिरोधी बनाती हैं। Regularization पैरामीटर्स आपको मॉडल जटिलता पर सीधा नियंत्रण देते हैं, जो शोरयुक्त या उच्च-आयामी डेटा के साथ उपयोगी है।
XGBoost को string के बजाय संख्यात्मक क्लास लेबल चाहिए होते हैं, इसलिए पहला कदम है टार्गेट वैरिएबल को एन्कोड करना:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}")
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))
Accuracy: 0.9232
precision recall f1-score support
BARBUNYA 0.95 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.93 0.91 709
HOROZ 0.96 0.96 0.96 386
SEKER 0.95 0.96 0.95 406
SIRA 0.87 0.86 0.87 527
accuracy 0.92 2723
macro avg 0.94 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723LabelEncoder क्लास नामों को पूर्णांकों (0 से 6) में मैप करता है और मैपिंग स्टोर करता है ताकि आप भविष्यवाणियों को वापस क्लास नामों में बदल सकें। eval_metric="mlogloss" आर्गुमेंट XGBoost को आंतरिक मूल्यांकन के लिए multiclass log loss उपयोग करने को कहता है।
बॉक्स से बाहर, XGBoost 92.3% शुद्धता पाता है, जो Random Forest के 92.0% से थोड़ा अधिक है। प्रति-क्लास पैटर्न समान है: Bombay बीन्स पूरी तरह classifiy होते हैं, जबकि Sira बीन्स सबसे कठिन बने रहते हैं।
XGBoost gain पर आधारित फीचर इम्पॉर्टेंस देता है, जो मापता है कि किसी फीचर के उपयोग होने पर वह सभी splits में औसतन कितनी शुद्धता बढ़त देता है:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()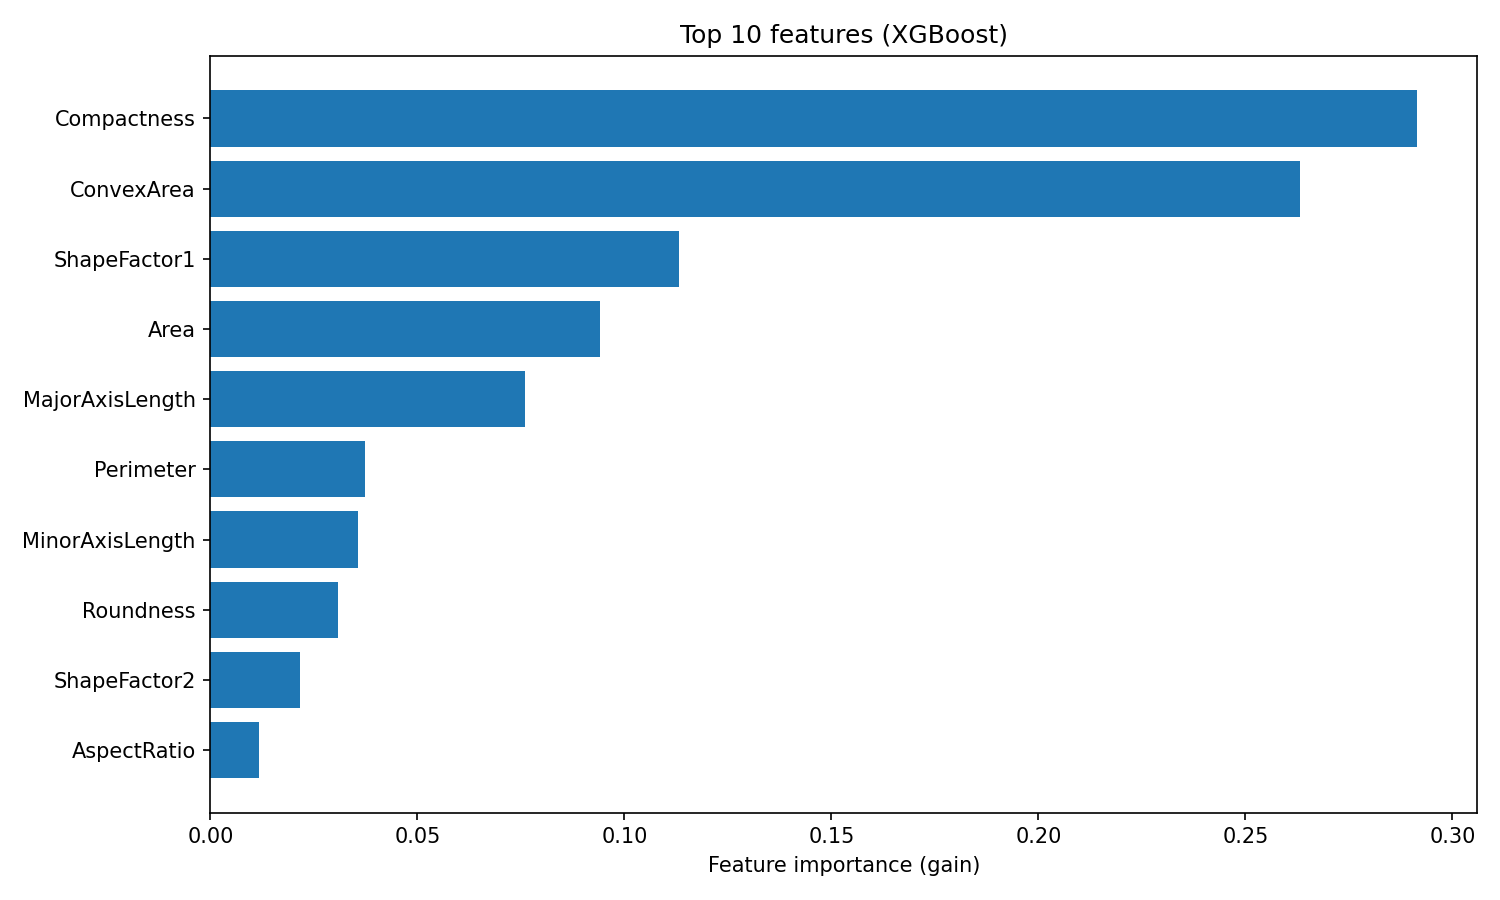
XGBoost फीचर इम्पॉर्टेंस
रैंकिंग Random Forest से अलग है। XGBoost ने Compactness और ConvexArea को शीर्ष पर रखा, जबकि Random Forest ने ShapeFactor3 को पहले स्थान पर रखा था.
यह अंतर बताता है कि दोनों एल्गोरिदम फीचर्स का उपयोग कैसे करते हैं: Random Forest स्वतंत्र ट्री में किसी फीचर द्वारा impurity कितनी बार घटती है, यह मापता है; जबकि XGBoost यह मापता है कि residuals सुधारते समय हर फीचर कितनी शुद्धता जोड़ता है। दोनों रैंकिंग वैध हैं, वे बस उपयोगिता के अलग पहलुओं को पकड़ती हैं।
XGBoost में Random Forest से अधिक ट्यूनिंग knobs हैं, जो इसकी अधिक लचीलेपन को दर्शाता है। मुख्य पैरामीटर्स हैं:
learning_rate: हर ट्री पर लागू shrinkage (डिफ़ॉल्ट 0.3)। कम मान अधिक ट्री माँगते हैं पर अक्सर बेहतर generalize करते हैं।max_depth: अधिकतम ट्री गहराई (डिफ़ॉल्ट 6)। उथले ट्री overfitting घटाते हैं। XGBoost का डिफ़ॉल्ट Random Forest की असीमित गहराई से अधिक सतर्क है।n_estimators: boosting राउंड्स की संख्या। विशेषकर कम learning rate के साथ, अधिक राउंड्स सूक्ष्म सुधारों की अनुमति देते हैं।reg_alpha: पत्तियों के weights पर L1 regularization (डिफ़ॉल्ट 0)। बड़े मान weights को शून्य की ओर धकेलते हैं, जिससे मॉडल sparse बनते हैं।reg_lambda: पत्तियों के weights पर L2 regularization (डिफ़ॉल्ट 1)। बड़े मान बड़े weights को दंडित करते हैं, भविष्यवाणियों को स्मूथ करते हैं।इनमें से कुछ पैरामीटर्स पर grid search:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f"Best params: {grid_search_xgb.best_params_}")
 print(f"Best CV accuracy: {grid_search_xgb.best_score_:.4f}")
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
Best CV accuracy: 0.9284y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
print(f"Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}")Tuned test accuracy: 0.9251सर्वोत्तम कॉन्फ़िगरेशन उथले ट्री (max_depth=4), अधिक regularization (reg_lambda=5), और दोगुने boosting राउंड्स (n_estimators=200) उपयोग करता है। यह पैटर्न आम है: XGBoost अक्सर कमजोर व्यक्तिगत ट्री को अधिक boosting राउंड्स के साथ जोड़कर सर्वश्रेष्ठ देता है। ट्यूनिंग से test शुद्धता 92.3% से 92.5% हो जाती है।
XGBoost के पैरामीटर्स और early stopping जैसे उन्नत फीचर्स पर गहराई से देखने के लिए DataCamp का XGBoost in Python ट्यूटोरियल देखें।
दोनों मॉडल ट्रेन और ट्यून करने के बाद, Dry Beans डेटासेट पर उनका तुलनात्मक चित्र इस प्रकार है।
|
Metric |
Random Forest |
XGBoost |
|
Accuracy (डिफ़ॉल्ट) |
92.0% |
92.3% |
|
Accuracy (ट्यून किया हुआ) |
92.1% |
92.5% |
|
Macro precision |
0.93 |
0.94 |
|
Macro recall |
0.93 |
0.93 |
|
Macro F1 |
0.93 |
0.93 |
|
Training time |
तेज़ |
मध्यम |
|
Tuning effort |
कम |
मध्यम |
Accuracy के आँकड़े XGBoost के पक्ष में हैं, पर macro F1 देखने पर अंतर घट जाता है। दोनों मॉडल 0.93 पाते हैं, यानी सातों बीन क्लासेस पर समान रूप से अच्छा प्रदर्शन करते हैं, न कि केवल बहुसंख्यक क्लास पर।
प्रति-क्लास प्रदर्शन भी यही कहानी बताता है:
|
Class |
Random Forest F1 |
XGBoost F1 |
|
Bombay |
1.00 |
1.00 |
|
Horoz |
0.96 |
0.96 |
|
Seker |
0.95 |
0.95 |
|
Cali |
0.94 |
0.94 |
|
Barbunya |
0.92 |
0.92 |
|
Dermason |
0.91 |
0.91 |
|
Sira |
0.86 |
0.87 |
दोनों मॉडल क्लासेस को समान क्रम में रैंक करते हैं। Bombay बीन्स को classifiy करना सबसे आसान है (वे सबसे बड़े और सबसे अलग हैं), जबकि Sira सबसे कठिन हैं (उनका आकार Dermason और Seker से ओवरलैप करता है)। XGBoost का प्रति-क्लास एकमात्र लाभ Sira पर F1 में 1-पॉइंट का सुधार है।
इन मॉडलों के बीच व्यावहारिक अंतर accuracy नहीं है। फर्क है कि आप ट्यूनिंग में कितना प्रयास करना चाहते हैं। Random Forest डिफ़ॉल्ट पैरामीटर्स के साथ XGBoost से केवल 0.4% पीछे था। XGBoost को आगे निकलने के लिए learning rate, tree depth, और regularization पर grid search चाहिए था।
|
परिस्थिति |
सिफारिश |
|
त्वरित बेसलाइन |
Random Forest (मजबूत डिफ़ॉल्ट, न्यूनतम ट्यूनिंग) |
|
अधिकतम शुद्धता |
XGBoost (उचित ट्यूनिंग के साथ उच्च ceiling) |
|
ट्यूनिंग के लिए सीमित समय |
Random Forest (हाइपरपैरामीटर्स के प्रति कम संवेदनशील) |
|
बहुत बड़े डेटासेट |
XGBoost (बेहतर मेमोरी दक्षता, GPU सपोर्ट) |
|
स्पष्टता/व्याख्या चाहिए |
कोई भी (दोनों फीचर इम्पॉर्टेंस देते हैं) |
|
प्रोडक्शन परिनियोजन |
कोई भी (दोनों की परिपक्व, स्थिर लाइब्रेरीज़ हैं) |
एक व्यावहारिक वर्कफ़्लो: बेसलाइन स्थापित करने के लिए पहले Random Forest से शुरू करें, फिर यदि आपको अतिरिक्त प्रदर्शन निचोड़ना हो तो XGBoost आज़माएँ। सर्वश्रेष्ठ चुनाव आपकी बाधाओं पर निर्भर है, न कि एल्गोरिदम की किसी सार्वभौमिक रैंकिंग पर।
इस ट्यूटोरियल में, मैंने दिखाया कि bagging और boosting कैसे कमजोर मॉडलों को मजबूत बनाते हैं। Bagging मॉडल को समानांतर में ट्रेन करता है और उनकी गलतियों का औसत लेता है। Boosting उन्हें क्रम में ट्रेन करता है, जहाँ हर एक पिछले की गलतियाँ ठीक करता है।
Random Forest और XGBoost पसंदीदा implementations हैं। Dry Beans डेटासेट पर, दोनों लगभग 92% शुद्धता तक पहुँचे। ट्यूनिंग के बाद XGBoost थोड़ा आगे रहा, लेकिन Random Forest लगभग बिना किसी कॉन्फ़िगरेशन के वहाँ पहुँच गया। असली trade-off यही है: Random Forest कम-देखभाल वाला है, XGBoost अतिरिक्त प्रयास का फल देता है।
जब आप किसी नई समस्या पर काम शुरू करें, तो पहले Random Forest फिट करें। यह एक ठोस बेसलाइन है जिसे सेटअप करने में मिनट लगते हैं। यदि आपको शुद्धता और बढ़ानी हो और ट्यूनिंग का समय हो, तो XGBoost पर जाएँ।
इन एल्गोरिदम के साथ और अधिक hands-on अभ्यास के लिए, मैं DataCamp का Machine Learning with Tree-Based Models कोर्स सुझाता हूँ।
शीर्ष मशीन लर्निंग पाठ्यक्रम
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें