
Khóa học
Ensemble Methods in Python
4 giờ
13.1K
Một cây quyết định đơn lẻ dễ diễn giải nhưng thường bị overfit. Một mô hình tuyến tính đơn giản khái quát hóa tốt nhưng bỏ lỡ các mẫu phức tạp. Mỗi loại mô hình có những điểm mù hạn chế độ chính xác trên dữ liệu thực tế.
Phương pháp ensemble giải quyết điều này bằng cách kết hợp nhiều mô hình thành một mô hình duy nhất. Thay vì dựa vào một bộ dự đoán, chúng tổng hợp dự đoán từ nhiều mô hình để lỗi cá nhân triệt tiêu lẫn nhau. Kết quả thường chính xác hơn bất kỳ mô hình đơn lẻ nào.
Trong hướng dẫn này, tôi sẽ chỉ cho bạn sự khác nhau giữa các phương pháp ensemble cốt lõi và tập trung vào hai thuật toán ensemble phổ biến nhất: Random Forest và XGBoost.
Bạn sẽ học cách từng thuật toán hoạt động, triển khai cả hai trên một bài toán phân loại đa lớp, và so sánh hiệu năng của chúng. Mục tiêu là giúp bạn hiểu thực tiễn khi nào nên dùng từng cách tiếp cận và cách tinh chỉnh chúng cho dự án của riêng bạn.
Nếu bạn muốn luyện tập thực hành thêm, tôi khuyến nghị xem khóa học Ensemble Methods in Python.
Ensemble learning huấn luyện nhiều mô hình và kết hợp dự đoán của chúng thành một đầu ra duy nhất. Ý tưởng rất đơn giản: các mô hình khác nhau mắc những lỗi khác nhau, nên khi lấy trung bình hoặc bỏ phiếu từ nhiều mô hình sẽ triệt tiêu lỗi riêng lẻ.
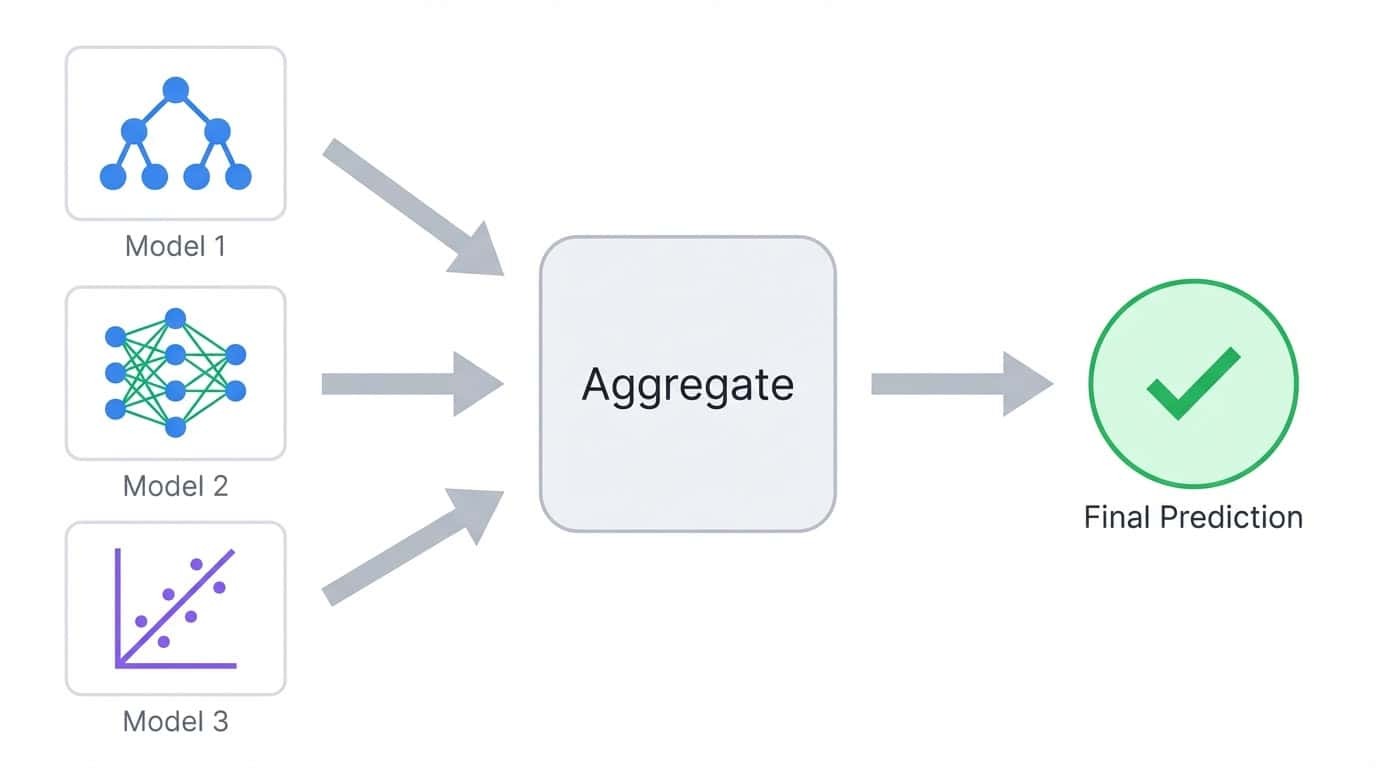
Ensemble learning kết hợp dự đoán từ nhiều mô hình thành một đầu ra tổng hợp
Hãy xét một tác vụ phân loại nơi bạn huấn luyện năm cây quyết định. Mỗi cây có thể đúng 80% dự đoán, nhưng chúng không thất bại trên cùng một ví dụ. Khi bạn tổng hợp phiếu bầu của chúng, đa số thường sẽ đúng ngay cả khi một hoặc hai cây sai. Đây là nguyên lý cốt lõi đứng sau mọi phương pháp ensemble.
Các mô hình bên trong một ensemble được gọi là base learner. Chúng có thể là bất kỳ thuật toán nào, nhưng cây quyết định là lựa chọn phổ biến nhất vì huấn luyện nhanh và tự nhiên tạo ra dự đoán đa dạng khi đưa các tập dữ liệu con khác nhau.
Lỗi mô hình đến từ hai nguồn: bias (độ chệch) và variance (phương sai).
Bias là lỗi do đơn giản hóa quá mức vấn đề. Một mô hình tuyến tính cố gắng khớp một mối quan hệ cong có bias cao vì nó không thể biểu diễn đúng mẫu thực, dù bạn cung cấp bao nhiêu dữ liệu. Mô hình có bias cao tạo ra dự đoán tương tự nhau trên các tập huấn luyện khác nhau, nhưng các dự đoán đó luôn lệch mục tiêu.
Variance là lỗi do quá nhạy với dữ liệu huấn luyện. Một cây quyết định sâu ghi nhớ tập huấn luyện có variance cao vì nó bắt cả nhiễu lẫn tín hiệu. Nếu bạn huấn luyện lại cùng cây trên một mẫu hơi khác, bạn sẽ nhận được dự đoán rất khác nhau. Mô hình khớp tốt dữ liệu huấn luyện nhưng sụp đổ khi gặp dữ liệu mới.
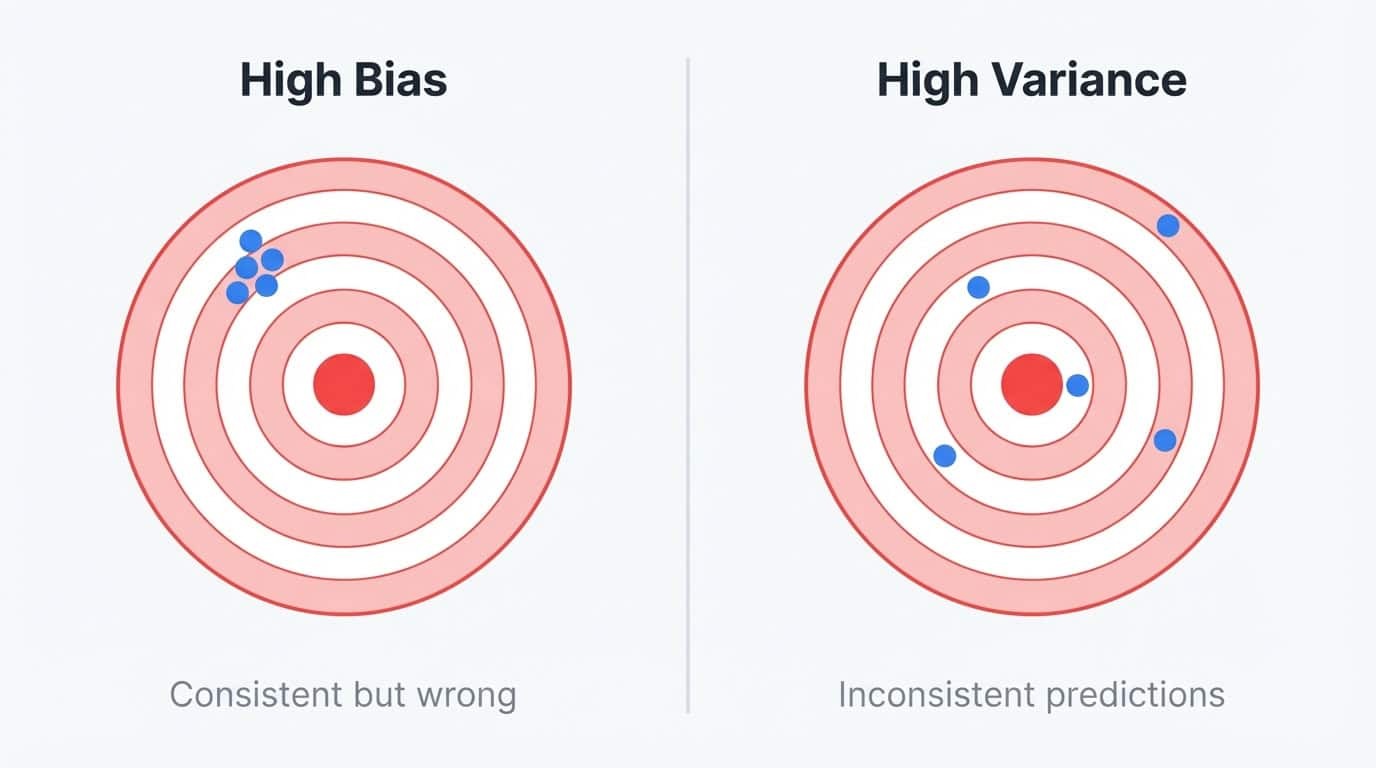
Minh họa bias vs variance bằng bảng phi tiêu: bias cao cho thấy dự đoán nhất quán nhưng lệch mục tiêu, variance cao cho thấy dự đoán phân tán và không nhất quán
Bạn có thể xem đây là vấn đề ổn định. Mô hình có bias cao thì ổn định nhưng luôn sai theo cùng một cách. Mô hình có variance cao thì không ổn định và sai theo những cách khác nhau tùy dữ liệu mà nó tình cờ thấy.
Mô hình lý tưởng vừa ổn định vừa chính xác, nhưng giảm một loại lỗi thường làm tăng loại còn lại.
Cây quyết định thuộc nhóm variance cao. Chúng dùng phép tách tham lam, nghĩa là thay đổi nhỏ trong dữ liệu huấn luyện có thể tạo ra cấu trúc cây hoàn toàn khác.
Huấn luyện cùng thuật toán cây trên hai mẫu ngẫu nhiên từ cùng quần thể, bạn có thể nhận hai mô hình chẳng giống nhau. Sự bất ổn này khiến từng cây riêng lẻ thiếu tin cậy, nhưng lại khiến chúng trở thành viên gạch hoàn hảo để xây ensemble.
Variance cao nghĩa là còn dư địa để cải thiện thông qua tổng hợp. Cây cũng huấn luyện nhanh và xử lý quan hệ phi tuyến mà không cần kỹ thuật đặc trưng thủ công, đó là lý do Random Forest và XGBoost đều dùng chúng dù giải quyết các phần khác nhau của bài toán bias-variance.
Phương pháp ensemble phá vỡ đánh đổi này bằng cách kết hợp nhiều mô hình:
Bagging huấn luyện nhiều mô hình song song trên các tập con dữ liệu ngẫu nhiên, rồi lấy trung bình dự đoán của chúng. Cách này giảm variance bằng cách làm mượt những lệch lạc của từng mô hình. Trực giác rất rõ: nếu mỗi mô hình mắc lỗi phần nào độc lập, thì việc lấy trung bình sẽ triệt tiêu các lỗi đó. Bạn kết hợp càng nhiều mô hình, dự đoán cuối cùng càng ổn định. Đó là lý do Random Forest mặc định dùng 100 cây thay vì 10.
Boosting huấn luyện các mô hình theo trình tự, trong đó mô hình mới tập trung vào lỗi của các mô hình trước. Cách này giảm bias bằng việc xây một bộ học mạnh từ nhiều bộ học yếu.
Hãy phân tích cách bagging và boosting hoạt động trong thực tế.
Bagging là viết tắt của bootstrap aggregating. Quy trình gồm ba bước:
1. Tạo nhiều tập huấn luyện bằng cách lấy mẫu từ dữ liệu gốc có hoàn lại (mẫu bootstrap)
2. Huấn luyện một mô hình độc lập trên mỗi mẫu bootstrap
3. Kết hợp dự đoán bằng cách lấy trung bình (hồi quy) hoặc đa số phiếu (phân loại)
Lấy mẫu bootstrap nghĩa là mỗi tập huấn luyện có cùng kích thước với dữ liệu gốc, nhưng một số ví dụ xuất hiện nhiều lần trong khi số khác không xuất hiện. Trung bình, mỗi mẫu bootstrap chứa khoảng 63% ví dụ duy nhất từ dữ liệu gốc. 37% còn lại gọi là mẫu out-of-bag và có thể dùng để kiểm định.
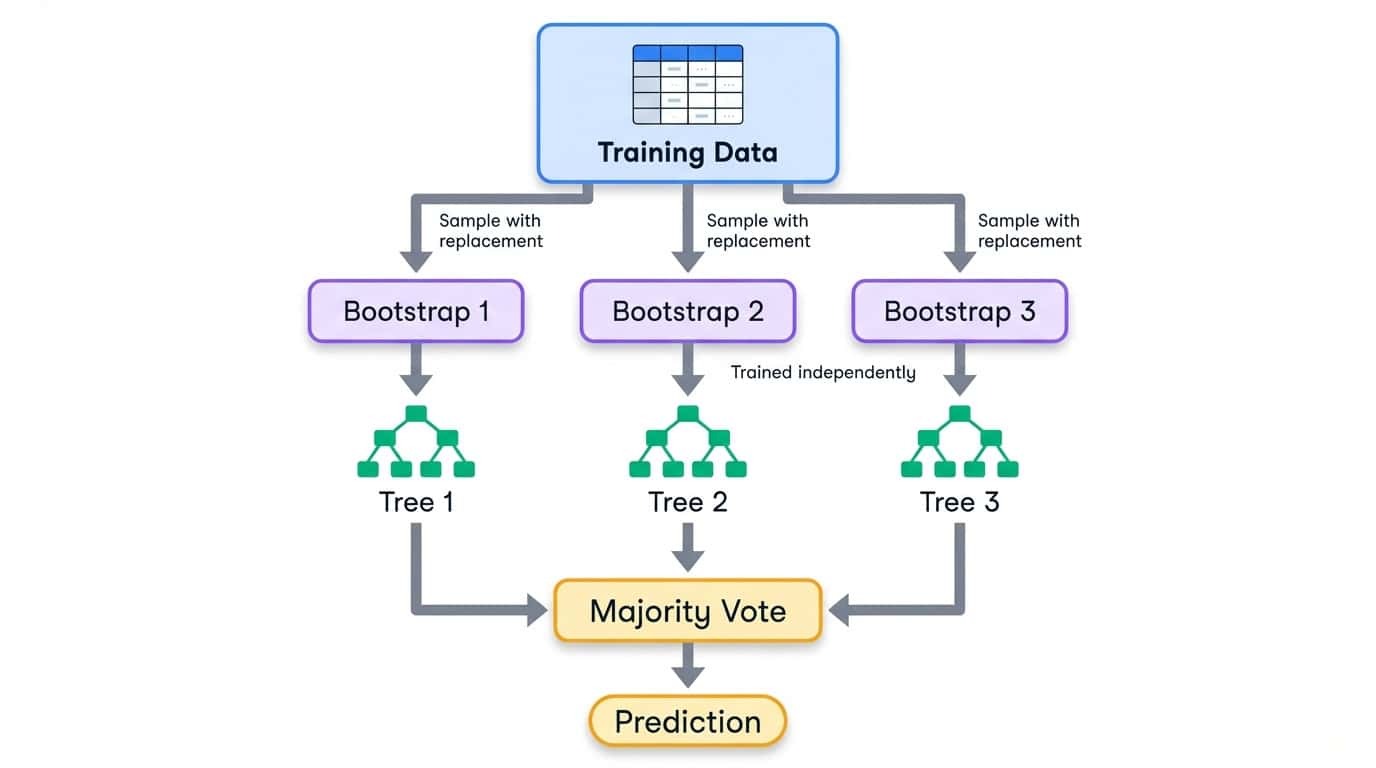
Quy trình bagging minh họa việc chia dữ liệu huấn luyện thành các mẫu bootstrap, mỗi mẫu huấn luyện một cây quyết định độc lập, rồi kết hợp bằng đa số phiếu
Vì mỗi mô hình thấy một lát cắt khác nhau của dữ liệu, chúng phát triển những lệch lạc riêng. Một số overfit vào một vùng của không gian đặc trưng, số khác vào vùng khác. Khi bạn tổng hợp dự đoán của chúng, các lỗi riêng lẻ có xu hướng bị triệt tiêu. Dự đoán của ensemble ổn định hơn bất kỳ mô hình đơn lẻ nào.
Việc huấn luyện diễn ra song song vì các mô hình không phụ thuộc nhau. Điều này khiến bagging dễ mở rộng trên nhiều lõi CPU. Random Forest, mà bạn sẽ triển khai ở phần sau, là thuật toán bagging được dùng rộng rãi nhất. Để đào sâu lý thuyết, xem hướng dẫn về bagging trong machine learning của DataCamp.
Boosting tiếp cận khác. Thay vì huấn luyện độc lập, nó huấn luyện tuần tự, với mỗi mô hình mới tập trung vào các ví dụ mà các mô hình trước làm sai.
Quy trình tổng quát như sau:
1. Huấn luyện một mô hình yếu trên toàn bộ tập huấn luyện
2. Xác định các ví dụ mô hình dự đoán kém
3. Huấn luyện mô hình kế tiếp với trọng số nhấn mạnh thêm vào các ví dụ khó đó
4. Lặp lại, bổ sung các mô hình sửa các lỗi còn lại
5. Kết hợp tất cả mô hình thành tổng có trọng số, nơi mô hình tốt hơn có trọng số cao hơn
Thuật ngữ "weak learner" chỉ mô hình chỉ tốt hơn đoán ngẫu nhiên chút ít. Decision stump (cây chỉ có một phép tách) là lựa chọn phổ biến. Riêng lẻ, một stump gần như vô dụng. Nhưng boosting xếp chồng hàng trăm stump, mỗi cái dần gỡ bỏ lỗi còn lại của cái trước. Ensemble cuối cùng là bộ học mạnh được xây từ nhiều đóng góp yếu.
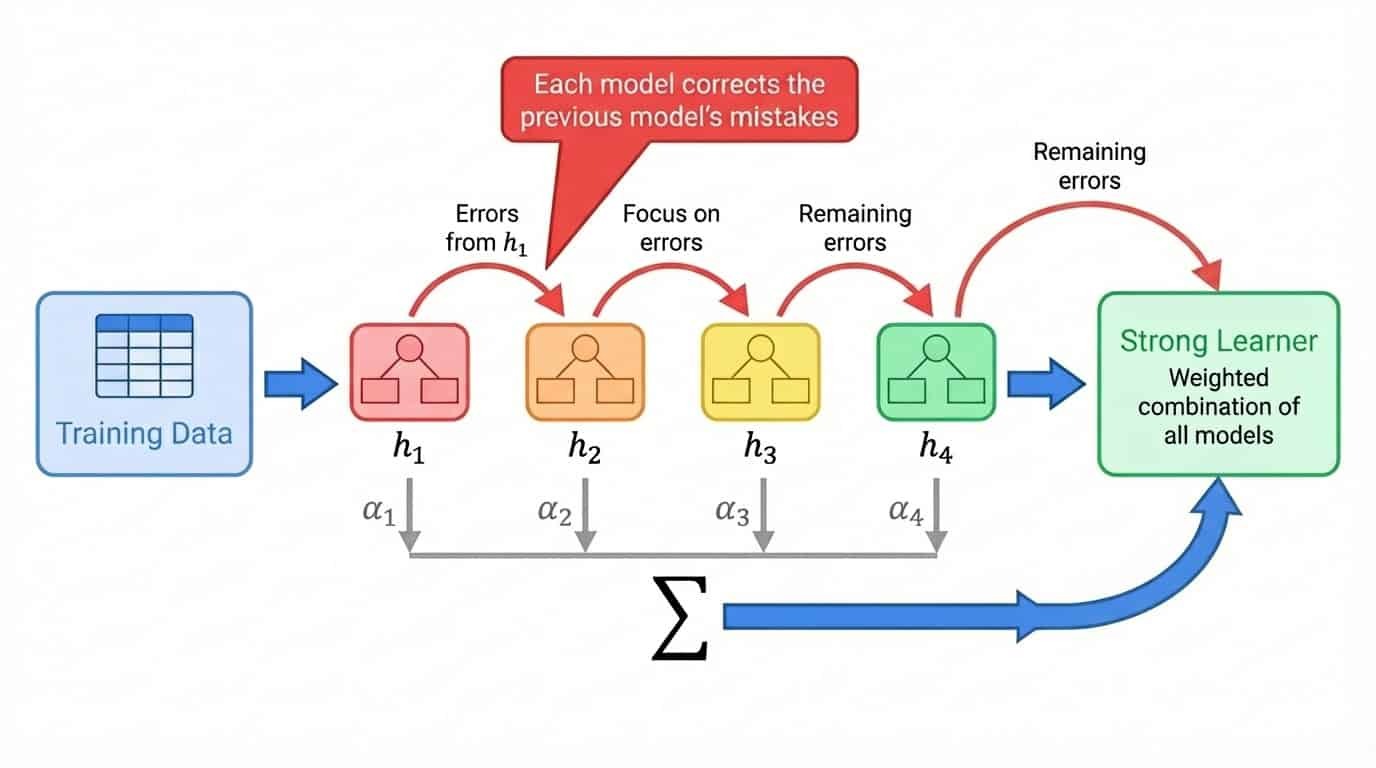
Quy trình boosting minh họa huấn luyện mô hình tuần tự, mỗi mô hình sửa lỗi của mô hình trước, rồi kết hợp thành tổng có trọng số
Khác với bagging, boosting vốn dĩ là tuần tự. Bạn không thể huấn luyện mô hình thứ 47 trước khi biết những ví dụ mà các mô hình 1 đến 46 gặp khó. Điều này khiến boosting huấn luyện chậm hơn, nhưng thường cho độ chính xác cao hơn vì mỗi mô hình được thiết kế có mục đích để khắc phục điểm yếu cụ thể trong ensemble.
XGBoost, mà bạn sẽ triển khai ở phần sau, là một thuật toán gradient boosting đã trở thành lựa chọn hàng đầu cho dữ liệu dạng bảng. Tôi khuyến nghị bài giới thiệu về boosting, có phần toán học chi tiết hơn nếu bạn muốn đào sâu.
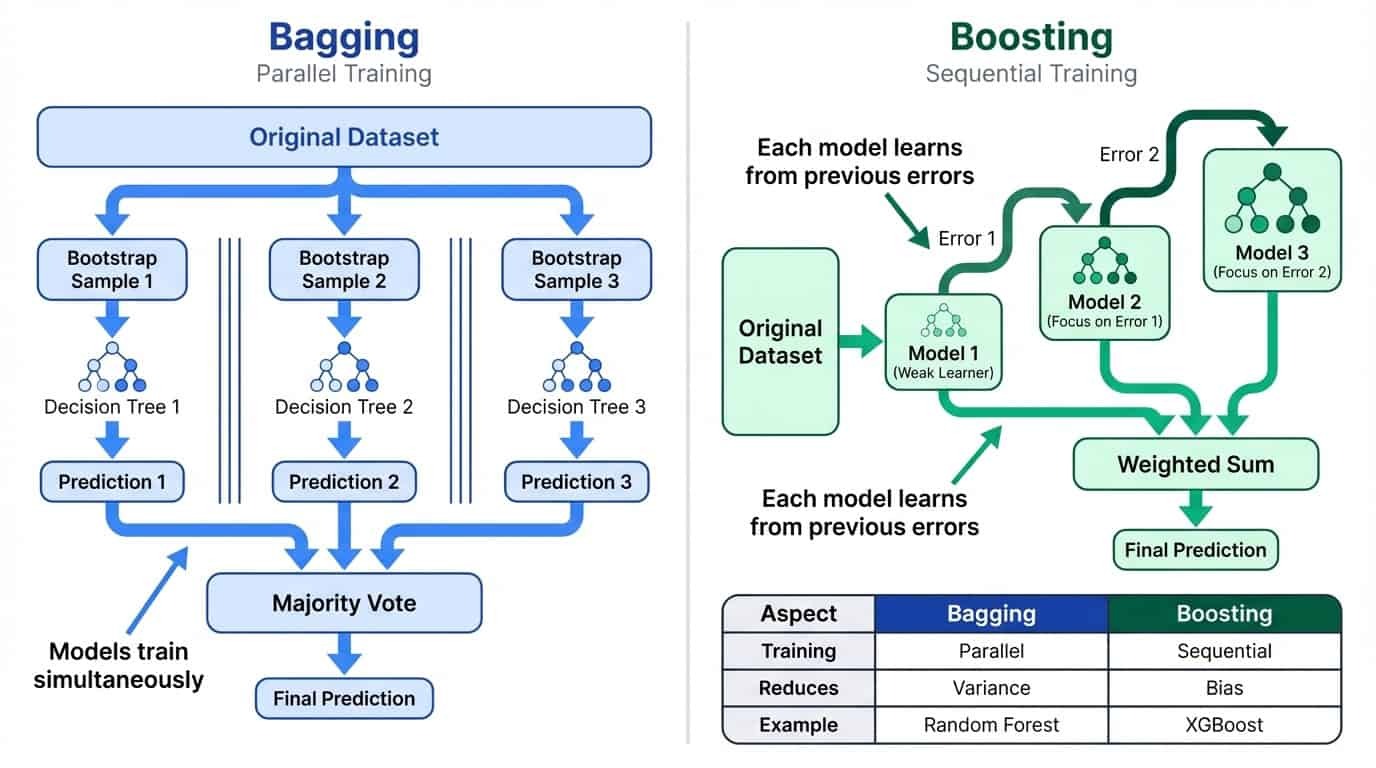
So sánh cạnh nhau giữa bagging và boosting: bagging dùng huấn luyện song song để giảm variance, boosting dùng huấn luyện tuần tự để giảm bias
Bagging và boosting là chiến lược ensemble được dùng rộng rãi nhất, nhưng không phải là các lựa chọn duy nhất. Trước khi đi vào Random Forest và XGBoost, cũng đáng biết thêm những gì khác tồn tại.
Cách đơn giản nhất để kết hợp mô hình là cho chúng bỏ phiếu. Ở hard voting, mỗi mô hình đưa ra dự đoán, và lớp có nhiều phiếu nhất thắng. Nếu bạn có logistic regression, support vector machine và một cây quyết định, và hai trong số chúng dự đoán lớp A còn một dự đoán lớp B, thì ensemble sẽ xuất ra lớp A.
Soft voting tiến thêm một bước bằng cách lấy trung bình xác suất dự đoán thay vì đếm phiếu rời rạc. Một mô hình dự đoán lớp A với độ tự tin 90% đóng góp nhiều hơn vào quyết định cuối cùng so với mô hình dự đoán A với 51% tự tin. Cách này thường vượt hard voting vì nắm bắt được mức độ chắc chắn của từng mô hình.
Bạn cũng có thể gán trọng số để mô hình mạnh có ảnh hưởng lớn hơn. Nếu logistic regression của bạn nhất quán vượt trội hơn các mô hình khác trên dữ liệu kiểm định, bạn có thể đặt trọng số dự đoán của nó là 2x trong khi các mô hình khác là 1x.
Voting hoạt động tốt nhất khi kết hợp các mô hình tiếp cận vấn đề theo những cách khác nhau. Một mô hình tuyến tính, một mô hình dựa trên cây, và một mô hình láng giềng gần nhất mỗi cái có các điểm mù khác nhau. Dự đoán kết hợp của chúng thường vượt qua từng mô hình riêng lẻ, ngay cả khi không mô hình nào thực sự mạnh. scikit-learn cung cấp VotingClassifier và VotingRegressor cho mục đích này.
Stacking đưa ý tưởng ensemble lên một tầng nữa. Thay vì lấy trung bình dự đoán, bạn huấn luyện một mô hình thứ hai (gọi là meta-learner) để kết hợp chúng. Quy trình như sau: huấn luyện vài mô hình nền tảng, thu thập dự đoán của chúng trên tập kiểm định, rồi huấn luyện meta-learner để ánh xạ các dự đoán đó tới nhãn đúng. Meta-learner học được nên tin mô hình nền tảng nào trong tình huống nào.
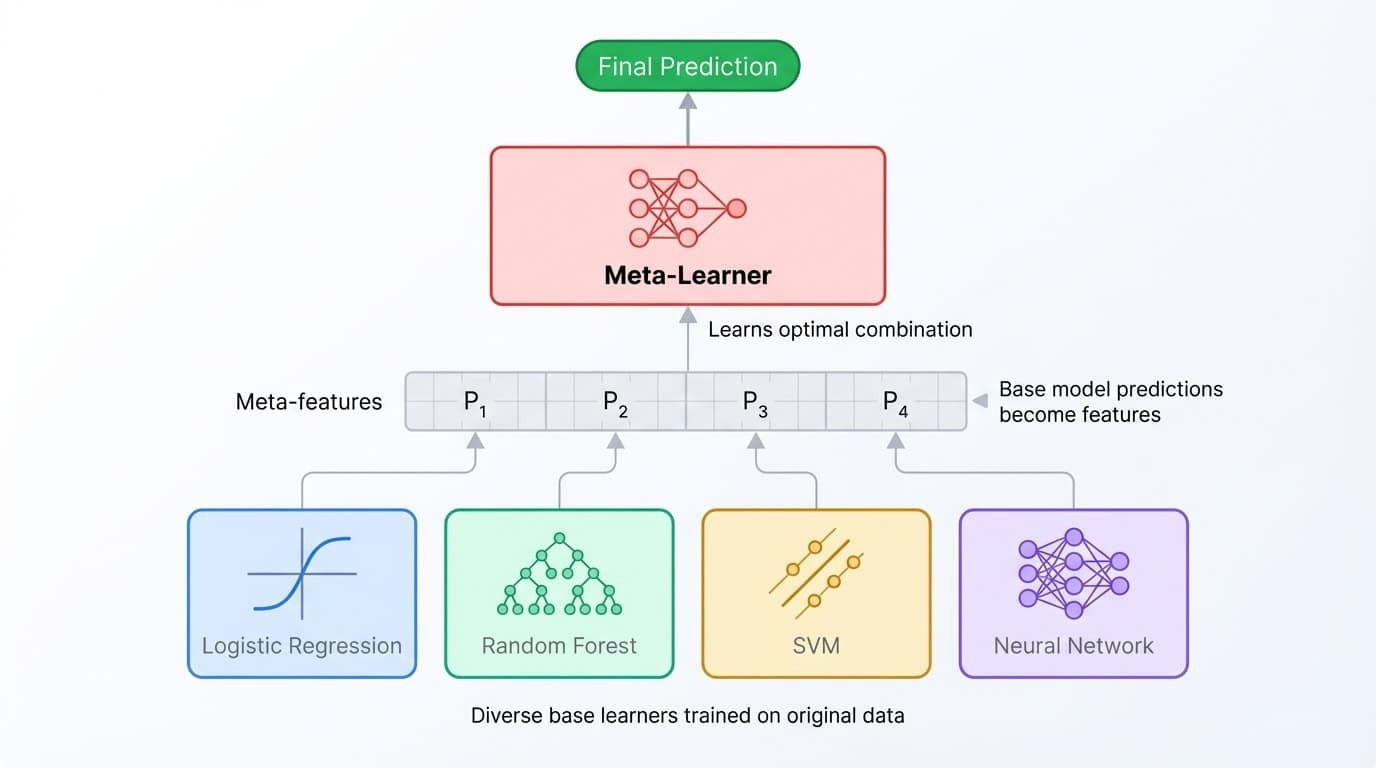
Kiến trúc stacking cho thấy các mô hình nền tảng đa dạng đưa dự đoán vào meta-learner để kết hợp ra đầu ra cuối
Blending là biến thể đơn giản hơn dùng một tập holdout duy nhất thay vì các nếp cross-validation. Nhanh triển khai hơn nhưng lãng phí một phần dữ liệu huấn luyện và dễ overfit vào tập holdout hơn.
Cả hai kỹ thuật có thể vắt thêm chút độ chính xác, nhưng mức tăng thường nhỏ (0,1–0,5%) so với độ phức tạp gia tăng. Ensemble xếp chồng khó gỡ lỗi hơn, huấn luyện chậm hơn và khó giải thích cho bên liên quan. Chúng tỏa sáng trong các cuộc thi Kaggle nơi từng chữ số thập phân đều quan trọng và thời gian huấn luyện không giới hạn, nhưng hiếm khi đáng để triển khai trong sản xuất.
Điều thú vị là hầu hết ensemble xếp chồng đều dùng Random Forest và XGBoost làm mô hình nền tảng. Hai thuật toán này mạnh đến mức stacking thường trở thành một cách rườm rà để lấy trung bình dự đoán của chúng.
Hướng dẫn này bám vào Random Forest (bagging) và XGBoost (boosting) vì chúng xử lý phần lớn bài toán dữ liệu dạng bảng trong thực tế. Chúng đơn giản để triển khai, dễ tinh chỉnh và dễ bảo trì hơn so với ensemble xếp chồng nhiều tầng.
Nếu bạn muốn đi sâu vào voting và stacking, khóa Ensemble Methods in Python của DataCamp bao quát đầy đủ kỹ thuật. Còn bây giờ, hãy thực hành với bộ dữ liệu.
Hướng dẫn này sử dụng bộ dữ liệu Dry Beans từ UCI Machine Learning Repository. Các nhà nghiên cứu Koklu và Ozkan (2020) đã chụp 13.611 hạt đậu khô từ bảy giống và trích xuất 16 đặc trưng hình học từ mỗi ảnh, gồm diện tích, chu vi, chiều dài trục và các hệ số hình dạng. Nhiệm vụ là phân loại mỗi hạt theo giống dựa trên các phép đo này.
Bộ dữ liệu này phù hợp cho hướng dẫn vì đây là bài toán đa lớp sạch với tất cả đặc trưng dạng số. Không có giá trị thiếu, không cần mã hóa dạng phân loại, không xử lý văn bản. Bạn có thể tập trung hoàn toàn vào các phương pháp ensemble.
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f"Features shape: {X.shape}")
 print(f"Target classes: {pd.Series(y).nunique()}")
Features shape: (13611, 16)
Target classes: 7X.head()|
Area |
Perimeter |
MajorAxisLength |
MinorAxisLength |
AspectRatio |
Eccentricity |
ConvexArea |
EquivDiameter |
Extent |
Solidity |
Roundness |
Compactness |
ShapeFactor1 |
ShapeFactor2 |
ShapeFactor3 |
|
28395 |
610.291 |
208.178 |
173.889 |
1.197 |
0.550 |
28715 |
190.141 |
0.764 |
0.989 |
0.958 |
0.913 |
0.007 |
0.003 |
0.834 |
|
28734 |
638.018 |
200.525 |
182.734 |
1.097 |
0.412 |
29172 |
191.273 |
0.784 |
0.985 |
0.887 |
0.954 |
0.007 |
0.004 |
0.910 |
|
29380 |
624.110 |
212.826 |
175.931 |
1.210 |
0.563 |
29690 |
193.411 |
0.778 |
0.990 |
0.948 |
0.909 |
0.007 |
0.003 |
0.826 |
|
30008 |
645.884 |
210.558 |
182.517 |
1.154 |
0.499 |
30724 |
195.467 |
0.783 |
0.977 |
0.904 |
0.928 |
0.007 |
0.003 |
0.862 |
|
30140 |
620.134 |
201.848 |
190.279 |
1.061 |
0.334 |
30417 |
195.897 |
0.773 |
0.991 |
0.985 |
0.971 |
0.007 |
0.004 |
0.942 |
pd.Series(y).value_counts()DERMASON 3546
SIRA 2636
SEKER 2027
HOROZ 1928
CALI 1630
BARBUNYA 1322
BOMBAY 522Các lớp tương đối cân bằng, với Dermason phổ biến nhất và Bombay ít nhất. Chia tầng (stratified) sẽ bảo toàn các tỷ lệ này ở cả tập huấn luyện và kiểm thử:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f"Training set: {X_train.shape[0]} samples")
 print(f"Test set: {X_test.shape[0]} samples")
Training set: 10888 samples
Test set: 2723 samplesKhi dữ liệu đã sẵn sàng, đến lúc huấn luyện mô hình ensemble đầu tiên. Phần này trình bày Random Forest hoạt động bên trong như thế nào, hướng dẫn huấn luyện và đánh giá, và cách tinh chỉnh siêu tham số.
Random Forest áp dụng bagging cho cây quyết định với một điểm khác. Mỗi cây được huấn luyện trên một mẫu bootstrap của dữ liệu (như đã đề cập), nhưng tại mỗi phép tách, thuật toán chỉ xem xét một tập con đặc trưng ngẫu nhiên thay vì tất cả.
Sự ngẫu nhiên về đặc trưng này ngăn cây trở nên quá giống nhau. Nếu không, các biến dự báo mạnh sẽ thống trị mọi cây, và ensemble sẽ chỉ là nhiều bản sao của các mô hình gần như giống hệt nhau.
Bằng cách buộc mỗi phép tách chọn trong một tập đặc trưng giới hạn, thuật toán tạo ra các cây đa dạng mắc lỗi khác nhau. Khi những cây này bỏ phiếu cùng nhau, lỗi riêng lẻ của chúng có xu hướng triệt tiêu.
Với bài toán phân loại, scikit-learn mặc định xem xét căn bậc hai của tổng số đặc trưng tại mỗi phép tách. Với 16 đặc trưng trong Dry Beans, mỗi phép tách chỉ đánh giá 4 đặc trưng được chọn ngẫu nhiên. Kết quả là một ensemble các cây ít tương quan, khái quát hóa tốt hơn bất kỳ cây đơn lẻ nào.
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}")
 print(classification_report(y_test, y_pred_rf))
Accuracy: 0.9199
precision recall f1-score support
BARBUNYA 0.94 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.92 0.91 709
HOROZ 0.96 0.95 0.96 386
SEKER 0.94 0.96 0.95 406
SIRA 0.86 0.85 0.86 527
accuracy 0.92 2723
macro avg 0.93 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Đoạn mã này tạo một rừng gồm 100 cây quyết định, huấn luyện chúng trên các mẫu bootstrap và tạo dự đoán bằng đa số phiếu. Tham số random_state cố định hạt giống ngẫu nhiên để có thể tái lặp kết quả.
Báo cáo phân loại phân rã hiệu năng theo từng lớp. Precision đo tỷ lệ dự đoán dương chính xác, recall đo tỷ lệ dương thực được phát hiện, và F1-score là trung bình điều hòa của chúng. Hạt Bombay được phân loại hoàn hảo (có lẽ vì khác biệt về hình thể), trong khi hạt Sira khó phân biệt nhất so với các giống khác.
Một ưu điểm của Random Forest là độ quan trọng đặc trưng có thể diễn giải. Thuật toán theo dõi mức độ mỗi đặc trưng giảm độ hỗn tạp (chỉ số Gini, mặc định) trên tất cả cây, cung cấp thước đo tích hợp để biết biến nào quan trọng nhất:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()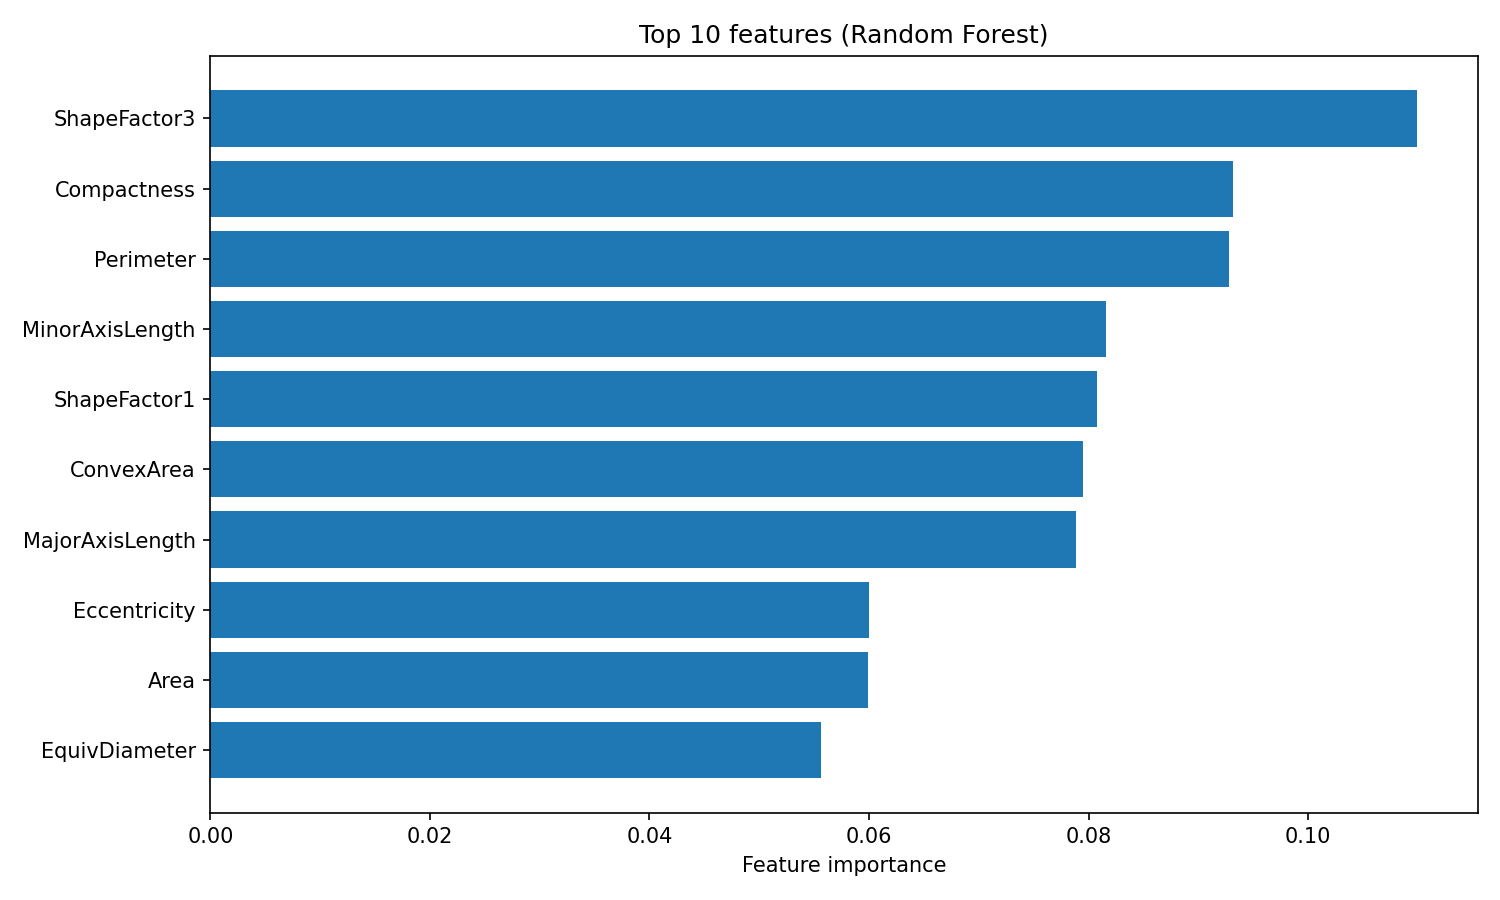
Độ quan trọng đặc trưng của Random Forest
Thuộc tính feature_importances_ trả về một mảng điểm số có tổng bằng 1, trong đó giá trị cao hơn chỉ ra đặc trưng đóng góp nhiều hơn vào các quyết định tách. ShapeFactor3 và Compactness đóng góp nhiều nhất cho phân loại, tiếp theo là các đo đạc hình học như Perimeter và MinorAxisLength. Những đặc trưng dựa trên hình dạng này nắm bắt khác biệt trực quan giữa các giống đậu mà các nhà nghiên cứu ban đầu thiết kế bộ dữ liệu để đo lường.
Random Forest có ba siêu tham số chính đáng để tinh chỉnh:
n_estimators: Số lượng cây trong rừng. Nhiều cây tạo ra dự đoán ổn định hơn nhưng mất thời gian huấn luyện lâu hơn. Hiệu quả tăng thêm giảm dần sau khoảng 200 cây với đa số bộ dữ liệu.max_depth: Độ sâu tối đa của mỗi cây. Mặc định (None) là phát triển cây cho đến khi lá thuần hoặc có ít hơn 2 mẫu. Giá trị thấp hơn có thể ngăn overfit.max_features: Số đặc trưng được xem xét tại mỗi phép tách. Mặc định "sqrt" hoạt động tốt cho phân loại. Dùng "log2" tăng đa dạng với cái giá là độ chính xác của từng cây.Một tìm kiếm lưới nhanh trên các tham số này:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f"Best params: {grid_search.best_params_}")
 print(f"Best CV accuracy: {grid_search.best_score_:.4f}")
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
Best CV accuracy: 0.9244GridSearchCV thử mọi tổ hợp tham số trong lưới và đánh giá từng tổ hợp bằng cross-validation. Tham số cv=3 chia dữ liệu huấn luyện thành 3 nếp, huấn luyện trên 2 và kiểm định trên 1, luân phiên mọi kết hợp. Cờ n_jobs=-1 song song hóa việc tìm kiếm trên tất cả lõi CPU sẵn có.
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}")
Tuned test accuracy: 0.9214Tinh chỉnh nâng độ chính xác từ 92,0% lên 92,1%, một cải thiện khiêm tốn. Cấu hình tốt nhất dùng mặc định cho max_depth và max_features, với 200 cây thay vì 100. Random Forest thường hoạt động tốt ngay từ mặc định, đó là một điểm hấp dẫn chính. Để tìm hiểu sâu về Random Forest và các tham số của nó, xem hướng dẫn phân loại bằng Random Forest của DataCamp.
XGBoost (Extreme Gradient Boosting) đi theo con đường khác để đạt độ chính xác so với Random Forest. Random Forest giảm variance bằng cách lấy trung bình các cây độc lập, còn XGBoost giảm bias bằng cách huấn luyện cây tuần tự, với mỗi cây mới sửa lỗi của ensemble hiện tại. Phần này đề cập gradient boosting hoạt động ra sao, điều gì khiến XGBoost đặc biệt, và cách huấn luyện, tinh chỉnh nó trên bộ Dry Beans.
Gradient boosting xây một ensemble từng cây một. Cây đầu tiên dự đoán trên mục tiêu gốc. Cây thứ hai không huấn luyện trên mục tiêu gốc, mà trên phần dư lỗi từ cây thứ nhất. Cây thứ ba khớp phần dư còn lại sau khi cộng dự đoán của cây thứ hai. Quy trình tiếp tục hàng trăm vòng, với mỗi cây mới dần loại bỏ phần lỗi còn lại.
Thuật ngữ "gradient" ám chỉ cách thuật toán quyết định cần khớp gì. Ở mỗi bước, nó tính gradient của hàm mất mát theo dự đoán hiện tại. Với hồi quy dùng mất mát bình phương, gradient chính là phần dư (thực trừ dự đoán). Với phân loại, toán học phức tạp hơn, nhưng trực giác tương tự: mỗi cây được huấn luyện để đẩy dự đoán theo hướng giảm mất mát nhiều nhất.
Tham số learning rate thu nhỏ đóng góp của mỗi cây trước khi cộng vào ensemble. Ví dụ, với learning rate 0,1, chỉ 10% dự đoán của mỗi cây được cộng. Điều này buộc thuật toán đi những bước nhỏ hơn và thường cải thiện khả năng khái quát. Đổi lại, bạn cần nhiều cây hơn để đạt cùng mức khớp. Learning rate nhỏ cộng với nhiều cây thường cho kết quả tốt hơn learning rate lớn với ít cây.
XGBoost là một trong vài triển khai gradient boosting, bên cạnh LightGBM và CatBoost. Nó trở nên phổ biến vì bổ sung một số cải tiến so với các triển khai trước như GradientBoostingClassifier của scikit-learn.
Các bổ sung chính gồm:
Những tính năng này khiến XGBoost vừa nhanh hơn vừa chống overfitting tốt hơn so với gradient boosting thuần. Các tham số regularization cho bạn quyền kiểm soát trực tiếp độ phức tạp mô hình, hữu ích khi làm việc với dữ liệu nhiễu hoặc chiều cao.
XGBoost kỳ vọng nhãn lớp dạng số thay vì chuỗi, nên bước đầu là mã hóa biến mục tiêu:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}")
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))
Accuracy: 0.9232
precision recall f1-score support
BARBUNYA 0.95 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.93 0.91 709
HOROZ 0.96 0.96 0.96 386
SEKER 0.95 0.96 0.95 406
SIRA 0.87 0.86 0.87 527
accuracy 0.92 2723
macro avg 0.94 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Bộ LabelEncoder ánh xạ tên lớp sang số nguyên (0 đến 6) và lưu lại ánh xạ để bạn có thể chuyển đổi dự đoán về tên lớp. Tham số eval_metric="mlogloss" bảo XGBoost dùng log loss đa lớp cho đánh giá nội bộ.
Ngay từ mặc định, XGBoost đạt 92,3% độ chính xác, nhỉnh hơn Random Forest 92,0% một chút. Mẫu theo lớp tương tự: hạt Bombay được phân loại hoàn hảo, trong khi Sira vẫn khó phân biệt nhất.
XGBoost cung cấp độ quan trọng đặc trưng dựa trên gain, đo lường mức cải thiện độ chính xác trung bình mà mỗi đặc trưng đóng góp trên tất cả các phép tách nơi nó được dùng:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()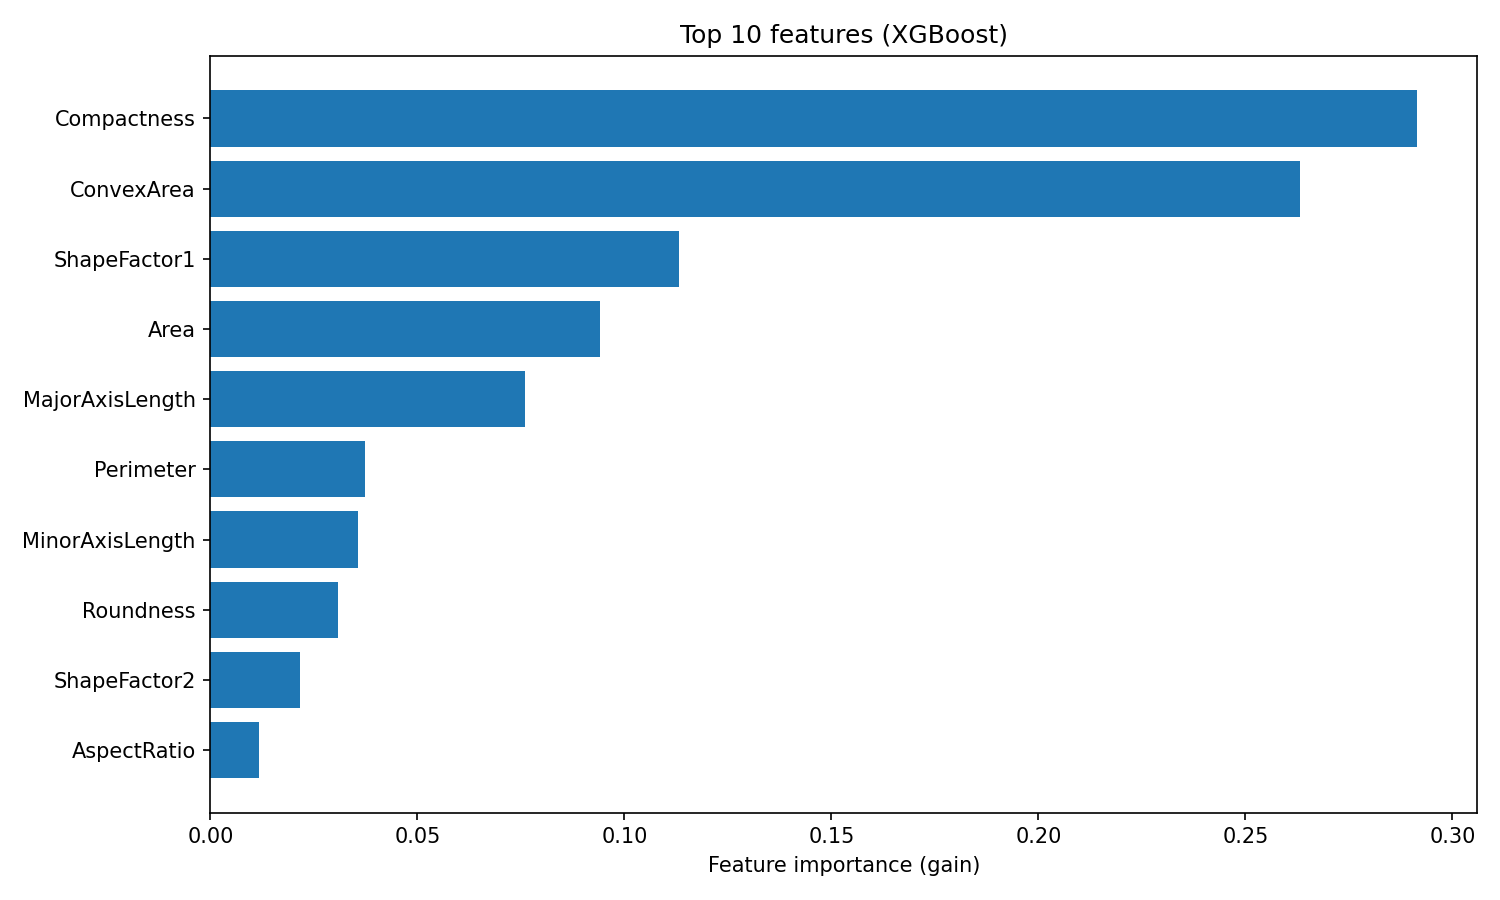
Độ quan trọng đặc trưng của XGBoost
Thứ hạng khác với Random Forest. XGBoost đặt Compactness và ConvexArea lên đầu, trong khi Random Forest xếp ShapeFactor3 đầu tiên.
Sự khác biệt này phản ánh cách hai thuật toán dùng đặc trưng: Random Forest đo tần suất một đặc trưng giảm độ hỗn tạp trên nhiều cây độc lập, còn XGBoost đo mức độ chính xác mà mỗi đặc trưng thêm vào khi sửa phần dư. Cả hai bảng xếp hạng đều hợp lý, chỉ là nắm bắt các khía cạnh khác nhau của tính hữu ích đặc trưng.
XGBoost có nhiều nút chỉnh hơn Random Forest, phản ánh độ linh hoạt lớn hơn. Các tham số chính cần cân nhắc gồm:
learning_rate: Hệ số thu nhỏ áp dụng cho mỗi cây (mặc định 0,3). Giá trị thấp hơn cần nhiều cây hơn nhưng thường khái quát tốt hơn.max_depth: Độ sâu cây tối đa (mặc định 6). Cây nông hơn giảm overfitting. Mặc định của XGBoost thận trọng hơn độ sâu không giới hạn của Random Forest.n_estimators: Số vòng boosting. Nhiều vòng cho phép hiệu chỉnh tinh hơn, đặc biệt khi learning rate thấp.reg_alpha: Regularization L1 trên trọng số lá (mặc định 0). Giá trị cao đẩy trọng số về 0, tạo mô hình thưa hơn.reg_lambda: Regularization L2 trên trọng số lá (mặc định 1). Giá trị cao phạt trọng số lớn, làm mượt dự đoán.Một tìm kiếm lưới trên vài tham số này:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f"Best params: {grid_search_xgb.best_params_}")
 print(f"Best CV accuracy: {grid_search_xgb.best_score_:.4f}")
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
Best CV accuracy: 0.9284y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
print(f"Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}")Tuned test accuracy: 0.9251Cấu hình tốt nhất dùng cây nông hơn (max_depth=4), regularization mạnh hơn (reg_lambda=5), và gấp đôi số vòng boosting (n_estimators=200). Mẫu hình này phổ biến: XGBoost thường hoạt động tốt nhất với các cây riêng lẻ yếu hơn nhưng kết hợp qua nhiều vòng boosting. Tinh chỉnh nâng độ chính xác kiểm thử từ 92,3% lên 92,5%.
Để tìm hiểu sâu hơn về các tham số của XGBoost và các tính năng nâng cao như early stopping, xem hướng dẫn XGBoost trong Python của DataCamp.
Khi cả hai mô hình đã được huấn luyện và tinh chỉnh, đây là cách chúng so sánh trên bộ Dry Beans.
|
Chỉ số |
Random Forest |
XGBoost |
|
Độ chính xác (mặc định) |
92,0% |
92,3% |
|
Độ chính xác (đã tinh chỉnh) |
92,1% |
92,5% |
|
Macro precision |
0,93 |
0,94 |
|
Macro recall |
0,93 |
0,93 |
|
Macro F1 |
0,93 |
0,93 |
|
Thời gian huấn luyện |
Nhanh |
Trung bình |
|
Công sức tinh chỉnh |
Thấp |
Trung bình |
Các con số độ chính xác nghiêng về XGBoost, nhưng khoảng cách thu hẹp khi nhìn vào macro F1. Cả hai đạt 0,93, nghĩa là chúng hoạt động ngang nhau trên cả bảy lớp đậu thay vì chỉ vượt trội ở lớp đa số.
Hiệu năng theo từng lớp cũng kể câu chuyện tương tự:
|
Lớp |
F1 của Random Forest |
F1 của XGBoost |
|
Bombay |
1,00 |
1,00 |
|
Horoz |
0,96 |
0,96 |
|
Seker |
0,95 |
0,95 |
|
Cali |
0,94 |
0,94 |
|
Barbunya |
0,92 |
0,92 |
|
Dermason |
0,91 |
0,91 |
|
Sira |
0,86 |
0,87 |
Cả hai mô hình xếp hạng các lớp giống hệt nhau. Hạt Bombay dễ phân loại nhất (lớn nhất và khác biệt về hình thể), trong khi hạt Sira khó nhất (hình dạng chồng lấn với Dermason và Seker). Lợi thế theo lớp duy nhất của XGBoost là tăng 1 điểm F1 cho Sira.
Sự khác biệt thực tế giữa hai mô hình không nằm ở độ chính xác. Mà ở mức công sức bạn muốn bỏ ra để tinh chỉnh. Random Forest đạt hiệu năng kém XGBoost chỉ 0,4% với tham số mặc định. XGBoost cần tìm kiếm lưới trên learning rate, độ sâu cây và regularization để vượt lên.
|
Kịch bản |
Khuyến nghị |
|
Thiết lập baseline nhanh |
Random Forest (mặc định mạnh, cần ít tinh chỉnh) |
|
Tối đa hóa độ chính xác |
XGBoost (trần hiệu năng cao hơn nếu tinh chỉnh đúng) |
|
Ít thời gian tinh chỉnh |
Random Forest (ít nhạy với siêu tham số) |
|
Bộ dữ liệu rất lớn |
XGBoost (hiệu quả bộ nhớ tốt hơn, hỗ trợ GPU) |
|
Cần khả năng diễn giải |
Cả hai (đều cung cấp độ quan trọng đặc trưng) |
|
Triển khai sản xuất |
Cả hai (đều có thư viện trưởng thành, ổn định) |
Quy trình hợp lý: bắt đầu với Random Forest để thiết lập baseline, sau đó thử XGBoost nếu bạn cần vắt thêm hiệu năng. Lựa chọn tốt nhất phụ thuộc vào ràng buộc của bạn, không phải bảng xếp hạng thuật toán chung chung.
Trong hướng dẫn này, tôi đã chỉ ra cách bagging và boosting biến các mô hình yếu thành mô hình mạnh. Bagging huấn luyện mô hình song song và lấy trung bình lỗi của chúng. Boosting huấn luyện tuần tự, với mỗi mô hình sửa lỗi của mô hình trước.
Random Forest và XGBoost là các triển khai nên dùng. Trên bộ Dry Beans, cả hai đạt quanh 92% độ chính xác. XGBoost nhỉnh hơn sau tinh chỉnh, nhưng Random Forest đạt được với hầu như không cần cấu hình. Đó là đánh đổi thực sự: Random Forest ít tốn công bảo trì, XGBoost tưởng thưởng cho công sức thêm.
Khi bắt đầu một bài toán mới, hãy huấn luyện Random Forest trước. Đó là baseline vững chắc thiết lập trong vài phút. Nếu cần đẩy độ chính xác cao hơn và có thời gian tinh chỉnh, hãy chuyển sang XGBoost.
Để thực hành thêm với các thuật toán này, tôi khuyến nghị khóa học Machine Learning with Tree-Based Models của DataCamp.
Các khóa học Machine Learning hàng đầu
Khóa học
Khóa học
Lộ trình