
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Een enkele beslisboom is makkelijk te interpreteren maar neigt naar overfitting. Een simpel lineair model generaliseert goed maar mist complexe patronen. Elk type model heeft blinde vlekken die de nauwkeurigheid op real-world data beperken.
Ensemblemethoden pakken dit aan door meerdere modellen te combineren tot één model. In plaats van te vertrouwen op één voorspeller, aggregeren ze voorspellingen van veel modellen zodat individuele fouten elkaar opheffen. Het resultaat is meestal nauwkeuriger dan elk afzonderlijk model.
In deze tutorial leer ik je de verschillen tussen kern-ensemblemethoden en focus ik op de twee populairste algoritmen: Random Forest en XGBoost.
Je leert hoe ze werken, implementeert beide op een multiclass-classificatieprobleem en vergelijkt hun prestaties. Het doel is je een praktisch begrip te geven van wanneer je welke aanpak gebruikt en hoe je ze afstemt voor je eigen projecten.
Als je graag verder hands-on oefent, raad ik de cursus Ensemble Methods in Python aan.
Ensemble learning traint meerdere modellen en combineert hun voorspellingen tot één output. Het idee is simpel: verschillende modellen maken verschillende fouten, dus middelen of stemmen over veel modellen heen heft individuele fouten meestal op.
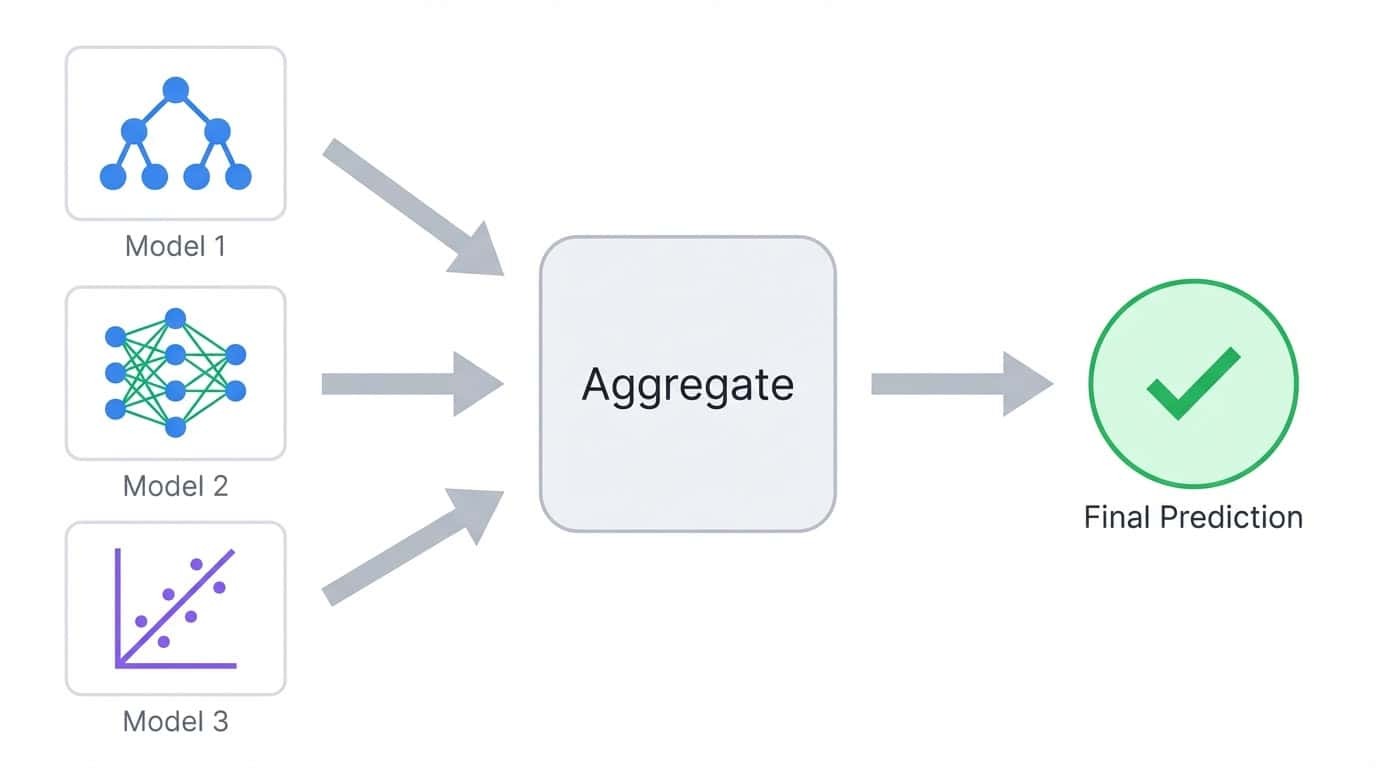
Ensemble learning combineert voorspellingen van meerdere modellen tot één geaggregeerde output
Neem een classificatietaak waarin je vijf beslisbomen traint. Elke boom haalt misschien 80% goede voorspellingen, maar ze falen niet allemaal op dezelfde voorbeelden. Als je hun stemmen aggregeert, heeft de meerderheid het vaak bij het juiste eind, zelfs als één of twee bomen fout zitten. Dit is het kernprincipe achter alle ensemblemethoden.
De modellen binnen een ensemble heten basisleerlingen. Het kunnen allerlei algoritmen zijn, maar beslisbomen zijn het populairst omdat ze snel trainen en van nature diverse voorspellingen opleveren op verschillende datasubsets.
Model fouten komen uit twee bronnen: bias en variantie.
Bias is de fout door het probleem te simplificeren. Een lineair model dat een kromme relatie probeert te vangen, heeft hoge bias omdat het het ware patroon niet kan representeren, hoeveel data je ook geeft. Hoog-biasmodellen doen vergelijkbare voorspellingen op verschillende trainingsets, maar die voorspellingen zitten steeds mis.
Variantie is de fout door te gevoelig te zijn voor trainingsdata. Een diepe beslisboom die de trainingsset uit het hoofd leert, heeft hoge variantie omdat hij ruis samen met signaal oppikt. Als je dezelfde boom op een iets andere steekproef traint, krijg je heel andere voorspellingen. Het model past goed op de trainingsdata, maar stort in op nieuwe data.
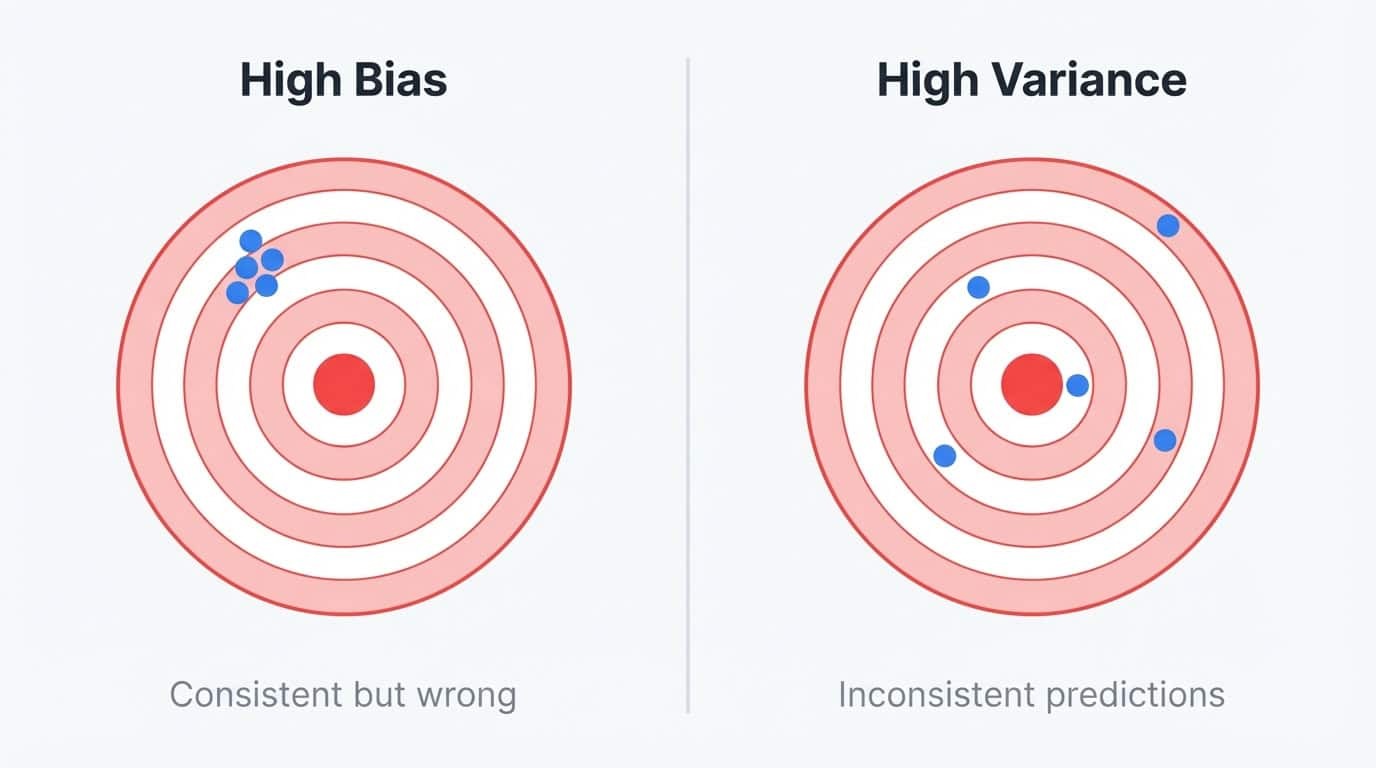
Bias versus variantie geïllustreerd met dartborden: hoge bias toont consistente maar misgerichte voorspellingen, hoge variantie toont verspreide inconsistente voorspellingen
Je kunt het zien als een stabiliteitsprobleem. Hoog-biasmodellen zijn stabiel maar telkens op dezelfde manier fout. Hoog-variantie modellen zijn instabiel en verschillend fout afhankelijk van welke data ze zagen.
Het ideale model is zowel stabiel als accuraat, maar het verlagen van het ene type fout verhoogt vaak het andere.
Beslisbomen zitten stevig in het hoge-variantie kamp. Ze gebruiken hebzuchtig splitsen, wat betekent dat kleine veranderingen in de trainingsdata tot compleet andere boomstructuren kunnen leiden.
Train hetzelfde boomalgoritme op twee willekeurige steekproeven uit dezelfde populatie en je kunt twee modellen krijgen die totaal niet op elkaar lijken. Deze instabiliteit maakt individuele bomen onbetrouwbaar, maar ook perfecte bouwstenen voor ensembles.
Hoge variantie betekent dat er ruimte is voor verbetering via aggregatie. Bomen zijn ook snel te trainen en behandelen niet-lineaire relaties zonder handmatige feature engineering, wat verklaart waarom Random Forest en XGBoost ze beide gebruiken, ondanks dat ze verschillende kanten van het bias-variantieprobleem aanpakken.
Ensemblemethoden doorbreken deze trade-off door meerdere modellen te combineren:
Bagging traint veel modellen parallel op willekeurige datasubsets en gemiddeld hun voorspellingen. Dit verlaagt variantie door de eigenaardigheden van individuele modellen uit te middelen. De intuïtie: als elk model deels onafhankelijke fouten maakt, heffen gemiddelden die fouten op. Hoe meer modellen je combineert, hoe stabieler de uiteindelijke voorspelling. Daarom gebruikt Random Forest standaard 100 bomen in plaats van 10.
Boosting traint modellen sequentieel, waarbij elk nieuw model focust op de fouten van de vorige. Dit verlaagt bias door een sterke leerling op te bouwen uit veel zwakke.
Laten we bekijken hoe bagging en boosting in de praktijk werken.
Bagging staat voor bootstrap aggregating. Het proces heeft drie stappen:
1. Maak meerdere trainingssets door met teruglegging uit de originele data te sampelen (bootstrap-samples)
2. Train onafhankelijk één model op elke bootstrap-sample
3. Combineer voorspellingen door te middelen (regressie) of meerderheid van stemmen (classificatie)
Bootstrap-sampling betekent dat elke trainingsset even groot is als het origineel, maar sommige voorbeelden meerdere keren voorkomen en andere helemaal niet. Gemiddeld bevat elke bootstrap-sample ongeveer 63% van de unieke voorbeelden uit de originele data. De overige 37% heten out-of-bag-samples en kunnen voor validatie worden gebruikt.
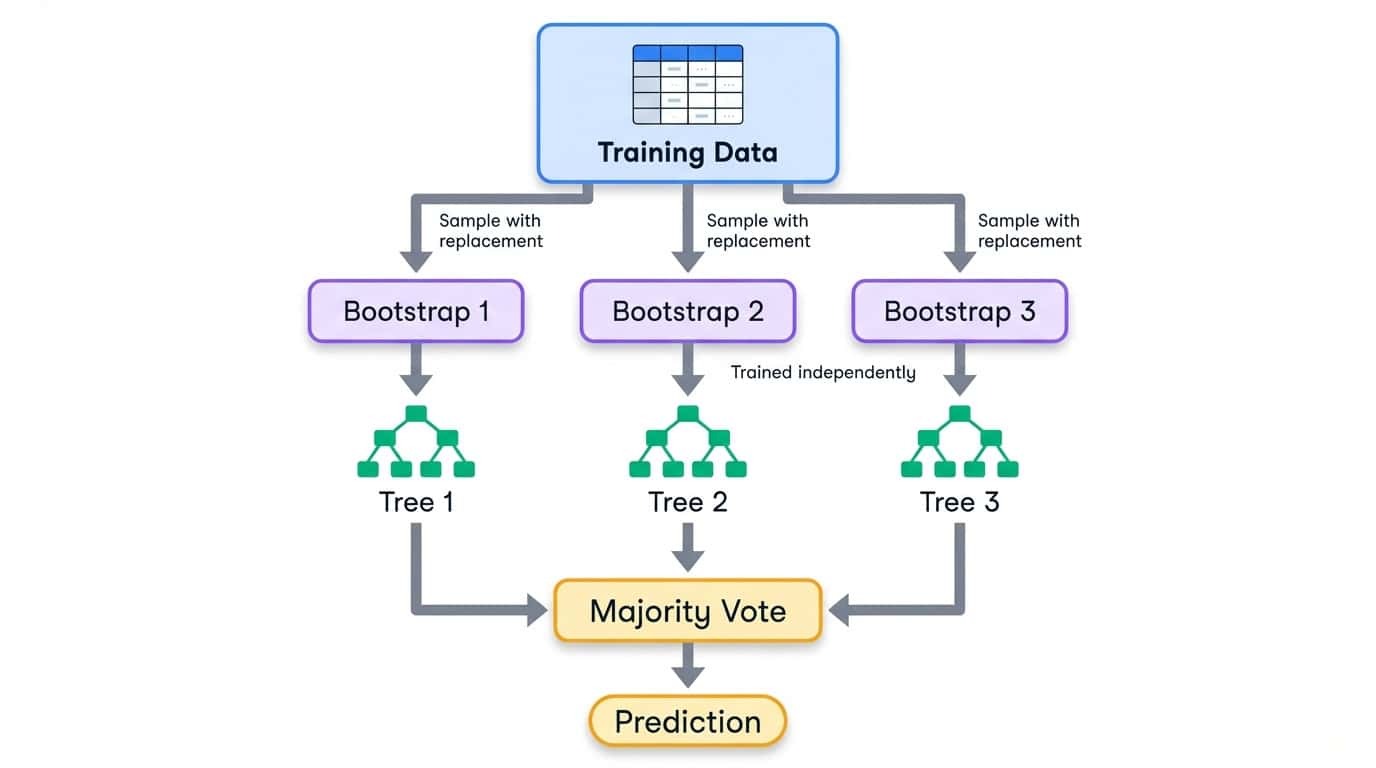
Bagging-workflow waarin trainingsdata worden opgesplitst in bootstrap-samples, elk traint een onafhankelijke beslisboom, en worden vervolgens gecombineerd via meerderheid van stemmen
Omdat elk model een andere doorsnede van de data ziet, ontwikkelen ze verschillende eigenaardigheden. Sommige overfitten op één regio van de feature space, andere op een andere regio. Wanneer je hun voorspellingen aggregeert, spoelen deze individuele fouten weg. De ensemble-voorspelling is stabieler dan elk afzonderlijk model.
Training gebeurt parallel omdat de modellen niet van elkaar afhankelijk zijn. Dit maakt bagging gemakkelijk te schalen over meerdere CPU-cores. Random Forest, dat je later in deze tutorial implementeert, is het meest gebruikte bagging-algoritme. Voor meer theorie zie DataCamp’s gids over bagging in machine learning.
Boosting pakt het anders aan. In plaats van modellen onafhankelijk te trainen, traint het ze na elkaar, waarbij elk nieuw model focust op voorbeelden die eerdere modellen fout hadden.
Het algemene proces ziet er zo uit:
1. Train een zwak model op de volledige trainingsset
2. Identificeer welke voorbeelden het model slecht voorspelde
3. Train het volgende model met extra nadruk op die lastige voorbeelden
4. Herhaal en voeg modellen toe die de resterende fouten corrigeren
5. Combineer alle modellen in een gewogen som, waarbij beter presterende modellen hogere gewichten krijgen
De term "zwakke leerling" betekent een model dat slechts iets beter presteert dan gokken. Decision stumps (bomen met één splitsing) zijn een veelgemaakte keuze. Op zichzelf is zo’n stump bijna waardeloos. Maar boosting stapelt er honderden, waarbij elk de fouten van de vorige een stukje wegwerkt. Het uiteindelijke ensemble is een sterke leerling gebouwd uit veel zwakke bijdragen.
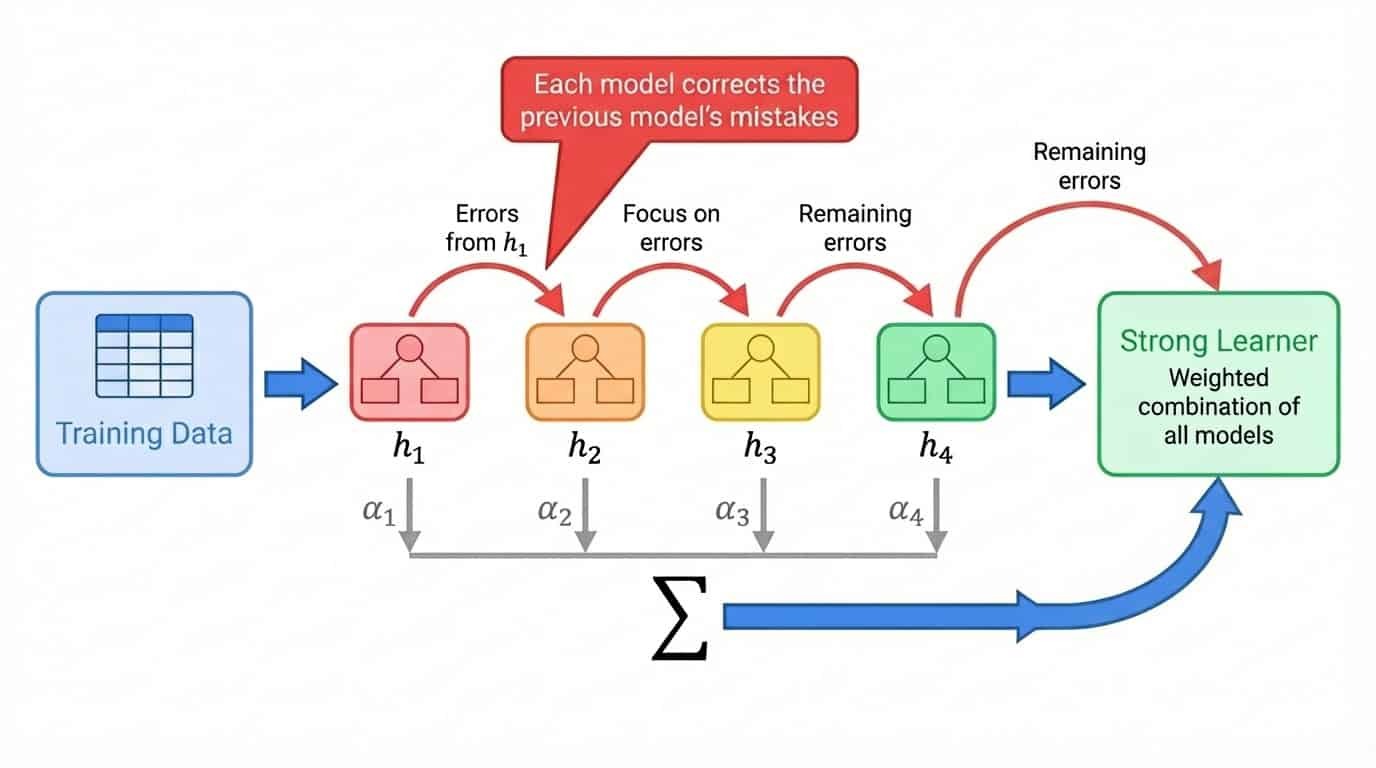
Boosting-workflow met sequentiële modeltraining waarbij elk model de fouten van het vorige corrigeert, gecombineerd in een gewogen som
In tegenstelling tot bagging is boosting inherent sequentieel. Je kunt model 47 niet trainen voordat je weet met welke voorbeelden modellen 1 t/m 46 worstelden. Dit maakt boosting trager om te trainen, maar vaak nauwkeuriger omdat elk model specifiek is ontworpen om zwaktes in het ensemble te repareren.
XGBoost, dat je later in deze tutorial implementeert, is een gradient boosting-algoritme dat dé keuze is geworden voor tabulaire data. Ik raad de introductie tot boosting-gids aan, die de wiskunde uitgebreider behandelt als je dieper wilt gaan.
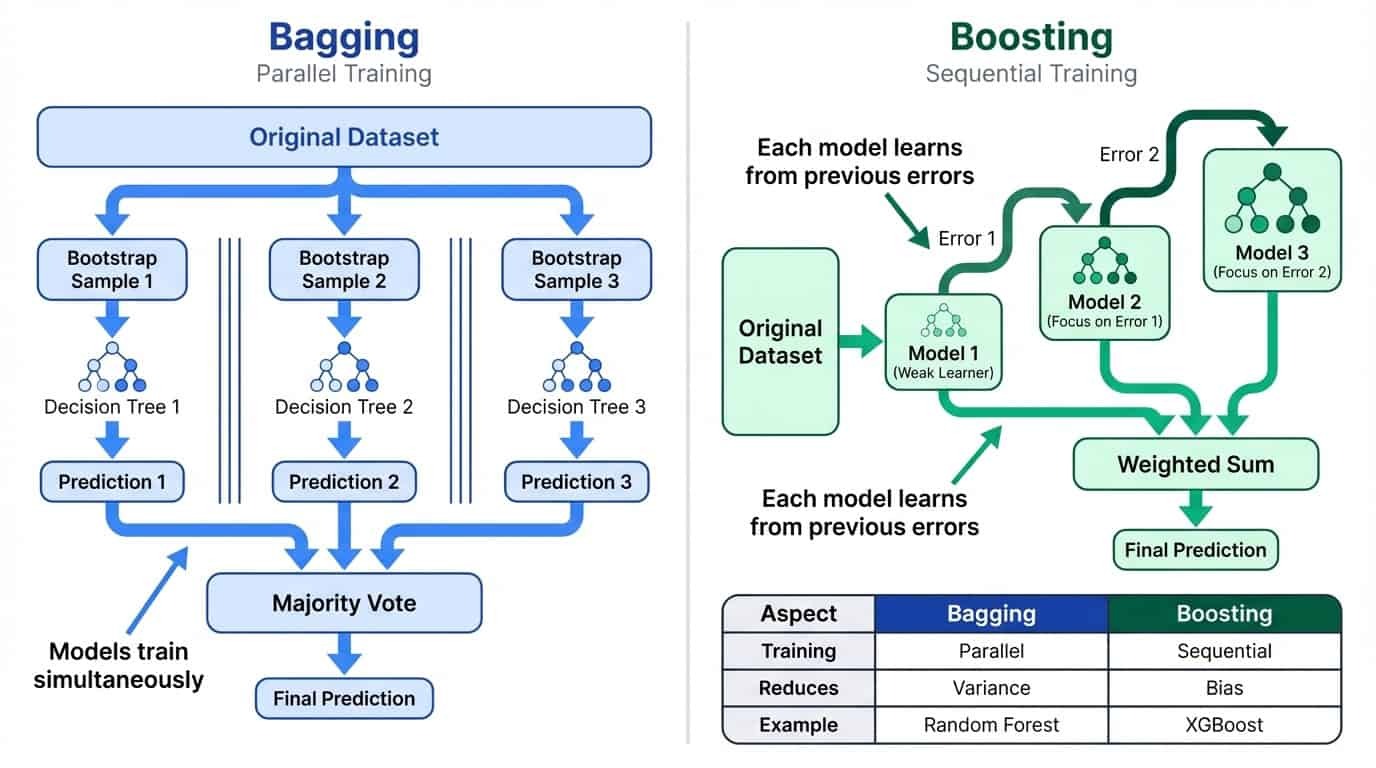
Vergelijking naast elkaar van bagging en boosting: bagging gebruikt parallel trainen om variantie te verlagen, boosting gebruikt sequentieel trainen om bias te verlagen
Bagging en boosting zijn de meest gebruikte ensemble-strategieën, maar er zijn meer opties. Voor we inzoomen op Random Forest en XGBoost is het goed om te weten wat er nog meer bestaat.
De simpelste manier om modellen te combineren is ze te laten stemmen. Bij hard voting doet elk model een voorspelling en de klasse met de meeste stemmen wint. Heb je een logistische regressie, een support-vector machine en een beslisboom, en twee voorspellen klasse A terwijl één klasse B voorspelt, dan geeft het ensemble klasse A.
Soft voting gaat een stap verder door de voorspelde waarschijnlijkheden te middelen in plaats van discrete stemmen te tellen. Een model dat klasse A met 90% zekerheid voorspelt, draagt meer bij dan een model dat A met 51% voorspelt. Dit presteert meestal beter omdat het vangt hoe zeker elk model is.
Je kunt ook gewichten toekennen om sterkere modellen meer invloed te geven. Als je logistische regressie consequent beter presteert op validatiedata, kun je die op 2x wegen en de rest op 1x houden.
Stemmen werkt het best als je modellen combineert die het probleem verschillend benaderen. Een lineair model, een boom-gebaseerd model en een nearest-neighbor model hebben elk andere blinde vlekken. Hun gecombineerde voorspelling verslaat vaak elk individueel model, zelfs als geen enkel model heel sterk is. scikit-learn biedt VotingClassifier en VotingRegressor voor dit doel.
Stacking gaat een niveau dieper. In plaats van voorspellingen te middelen, train je een tweede model (de meta-learner) om ze te combineren. Het proces: train meerdere basismodellen, verzamel hun voorspellingen op een validatieset en train dan de meta-learner om die voorspellingen aan de juiste labels te koppelen. De meta-learner leert welk basismodel te vertrouwen is in welke situaties.
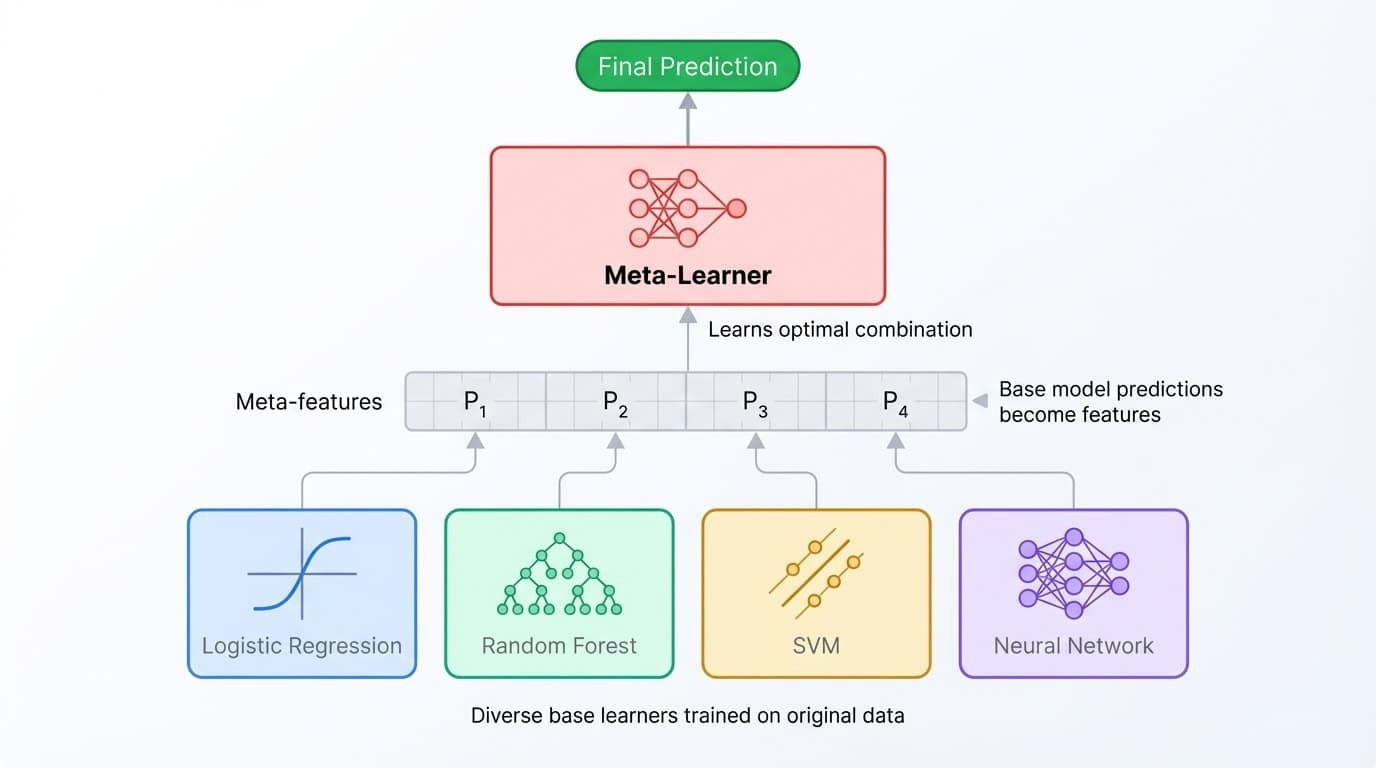
Stacking-ensemblearchitectuur met diverse basismodellen die voorspellingen doorgeven aan een meta-learner die ze combineert tot de uiteindelijke output
Blending is een eenvoudigere variant die één holdout-set gebruikt in plaats van cross-validatiefolds. Het is sneller te implementeren maar verspilt wat trainingsdata en is gevoeliger voor overfitting op de holdout.
Beide technieken kunnen extra nauwkeurigheid opleveren, maar de winst is vaak klein (0,1–0,5% verbetering) in verhouding tot de extra complexiteit. Gestackte ensembles zijn lastiger te debuggen, trager te trainen en moeilijker uit te leggen aan stakeholders. Ze schitteren in Kaggle-wedstrijden waar elke decimal telt en traintijd onbeperkt is, maar in productie loont de moeite zelden.
Interessant genoeg gebruiken de meeste gestackte ensembles toch Random Forest en XGBoost als basismodellen. Deze twee algoritmen zijn zo sterk dat stacking vaak slechts een omslachtige manier is om hun voorspellingen te middelen.
Deze tutorial blijft bij Random Forest (bagging) en XGBoost (boosting) omdat ze het overgrote deel van real-world tabulaire problemen afdekken. Ze zijn eenvoudiger te implementeren, makkelijker te tunen en onderhoudsvriendelijker dan meerlaagse gestackte ensembles.
Wil je dieper in stemmen en stacking duiken, bekijk dan DataCamp’s Ensemble Methods in Python-cursus. Voor nu: aan de slag met de dataset.
Deze tutorial gebruikt de Dry Beans-dataset van de UCI Machine Learning Repository. Onderzoekers Köklü en Özkan (2020) fotografeerden 13.611 gedroogde bonen uit zeven variëteiten en extraheerden 16 geometrische features per afbeelding, waaronder oppervlakte, omtrek, aslengtes en vormfactoren. De taak is om elke boon op basis van deze metingen naar variëteit te classificeren.
De dataset werkt goed voor deze tutorial omdat het een schone multiclass-taak is met uitsluitend numerieke features. Geen missende waarden, geen categorische encodering, geen tekstvoorbewerking. Je kunt je volledig focussen op de ensemblemethoden.
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f("Features shape: {X.shape}"))
 print(f("Target classes: {pd.Series(y).nunique()}"))
Features shape: (13611, 16)
Target classes: 7X.head()|
Area |
Perimeter |
MajorAxisLength |
MinorAxisLength |
AspectRatio |
Eccentricity |
ConvexArea |
EquivDiameter |
Extent |
Solidity |
Roundness |
Compactness |
ShapeFactor1 |
ShapeFactor2 |
ShapeFactor3 |
|
28395 |
610.291 |
208.178 |
173.889 |
1.197 |
0.550 |
28715 |
190.141 |
0.764 |
0.989 |
0.958 |
0.913 |
0.007 |
0.003 |
0.834 |
|
28734 |
638.018 |
200.525 |
182.734 |
1.097 |
0.412 |
29172 |
191.273 |
0.784 |
0.985 |
0.887 |
0.954 |
0.007 |
0.004 |
0.910 |
|
29380 |
624.110 |
212.826 |
175.931 |
1.210 |
0.563 |
29690 |
193.411 |
0.778 |
0.990 |
0.948 |
0.909 |
0.007 |
0.003 |
0.826 |
|
30008 |
645.884 |
210.558 |
182.517 |
1.154 |
0.499 |
30724 |
195.467 |
0.783 |
0.977 |
0.904 |
0.928 |
0.007 |
0.003 |
0.862 |
|
30140 |
620.134 |
201.848 |
190.279 |
1.061 |
0.334 |
30417 |
195.897 |
0.773 |
0.991 |
0.985 |
0.971 |
0.007 |
0.004 |
0.942 |
pd.Series(y).value_counts()DERMASON 3546
SIRA 2636
SEKER 2027
HOROZ 1928
CALI 1630
BARBUNYA 1322
BOMBAY 522De klassen zijn redelijk in balans, met Dermason als meest voorkomende en Bombay als minst voorkomende. Een gestratificeerde splitsing behoudt deze verhoudingen in zowel train- als testset:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f("Training set: {X_train.shape[0]} samples"))
 print(f("Test set: {X_test.shape[0]} samples"))
Training set: 10888 samples
Test set: 2723 samplesNu de data klaar is, is het tijd om het eerste ensemblemodel te trainen. Deze sectie legt uit hoe Random Forest onder de motorkap werkt, doorloopt training en evaluatie en laat zien hoe je hyperparameters afstemt.
Random Forest past bagging toe op beslisbomen met een extra twist. Elke boom wordt getraind op een bootstrap-sample van de data (zoals eerder besproken), maar bij elke splitsing overweegt het algoritme slechts een willekeurige subset van features in plaats van allemaal.
Deze feature-randomisatie voorkomt dat bomen te veel op elkaar gaan lijken. Zonder dat zouden dezelfde sterke voorspellers elke boom domineren en zou het ensemble uit kopieën van bijna identieke modellen bestaan.
Door elke splitsing te dwingen te kiezen uit een beperkte set features, creëert het algoritme diverse bomen die verschillende fouten maken. Wanneer deze bomen samen stemmen, heffen hun individuele fouten elkaar op.
Voor classificatie overweegt scikit-learn standaard de vierkantswortel van het totaal aantal features bij elke splitsing. Met 16 features in de Dry Beans-dataset evalueert elke splitsing dus slechts 4 willekeurig gekozen features. Het resultaat is een ensemble van gedecorreleerde bomen dat beter generaliseert dan een enkele boom ooit kan.
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f("Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}"))
 print(classification_report(y_test, y_pred_rf))
Accuracy: 0.9199
precision recall f1-score support
BARBUNYA 0.94 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.92 0.91 709
HOROZ 0.96 0.95 0.96 386
SEKER 0.94 0.96 0.95 406
SIRA 0.86 0.85 0.86 527
accuracy 0.92 2723
macro avg 0.93 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Deze code maakt een bos van 100 beslisbomen, traint ze op de bootstrap-samples en genereert voorspellingen via meerderheid van stemmen. De parameter random_state zet de random seed vast zodat resultaten reproduceerbaar zijn.
Het classificatierapport splitst prestaties per klasse uit. Precision meet hoeveel voorspelde positieven correct waren, recall meet hoeveel werkelijke positieven gevonden zijn, en de F1-score is hun harmonisch gemiddelde. Bombay-bonen worden perfect geclassificeerd (waarschijnlijk omdat ze fysiek onderscheiden zijn), terwijl Sira-bonen het lastigst te onderscheiden blijven.
Een voordeel van Random Forest is interpreteerbare feature-importances. Het algoritme houdt bij hoeveel elke feature de onzuiverheid (standaard de Gini-index) reduceert over alle bomen heen, wat je een ingebouwde maat geeft voor welke variabelen het meest tellen:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()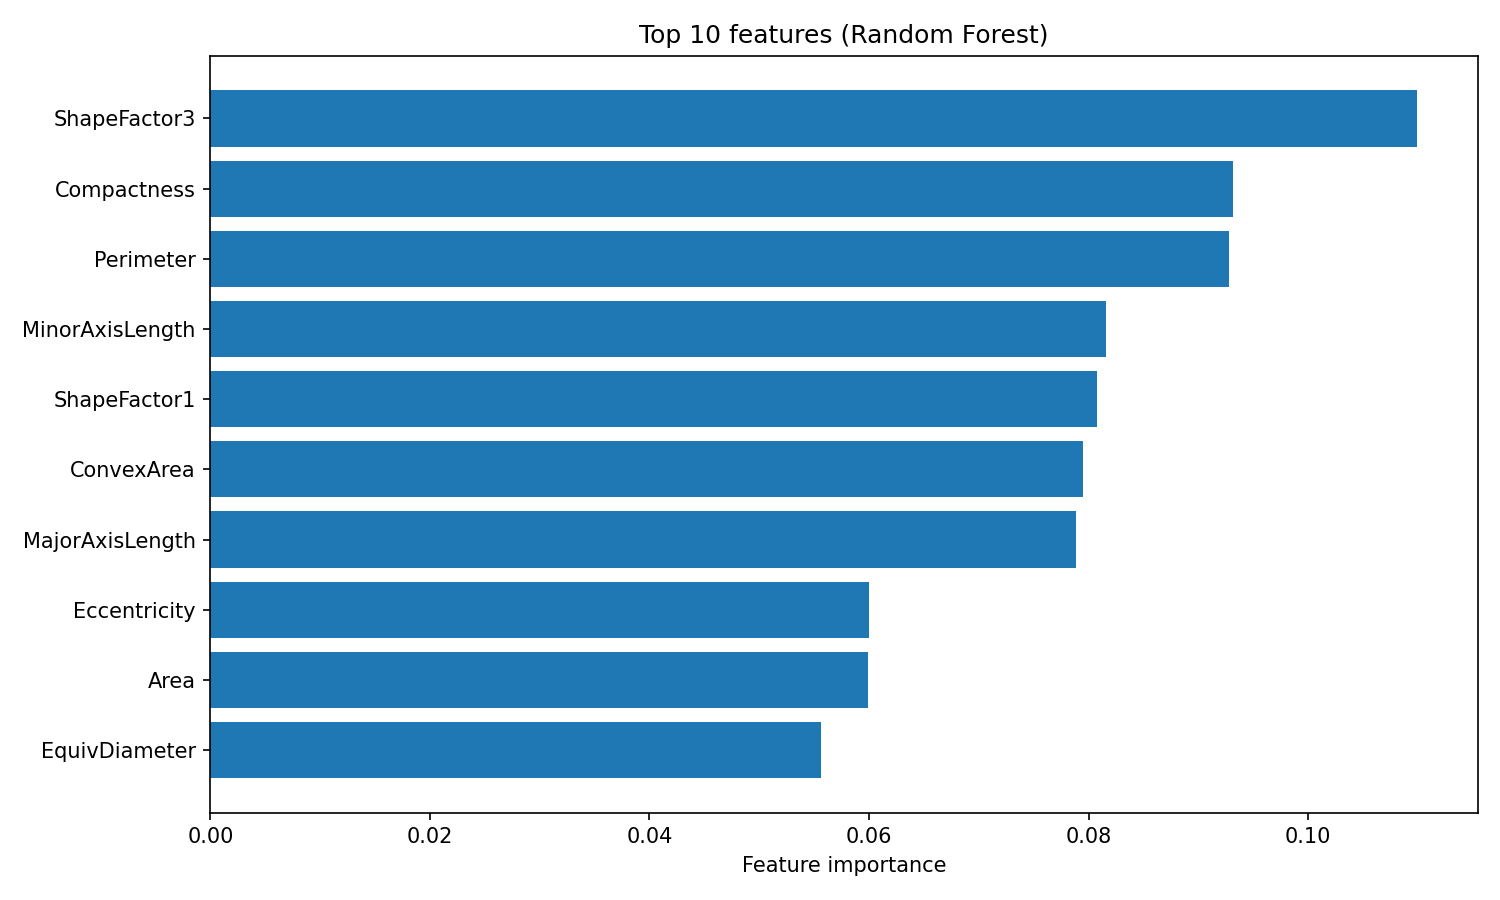
Feature-importance van Random Forest
Het attribuut feature_importances_ geeft een array van scores die optellen tot 1, waarbij hogere waarden features aangeven die meer bijdroegen aan splitsingsbeslissingen. ShapeFactor3 en Compactness dragen het meest bij aan classificatie, gevolgd door geometrische metingen zoals Perimeter en MinorAxisLength. Deze vormgebaseerde features vangen de visuele verschillen tussen bonenvariëteiten die de oorspronkelijke onderzoekers wilden meten.
Random Forest heeft drie hoofdhyperparameters die de moeite van het tunen waard zijn:
n_estimators: Het aantal bomen in het bos. Meer bomen geven stabielere voorspellingen maar kosten meer traintijd. Het rendement vlakt voor de meeste datasets af boven ~200 bomen.max_depth: De maximale diepte van elke boom. De default (None) laat bomen groeien tot bladeren puur zijn of minder dan 2 samples bevatten. Lagere waarden kunnen overfitting voorkomen.max_features: Het aantal features dat bij elke splitsing wordt beschouwd. De default "sqrt" werkt goed voor classificatie. "log2" verhoogt diversiteit ten koste van de nauwkeurigheid van individuele bomen.Een snelle grid search over deze parameters:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f("Best params: {grid_search.best_params_}"))
 print(f("Best CV accuracy: {grid_search.best_score_:.4f}"))
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
Best CV accuracy: 0.9244GridSearchCV probeert alle combinaties in het raster en evalueert elke met cross-validatie. Het argument cv=3 splitst de trainingsdata in 3 folds, traint op 2 en valideert op 1, en roteert alle combinaties. De vlag n_jobs=-1 paralleliseert de zoekopdracht over alle beschikbare CPU-cores.
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f("Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}"))
Tuned test accuracy: 0.9214Tunen tilt de nauwkeurigheid van 92,0% naar 92,1%, een bescheiden verbetering. De beste configuratie gebruikt de defaults voor max_depth en max_features, met 200 bomen in plaats van 100. Random Forest presteert vaak al goed out-of-the-box, wat een groot pluspunt is. Voor meer verdieping in Random Forest en zijn parameters, zie DataCamp’s Random Forest-classificatietutorial.
XGBoost (Extreme Gradient Boosting) bewandelt een andere weg naar nauwkeurigheid dan Random Forest. Waar Random Forest variantie verlaagt door onafhankelijke bomen te middelen, verlaagt XGBoost bias door bomen sequentieel te trainen, waarbij elke nieuwe boom de fouten van het ensemble tot dan toe corrigeert. Deze sectie behandelt hoe gradient boosting werkt, wat XGBoost bijzonder maakt en hoe je het traint en tuunt op de Dry Beans-dataset.
Gradient boosting bouwt een ensemble boom voor boom op. De eerste boom doet voorspellingen op het oorspronkelijke target. De tweede boom traint niet op het oorspronkelijke target, maar op de residuele fouten van de eerste boom. De derde boom past op de residuen die overblijven na toevoeging van de voorspellingen van de tweede boom. Dit gaat honderden rondes door, waarbij elke nieuwe boom de resterende fout verder verkleint.
De term "gradient" verwijst naar hoe het algoritme beslist wat te fitten. Bij elke stap berekent het de gradiënt van de verliesfunctie met betrekking tot de huidige voorspellingen. Voor regressie met kwadratische fout is die gradiënt simpelweg het residu (echt min voorspeld). Voor classificatie is de wiskunde ingewikkelder, maar de intuïtie is hetzelfde: elke boom wordt getraind om voorspellingen te verschuiven in de richting die de loss het meest verlaagt.
Een learning rate-parameter verkleint de bijdrage van elke boom voordat die aan het ensemble wordt toegevoegd. Met een learning rate van 0,1 wordt bijvoorbeeld slechts 10% van elke boomvoorspelling toegevoegd. Dit dwingt het algoritme kleinere stappen te nemen en verbetert doorgaans de generalisatie. De trade-off is dat je meer bomen nodig hebt om hetzelfde fitniveau te bereiken. Kleine learning rate plus veel bomen levert vaak betere resultaten op dan een grote learning rate met weinig bomen.
XGBoost is één van meerdere gradient boosting-implementaties, naast LightGBM en CatBoost. Het werd populair omdat het verschillende verbeteringen toevoegde boven eerdere implementaties zoals scikit-learn’s GradientBoostingClassifier.
De belangrijkste toevoegingen zijn:
Deze features maken XGBoost zowel sneller als beter bestand tegen overfitting dan vanilla gradient boosting. De regularisatieparameters geven je directe controle over modelcomplexiteit, handig bij ruisige of hoge-dimensionale data.
XGBoost verwacht numerieke klasselabels in plaats van strings, dus de eerste stap is het encoden van de targetvariabele:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f("Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}"))
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))
Accuracy: 0.9232
precision recall f1-score support
BARBUNYA 0.95 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.93 0.91 709
HOROZ 0.96 0.96 0.96 386
SEKER 0.95 0.96 0.95 406
SIRA 0.87 0.86 0.87 527
accuracy 0.92 2723
macro avg 0.94 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723De LabelEncoder zet klassennamen om naar gehele getallen (0 t/m 6) en bewaart de mapping, zodat je voorspellingen terug naar klassennamen kunt converteren. Het argument eval_metric="mlogloss" vertelt XGBoost om multiclass log loss te gebruiken voor interne evaluatie.
Out-of-the-box haalt XGBoost 92,3% nauwkeurigheid, iets hoger dan de 92,0% van Random Forest. Het patroon per klasse is vergelijkbaar: Bombay-bonen zijn perfect, terwijl Sira-bonen het lastigst blijven.
XGBoost levert feature-importances op basis van gain, wat de gemiddelde verbetering in nauwkeurigheid meet die elke feature bijdraagt over alle splitsingen waar die is gebruikt:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()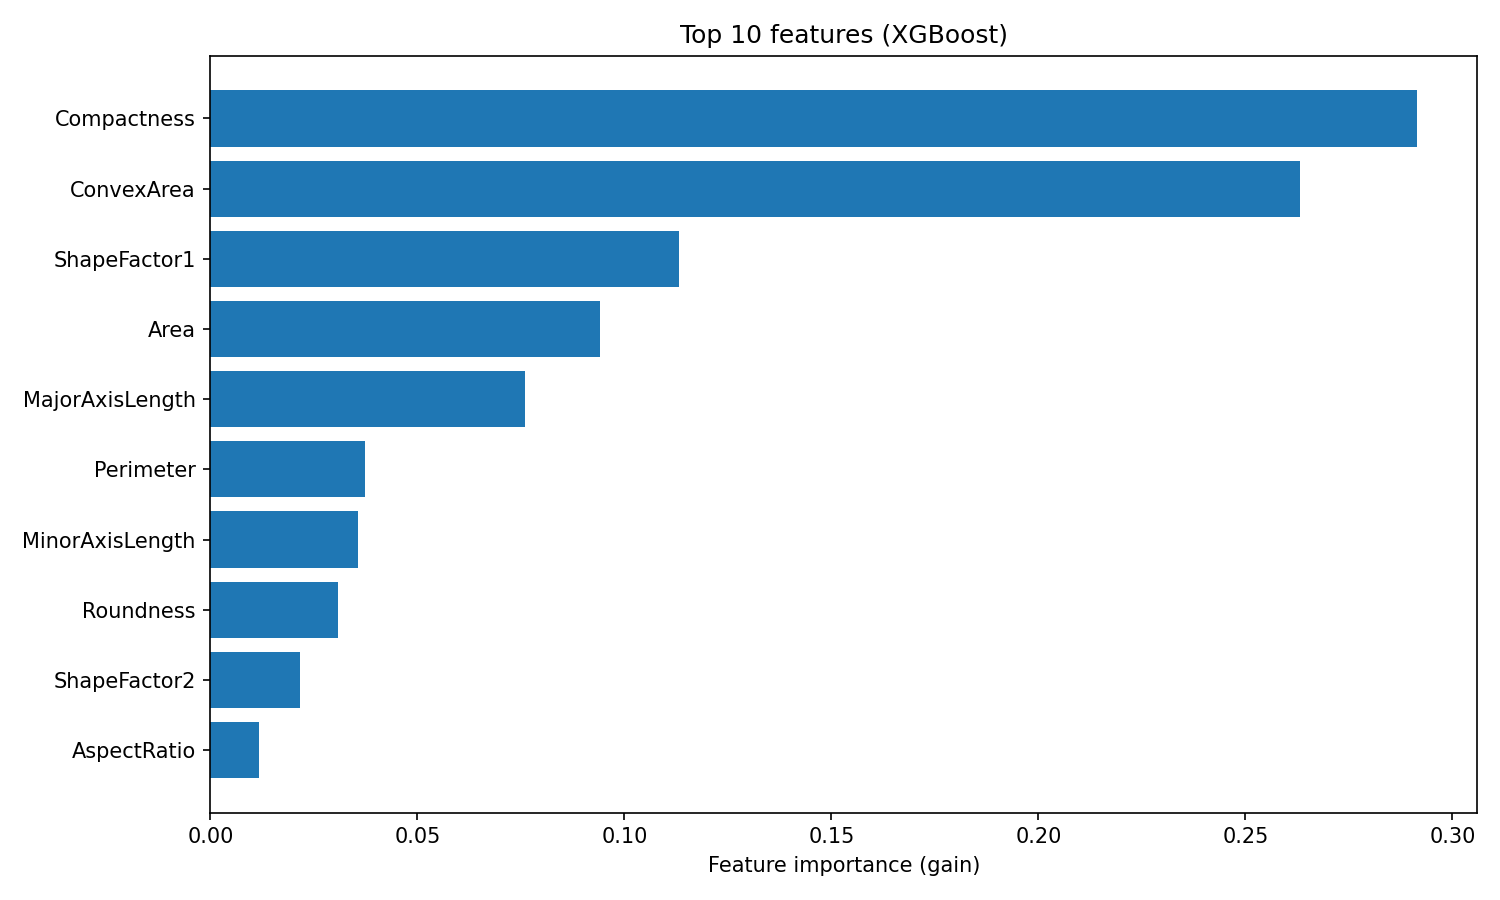
Feature-importance van XGBoost
De rangorde verschilt van Random Forest. XGBoost zet Compactness en ConvexArea bovenaan, terwijl Random Forest ShapeFactor3 als eerste rangschikte.
Dit verschil weerspiegelt hoe de twee algoritmen features gebruiken: Random Forest meet hoe vaak een feature onzuiverheid reduceert over veel onafhankelijke bomen, terwijl XGBoost meet hoeveel nauwkeurigheid elke feature toevoegt bij het corrigeren van residuen. Beide ranglijsten zijn valide; ze vangen gewoon verschillende aspecten van feature-nuttigheid.
XGBoost heeft meer draaiknoppen dan Random Forest, wat zijn grotere flexibiliteit weerspiegelt. De belangrijkste parameters om te overwegen zijn:
learning_rate: Verkleining toegepast op elke boom (default 0,3). Lagere waarden vereisen meer bomen maar generaliseren vaak beter.max_depth: Maximale boomdiepte (default 6). Ondiepe bomen verminderen overfitting. XGBoost’s default is conservatiever dan de onbeperkte diepte van Random Forest.n_estimators: Aantal boosting-rondes. Meer rondes maken fijnere correcties mogelijk, vooral met een lage learning rate.reg_alpha: L1-regularisatie op bladgewichten (default 0). Hogere waarden duwen gewichten naar nul en creëren spaarzamere modellen.reg_lambda: L2-regularisatie op bladgewichten (default 1). Hogere waarden bestraffen grote gewichten en maken voorspellingen gladder.Een grid search over een paar van deze parameters:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f("Best params: {grid_search_xgb.best_params_}"))
 print(f("Best CV accuracy: {grid_search_xgb.best_score_:.4f}"))
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
Best CV accuracy: 0.9284y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
print(f("Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}"))Tuned test accuracy: 0.9251De beste configuratie gebruikt ondiepere bomen (max_depth=4), meer regularisatie (reg_lambda=5) en tweemaal zoveel boosting-rondes (n_estimators=200). Dit patroon is gebruikelijk: XGBoost presteert vaak het best met zwakkere individuele bomen gecombineerd via meer boosting-rondes. Tunen verhoogt de testnauwkeurigheid van 92,3% naar 92,5%.
Voor meer verdieping in XGBoost’s parameters en geavanceerde features zoals early stopping, zie DataCamp’s XGBoost in Python-tutorial.
Met beide modellen getraind en getuned, zo vergelijken ze op de Dry Beans-dataset.
|
Metric |
Random Forest |
XGBoost |
|
Nauwkeurigheid (default) |
92,0% |
92,3% |
|
Nauwkeurigheid (getuned) |
92,1% |
92,5% |
|
Macro precision |
0,93 |
0,94 |
|
Macro recall |
0,93 |
0,93 |
|
Macro F1 |
0,93 |
0,93 |
|
Traintijd |
Snel |
Gemiddeld |
|
Tune-inspanning |
Laag |
Gemiddeld |
De nauwkeurigheidscijfers zijn in het voordeel van XGBoost, maar het gat krimpt bij macro-F1. Beide modellen halen 0,93, wat betekent dat ze over alle zeven bonenklassen even goed presteren, in plaats van vooral op de grootste klasse te excelleren.
Prestaties per klasse vertellen hetzelfde verhaal:
|
Klasse |
Random Forest F1 |
XGBoost F1 |
|
Bombay |
1,00 |
1,00 |
|
Horoz |
0,96 |
0,96 |
|
Seker |
0,95 |
0,95 |
|
Cali |
0,94 |
0,94 |
|
Barbunya |
0,92 |
0,92 |
|
Dermason |
0,91 |
0,91 |
|
Sira |
0,86 |
0,87 |
Beide modellen rangschikken klassen identiek. Bombay-bonen zijn het gemakkelijkst te classificeren (ze zijn het grootst en fysiek het meest onderscheidend), terwijl Sira-bonen het lastigst zijn (hun vorm overlapt met Dermason en Seker). XGBoost’s enige voordeel per klasse is 1 punt F1-winst op Sira.
Het praktische verschil tussen deze modellen is niet de nauwkeurigheid, maar hoeveel tijd je wilt besteden aan tunen. Random Forest zat binnen 0,4% van XGBoost met standaardparameters. XGBoost had een grid search over learning rate, boomdiepte en regularisatie nodig om voor te blijven.
|
Scenario |
Aanbeveling |
|
Snelle baseline |
Random Forest (sterke defaults, minimale tuning) |
|
Maximale nauwkeurigheid |
XGBoost (hoger plafond met goede tuning) |
|
Beperkte tijd om te tunen |
Random Forest (minder gevoelig voor hyperparameters) |
|
Zeer grote datasets |
XGBoost (betere geheugenefficiëntie, GPU-ondersteuning) |
|
Interpretatie nodig |
Beide (beiden bieden feature-importances) |
|
Productie-deployment |
Beide (beiden hebben volwassen, stabiele libraries) |
Een redelijke workflow: begin met Random Forest om een baseline te zetten, probeer dan XGBoost als je extra prestaties nodig hebt. De beste keuze hangt af van je constraints, niet van een universele algoritmeranglijst.
In deze tutorial heb ik laten zien hoe bagging en boosting zwakke modellen sterk maken. Bagging traint modellen parallel en middelt hun fouten uit. Boosting traint ze na elkaar, waarbij elk model repareert wat het vorige fout deed.
Random Forest en XGBoost zijn de go-to implementaties. Op de Dry Beans-dataset kwamen beide rond 92% nauwkeurigheid uit. XGBoost liep na tuning iets uit, maar Random Forest haalde dat bijna zonder configuratie. Dat is de echte trade-off: Random Forest is onderhoudsarm, XGBoost beloont extra moeite.
Begin je aan een nieuw probleem, fit dan eerst een Random Forest. Het is een solide baseline die je in minuten opzet. Moet de nauwkeurigheid hoger en heb je tijd om te tunen, stap dan over op XGBoost.
Voor meer hands-on oefening met deze algoritmen raad ik DataCamp’s Machine Learning with Tree-Based Models-cursus aan.
Topcursussen in machine learning
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


