
Kursus
Metode Ensemble di Python
4 jam
13.1K
Sebuah pohon keputusan tunggal mudah diinterpretasikan tetapi cenderung overfit. Model linier sederhana melakukan generalisasi dengan baik namun melewatkan pola yang kompleks. Setiap tipe model memiliki titik buta yang membatasi akurasinya pada data dunia nyata.
Metode ensemble mengatasi hal ini dengan menggabungkan banyak model menjadi satu model. Alih-alih mengandalkan satu prediktor, metode ini mengagregasikan prediksi dari banyak model sehingga kesalahan individual saling meniadakan. Hasilnya biasanya lebih akurat dibandingkan model tunggal mana pun.
Dalam tutorial ini, saya akan menjelaskan perbedaan antara metode ensemble inti dan berfokus pada dua algoritma ensemble paling populer: Random Forest dan XGBoost.
Anda akan mempelajari cara kerja masing-masing, mengimplementasikan keduanya pada masalah klasifikasi multikelas, dan membandingkan kinerjanya. Tujuannya adalah memberi Anda pemahaman praktis tentang kapan menggunakan setiap pendekatan dan cara men-tuning-nya untuk proyek Anda sendiri.
Jika Anda mencari latihan praktis lebih lanjut, saya sarankan melihat kursus Ensemble Methods in Python.
Ensemble learning melatih banyak model dan menggabungkan prediksinya menjadi satu keluaran. Idenya sederhana: model yang berbeda membuat kesalahan yang berbeda, sehingga merata-ratakan atau melakukan voting di banyak model cenderung meniadakan kesalahan individual.
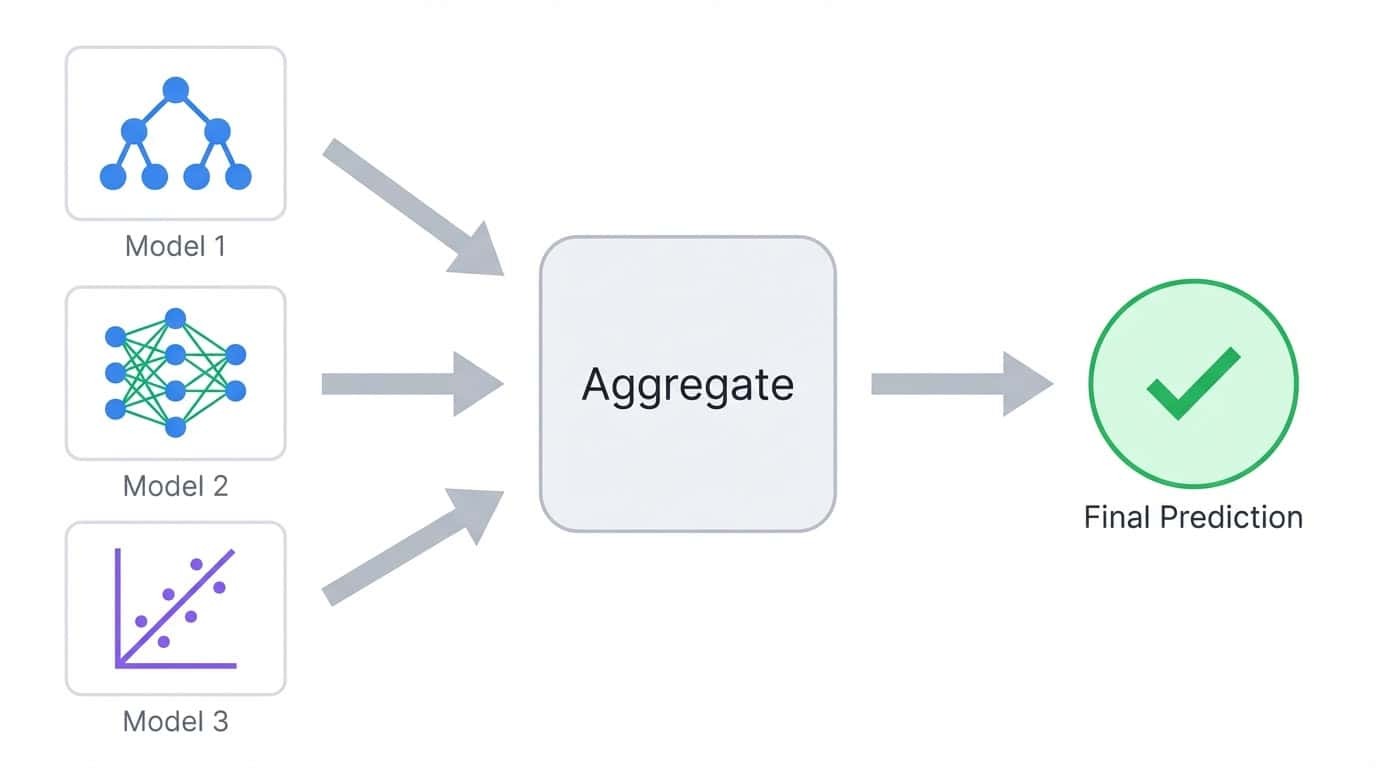
Ensemble learning menggabungkan prediksi dari banyak model menjadi satu keluaran teragregasi
Pertimbangkan tugas klasifikasi di mana Anda melatih lima pohon keputusan. Masing-masing pohon mungkin benar 80% dari prediksi, tetapi mereka tidak semuanya gagal pada contoh yang sama. Ketika Anda mengagregasikan suara mereka, mayoritas sering kali benar bahkan ketika satu atau dua pohon salah. Ini adalah prinsip inti di balik semua metode ensemble.
Model dalam sebuah ensemble disebut base learner. Mereka bisa berupa algoritma apa pun, tetapi pohon keputusan adalah pilihan paling umum karena cepat dilatih dan secara alami menghasilkan prediksi beragam saat diberi subset data yang berbeda.
Kesalahan model berasal dari dua sumber: bias dan varians.
Bias adalah kesalahan akibat menyederhanakan masalah secara berlebihan. Model linier yang mencoba menyesuaikan hubungan melengkung memiliki bias tinggi karena tidak dapat merepresentasikan pola sebenarnya, tidak peduli seberapa banyak data yang Anda berikan. Model dengan bias tinggi menghasilkan prediksi serupa di berbagai set pelatihan, tetapi prediksi tersebut selalu meleset dari sasaran.
Varians adalah kesalahan akibat terlalu sensitif terhadap data pelatihan. Pohon keputusan yang dalam dan menghafal data latih memiliki varians tinggi karena menangkap noise sekaligus sinyal. Jika Anda melatih ulang pohon yang sama pada sampel yang sedikit berbeda, Anda akan mendapatkan prediksi yang sangat berbeda. Model cocok dengan data latih dengan baik, tetapi runtuh pada data baru.
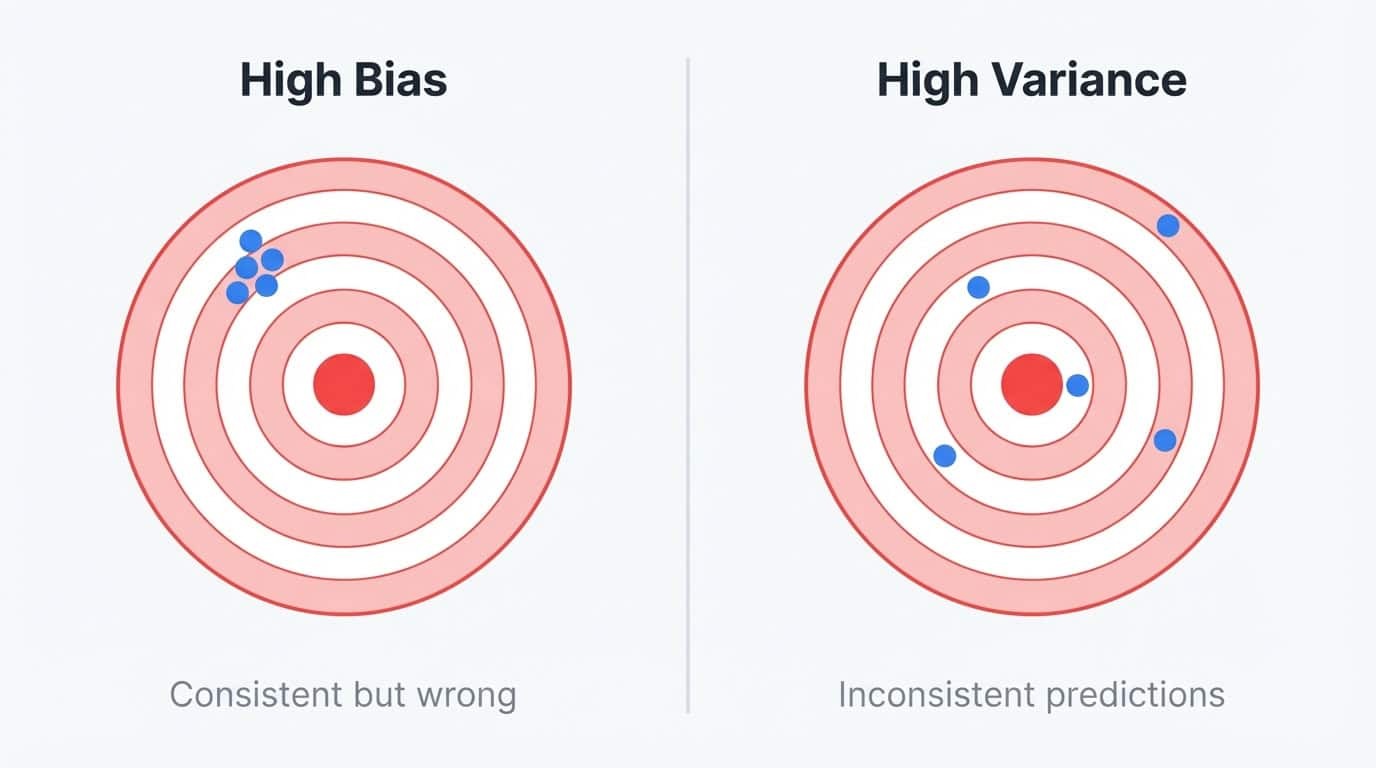
Bias vs varians digambarkan dengan papan panah: bias tinggi menunjukkan prediksi konsisten namun meleset dari sasaran, varians tinggi menunjukkan prediksi tersebar dan tidak konsisten
Anda dapat menganggapnya sebagai masalah stabilitas. Model dengan bias tinggi stabil tetapi salah dengan cara yang sama setiap saat. Model dengan varians tinggi tidak stabil dan salah dengan cara yang berbeda tergantung pada data yang kebetulan mereka lihat.
Model ideal bersifat stabil sekaligus akurat, tetapi mengurangi satu jenis kesalahan sering kali meningkatkan yang lain.
Pohon keputusan jelas berada di kubu varians tinggi. Mereka menggunakan pemisahan greedy, artinya perubahan kecil pada data latih dapat menghasilkan struktur pohon yang sama sekali berbeda.
Latih algoritma pohon yang sama pada dua sampel acak dari populasi yang sama, dan Anda mungkin mendapatkan dua model yang terlihat sangat berbeda. Ketidakstabilan ini membuat pohon individual tidak andal, tetapi juga menjadikannya blok bangunan yang sempurna untuk ensemble.
Varians yang tinggi berarti ada ruang untuk perbaikan melalui agregasi. Pohon juga cepat dilatih dan menangani hubungan non-linier tanpa rekayasa fitur manual, itulah sebabnya Random Forest dan XGBoost sama-sama menggunakannya meski menyerang bagian berbeda dari masalah bias-varians.
Metode ensemble mematahkan trade-off ini dengan menggabungkan beberapa model:
Bagging melatih banyak model secara paralel pada subset data acak, lalu merata-ratakan prediksinya. Ini mengurangi varians dengan menghaluskan kekhasan tiap model. Intuisinya sederhana: jika setiap model membuat kesalahan yang agak independen, perataan cenderung meniadakan kesalahan tersebut. Semakin banyak model yang Anda gabungkan, semakin stabil prediksi akhirnya. Inilah mengapa Random Forest menggunakan default 100 pohon alih-alih 10.
Boosting melatih model secara berurutan, di mana setiap model baru berfokus pada kesalahan model sebelumnya. Ini mengurangi bias dengan membangun learner yang kuat dari banyak learner lemah.
Mari kita uraikan cara kerja bagging dan boosting dalam praktik.
Bagging adalah singkatan dari bootstrap aggregating. Prosesnya memiliki tiga langkah:
1. Buat beberapa set pelatihan dengan sampling dari data asli dengan pengembalian (bootstrap samples)
2. Latih satu model pada setiap sampel bootstrap secara independen
3. Gabungkan prediksi dengan merata-ratakan (regresi) atau voting mayoritas (klasifikasi)
Bootstrap sampling berarti setiap set pelatihan berukuran sama dengan data asli, tetapi beberapa contoh muncul berkali-kali sementara yang lain sama sekali tidak muncul. Rata-rata, setiap sampel bootstrap berisi sekitar 63% contoh unik dari data asli. Sisanya 37% disebut sampel out-of-bag dan dapat digunakan untuk validasi.
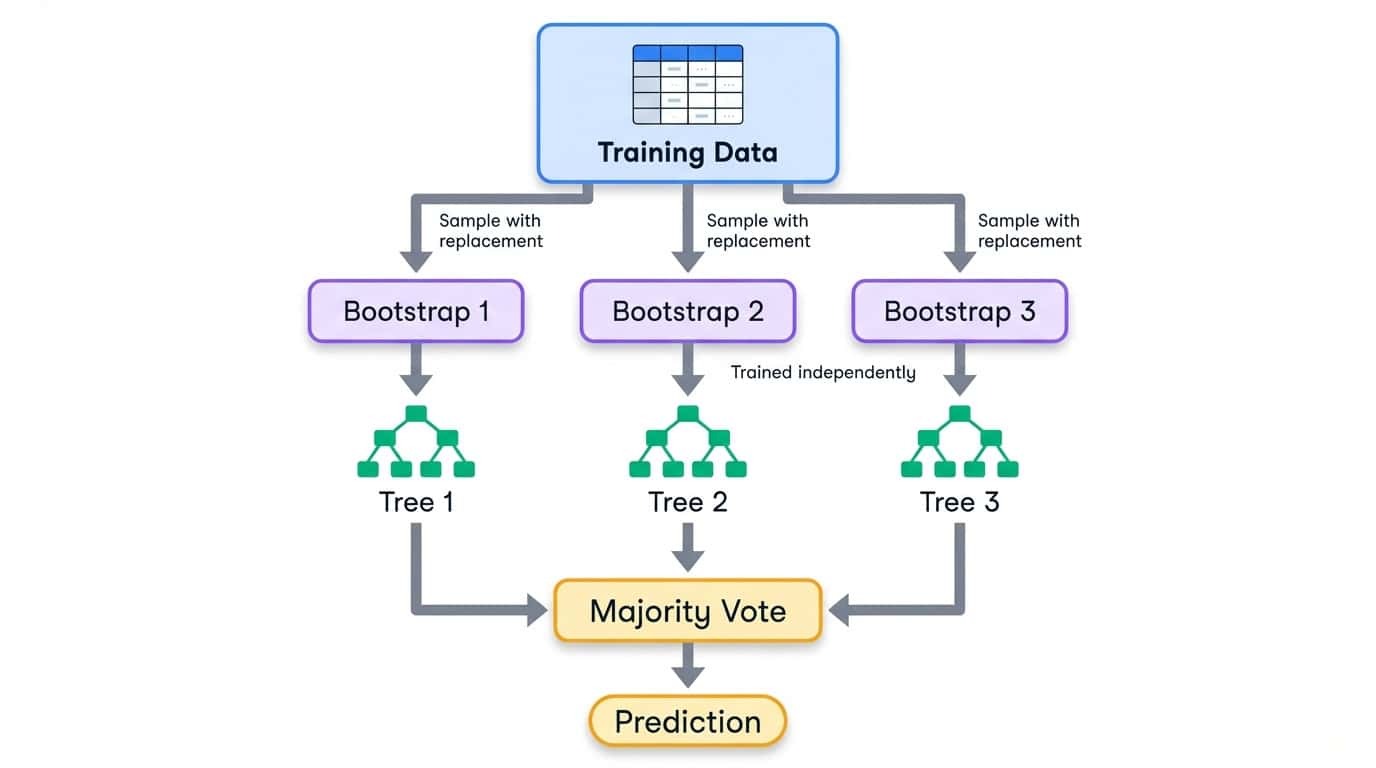
Alur kerja bagging yang menunjukkan data pelatihan dibagi menjadi sampel bootstrap, masing-masing melatih pohon keputusan independen, lalu digabungkan melalui voting mayoritas
Karena setiap model melihat potongan data yang berbeda, mereka mengembangkan kekhasan yang berbeda. Sebagian overfit pada satu wilayah ruang fitur, yang lain pada wilayah berbeda. Saat Anda mengagregasikan prediksinya, kesalahan individual ini cenderung hilang. Prediksi ensemble lebih stabil daripada model tunggal mana pun.
Pelatihan terjadi secara paralel karena model tidak saling bergantung. Ini membuat bagging mudah diskalakan di banyak inti CPU. Random Forest, yang akan Anda implementasikan nanti di tutorial ini, adalah algoritma bagging yang paling banyak digunakan. Untuk melihat teori lebih dalam, lihat panduan bagging dalam machine learning dari DataCamp.
Boosting mengambil pendekatan berbeda. Alih-alih melatih model secara independen, ia melatihnya satu per satu, di mana setiap model baru berfokus pada contoh yang salah diprediksi oleh model sebelumnya.
Proses umum terlihat seperti ini:
1. Latih model lemah pada seluruh set pelatihan
2. Identifikasi contoh mana yang diprediksi buruk oleh model
3. Latih model berikutnya dengan penekanan ekstra pada contoh yang sulit tersebut
4. Ulangi, menambahkan model yang mengoreksi kesalahan yang tersisa
5. Gabungkan semua model ke dalam jumlah berbobot, di mana model yang berkinerja lebih baik mendapat bobot lebih tinggi
Istilah "weak learner" berarti model yang kinerjanya hanya sedikit lebih baik dari tebak acak. Decision stump (pohon dengan satu pemisahan) adalah pilihan umum. Secara individual, stump hampir tidak berguna. Namun boosting menumpuk ratusan di antaranya, masing-masing mengikis sisa kesalahan yang ditinggalkan model sebelumnya. Ensemble akhir menjadi strong learner yang dibangun dari banyak kontribusi lemah.
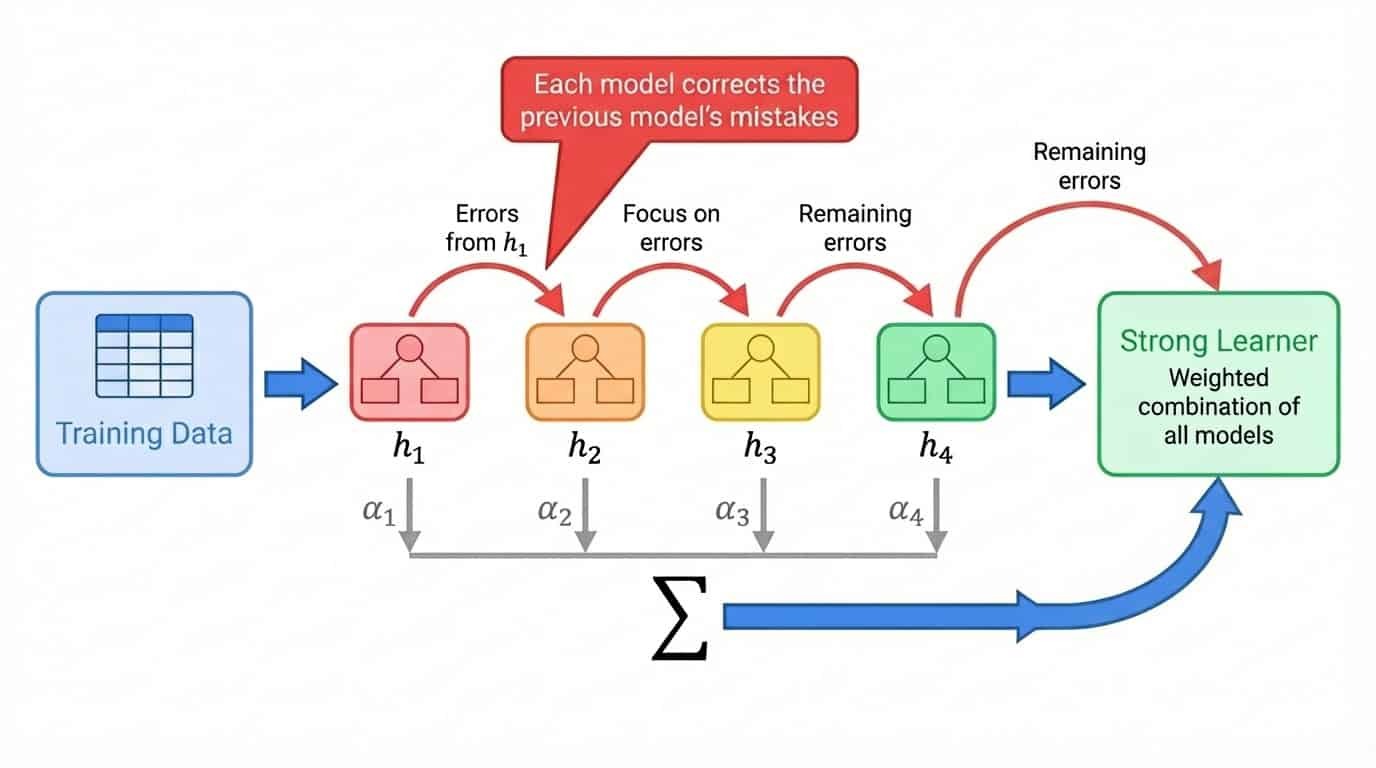
Alur kerja boosting yang menunjukkan pelatihan model berurutan di mana setiap model mengoreksi kesalahan model sebelumnya, digabungkan menjadi jumlah berbobot
Tidak seperti bagging, boosting secara inheren bersifat berurutan. Anda tidak dapat melatih model ke-47 sampai Anda tahu contoh mana yang sulit bagi model 1 hingga 46. Ini membuat boosting lebih lambat dilatih, tetapi sering kali menghasilkan akurasi lebih tinggi karena setiap model dibuat khusus untuk memperbaiki kelemahan tertentu dalam ensemble.
XGBoost, yang akan Anda implementasikan nanti di tutorial ini, adalah algoritma gradient boosting yang menjadi pilihan utama untuk data tabular. Saya merekomendasikan pengantar boosting yang membahas matematika lebih detail jika Anda ingin menggali lebih dalam.
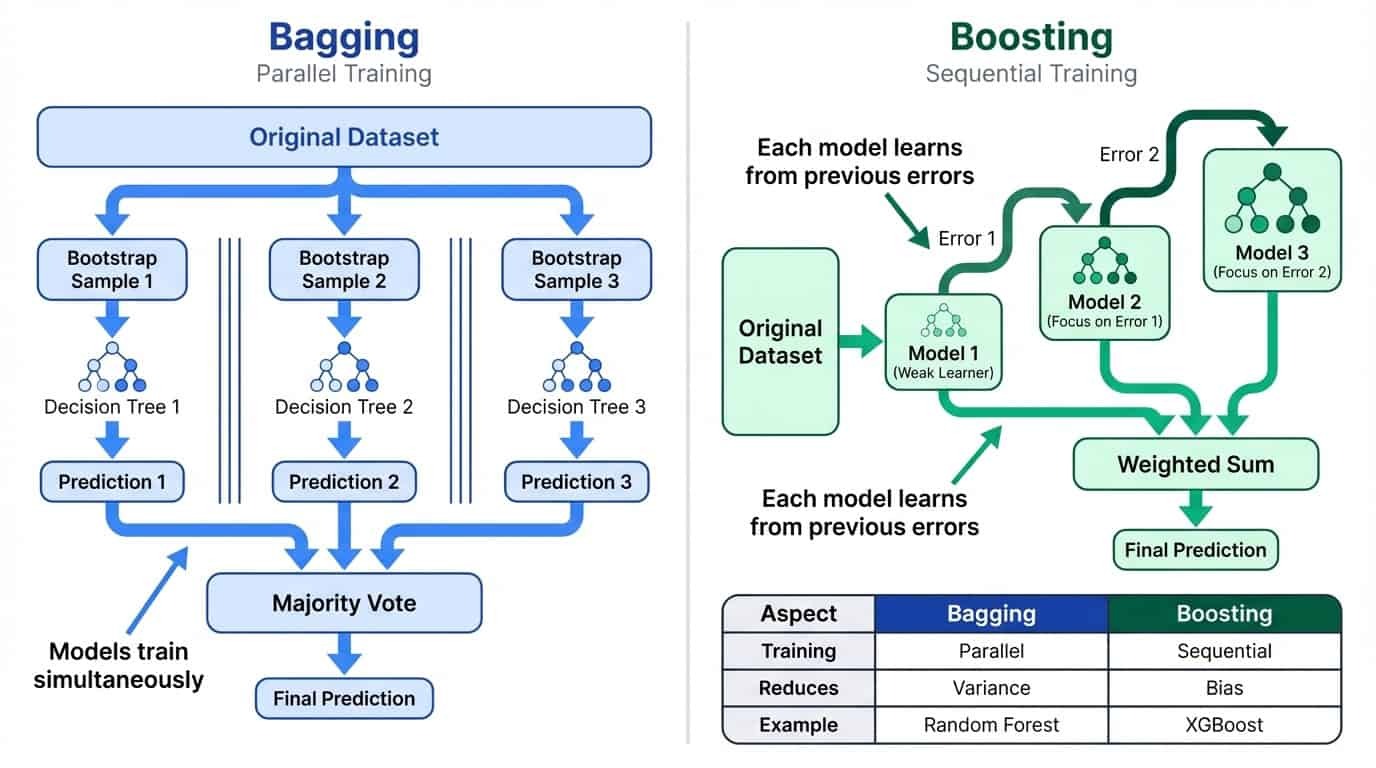
Perbandingan berdampingan antara bagging dan boosting: bagging menggunakan pelatihan paralel untuk mengurangi varians, boosting menggunakan pelatihan berurutan untuk mengurangi bias
Bagging dan boosting adalah strategi ensemble yang paling banyak digunakan, tetapi bukan satu-satunya. Sebelum menyelami Random Forest dan XGBoost, ada baiknya mengetahui opsi lain yang ada.
Cara termudah untuk menggabungkan model adalah membiarkan mereka melakukan voting. Pada hard voting, setiap model membuat prediksi, dan kelas dengan suara terbanyak menang. Jika Anda memiliki logistic regression, support vector machine, dan pohon keputusan, dan dua di antaranya memprediksi kelas A sementara satu memprediksi kelas B, ensemble menghasilkan kelas A.
Soft voting melangkah lebih jauh dengan merata-ratakan probabilitas prediksi alih-alih menghitung suara diskret. Model yang memprediksi kelas A dengan keyakinan 90% berkontribusi lebih besar pada keputusan akhir dibandingkan yang memprediksi A dengan 51% keyakinan. Ini biasanya mengungguli hard voting karena menangkap seberapa yakin tiap model.
Anda juga dapat memberikan bobot untuk memberi pengaruh lebih pada model yang lebih kuat. Jika logistic regression Anda secara konsisten mengungguli yang lain pada data validasi, Anda bisa membobotkan prediksinya 2x sementara yang lain tetap 1x.
Voting bekerja paling baik saat menggabungkan model yang mendekati masalah secara berbeda. Model linier, model berbasis pohon, dan model tetangga-terdekat masing-masing memiliki titik buta berbeda. Prediksi gabungan mereka sering mengungguli model individual mana pun, bahkan jika tidak ada model tunggal yang sangat kuat. scikit-learn menyediakan VotingClassifier dan VotingRegressor untuk tujuan ini.
Stacking membawa ide ensemble satu tingkat lebih dalam. Alih-alih merata-ratakan prediksi, Anda melatih model kedua (disebut meta-learner) untuk menggabungkannya. Prosesnya seperti ini: latih beberapa model dasar, kumpulkan prediksi mereka pada set validasi, lalu latih meta-learner untuk memetakan prediksi tersebut ke label yang benar. Meta-learner mempelajari model dasar mana yang harus dipercaya dalam situasi tertentu.
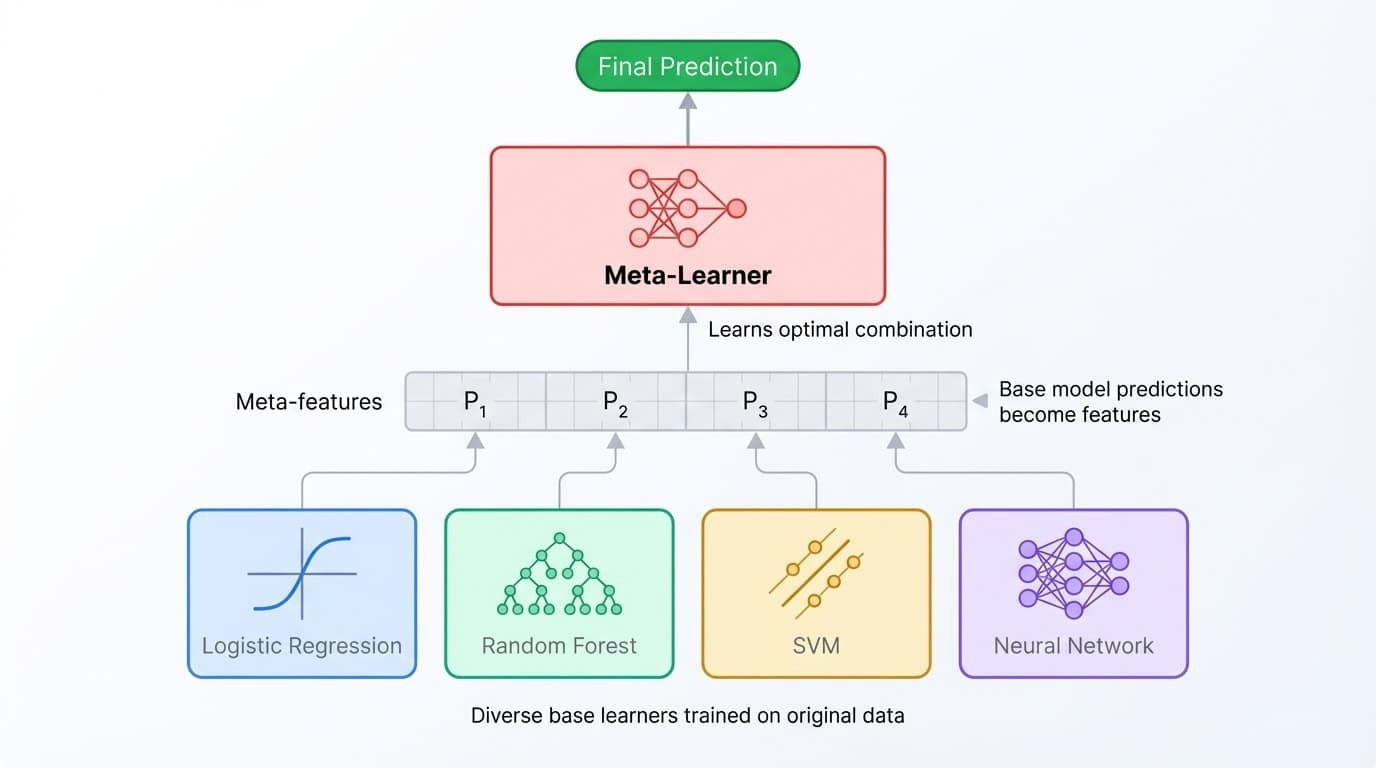
Arsitektur stacking ensemble yang menunjukkan beragam model dasar memberi masukan prediksi ke meta-learner yang menggabungkannya untuk keluaran akhir
Blending adalah varian yang lebih sederhana yang menggunakan satu set holdout alih-alih lipatan cross-validation. Lebih cepat diimplementasikan tetapi menyia-nyiakan sebagian data pelatihan dan lebih rentan terhadap overfitting pada set holdout.
Kedua teknik ini dapat memeras akurasi ekstra, tetapi keuntungannya sering kecil (peningkatan 0,1–0,5%) dibandingkan kompleksitas tambahan. Stacked ensemble lebih sulit di-debug, lebih lambat dilatih, dan lebih sulit dijelaskan kepada pemangku kepentingan. Teknik ini unggul dalam kompetisi Kaggle di mana setiap titik desimal berarti dan waktu pelatihan tidak terbatas, tetapi jarang sepadan di produksi.
Menariknya, sebagian besar stacked ensemble tetap menggunakan Random Forest dan XGBoost sebagai base learner. Kedua algoritma ini begitu kuat sehingga stacking sering kali hanya menjadi cara rumit untuk merata-ratakan prediksinya.
Tutorial ini berpegang pada Random Forest (bagging) dan XGBoost (boosting) karena keduanya menangani sebagian besar masalah data tabular dunia nyata. Keduanya lebih sederhana diimplementasikan, lebih mudah dituning, dan lebih mudah dipelihara daripada stacked ensemble multi-level.
Jika Anda ingin mendalami voting dan stacking, kursus Ensemble Methods in Python dari DataCamp mencakup seluruh rangkaian teknik. Sekarang, mari praktik langsung dengan datasetnya.
Tutorial ini menggunakan dataset Dry Beans dari UCI Machine Learning Repository. Peneliti Koklu dan Ozkan (2020) memotret 13.611 kacang kering dari tujuh varietas dan mengekstraksi 16 fitur geometris dari setiap gambar, termasuk luas, keliling, panjang sumbu, dan faktor bentuk. Tugasnya adalah mengklasifikasikan setiap kacang berdasarkan varietas menurut pengukuran ini.
Dataset ini cocok untuk tutorial karena merupakan masalah multikelas yang bersih dengan semua fitur numerik. Tidak ada nilai hilang, tidak ada pengkodean kategorikal, tidak ada prapemrosesan teks. Anda dapat sepenuhnya fokus pada metode ensemble.
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f"Features shape: {X.shape}")
 print(f"Target classes: {pd.Series(y).nunique()}")
Features shape: (13611, 16)
Target classes: 7X.head()|
Area |
Perimeter |
MajorAxisLength |
MinorAxisLength |
AspectRatio |
Eccentricity |
ConvexArea |
EquivDiameter |
Extent |
Solidity |
Roundness |
Compactness |
ShapeFactor1 |
ShapeFactor2 |
ShapeFactor3 |
|
28395 |
610.291 |
208.178 |
173.889 |
1.197 |
0.550 |
28715 |
190.141 |
0.764 |
0.989 |
0.958 |
0.913 |
0.007 |
0.003 |
0.834 |
|
28734 |
638.018 |
200.525 |
182.734 |
1.097 |
0.412 |
29172 |
191.273 |
0.784 |
0.985 |
0.887 |
0.954 |
0.007 |
0.004 |
0.910 |
|
29380 |
624.110 |
212.826 |
175.931 |
1.210 |
0.563 |
29690 |
193.411 |
0.778 |
0.990 |
0.948 |
0.909 |
0.007 |
0.003 |
0.826 |
|
30008 |
645.884 |
210.558 |
182.517 |
1.154 |
0.499 |
30724 |
195.467 |
0.783 |
0.977 |
0.904 |
0.928 |
0.007 |
0.003 |
0.862 |
|
30140 |
620.134 |
201.848 |
190.279 |
1.061 |
0.334 |
30417 |
195.897 |
0.773 |
0.991 |
0.985 |
0.971 |
0.007 |
0.004 |
0.942 |
pd.Series(y).value_counts()DERMASON 3546
SIRA 2636
SEKER 2027
HOROZ 1928
CALI 1630
BARBUNYA 1322
BOMBAY 522Kelas-kelasnya cukup seimbang, dengan Dermason paling umum dan Bombay paling sedikit. Split terstratifikasi mempertahankan proporsi ini pada set pelatihan dan uji:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f"Training set: {X_train.shape[0]} samples")
 print(f"Test set: {X_test.shape[0]} samples")
Training set: 10888 samples
Test set: 2723 samplesDengan data siap, saatnya melatih model ensemble pertama. Bagian ini membahas cara kerja Random Forest di balik layar, langkah pelatihan dan evaluasi, serta cara men-tuning hyperparameter-nya.
Random Forest menerapkan bagging pada pohon keputusan dengan satu twist tambahan. Setiap pohon dilatih pada sampel bootstrap dari data (seperti dibahas di bagian sebelumnya), tetapi pada setiap pemisahan, algoritma hanya mempertimbangkan subset fitur acak alih-alih semuanya.
Randomisasi fitur ini mencegah pohon menjadi terlalu mirip. Tanpanya, prediktor kuat yang sama akan mendominasi setiap pohon, dan ensemble hanya akan menjadi banyak salinan model yang hampir identik.
Dengan memaksa setiap pemisahan memilih di antara fitur yang terbatas, algoritma menciptakan pohon yang beragam yang membuat kesalahan berbeda. Saat pohon-pohon ini melakukan voting bersama, kesalahan individu mereka cenderung saling meniadakan.
Untuk klasifikasi, scikit-learn secara default mempertimbangkan akar kuadrat dari total fitur pada setiap pemisahan. Dengan 16 fitur pada dataset Dry Beans, setiap pemisahan hanya mengevaluasi 4 fitur yang dipilih secara acak. Hasilnya adalah ensemble pohon yang tidak berkorelasi yang melakukan generalisasi lebih baik daripada pohon tunggal mana pun.
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}")
 print(classification_report(y_test, y_pred_rf))
Accuracy: 0.9199
precision recall f1-score support
BARBUNYA 0.94 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.92 0.91 709
HOROZ 0.96 0.95 0.96 386
SEKER 0.94 0.96 0.95 406
SIRA 0.86 0.85 0.86 527
accuracy 0.92 2723
macro avg 0.93 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Kode ini membuat hutan berisi 100 pohon keputusan, melatihnya pada sampel bootstrap, dan menghasilkan prediksi melalui voting mayoritas. Parameter random_state menetapkan seed acak sehingga hasil dapat direproduksi.
Laporan klasifikasi merinci kinerja per kelas. Precision mengukur berapa banyak positif yang diprediksi benar, recall mengukur berapa banyak positif aktual yang ditemukan, dan F1-score adalah mean harmonik keduanya. Kacang Bombay terklasifikasi sempurna (kemungkinan karena secara fisik berbeda), sementara kacang Sira paling sulit dibedakan dari varietas lain.
Salah satu keunggulan Random Forest adalah pentingnya fitur yang dapat diinterpretasi. Algoritma melacak seberapa banyak setiap fitur mengurangi impuritas (indeks Gini, secara default) di seluruh pohon, memberi Anda ukuran bawaan tentang variabel mana yang paling penting:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()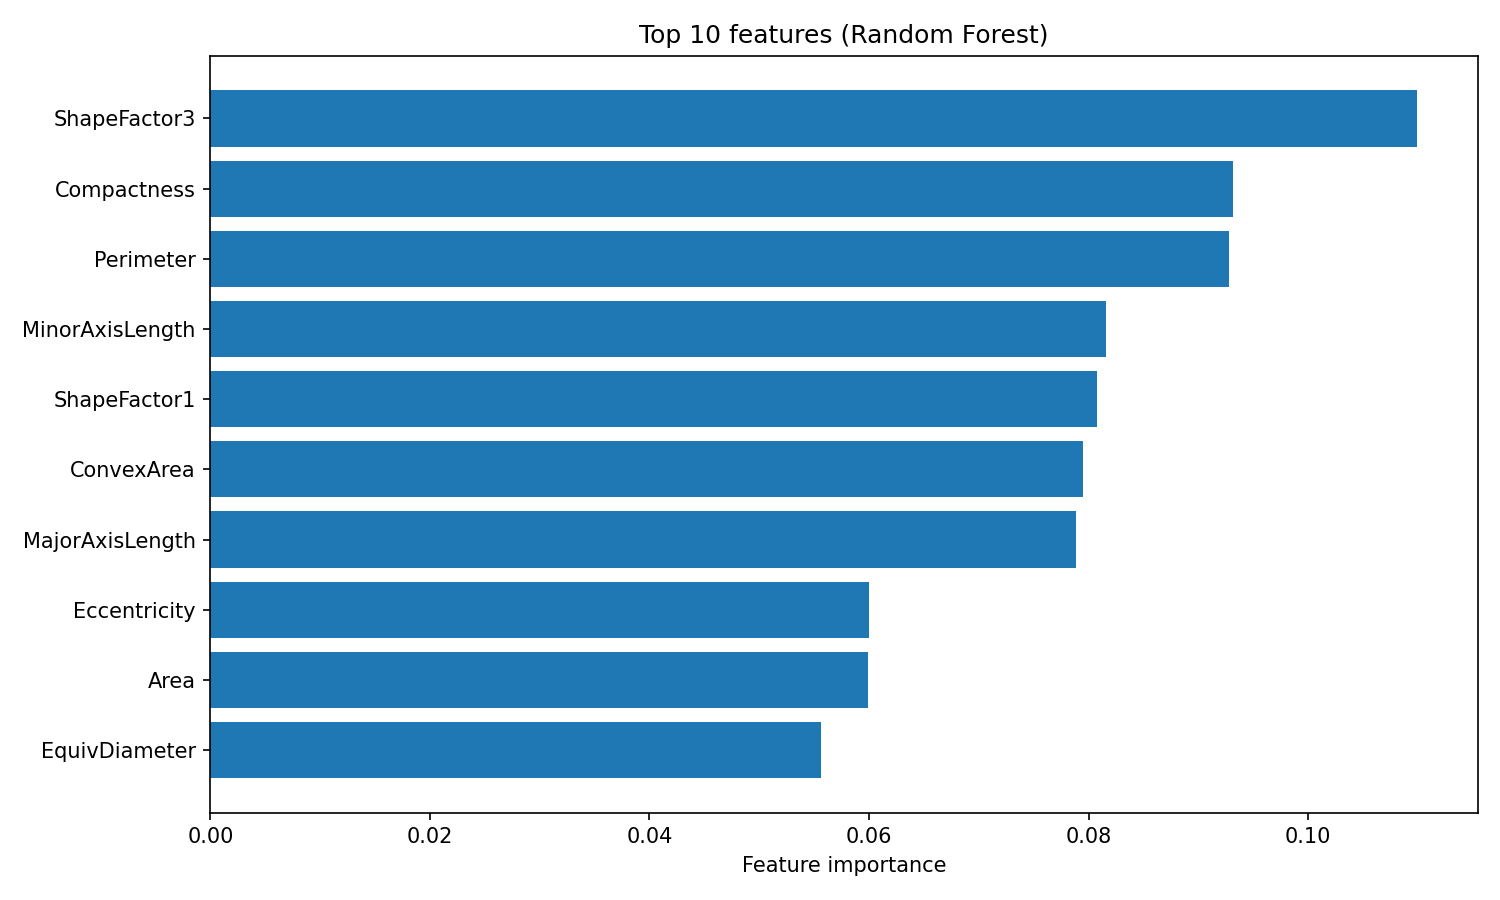
Pentingnya fitur Random Forest
Atribut feature_importances_ mengembalikan array skor yang jumlahnya 1, di mana nilai lebih tinggi menunjukkan fitur yang lebih banyak berkontribusi pada keputusan pemisahan. ShapeFactor3 dan Compactness paling banyak berkontribusi pada klasifikasi, diikuti pengukuran geometris seperti Perimeter dan MinorAxisLength. Fitur berbasis bentuk ini menangkap perbedaan visual antar varietas kacang yang memang dirancang untuk diukur oleh peneliti aslinya.
Random Forest memiliki tiga hyperparameter utama yang layak dituning:
n_estimators: Jumlah pohon dalam hutan. Lebih banyak pohon menghasilkan prediksi yang lebih stabil tetapi lebih lama dilatih. Hasil yang menurun biasanya terjadi setelah 200 pohon untuk sebagian besar dataset.max_depth: Kedalaman maksimum setiap pohon. Default (None) menumbuhkan pohon hingga daun menjadi murni atau berisi kurang dari 2 sampel. Nilai yang lebih rendah dapat mencegah overfitting.max_features: Jumlah fitur yang dipertimbangkan pada setiap pemisahan. Default "sqrt" bekerja baik untuk klasifikasi. Menggunakan "log2" meningkatkan keragaman dengan mengorbankan akurasi pohon individual.Pencarian grid cepat atas parameter-parameter ini:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f"Best params: {grid_search.best_params_}")
 print(f"Best CV accuracy: {grid_search.best_score_:.4f}")
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
Best CV accuracy: 0.9244GridSearchCV mencoba setiap kombinasi parameter di grid dan mengevaluasi masing-masing menggunakan cross-validation. Argumen cv=3 membagi data pelatihan menjadi 3 lipatan, melatih pada 2 dan memvalidasi pada 1, berotasi melalui semua kombinasi. Flag n_jobs=-1 memparalelkan pencarian di semua inti CPU yang tersedia.
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}")
Tuned test accuracy: 0.9214Tuning meningkatkan akurasi dari 92,0% menjadi 92,1%, peningkatan yang moderat. Konfigurasi terbaik menggunakan default untuk max_depth dan max_features, dengan 200 pohon alih-alih 100. Random Forest sering berkinerja baik sejak awal, yang menjadi salah satu daya tarik utamanya. Untuk melihat Random Forest dan parameternya lebih dalam, lihat tutorial klasifikasi Random Forest dari DataCamp.
XGBoost (Extreme Gradient Boosting) mengambil jalur berbeda menuju akurasi dibandingkan Random Forest. Jika Random Forest mengurangi varians dengan merata-ratakan pohon independen, XGBoost mengurangi bias dengan melatih pohon secara berurutan, di mana setiap pohon baru mengoreksi kesalahan ensemble sejauh ini. Bagian ini membahas cara kerja gradient boosting, apa yang membuat XGBoost istimewa, serta cara melatih dan men-tuning-nya pada dataset Dry Beans.
Gradient boosting membangun ensemble satu pohon pada satu waktu. Pohon pertama membuat prediksi pada target asli. Pohon kedua dilatih bukan pada target asli, melainkan pada error residual dari pohon pertama. Pohon ketiga menyesuaikan residual yang tersisa setelah menambahkan prediksi pohon kedua. Ini berlanjut ratusan ronde, dengan setiap pohon baru mengikis kesalahan yang tersisa.
Istilah "gradient" mengacu pada cara algoritma memutuskan apa yang harus dipelajari. Pada setiap langkah, ia menghitung gradien dari fungsi loss terhadap prediksi saat ini. Untuk regresi dengan squared error loss, gradien ini hanyalah residual (aktual dikurangi prediksi). Untuk klasifikasi, matematikanya lebih rumit, tetapi intuisinya sama: setiap pohon dilatih untuk menggerakkan prediksi ke arah yang paling mengurangi loss.
Parameter learning rate mengecilkan kontribusi setiap pohon sebelum menambahkannya ke ensemble. Dengan learning rate 0,1, misalnya, hanya 10% dari prediksi tiap pohon yang ditambahkan. Ini memaksa algoritma mengambil langkah yang lebih kecil dan biasanya meningkatkan generalisasi. Konsekuensinya, Anda memerlukan lebih banyak pohon untuk mencapai tingkat kecocokan yang sama. Learning rate kecil ditambah banyak pohon cenderung menghasilkan hasil lebih baik daripada learning rate besar dengan sedikit pohon.
XGBoost adalah salah satu implementasi gradient boosting, bersama LightGBM dan CatBoost. Algoritma ini menjadi populer karena menambahkan beberapa perbaikan dibandingkan implementasi sebelumnya seperti GradientBoostingClassifier di scikit-learn.
Penambahan utamanya adalah:
Fitur-fitur ini membuat XGBoost lebih cepat dan lebih tahan terhadap overfitting dibandingkan gradient boosting biasa. Parameter regularisasi memberi Anda kontrol langsung atas kompleksitas model, yang berguna saat bekerja dengan data bising atau berdimensi tinggi.
XGBoost mengharapkan label kelas numerik alih-alih string, jadi langkah pertama adalah mengenkode variabel target:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}")
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))
Accuracy: 0.9232
precision recall f1-score support
BARBUNYA 0.95 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.93 0.91 709
HOROZ 0.96 0.96 0.96 386
SEKER 0.95 0.96 0.95 406
SIRA 0.87 0.86 0.87 527
accuracy 0.92 2723
macro avg 0.94 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723LabelEncoder memetakan nama kelas ke bilangan bulat (0 sampai 6) dan menyimpan pemetaannya sehingga Anda dapat mengonversi prediksi kembali ke nama kelas. Argumen eval_metric="mlogloss" memberi tahu XGBoost untuk menggunakan multiclass log loss untuk evaluasi internal.
Langsung dari kotak, XGBoost mencapai akurasi 92,3%, sedikit lebih tinggi daripada 92,0% milik Random Forest. Pola per kelasnya serupa: kacang Bombay diklasifikasikan sempurna, sementara kacang Sira tetap paling sulit dibedakan.
XGBoost menyediakan pentingnya fitur berbasis gain, yang mengukur peningkatan rata-rata akurasi yang disumbangkan setiap fitur di seluruh pemisahan tempat fitur tersebut digunakan:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()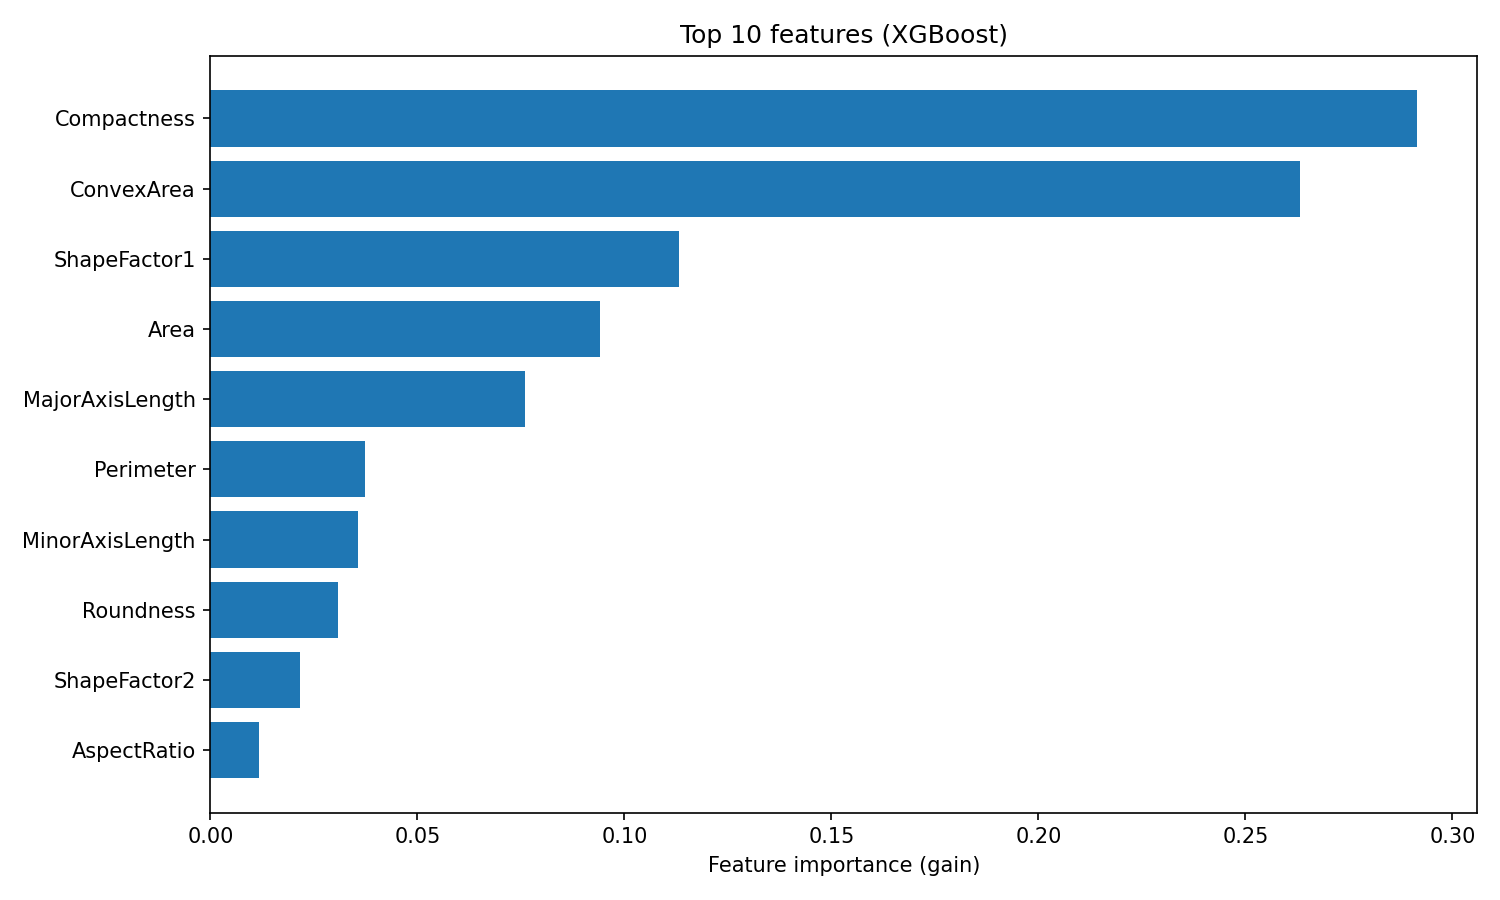
Pentingnya fitur XGBoost
Peringkatnya berbeda dari Random Forest. XGBoost menempatkan Compactness dan ConvexArea di posisi teratas, sementara Random Forest menempatkan ShapeFactor3 di urutan pertama.
Perbedaan ini mencerminkan cara kedua algoritma menggunakan fitur: Random Forest mengukur seberapa sering sebuah fitur mengurangi impuritas di banyak pohon independen, sementara XGBoost mengukur seberapa banyak akurasi yang ditambahkan setiap fitur saat mengoreksi residual. Keduanya valid, hanya saja menangkap aspek kegunaan fitur yang berbeda.
XGBoost memiliki lebih banyak tombol pengaturan daripada Random Forest, mencerminkan fleksibilitasnya yang lebih besar. Parameter utama yang perlu dipertimbangkan adalah:
learning_rate: Shrinkage yang diterapkan pada setiap pohon (default 0,3). Nilai lebih rendah membutuhkan lebih banyak pohon tetapi sering kali melakukan generalisasi lebih baik.max_depth: Kedalaman maksimum pohon (default 6). Pohon yang lebih dangkal mengurangi overfitting. Default XGBoost lebih konservatif dibandingkan kedalaman tak terbatas pada Random Forest.n_estimators: Jumlah ronde boosting. Lebih banyak ronde memungkinkan koreksi lebih halus, terutama dengan learning rate rendah.reg_alpha: Regularisasi L1 pada bobot daun (default 0). Nilai lebih tinggi mendorong bobot menuju nol, menciptakan model lebih jarang (sparse).reg_lambda: Regularisasi L2 pada bobot daun (default 1). Nilai lebih tinggi menghukum bobot besar, menghaluskan prediksi.Pencarian grid atas beberapa parameter ini:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f"Best params: {grid_search_xgb.best_params_}")
 print(f"Best CV accuracy: {grid_search_xgb.best_score_:.4f}")
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
Best CV accuracy: 0.9284y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
print(f"Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}")Tuned test accuracy: 0.9251Konfigurasi terbaik menggunakan pohon yang lebih dangkal (max_depth=4), regularisasi lebih besar (reg_lambda=5), dan dua kali lebih banyak ronde boosting (n_estimators=200). Pola ini umum: XGBoost sering berkinerja terbaik dengan pohon individual yang lebih lemah dikombinasikan melalui lebih banyak ronde boosting. Tuning meningkatkan akurasi uji dari 92,3% menjadi 92,5%.
Untuk melihat parameter XGBoost dan fitur lanjutan seperti early stopping lebih dalam, lihat tutorial XGBoost di Python dari DataCamp.
Dengan kedua model dilatih dan dituning, berikut perbandingannya pada dataset Dry Beans.
|
Metrik |
Random Forest |
XGBoost |
|
Akurasi (default) |
92,0% |
92,3% |
|
Akurasi (tuning) |
92,1% |
92,5% |
|
Macro precision |
0,93 |
0,94 |
|
Macro recall |
0,93 |
0,93 |
|
Macro F1 |
0,93 |
0,93 |
|
Waktu pelatihan |
Cepat |
Sedang |
|
Upaya tuning |
Rendah |
Sedang |
Angka akurasi mengunggulkan XGBoost, tetapi kesenjangan mengecil saat Anda melihat macro F1. Kedua model mencapai 0,93, yang berarti keduanya berkinerja sama baik di semua tujuh kelas kacang alih-alih hanya unggul pada kelas mayoritas.
Kinerja per kelas menunjukkan hal serupa:
|
Kelas |
F1 Random Forest |
F1 XGBoost |
|
Bombay |
1,00 |
1,00 |
|
Horoz |
0,96 |
0,96 |
|
Seker |
0,95 |
0,95 |
|
Cali |
0,94 |
0,94 |
|
Barbunya |
0,92 |
0,92 |
|
Dermason |
0,91 |
0,91 |
|
Sira |
0,86 |
0,87 |
Kedua model memberi peringkat kelas secara identik. Kacang Bombay paling mudah diklasifikasikan (mereka paling besar dan paling berbeda secara fisik), sementara kacang Sira paling sulit (bentuknya tumpang tindih dengan Dermason dan Seker). Satu-satunya keunggulan per kelas XGBoost adalah peningkatan F1 satu poin pada Sira.
Perbedaan praktis antara model ini bukan pada akurasi. Yang membedakan adalah seberapa banyak upaya yang ingin Anda habiskan untuk tuning. Random Forest berkinerja dalam selisih 0,4% dari XGBoost menggunakan parameter default. XGBoost memerlukan grid search atas learning rate, kedalaman pohon, dan regularisasi untuk unggul.
|
Skenario |
Rekomendasi |
|
Baseline cepat |
Random Forest (default kuat, minimal tuning) |
|
Memaksimalkan akurasi |
XGBoost (batas atas lebih tinggi dengan tuning yang tepat) |
|
Waktu terbatas untuk tuning |
Random Forest (kurang sensitif terhadap hyperparameter) |
|
Dataset sangat besar |
XGBoost (efisiensi memori lebih baik, dukungan GPU) |
|
Membutuhkan interpretabilitas |
Keduanya (keduanya menyediakan pentingnya fitur) |
|
Deployment produksi |
Keduanya (keduanya memiliki pustaka yang matang dan stabil) |
Alur kerja yang masuk akal: mulai dengan Random Forest untuk menetapkan baseline, lalu coba XGBoost jika Anda perlu memeras kinerja ekstra. Pilihan terbaik bergantung pada kendala Anda, bukan peringkat algoritma universal.
Dalam tutorial ini, saya telah menunjukkan bagaimana bagging dan boosting mengubah model lemah menjadi kuat. Bagging melatih model secara paralel dan merata-ratakan kesalahannya. Boosting melatihnya secara berurutan, di mana masing-masing memperbaiki kesalahan sebelumnya.
Random Forest dan XGBoost adalah implementasi andalan. Pada dataset Dry Beans, keduanya mencapai sekitar 92% akurasi. XGBoost unggul tipis setelah tuning, tetapi Random Forest mencapai sana dengan hampir tanpa konfigurasi. Itulah trade-off sebenarnya: Random Forest minim perawatan, XGBoost membalas upaya ekstra.
Saat memulai masalah baru, latih Random Forest terlebih dahulu. Ini adalah baseline yang solid dan hanya butuh menit untuk disiapkan. Jika Anda perlu mendorong akurasi lebih tinggi dan punya waktu untuk tuning, beralihlah ke XGBoost.
Untuk latihan praktis lebih lanjut dengan algoritma ini, saya merekomendasikan kursus Machine Learning with Tree-Based Models dari DataCamp.
Kursus Machine Learning Teratas
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



