
Corso
Metodi Ensemble in Python
4 ore
13.1K
Un singolo albero decisionale è facile da interpretare ma tende a fare overfitting. Un semplice modello lineare generalizza bene ma non coglie pattern complessi. Ogni tipo di modello ha punti ciechi che ne limitano l’accuratezza sui dati reali.
I metodi ensemble affrontano questo problema combinando più modelli in un unico modello. Invece di affidarsi a un solo predittore, aggregano le previsioni di molti modelli in modo che gli errori individuali si compensino. Il risultato è di solito più accurato di qualunque singolo modello preso da solo.
In questo tutorial ti insegnerò le differenze tra i metodi ensemble fondamentali e mi concentrerò sui due algoritmi ensemble più popolari: Random Forest e XGBoost.
Imparerai come funziona ciascuno, li implementerai entrambi su un problema di classificazione multiclasse e confronterai le loro prestazioni. L’obiettivo è darti una comprensione pratica di quando usare ciascun approccio e come ottimizzarli per i tuoi progetti.
Se cerchi ulteriore pratica hands-on, ti consiglio di dare un’occhiata al corso Ensemble Methods in Python.
L’ensemble learning allena più modelli e combina le loro previsioni in un unico output. L’idea è semplice: modelli diversi commettono errori diversi, quindi la media o il voto tra molti modelli tende a cancellare gli errori individuali.
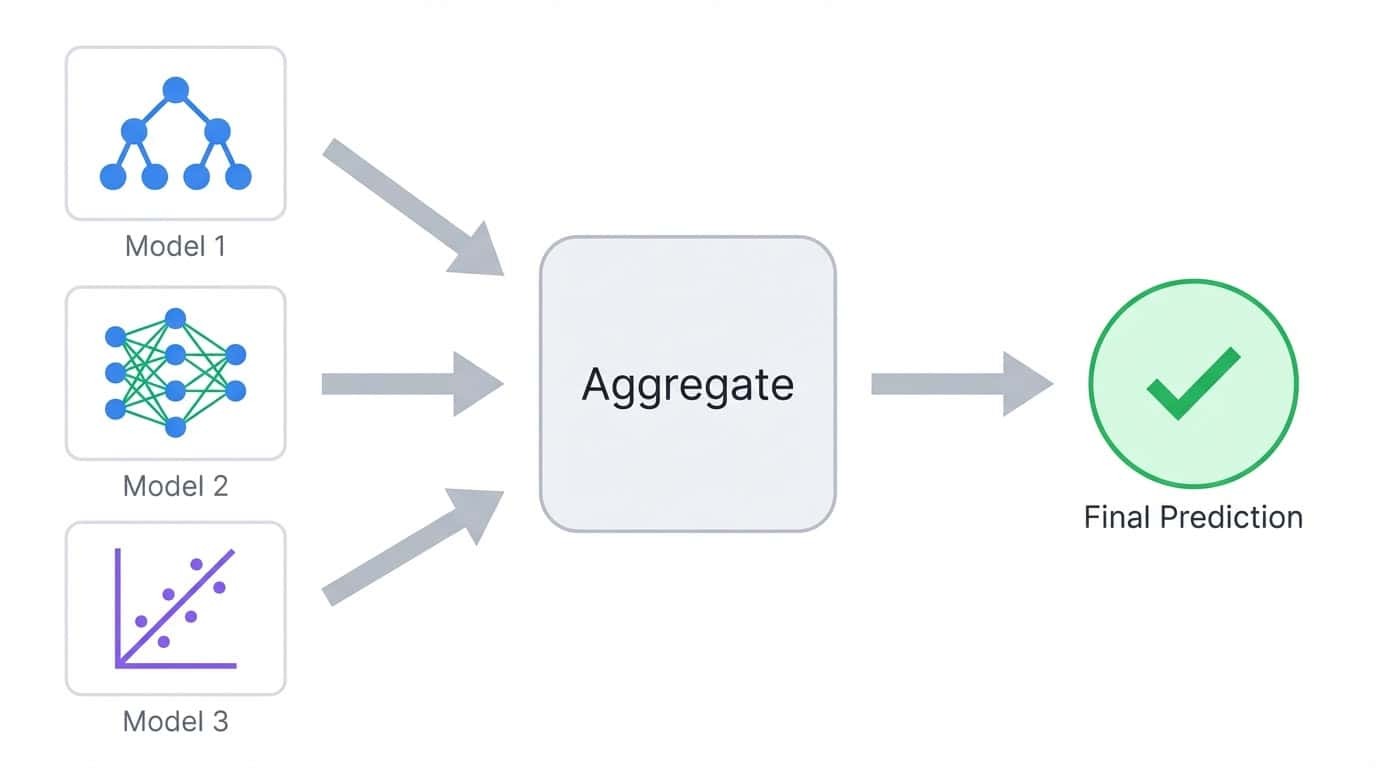
L'ensemble learning combina le previsioni di più modelli in un unico output aggregato
Considera un compito di classificazione in cui alleni cinque alberi decisionali. Ciascun albero potrebbe azzeccare l’80% delle previsioni, ma non sbaglieranno tutti sugli stessi esempi. Quando aggreghi i loro voti, la maggioranza spesso indovina anche quando uno o due alberi sbagliano. Questo è il principio alla base di tutti i metodi ensemble.
I modelli all’interno di un ensemble si chiamano base learner. Possono essere qualsiasi algoritmo, ma gli alberi decisionali sono la scelta più comune perché sono veloci da addestrare e producono naturalmente previsioni diverse quando ricevono sottoinsiemi di dati differenti.
Gli errori di un modello derivano da due fonti: bias e varianza.
Il bias è l’errore dovuto a un’eccessiva semplificazione del problema. Un modello lineare che prova a fittare una relazione curva ha alto bias perché non può rappresentare il pattern reale, indipendentemente da quanti dati gli fornisci. I modelli ad alto bias producono previsioni simili su set di training diversi, ma sono sempre fuori bersaglio.
La varianza è l’errore dovuto a una sensibilità eccessiva ai dati di training. Un albero decisionale profondo che memorizza il training set ha alta varianza perché cattura rumore oltre al segnale. Se riaddestrassi lo stesso albero su un campione leggermente diverso, otterresti previsioni molto diverse. Il modello si adatta bene ai dati di training, ma crolla su dati nuovi.
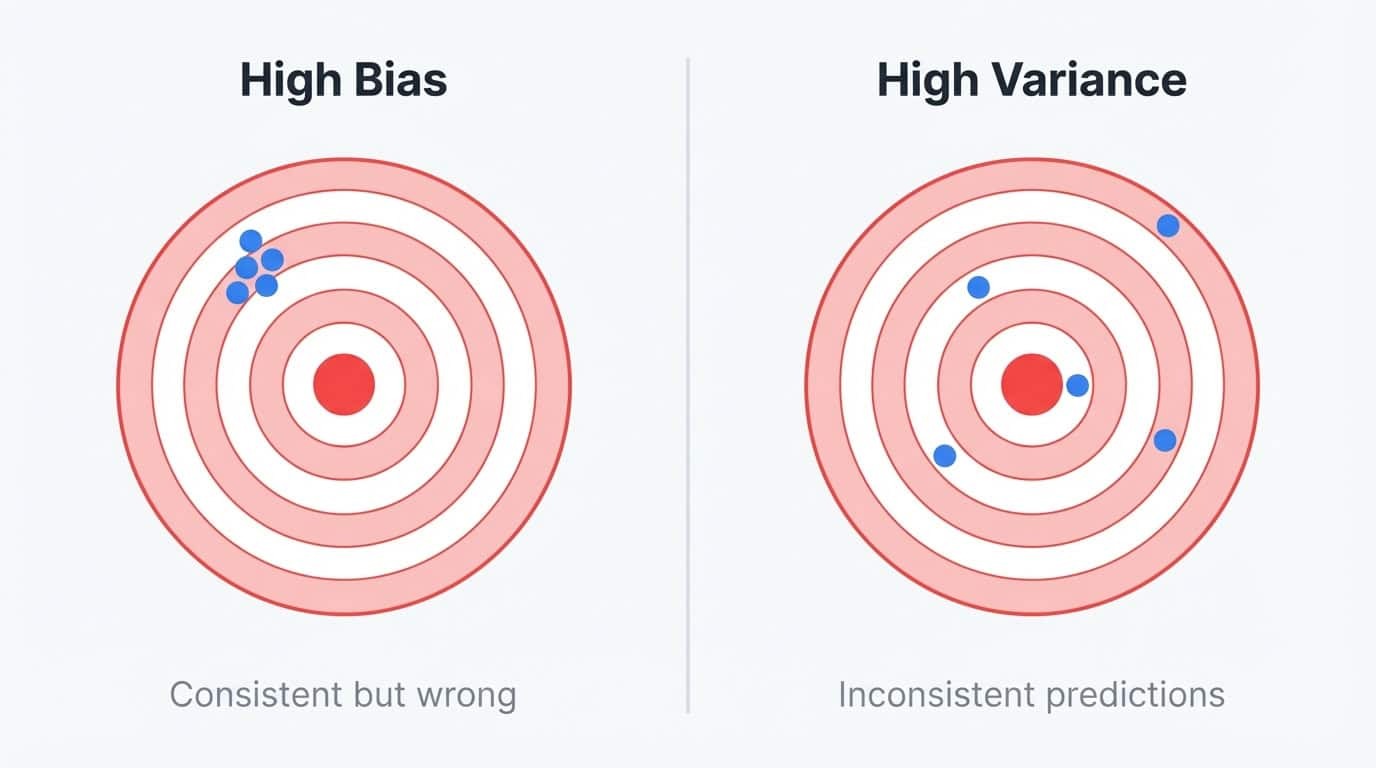
Bias vs varianza illustrati con bersagli: alto bias mostra previsioni consistenti ma fuori bersaglio, alta varianza mostra previsioni sparse e incoerenti
Puoi pensarla come un problema di stabilità. I modelli ad alto bias sono stabili ma sbagliano sempre nello stesso modo. I modelli ad alta varianza sono instabili e sbagliano in modi diversi a seconda dei dati che hanno visto.
Il modello ideale è sia stabile sia accurato, ma ridurre un tipo di errore spesso aumenta l’altro.
Gli alberi decisionali rientrano chiaramente nel campo dell’alta varianza. Usano split greedy, il che significa che piccole variazioni nei dati di training possono produrre strutture di albero completamente diverse.
Allena lo stesso algoritmo di albero su due campioni casuali della stessa popolazione e potresti ottenere due modelli che non si assomigliano affatto. Questa instabilità rende i singoli alberi inaffidabili, ma li rende anche blocchi perfetti per ensemble.
L’alta varianza significa che c’è margine di miglioramento tramite aggregazione. Gli alberi sono anche veloci da addestrare e gestiscono relazioni non lineari senza feature engineering manuale, motivo per cui sia Random Forest che XGBoost li usano, pur affrontando parti diverse del problema bias-varianza.
I metodi ensemble spezzano questo trade-off combinando più modelli:
Il bagging allena molti modelli in parallelo su sottoinsiemi casuali dei dati, quindi fa la media delle previsioni. Questo riduce la varianza attenuando le peculiarità dei singoli modelli. L’intuizione è semplice: se ogni modello commette errori in parte indipendenti, la media tende a cancellarli. Più modelli combini, più stabile diventa la previsione finale. Ecco perché Random Forest di default usa 100 alberi anziché 10.
Il boosting allena i modelli in sequenza, dove ogni nuovo modello si concentra sugli errori dei precedenti. Questo riduce il bias costruendo un learner forte a partire da molti learner deboli.
Vediamo nel pratico come funzionano bagging e boosting.
Bagging sta per bootstrap aggregating. Il processo ha tre passaggi:
1. Crea più set di training campionando dai dati originali con ripetizione (campioni bootstrap)
2. Allena un modello su ciascun campione bootstrap in modo indipendente
3. Combina le previsioni facendo la media (regressione) o con voto di maggioranza (classificazione)
Il campionamento bootstrap significa che ogni set di training ha la stessa dimensione dell’originale, ma alcuni esempi compaiono più volte mentre altri non compaiono affatto. In media, ogni campione bootstrap contiene circa il 63% degli esempi unici dei dati originali. Il restante 37% sono gli out-of-bag sample e possono essere usati per la validazione.
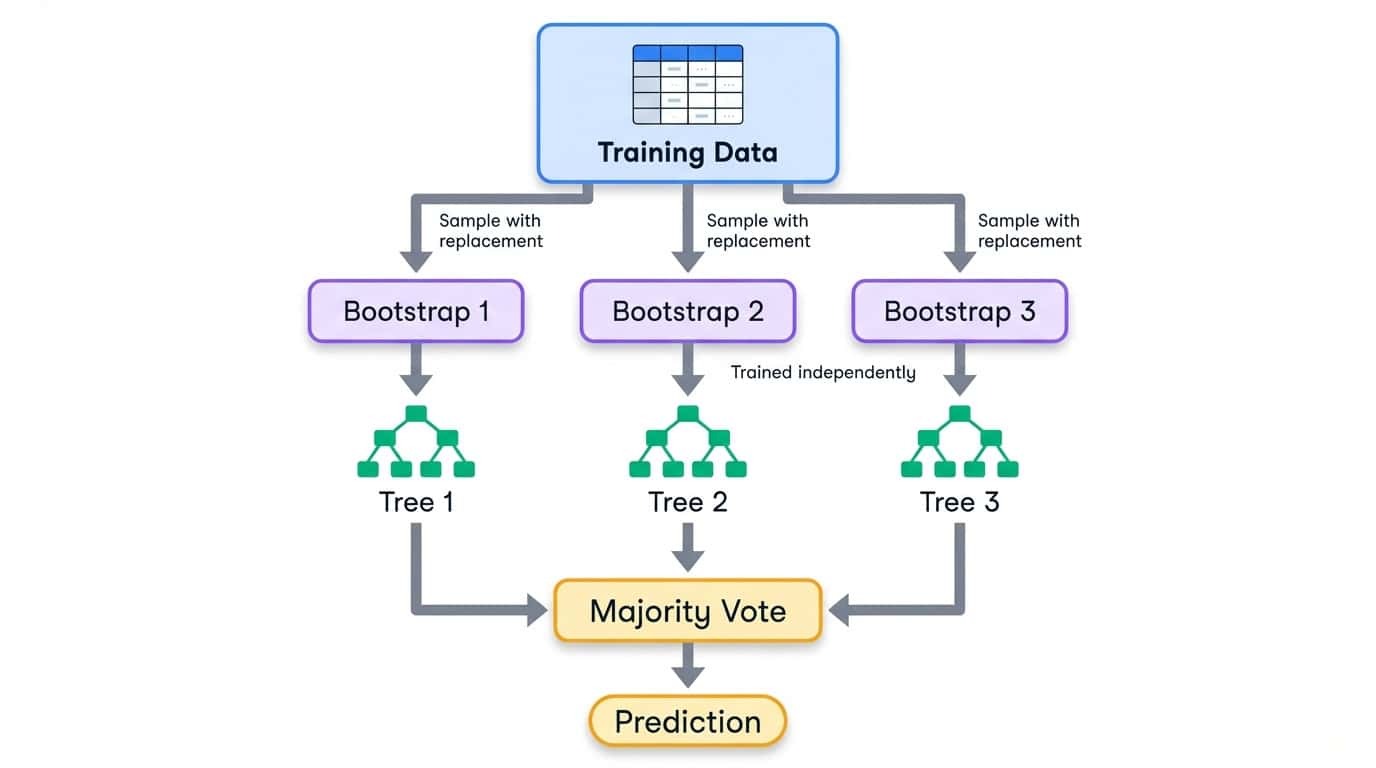
Workflow del bagging che mostra i dati di training suddivisi in campioni bootstrap, ciascuno addestra un albero decisionale indipendente, poi combinati tramite voto di maggioranza
Poiché ogni modello vede una porzione diversa dei dati, sviluppa peculiarità diverse. Alcuni fanno overfitting in una regione dello spazio delle feature, altri in un’altra. Quando aggreghi le loro previsioni, questi errori individuali tendono ad annullarsi. La previsione dell’ensemble è più stabile di qualsiasi singolo modello.
Il training avviene in parallelo perché i modelli non dipendono l’uno dall’altro. Questo rende il bagging facile da scalare su più core CPU. Random Forest, che implementerai più avanti in questo tutorial, è l’algoritmo di bagging più usato. Per approfondire la teoria, vedi la guida al bagging nel machine learning di DataCamp.
Il boosting adotta un approccio diverso. Invece di addestrare i modelli in modo indipendente, li allena uno dopo l’altro, con ogni nuovo modello che si concentra sugli esempi in cui i modelli precedenti hanno sbagliato.
Il processo generale è questo:
1. Allena un modello debole sull’intero training set
2. Identifica quali esempi il modello ha previsto male
3. Allena il modello successivo con enfasi extra su quegli esempi difficili
4. Ripeti, aggiungendo modelli che correggono gli errori rimanenti
5. Combina tutti i modelli in una somma pesata, dove i modelli migliori ricevono pesi più alti
Il termine "weak learner" indica un modello che va solo leggermente meglio del caso. I decision stump (alberi con un solo split) sono una scelta comune. Preso singolarmente, uno stump è quasi inutile. Ma il boosting ne impila centinaia, ciascuno che rosicchia gli errori lasciati dai precedenti. L’ensemble finale è un learner forte costruito da molti contributi deboli.
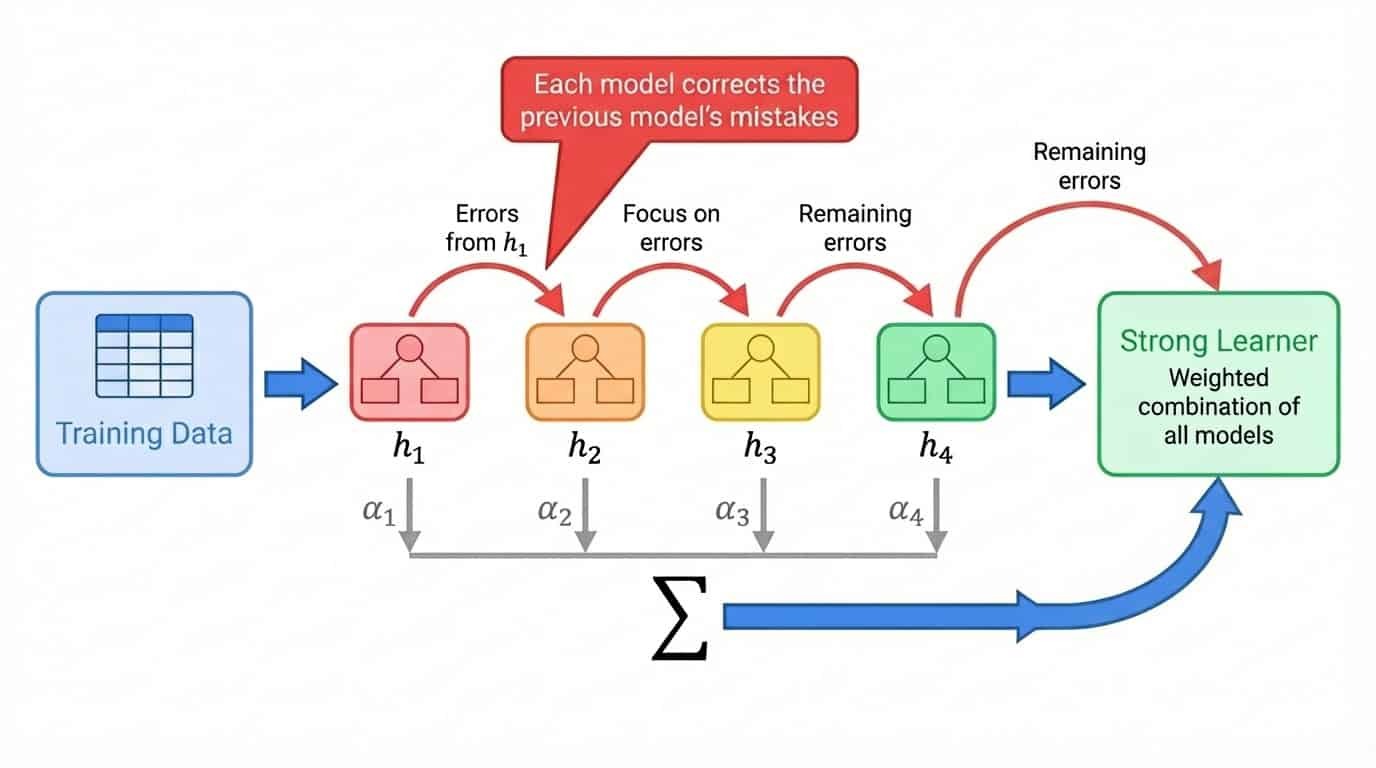
Workflow del boosting che mostra il training sequenziale in cui ogni modello corregge gli errori del precedente, combinati in una somma pesata
A differenza del bagging, il boosting è intrinsecamente sequenziale. Non puoi addestrare il modello 47 finché non sai con quali esempi hanno avuto difficoltà i modelli da 1 a 46. Questo rende il boosting più lento da addestrare, ma spesso produce un’accuratezza maggiore perché ogni modello è progettato per correggere debolezze specifiche dell’ensemble.
XGBoost, che implementerai più avanti in questo tutorial, è un algoritmo di gradient boosting che è diventato la scelta di riferimento per i dati tabellari. Ti consiglio la guida introduttiva al boosting, che copre la matematica in maggior dettaglio se vuoi approfondire.
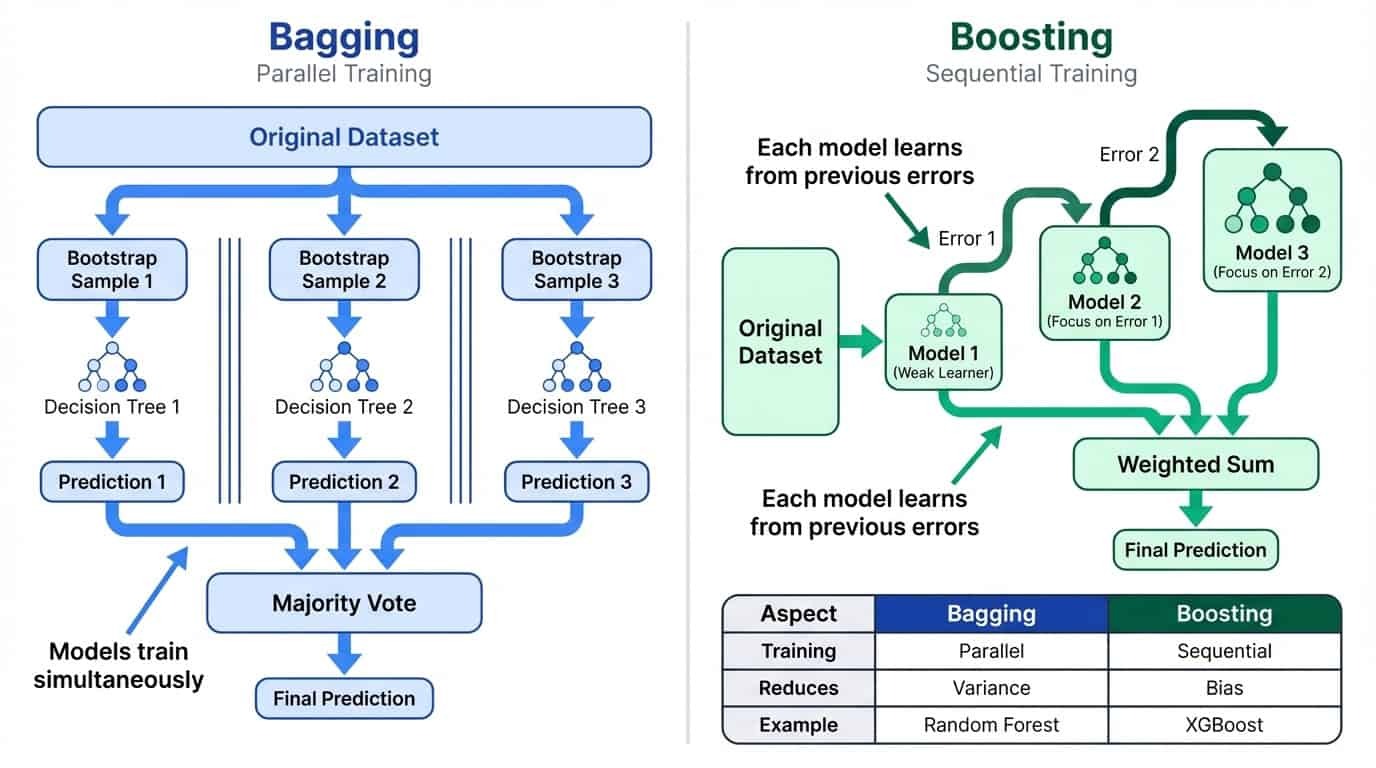
Confronto fianco a fianco tra bagging e boosting: il bagging usa training in parallelo per ridurre la varianza, il boosting usa training sequenziale per ridurre il bias
Bagging e boosting sono le strategie ensemble più usate, ma non sono le uniche. Prima di addentrarci in Random Forest e XGBoost, vale la pena sapere cos’altro esiste.
Il modo più semplice per combinare i modelli è lasciarli votare. Nel hard voting, ogni modello fa una previsione e vince la classe con più voti. Se hai una regressione logistica, una support vector machine e un albero decisionale, e due prevedono la classe A mentre uno prevede la classe B, l’ensemble restituisce la classe A.
Il soft voting va oltre facendo la media delle probabilità previste invece di contare i voti discreti. Un modello che prevede la classe A con il 90% di confidenza contribuisce di più alla decisione finale di uno che prevede A con il 51% di confidenza. Questo di solito supera l’hard voting perché cattura quanto ciascun modello è sicuro.
Puoi anche assegnare pesi per dare più influenza ai modelli più forti. Se la tua regressione logistica supera affidabilmente gli altri sui dati di validazione, potresti pesare le sue previsioni 2x mantenendo gli altri a 1x.
Il voting funziona meglio quando si combinano modelli che affrontano il problema in modo diverso. Un modello lineare, un modello basato su alberi e un modello nearest neighbor hanno ciascuno punti ciechi diversi. La loro previsione combinata spesso supera qualunque singolo, anche se nessun modello è molto forte. scikit-learn fornisce VotingClassifier e VotingRegressor per questo scopo.
Lo stacking porta l’idea dell’ensemble un livello più in profondità. Invece di fare la media delle previsioni, alleni un secondo modello (chiamato meta-learner) per combinarle. Il processo funziona così: allena diversi modelli base, raccogli le loro previsioni su un set di validazione, quindi allena il meta-learner a mappare quelle previsioni sulle etichette corrette. Il meta-learner impara a fidarsi di quale modello base in quali situazioni.
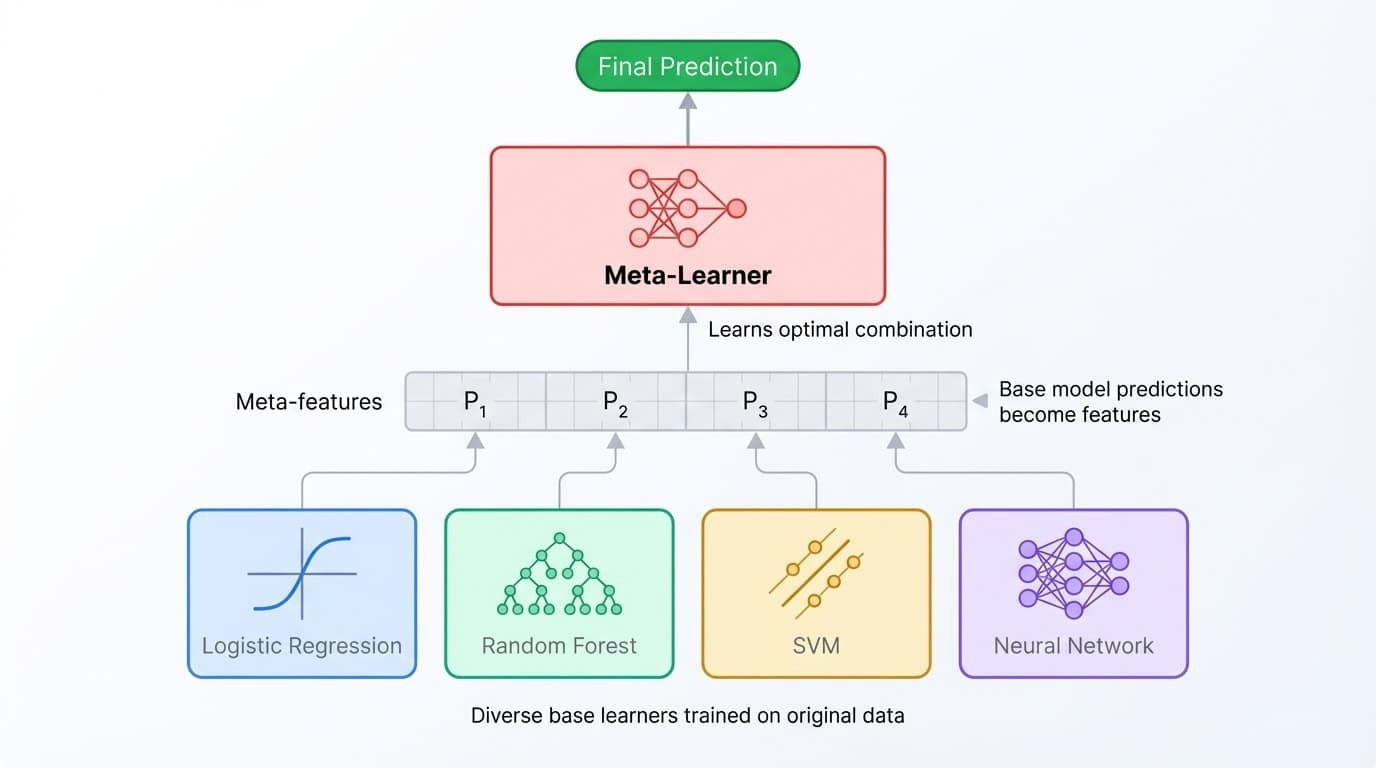
Architettura di stacking ensemble che mostra modelli base eterogenei che alimentano un meta-learner che li combina per l'output finale
Il blending è una variante più semplice che usa un singolo holdout set invece delle fold di cross-validation. È più veloce da implementare ma spreca parte dei dati di training e può essere più incline a fare overfitting sull’holdout set.
Entrambe le tecniche possono spremere un po’ di accuratezza extra, ma i guadagni sono spesso piccoli (0,1-0,5%) rispetto alla complessità aggiunta. Gli ensemble impilati sono più difficili da debuggare, più lenti da addestrare e più ardui da spiegare agli stakeholder. Brillano nelle competizioni Kaggle dove ogni decimale conta e il tempo di training è illimitato, ma raramente valgono l’overhead in produzione.
È interessante notare che la maggior parte degli ensemble impilati usa comunque Random Forest e XGBoost come base learner. Questi due algoritmi sono così forti che lo stacking spesso diventa solo un modo elaborato per fare la media delle loro previsioni.
Questo tutorial si limita a Random Forest (bagging) e XGBoost (boosting) perché coprono la grande maggioranza dei problemi reali con dati tabellari. Sono più semplici da implementare, più facili da ottimizzare e più gestibili rispetto agli ensemble impilati multi-livello.
Se vuoi approfondire voting e stacking, il corso Ensemble Methods in Python di DataCamp copre l’intera gamma di tecniche. Per ora, passiamo al dataset.
Questo tutorial usa il dataset Dry Beans dell’UCI Machine Learning Repository. I ricercatori Koklu e Ozkan (2020) hanno fotografato 13.611 fagioli secchi di sette varietà ed estratto 16 feature geometriche da ciascuna immagine, tra cui area, perimetro, lunghezze degli assi e fattori di forma. Il compito è classificare ogni fagiolo per varietà in base a queste misurazioni.
Il dataset è adatto a questo tutorial perché è un problema multiclasse pulito con tutte feature numeriche. Niente valori mancanti, niente codifica categorica, niente preprocessing di testo. Puoi concentrarti interamente sui metodi ensemble.
!uv add ucimlrepo scikit-learn pandas xgboost

 from ucimlrepo import fetch_ucirepo
 from sklearn.model_selection import train_test_split
 import pandas as pd

 dry_bean = fetch_ucirepo(id=602)
 X = dry_bean.data.features
 y = dry_bean.data.targets.values.ravel()

 print(f"Features shape: {X.shape}")
 print(f"Target classes: {pd.Series(y).nunique()}")
Features shape: (13611, 16)
Target classes: 7X.head()|
Area |
Perimeter |
MajorAxisLength |
MinorAxisLength |
AspectRatio |
Eccentricity |
ConvexArea |
EquivDiameter |
Extent |
Solidity |
Roundness |
Compactness |
ShapeFactor1 |
ShapeFactor2 |
ShapeFactor3 |
|
28395 |
610.291 |
208.178 |
173.889 |
1.197 |
0.550 |
28715 |
190.141 |
0.764 |
0.989 |
0.958 |
0.913 |
0.007 |
0.003 |
0.834 |
|
28734 |
638.018 |
200.525 |
182.734 |
1.097 |
0.412 |
29172 |
191.273 |
0.784 |
0.985 |
0.887 |
0.954 |
0.007 |
0.004 |
0.910 |
|
29380 |
624.110 |
212.826 |
175.931 |
1.210 |
0.563 |
29690 |
193.411 |
0.778 |
0.990 |
0.948 |
0.909 |
0.007 |
0.003 |
0.826 |
|
30008 |
645.884 |
210.558 |
182.517 |
1.154 |
0.499 |
30724 |
195.467 |
0.783 |
0.977 |
0.904 |
0.928 |
0.007 |
0.003 |
0.862 |
|
30140 |
620.134 |
201.848 |
190.279 |
1.061 |
0.334 |
30417 |
195.897 |
0.773 |
0.991 |
0.985 |
0.971 |
0.007 |
0.004 |
0.942 |
pd.Series(y).value_counts()DERMASON 3546
SIRA 2636
SEKER 2027
HOROZ 1928
CALI 1630
BARBUNYA 1322
BOMBAY 522Le classi sono ragionevolmente bilanciate, con Dermason la più comune e Bombay la meno. Uno split stratificato preserva queste proporzioni sia nel training set che nel test set:
X_train, X_test, y_train, y_test = train_test_split(
 	X, y, test_size=0.2, random_state=42, stratify=y
 )
 print(f"Training set: {X_train.shape[0]} samples")
 print(f"Test set: {X_test.shape[0]} samples")
Training set: 10888 samples
Test set: 2723 samplesCon i dati pronti, è il momento di addestrare il primo modello ensemble. Questa sezione spiega come funziona Random Forest sotto il cofano, guida attraverso training e valutazione e mostra come ottimizzarne gli iperparametri.
Random Forest applica il bagging agli alberi decisionali con un’ulteriore particolarità. Ogni albero è addestrato su un campione bootstrap dei dati (come visto nella sezione precedente), ma a ogni split l’algoritmo considera solo un sottoinsieme casuale di feature invece che tutte.
Questa randomizzazione delle feature impedisce agli alberi di diventare troppo simili. Senza di essa, gli stessi predittori forti dominerebbero ogni albero e l’ensemble sarebbe solo molte copie di modelli quasi identici.
Costringendo ogni split a scegliere tra un set limitato di feature, l’algoritmo crea alberi diversi che commettono errori differenti. Quando questi alberi votano insieme, i loro errori individuali tendono a cancellarsi.
Per la classificazione, scikit-learn di default considera la radice quadrata del numero totale di feature a ogni split. Con 16 feature nel dataset Dry Beans, ogni split valuta solo 4 feature scelte casualmente. Il risultato è un ensemble di alberi decorrelati che generalizza meglio di qualunque singolo albero.
from sklearn.ensemble import RandomForestClassifier
 from sklearn.metrics import classification_report, accuracy_score

 rf = RandomForestClassifier(n_estimators=100, random_state=42)
 rf.fit(X_train, y_train)
 y_pred_rf = rf.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test, y_pred_rf):.4f}")
 print(classification_report(y_test, y_pred_rf))
Accuracy: 0.9199
precision recall f1-score support
BARBUNYA 0.94 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.92 0.91 709
HOROZ 0.96 0.95 0.96 386
SEKER 0.94 0.96 0.95 406
SIRA 0.86 0.85 0.86 527
accuracy 0.92 2723
macro avg 0.93 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Questo codice crea una foresta di 100 alberi decisionali, li allena sui campioni bootstrap e genera previsioni tramite voto di maggioranza. Il parametro random_state fissa il seme random in modo che i risultati siano riproducibili.
Il classification report dettaglia le prestazioni per classe. La precision misura quante predizioni positive erano corrette, il recall misura quante positive reali sono state trovate, e l’F1-score è la loro media armonica. I fagioli Bombay sono classificati perfettamente (probabilmente perché fisicamente distinti), mentre i fagioli Sira sono i più difficili da distinguere dalle altre varietà.
Un vantaggio di Random Forest è l’interpretabilità delle feature importance. L’algoritmo traccia quanto ciascuna feature riduce l’impurità (l’indice di Gini, di default) attraverso tutti gli alberi, fornendoti una misura integrata di quali variabili contano di più:
import matplotlib.pyplot as plt

 importances = rf.feature_importances_
 feature_names = X.columns
 sorted_idx = importances.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances[sorted_idx][::-1])
 plt.yticks(range(10), feature_names[sorted_idx][::-1])
 plt.xlabel("Feature importance")
 plt.title("Top 10 features (Random Forest)")
 plt.tight_layout()
 plt.show()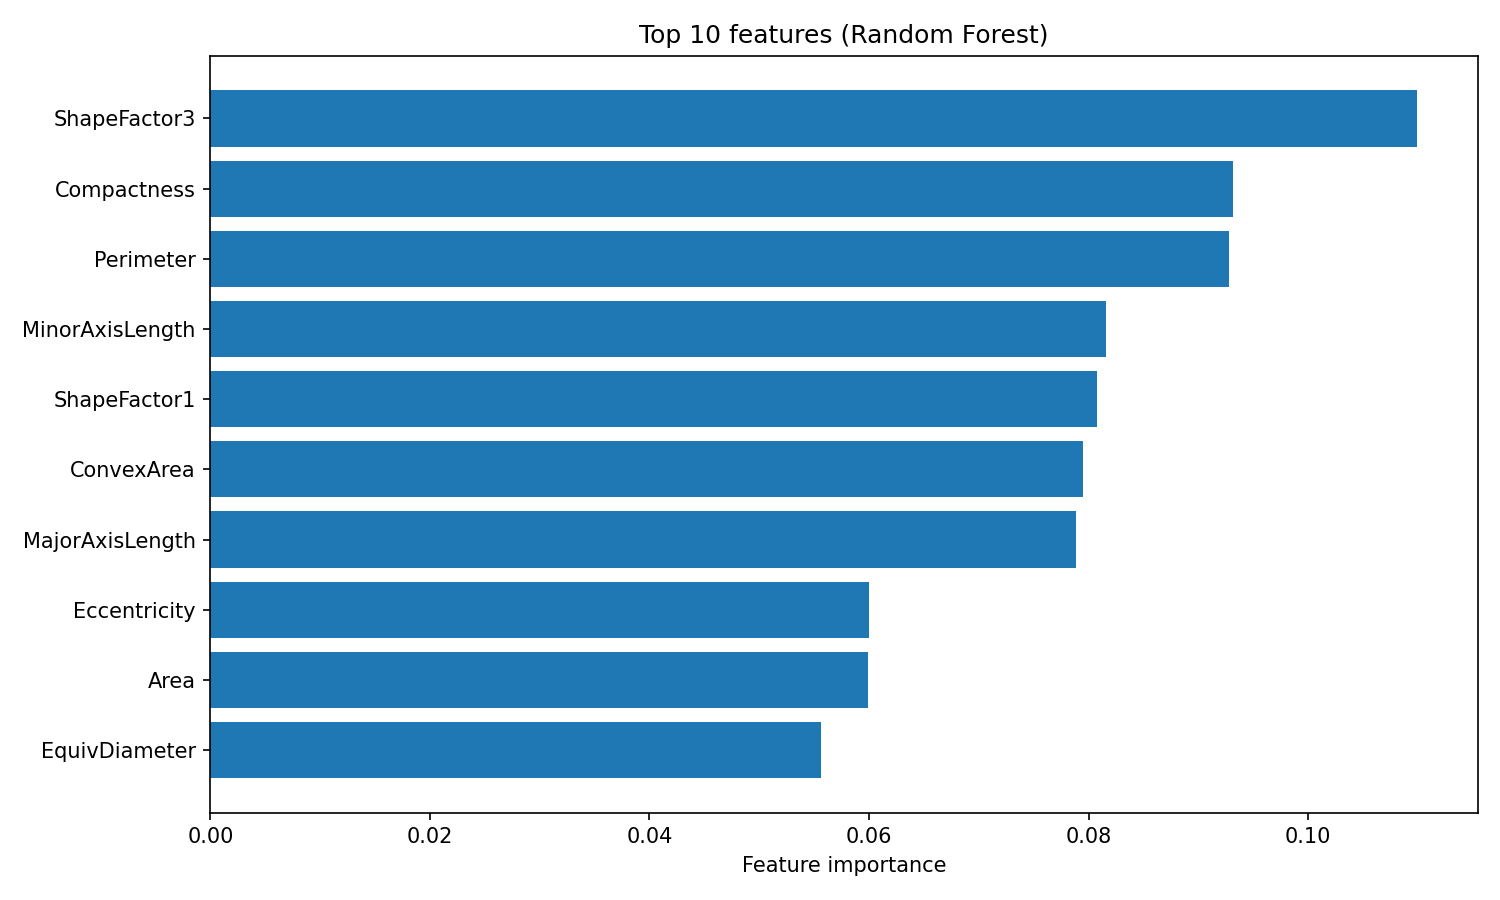
Feature importance di Random Forest
L’attributo feature_importances_ restituisce un array di punteggi che sommano a 1, dove valori più alti indicano feature che hanno contribuito di più alle decisioni di split. ShapeFactor3 e Compactness contribuiscono maggiormente alla classificazione, seguiti da misure geometriche come Perimeter e MinorAxisLength. Queste feature basate sulla forma catturano le differenze visive tra le varietà di fagioli che i ricercatori originali hanno progettato il dataset per misurare.
Random Forest ha tre principali iperparametri che vale la pena ottimizzare:
n_estimators: Il numero di alberi nella foresta. Più alberi producono previsioni più stabili ma richiedono più tempo di training. I ritorni diminuiscono oltre 200 alberi per la maggior parte dei dataset.max_depth: La profondità massima di ciascun albero. Il default (None) fa crescere gli alberi finché le foglie non sono pure o contengono meno di 2 campioni. Valori più bassi possono prevenire l’overfitting.max_features: Il numero di feature considerate a ogni split. Il default "sqrt" funziona bene per la classificazione. Usare "log2" aumenta la diversità a costo dell’accuratezza dei singoli alberi.Una rapida grid search su questi parametri:
from sklearn.model_selection import GridSearchCV

 param_grid = {
 	"n_estimators": [100, 200],
 	"max_depth": [10, 20, None],
 	"max_features": ["sqrt", "log2"]
 }

 grid_search = GridSearchCV(
     RandomForestClassifier(random_state=42),
 	param_grid,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search.fit(X_train, y_train)

 print(f"Best params: {grid_search.best_params_}")
 print(f"Best CV accuracy: {grid_search.best_score_:.4f}")
Best params: {'max_depth': None, 'max_features': 'sqrt', 'n_estimators': 200}
Best CV accuracy: 0.9244GridSearchCV prova ogni combinazione di parametri nella griglia e valuta ciascuna usando la cross-validation. L’argomento cv=3 divide i dati di training in 3 fold, allenando su 2 e validando su 1, ruotando tutte le combinazioni. Il flag n_jobs=-1 parallelizza la ricerca su tutti i core CPU disponibili.
y_pred_tuned = grid_search.best_estimator_.predict(X_test)
 print(f"Tuned test accuracy: {accuracy_score(y_test, y_pred_tuned):.4f}")
Tuned test accuracy: 0.9214L’ottimizzazione aumenta l’accuratezza dal 92,0% al 92,1%, un miglioramento modesto. La configurazione migliore usa i default per max_depth e max_features, con 200 alberi invece di 100. Random Forest spesso funziona bene out-of-the-box, che è uno dei suoi principali punti di forza. Per un approfondimento su Random Forest e i suoi parametri, vedi il tutorial sulla classificazione con Random Forest di DataCamp.
XGBoost (Extreme Gradient Boosting) segue un percorso diverso verso l’accuratezza rispetto a Random Forest. Dove Random Forest riduce la varianza mediando alberi indipendenti, XGBoost riduce il bias addestrando alberi in sequenza, con ogni nuovo albero che corregge gli errori dell’ensemble fino a quel punto. Questa sezione spiega come funziona il gradient boosting, cosa rende XGBoost speciale e come addestrarlo e ottimizzarlo sul dataset Dry Beans.
Il gradient boosting costruisce un ensemble un albero alla volta. Il primo albero fa previsioni sul target originale. Il secondo albero viene addestrato non sul target originale, ma sugli errori residui del primo albero. Il terzo albero fitta i residui rimasti dopo aver aggiunto le previsioni del secondo. Questo continua per centinaia di round, con ogni nuovo albero che rosicchia qualunque errore rimanga.
Il termine "gradient" si riferisce a come l’algoritmo decide cosa fittare. A ogni passo, calcola il gradiente della funzione di perdita rispetto alle previsioni correnti. Per la regressione con loss a errore quadratico, questo gradiente è semplicemente il residuo (valore reale meno previsto). Per la classificazione, la matematica è più complessa, ma l’intuizione è la stessa: ogni albero è addestrato a muovere le previsioni nella direzione che riduce maggiormente la perdita.
Un parametro di learning rate riduce il contributo di ciascun albero prima di aggiungerlo all’ensemble. Con un learning rate di 0,1, ad esempio, solo il 10% della previsione di ogni albero viene aggiunto. Questo costringe l’algoritmo a fare passi più piccoli e in genere migliora la generalizzazione. Il rovescio della medaglia è che servono più alberi per raggiungere lo stesso livello di fit. Un learning rate basso più molti alberi tende a produrre risultati migliori di un learning rate alto con pochi alberi.
XGBoost è una delle varie implementazioni di gradient boosting, insieme a LightGBM e CatBoost. È diventato popolare perché ha aggiunto diversi miglioramenti rispetto a implementazioni precedenti come GradientBoostingClassifier di scikit-learn.
Le principali aggiunte sono:
Queste caratteristiche rendono XGBoost sia più veloce sia più resistente all’overfitting del gradient boosting “vanilla”. I parametri di regolarizzazione ti danno controllo diretto sulla complessità del modello, utile con dati rumorosi o ad alta dimensionalità.
XGBoost si aspetta etichette di classe numeriche anziché stringhe, quindi il primo passaggio è codificare la variabile target:
from xgboost import XGBClassifier
 from sklearn.preprocessing import LabelEncoder

 le = LabelEncoder()
 y_train_encoded = le.fit_transform(y_train)
 y_test_encoded = le.transform(y_test)

 xgb = XGBClassifier(n_estimators=100, random_state=42, eval_metric="mlogloss")
 xgb.fit(X_train, y_train_encoded)
 y_pred_xgb = xgb.predict(X_test)

 print(f"Accuracy: {accuracy_score(y_test_encoded, y_pred_xgb):.4f}")
 print(classification_report(y_test_encoded, y_pred_xgb, target_names=le.classes_))
Accuracy: 0.9232
precision recall f1-score support
BARBUNYA 0.95 0.89 0.92 265
BOMBAY 1.00 1.00 1.00 104
CALI 0.94 0.94 0.94 326
DERMASON 0.90 0.93 0.91 709
HOROZ 0.96 0.96 0.96 386
SEKER 0.95 0.96 0.95 406
SIRA 0.87 0.86 0.87 527
accuracy 0.92 2723
macro avg 0.94 0.93 0.93 2723
weighted avg 0.92 0.92 0.92 2723Il LabelEncoder mappa i nomi delle classi a interi (da 0 a 6) e memorizza la mappatura così da poter convertire le previsioni di nuovo in nomi di classe. L’argomento eval_metric="mlogloss" dice a XGBoost di usare la log loss multiclasse per la valutazione interna.
Out-of-the-box, XGBoost raggiunge il 92,3% di accuratezza, leggermente più di Random Forest (92,0%). Il pattern per classe è simile: i fagioli Bombay sono classificati perfettamente, mentre i Sira restano i più difficili da distinguere.
XGBoost fornisce feature importance basate sul gain, che misura il miglioramento medio in accuratezza che ciascuna feature apporta attraverso tutti gli split in cui è usata:
importances_xgb = xgb.feature_importances_
 sorted_idx_xgb = importances_xgb.argsort()[::-1][:10]

 plt.figure(figsize=(10, 6))
 plt.barh(range(10), importances_xgb[sorted_idx_xgb][::-1])
 plt.yticks(range(10), feature_names[sorted_idx_xgb][::-1])
 plt.xlabel("Feature importance (gain)")
 plt.title("Top 10 features (XGBoost)")
 plt.tight_layout()
 plt.show()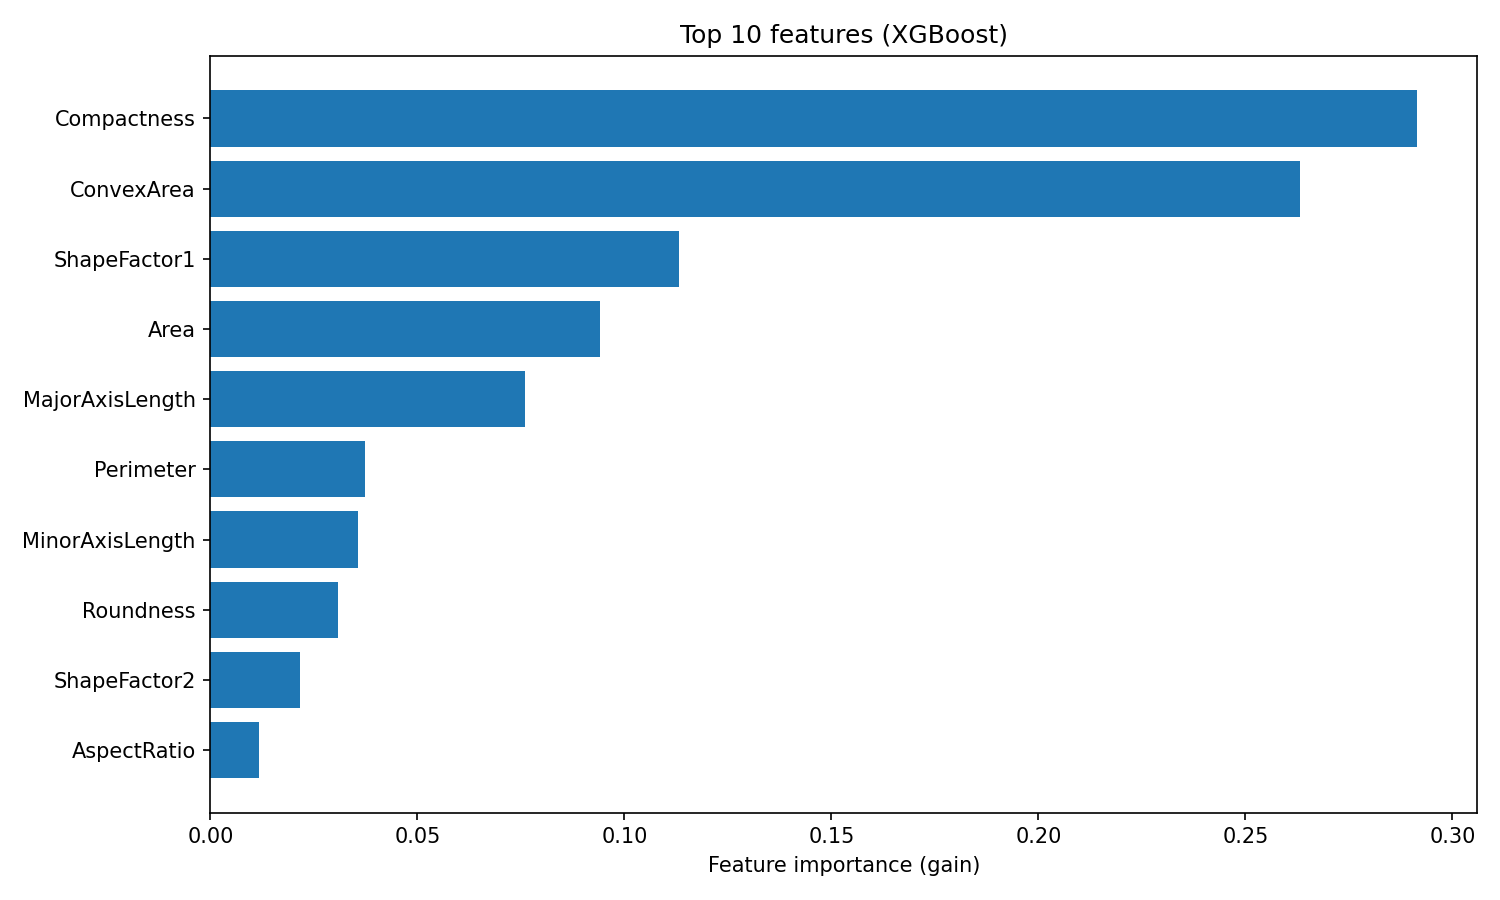
Feature importance di XGBoost
Il ranking differisce da Random Forest. XGBoost mette Compactness e ConvexArea in cima, mentre Random Forest ha piazzato ShapeFactor3 al primo posto.
Questa differenza riflette come i due algoritmi usano le feature: Random Forest misura quanto spesso una feature riduce l’impurità attraverso molti alberi indipendenti, mentre XGBoost misura quanta accuratezza ogni feature aggiunge quando corregge i residui. Entrambi i ranking sono validi, semplicemente catturano aspetti diversi dell’utilità delle feature.
XGBoost ha più manopole di tuning rispetto a Random Forest, a riflesso della sua maggiore flessibilità. I principali parametri da considerare sono:
learning_rate: Shrinkage applicato a ciascun albero (default 0,3). Valori più bassi richiedono più alberi ma spesso generalizzano meglio.max_depth: Profondità massima dell’albero (default 6). Alberi più superficiali riducono l’overfitting. Il default di XGBoost è più conservativo della profondità illimitata di Random Forest.n_estimators: Numero di round di boosting. Più round permettono correzioni più fini, soprattutto con learning rate basso.reg_alpha: Regolarizzazione L1 sui pesi delle foglie (default 0). Valori più alti spingono i pesi verso zero, creando modelli più sparsi.reg_lambda: Regolarizzazione L2 sui pesi delle foglie (default 1). Valori più alti penalizzano pesi grandi, smussando le previsioni.Una grid search su alcuni di questi parametri:
param_grid_xgb = {
 	"learning_rate": [0.05, 0.1],
 	"max_depth": [4, 6],
 	"n_estimators": [100, 200],
 	"reg_lambda": [1, 5]
 }

 grid_search_xgb = GridSearchCV(
 	XGBClassifier(random_state=42, eval_metric="mlogloss"),
 	param_grid_xgb,
 	cv=3,
 	scoring="accuracy",
 	n_jobs=-1
 )
 grid_search_xgb.fit(X_train, y_train_encoded)

 print(f"Best params: {grid_search_xgb.best_params_}")
 print(f"Best CV accuracy: {grid_search_xgb.best_score_:.4f}")
Best params: {'learning_rate': 0.1, 'max_depth': 4, 'n_estimators': 200, 'reg_lambda': 5}
Best CV accuracy: 0.9284y_pred_xgb_tuned = grid_search_xgb.best_estimator_.predict(X_test)
print(f"Tuned test accuracy: {accuracy_score(y_test_encoded, y_pred_xgb_tuned):.4f}")Tuned test accuracy: 0.9251La configurazione migliore usa alberi più superficiali (max_depth=4), più regolarizzazione (reg_lambda=5) e il doppio dei round di boosting (n_estimators=200). Questo pattern è comune: XGBoost spesso rende meglio con alberi individuali più deboli combinati tramite più round di boosting. Il tuning migliora l’accuratezza sul test dal 92,3% al 92,5%.
Per approfondire i parametri di XGBoost e funzionalità avanzate come l’early stopping, vedi il tutorial XGBoost in Python di DataCamp.
Con entrambi i modelli addestrati e ottimizzati, ecco come si confrontano sul dataset Dry Beans.
|
Metrica |
Random Forest |
XGBoost |
|
Accuracy (default) |
92,0% |
92,3% |
|
Accuracy (tuned) |
92,1% |
92,5% |
|
Macro precision |
0,93 |
0,94 |
|
Macro recall |
0,93 |
0,93 |
|
Macro F1 |
0,93 |
0,93 |
|
Tempo di training |
Veloce |
Moderato |
|
Sforzo di tuning |
Basso |
Moderato |
I numeri di accuratezza favoriscono XGBoost, ma il divario si riduce guardando alla macro F1. Entrambi i modelli raggiungono 0,93, cioè si comportano ugualmente bene su tutte e sette le classi di fagioli, invece di eccellere solo sulla classe maggioritaria.
Le prestazioni per classe raccontano una storia simile:
|
Classe |
F1 Random Forest |
F1 XGBoost |
|
Bombay |
1,00 |
1,00 |
|
Horoz |
0,96 |
0,96 |
|
Seker |
0,95 |
0,95 |
|
Cali |
0,94 |
0,94 |
|
Barbunya |
0,92 |
0,92 |
|
Dermason |
0,91 |
0,91 |
|
Sira |
0,86 |
0,87 |
Entrambi i modelli classificano le classi nello stesso ordine. I fagioli Bombay sono i più facili da classificare (sono i più grandi e fisicamente distinti), mentre i Sira sono i più difficili (la loro forma si sovrappone a Dermason e Seker). L’unico vantaggio per classe di XGBoost è un miglioramento di 1 punto di F1 su Sira.
La differenza pratica tra questi modelli non è l’accuratezza. È quanto sforzo vuoi spendere per il tuning. Random Forest ha performato entro lo 0,4% da XGBoost usando i parametri di default. XGBoost ha avuto bisogno di una grid search su learning rate, profondità degli alberi e regolarizzazione per passare in vantaggio.
|
Scenario |
Raccomandazione |
|
Baseline rapida |
Random Forest (default solidi, minimo tuning) |
|
Massimizzare l’accuratezza |
XGBoost (margine superiore con tuning adeguato) |
|
Tempo limitato per il tuning |
Random Forest (meno sensibile agli iperparametri) |
|
Dataset molto grandi |
XGBoost (migliore efficienza di memoria, supporto GPU) |
|
Serve interpretabilità |
Entrambi (entrambi forniscono feature importance) |
|
Deployment in produzione |
Entrambi (librerie mature e stabili) |
Un workflow ragionevole: inizia con Random Forest per stabilire una baseline, poi prova XGBoost se hai bisogno di spremere prestazioni extra. La scelta migliore dipende dai tuoi vincoli, non da una classifica universale degli algoritmi.
In questo tutorial ho mostrato come bagging e boosting trasformano modelli deboli in modelli forti. Il bagging allena modelli in parallelo e fa la media dei loro errori. Il boosting li allena in sequenza, con ciascuno che corregge ciò che il precedente ha sbagliato.
Random Forest e XGBoost sono le implementazioni di riferimento. Sul dataset Dry Beans, entrambi si sono attestati intorno al 92% di accuratezza. XGBoost è passato avanti dopo il tuning, ma Random Forest c’è arrivato quasi senza configurazione. Questo è il vero trade-off: Random Forest richiede poca manutenzione, XGBoost ripaga lo sforzo extra.
Quando inizi un nuovo problema, addestra prima una Random Forest. È una baseline solida che richiede pochi minuti per essere impostata. Se devi spingere l’accuratezza più in alto e hai tempo per il tuning, passa a XGBoost.
Per più pratica hands-on con questi algoritmi, ti consiglio il corso Machine Learning with Tree-Based Models di DataCamp.
I migliori corsi di Machine Learning
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



