F 统计量帮助您判断数据中的差异是有意义的,还是只是随机波动。它比较模型或分组所能解释的变异,与仍未被解释的变异。
您会在常见的统计方法中看到 F 统计量,例如 ANOVA 和回归分析。在这两种情况下,它都在回答一个基本问题:模型是否比偶然因素更好地解释数据?
在本指南中,我们将带您了解 F 统计量度量的含义、其计算方式、在 ANOVA 与回归中的出现位置,以及如何正确解释结果。
F 统计量度量了什么
F 统计量衡量模型所解释的变异是否大于随机噪声导致的变异。它比较两种方差来源:一种代表信号,另一种代表噪声。
从数学上讲,F 统计量是均方(方差)的比值:
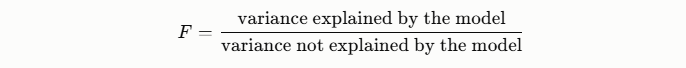
在许多统计检验中,它写作
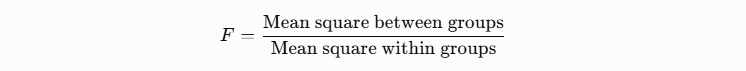
F 统计量比较以下两项数量。
- 组间方差:衡量各组平均值彼此之间的差异程度。差异越大,越表明各组行为不同。
- 组内方差:衡量每组内各个值围绕本组均值的波动程度。这代表数据中的随机噪声或自然变异。
如果组间方差远大于组内方差,F 值就会很大,这表明组间差异具有意义。若组内方差占主导,F 值会很小,这表明观察到的差异很可能是随机的。
F 统计量的应用场景
您可能会在以下统计方法中看到 F 统计量:
- 方差分析(ANOVA):ANOVA 使用 F 统计量检验多个组的均值是否不同。例如,它可检验三种营销活动的平均转化率是否存在差异。
- 回归模型总体显著性:在线性回归中,F 统计量用于检查模型是否对因变量有有意义的解释。简单来说,它检验各预测变量合在一起,是否比仅用总体平均值更能改善预测。
- 比较嵌套模型:F 统计量还可用于比较两个回归模型,其中一个是另一个的简化版本。这有助于判断添加额外变量带来的改进是否足以抵消复杂度的增加。
如何计算 F 统计量
F 统计量计算为两个均方之比。均方是方差估计,显示数据某一部分的变异程度。
通用公式如下所示: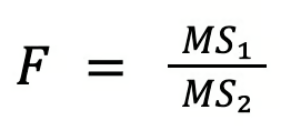
其中:
- MS₁ 代表由模型或分组结构解释的变异。
- MS₂ 代表仍未被解释的变异。
如果解释变异远大于未解释变异,F 值就会很大。这意味着模型或分组解释了有意义的差异。
尽管解释依赖于您所进行的分析,F 统计量最常用于 ANOVA 和回归分析。
一个简单的数值示例
我们通过一个简单示例来说明。
假设您正在比较三种营销活动的转化率。计算平方和并除以自由度后,得到:
- 组间均方(MS_between)= 20
- 组内均方(MS_within)= 5
现在计算 F 统计量: F = 20 / 5 = 4
因此,F 值为 4。
这意味着各活动平均值之间的变异是各活动内部变异的四倍。换言之,与各自内部的随机波动相比,活动之间的差异相对较大。
F 统计量与 F 分布
当原假设为真时,F 统计量服从 F 分布。
该分布显示仅由随机波动产生时,F 值可能有多大。我们用它来判断观察到的 F 值是否异常之大。
其原因来自 F 统计量的构造方式。
F 比值的每一部分都是方差度量。一部分捕捉模型或分组解释的变异,另一部分捕捉随机变异。当原假设为真时,两者来自同一底层方差。
简单说,F 统计量比较的是对同一方差的两个独立估计。在这种情况下,它们的比值服从 F 分布。
F 分布中的两个自由度
F 分布由两个自由度参数定义,它们决定分布的具体形状。
- 分子自由度(df₁):对应 F 统计量分子中的方差估计。
- 分母自由度(df₂):对应分母中的方差估计。
在实践中,这些数值取决于所用的统计方法。
例如:
在 ANOVA 中:
- 分子自由度 = 组数 − 1
- 分母自由度 = 总观测数 − 组数
在回归中:
- 分子自由度 = 预测变量个数
- 分母自由度 = 样本量 − 预测变量个数 − 1
这些自由度决定方差估计的波动性。自由度越小,波动越大,从而改变分布形状。
F 分布是右偏的。大多数取值靠近零,而较大取值延伸到右尾。这是因为方差估计不可能为负,因此两个方差估计的比值也只会产生正值。
自由度会影响分布的具体形状:
- 自由度较小时,分布更分散,右尾更长。
- 自由度较大时,分布更集中。
当观测到的 F 统计量落在分布的右尾远处,表示解释变异远大于未解释变异,这为拒绝原假设提供证据。
ANOVA 中的 F 统计量
在方差分析(ANOVA)中,F 统计量用于检验多个组的均值是否相等。
对单因素 ANOVA,原假设认为所有组均值相等;备择假设认为至少有一组均值不同。
该检验比较组间变异与组内变异。如果组均值之间的差异远大于组内的变异,F 值就会很大。
使用的组成部分
ANOVA 将总变异分为两部分:
- SS between(组间平方和):衡量各组均值偏离总体均值的程度
- SS within(组内平方和):衡量各观测值围绕各自组均值的波动程度
随后将它们分别除以自由度转化为均方:
- MS between 估计由组间差异解释的方差。
- MS within 估计剩余未解释的方差。
随后以这两个均方的比值计算 F 统计量。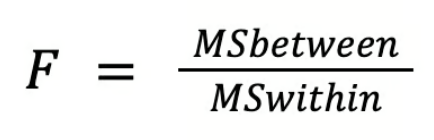
如何解释 F 值
F 值显示组间差异相对于随机变异的突出程度。可按如下方式解释:
- F 值小:组间变异与组内变异相近,均值很可能相等。
- F 值大:组间变异远大,这表明至少有一组均值不同。
关键假设
ANOVA 依赖以下假设:
- 观测相互独立
- 每组数据近似服从正态分布
- 各组方差相近
回归中的 F 统计量
在回归分析中,F 统计量用于检验模型是否优于没有任何预测变量的模型来解释数据。
对比模型仅包含截距,预测因变量的平均值。这称为总体显著性的 F 检验。其假设为:
- 原假设(H₀):无预测变量的模型与回归模型对数据的拟合同样好
- 备择假设(H₁):回归模型优于仅含截距的模型
F 统计量比较模型解释的变异与未解释的变异。
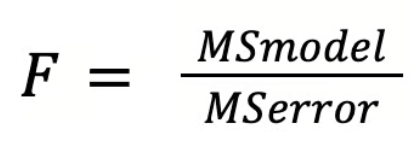
- MS model 表示由预测变量解释的方差。
- MS error 表示剩余未解释的方差。
如果解释变异远大于未解释变异,F 值会很大。这表明模型捕捉到了数据中的有意义模式。
F 统计量与 R² 的关系
F 统计量与R²密切相关,R² 衡量模型对因变量变异的解释程度。
随着模型解释的变异增多,R² 增大。这也往往会提高 F 统计量,因为解释变异相对于未解释变异变大了。
然而,两者作用不同:
- R² 显示模型解释了多少变异
- F 检验 评估这种解释的变异是否具有统计学显著性
多元回归中的解释
在多元回归中,F 检验评估模型的总体显著性。原假设认为所有回归系数均等于零:
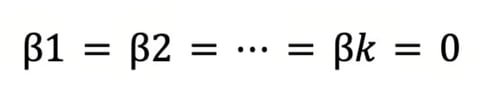
如果 F 统计量足够大,则拒绝原假设。这意味着至少有一个预测变量对因变量有非零影响。
F 检验评估的是整体模型。之后,再用 t 检验考察各个预测变量。
如何解读 F 统计量与 p 值
解读 F 检验时,请按以下步骤:
- 计算 F 统计量:F 值是两个均方的比值。具体公式取决于所用方法,如 ANOVA 或回归。
- 参考 F 分布:将计算得到的 F 值与由两个自由度确定的 F 分布进行比较:
- 计算 p 值:p 值表示在原假设为真时,观察到至少与当前一样大的 F 值的概率。
如果 p 值小于所选显著性水平,则结果被认为具有统计学显著性。
统计显著性意味着什么
具有统计显著性的 F 检验表明,模型解释的变异超出了随机机会所能产生的范围。
- 在 ANOVA 中,这表明至少有一组均值不同
- 在回归中,这表明模型优于仅含截距的模型来解释结果
统计显著性不意味着什么
显著的 F 结果也有局限:
- 它不能指出 ANOVA 中具体哪一组不同,需要事后检验
- 它不代表实际重要性。样本量很大时,即便效应很小也可能达到统计显著
因此,分析人员常会报告其他指标来了解效应强度。
与 F 检验互补的效应量指标
效应量统计用于量化模型所解释的变异有多大。
在 ANOVA 中,常见指标有:
- Eta squared(η²),用于估计由组间差异解释的方差比例。
在回归中,常见指标包括:
- R²,衡量模型解释的方差比例。
- 调整 R²,对模型中的自变量个数进行校正。
F 统计量的假设及其可能的误导
当若干关键假设得到较好满足时,F 检验表现良好。 若这些假设被违反,F 统计量可能会产生误导性结果。
观测值相互独立
数据集中的观测应彼此独立——一个观测不应影响另一个观测。
例如,若多个测量来自同一人或同一实验单元,则可能违反独立性。当观测不独立时,F 统计量可能低估变异,从而产生不可靠结果。
误差近似正态
许多 F 检验假设误差近似正态分布。简言之,观测值与模型预测之间的差异应大致呈正态模式。
随着样本量增大,该假设的重要性降低。数据足够多时,即便分布并非完全正态,F 检验通常也能较好地工作。
方差相等
经典 ANOVA 假设各组方差相近,这称为方差齐性。
如果某一组的波动远大于其他组,F 检验可能会错误地检测到组均值差异。当组大小差异很大时,这个问题会更严重。
何时 F 检验更稳健
在许多实际情境中,F 检验仍能有不错表现。
例如,当各组样本量均衡(每组观测数量相近)时,ANOVA 相当稳健。在这些情况下,适度违反正态性或方差齐性通常影响有限。
然而,当以下两种情况同时出现,问题会加剧:
这种组合可能会扭曲 F 统计量,并增加得出错误结论的风险。
当假设不满足时的替代方法
若数据不满足 F 检验的假设,可以使用更能处理这些问题的替代方法:
- Welch 的 ANOVA:适用于各组方差不等的情形
- 稳健回归方法:减小极端值或异常值的影响
- 置换检验:通过反复重排数据来估计显著性,而非依赖理论分布
人们常对 F 统计量感到困惑的点
F 统计量应用广泛,但一些点常让初学者困惑,多与其与其他统计检验的关系有关。
F 统计量 vs t 统计量
F 统计量与 t 统计量密切相关。在简单情形下,它们检验的是同一思想。
例如,当回归模型只有一个预测变量时:
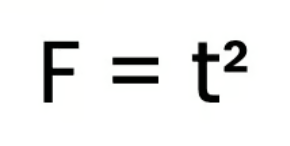
这意味着两种检验在统计显著性上的结论一致。
在更复杂的模型中,它们的作用不同。t 检验逐一评估系数,而 F 检验同时评估多个参数。
总体显著性 vs 个别系数显著性
另一个常见困惑在于模型层面与变量层面的显著性差异。
- F 检验 评估整体模型,检查模型是否优于无预测变量的模型
- t 检验 评估单个系数,检验某个特定预测变量是否显著
因此,您可能会看到如下结果:
当多个变量共同解释结果,但各自单独效应较小时,就会出现这种情况。
大样本中的大 F 值
较大的 F 值通常导致统计显著,但这并不总意味着在实践中重要。
在大样本中,即使很小的差异也可能产生显著的 F 值。模型也许解释了一些变异,但实际效应可能很小。
因此,分析人员还会关注 R² 或 eta squared 等效应量指标。
ANOVA 之后的事后检验
在 ANOVA 中,F 统计量回答的是:所有组均值是否相等?
若结果显著,说明至少有一组均值不同,但并不指出哪些组之间存在差异。
为识别具体差异,需要进行两两比较的事后检验。
常见示例包括:
- Tukey 检验:控制多重比较
- Bonferroni 校正:在进行多次检验时收紧显著性阈值
这些检验会在总体 F 检验显著之后,精确定位差异所在。
结束语
您已了解 F 统计量的工作原理,以及如何在 ANOVA 与回归中进行解读。现在,把它应用到实践中吧。
运行简单的 ANOVA 或回归分析,并将 F 值、p 值与效应量结合解读。这将帮助您从计算走向真正的解释。
如果您想夯实统计学基础,可进一步深入方差、假设检验与回归建模等核心概念。


F 统计量帮助您判断数据中的差异是有意义的,还是只是随机波动。它比较模型或分组所能解释的变异,与仍未被解释的变异。
您会在常见的统计方法中看到 F 统计量,例如 ANOVA 和回归分析。在这两种情况下,它都在回答一个基本问题:模型是否比偶然因素更好地解释数据?
在本指南中,我们将带您了解 F 统计量度量的含义、其计算方式、在 ANOVA 与回归中的出现位置,以及如何正确解释结果。
F 统计量度量了什么
F 统计量衡量模型所解释的变异是否大于随机噪声导致的变异。它比较两种方差来源:一种代表信号,另一种代表噪声。
从数学上讲,F 统计量是均方(方差)的比值:
在许多统计检验中,它写作
F 统计量比较以下两项数量。
如果组间方差远大于组内方差,F 值就会很大,这表明组间差异具有意义。若组内方差占主导,F 值会很小,这表明观察到的差异很可能是随机的。
F 统计量的应用场景
您可能会在以下统计方法中看到 F 统计量:
如何计算 F 统计量
F 统计量计算为两个均方之比。均方是方差估计,显示数据某一部分的变异程度。
通用公式如下所示: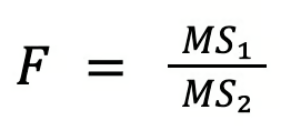
其中:
如果解释变异远大于未解释变异,F 值就会很大。这意味着模型或分组解释了有意义的差异。
尽管解释依赖于您所进行的分析,F 统计量最常用于 ANOVA 和回归分析。
一个简单的数值示例
我们通过一个简单示例来说明。
假设您正在比较三种营销活动的转化率。计算平方和并除以自由度后,得到:
现在计算 F 统计量: F = 20 / 5 = 4
因此,F 值为 4。
这意味着各活动平均值之间的变异是各活动内部变异的四倍。换言之,与各自内部的随机波动相比,活动之间的差异相对较大。
F 统计量与 F 分布
当原假设为真时,F 统计量服从 F 分布。
该分布显示仅由随机波动产生时,F 值可能有多大。我们用它来判断观察到的 F 值是否异常之大。
其原因来自 F 统计量的构造方式。
F 比值的每一部分都是方差度量。一部分捕捉模型或分组解释的变异,另一部分捕捉随机变异。当原假设为真时,两者来自同一底层方差。
简单说,F 统计量比较的是对同一方差的两个独立估计。在这种情况下,它们的比值服从 F 分布。
F 分布中的两个自由度
F 分布由两个自由度参数定义,它们决定分布的具体形状。
在实践中,这些数值取决于所用的统计方法。
例如:
在 ANOVA 中:
在回归中:
这些自由度决定方差估计的波动性。自由度越小,波动越大,从而改变分布形状。
F 分布是右偏的。大多数取值靠近零,而较大取值延伸到右尾。这是因为方差估计不可能为负,因此两个方差估计的比值也只会产生正值。
自由度会影响分布的具体形状:
当观测到的 F 统计量落在分布的右尾远处,表示解释变异远大于未解释变异,这为拒绝原假设提供证据。
ANOVA 中的 F 统计量
在方差分析(ANOVA)中,F 统计量用于检验多个组的均值是否相等。
对单因素 ANOVA,原假设认为所有组均值相等;备择假设认为至少有一组均值不同。
该检验比较组间变异与组内变异。如果组均值之间的差异远大于组内的变异,F 值就会很大。
使用的组成部分
ANOVA 将总变异分为两部分:
随后将它们分别除以自由度转化为均方:
随后以这两个均方的比值计算 F 统计量。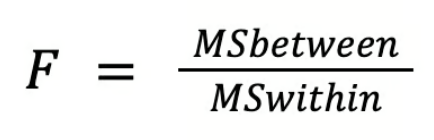
如何解释 F 值
F 值显示组间差异相对于随机变异的突出程度。可按如下方式解释:
关键假设
ANOVA 依赖以下假设:
回归中的 F 统计量
在回归分析中,F 统计量用于检验模型是否优于没有任何预测变量的模型来解释数据。
对比模型仅包含截距,预测因变量的平均值。这称为总体显著性的 F 检验。其假设为:
F 统计量比较模型解释的变异与未解释的变异。
如果解释变异远大于未解释变异,F 值会很大。这表明模型捕捉到了数据中的有意义模式。
F 统计量与 R² 的关系
F 统计量与R²密切相关,R² 衡量模型对因变量变异的解释程度。
随着模型解释的变异增多,R² 增大。这也往往会提高 F 统计量,因为解释变异相对于未解释变异变大了。
然而,两者作用不同:
多元回归中的解释
在多元回归中,F 检验评估模型的总体显著性。原假设认为所有回归系数均等于零:
如果 F 统计量足够大,则拒绝原假设。这意味着至少有一个预测变量对因变量有非零影响。
F 检验评估的是整体模型。之后,再用 t 检验考察各个预测变量。
如何解读 F 统计量与 p 值
解读 F 检验时,请按以下步骤:
如果 p 值小于所选显著性水平,则结果被认为具有统计学显著性。
统计显著性意味着什么
具有统计显著性的 F 检验表明,模型解释的变异超出了随机机会所能产生的范围。
统计显著性不意味着什么
显著的 F 结果也有局限:
因此,分析人员常会报告其他指标来了解效应强度。
与 F 检验互补的效应量指标
效应量统计用于量化模型所解释的变异有多大。
在 ANOVA 中,常见指标有:
在回归中,常见指标包括:
F 统计量的假设及其可能的误导
当若干关键假设得到较好满足时,F 检验表现良好。 若这些假设被违反,F 统计量可能会产生误导性结果。
观测值相互独立
数据集中的观测应彼此独立——一个观测不应影响另一个观测。
例如,若多个测量来自同一人或同一实验单元,则可能违反独立性。当观测不独立时,F 统计量可能低估变异,从而产生不可靠结果。
误差近似正态
许多 F 检验假设误差近似正态分布。简言之,观测值与模型预测之间的差异应大致呈正态模式。
随着样本量增大,该假设的重要性降低。数据足够多时,即便分布并非完全正态,F 检验通常也能较好地工作。
方差相等
经典 ANOVA 假设各组方差相近,这称为方差齐性。
如果某一组的波动远大于其他组,F 检验可能会错误地检测到组均值差异。当组大小差异很大时,这个问题会更严重。
何时 F 检验更稳健
在许多实际情境中,F 检验仍能有不错表现。
例如,当各组样本量均衡(每组观测数量相近)时,ANOVA 相当稳健。在这些情况下,适度违反正态性或方差齐性通常影响有限。
然而,当以下两种情况同时出现,问题会加剧:
这种组合可能会扭曲 F 统计量,并增加得出错误结论的风险。
当假设不满足时的替代方法
若数据不满足 F 检验的假设,可以使用更能处理这些问题的替代方法:
人们常对 F 统计量感到困惑的点
F 统计量应用广泛,但一些点常让初学者困惑,多与其与其他统计检验的关系有关。
F 统计量 vs t 统计量
F 统计量与 t 统计量密切相关。在简单情形下,它们检验的是同一思想。
例如,当回归模型只有一个预测变量时:
这意味着两种检验在统计显著性上的结论一致。
在更复杂的模型中,它们的作用不同。t 检验逐一评估系数,而 F 检验同时评估多个参数。
总体显著性 vs 个别系数显著性
另一个常见困惑在于模型层面与变量层面的显著性差异。
因此,您可能会看到如下结果:
当多个变量共同解释结果,但各自单独效应较小时,就会出现这种情况。
大样本中的大 F 值
较大的 F 值通常导致统计显著,但这并不总意味着在实践中重要。
在大样本中,即使很小的差异也可能产生显著的 F 值。模型也许解释了一些变异,但实际效应可能很小。
因此,分析人员还会关注 R² 或 eta squared 等效应量指标。
ANOVA 之后的事后检验
在 ANOVA 中,F 统计量回答的是:所有组均值是否相等?
若结果显著,说明至少有一组均值不同,但并不指出哪些组之间存在差异。
为识别具体差异,需要进行两两比较的事后检验。
常见示例包括:
这些检验会在总体 F 检验显著之后,精确定位差异所在。
结束语
您已了解 F 统计量的工作原理,以及如何在 ANOVA 与回归中进行解读。现在,把它应用到实践中吧。
运行简单的 ANOVA 或回归分析,并将 F 值、p 值与效应量结合解读。这将帮助您从计算走向真正的解释。
如果您想夯实统计学基础,可进一步深入方差、假设检验与回归建模等核心概念。