De F-statistiek helpt je te controleren of verschillen in data betekenisvol zijn of slechts willekeurige variatie. Hij vergelijkt de variatie die door een model of indeling wordt verklaard met de variatie die onverklaard blijft.
Je komt de F-statistiek tegen in veelgebruikte statistische methoden zoals ANOVA en regressieanalyse. In beide gevallen beantwoordt hij een basisvraag: verklaart het model de data beter dan toeval?
In deze gids leggen we uit wat de F-statistiek meet, hoe hij wordt berekend, waar hij voorkomt in ANOVA en regressie, en hoe je de resultaten correct interpreteert.
Wat de F-statistiek meet
De F-statistiek meet of de variatie die door een model wordt verklaard groter is dan de variatie veroorzaakt door willekeurige ruis. Hij vergelijkt twee bronnen van variantie: de ene staat voor het signaal en de andere voor de ruis.
Wiskundig is de F-statistiek een verhouding van mean squares (varianties):
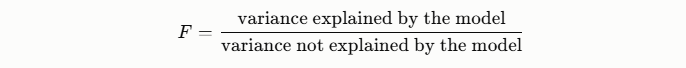
In veel statistische toetsen wordt dit geschreven als
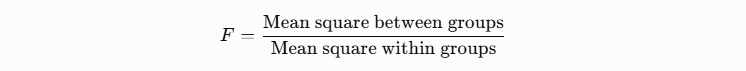
De F-statistiek vergelijkt deze twee grootheden.
- Varianties tussen groepen: Dit meet hoe verschillend de groepsgemiddelden van elkaar zijn. Grote verschillen suggereren dat de groepen zich anders gedragen.
- Varianties binnen groepen: Dit meet hoeveel de individuele waarden binnen elke groep rond hun eigen groepsgemiddelde variëren. Dit staat voor willekeurige ruis of natuurlijke variabiliteit in de data.
Als de variantie tussen groepen veel groter is, wordt de F-waarde groot. Dat wijst erop dat de verschillen tussen groepen betekenisvol zijn. Als de variantie binnen groepen domineert, wordt de F-waarde klein. Dat suggereert dat de waargenomen verschillen waarschijnlijk willekeurig zijn.
Waar de F-statistiek wordt gebruikt
Je kunt de F-statistiek tegenkomen in de volgende statistische methoden:
- Analyse van variantie (ANOVA): ANOVA gebruikt de F-statistiek om te testen of meerdere groepsgemiddelden van elkaar verschillen. Zo kun je bijvoorbeeld testen of drie marketingcampagnes verschillende gemiddelde conversieratio’s opleveren.
- Algemene significantie van de regressie: In lineaire regressie controleert de F-statistiek of het model een betekenisvol deel van de uitkomstvariabele verklaart. Simpel gezegd: hij test of de voorspellers samen de voorspelling verbeteren vergeleken met alleen het gemiddelde gebruiken.
- Geneste modellen vergelijken: De F-statistiek kan ook twee regressiemodellen vergelijken waarbij het ene model een eenvoudigere versie is van het andere. Dit helpt bepalen of extra variabelen het model genoeg verbeteren om de extra complexiteit te rechtvaardigen.
Hoe je de F-statistiek berekent
De F-statistiek wordt berekend als de verhouding van twee mean squares. Een mean square is een schatting van de variantie. Die laat zien hoeveel variatie er in een specifiek deel van de data zit.
De generieke formule ziet er zo uit: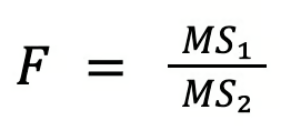
Hier:
- MS₁ staat voor variatie verklaard door een model of groeperingsstructuur.
- MS₂ staat voor variatie die onverklaard blijft.
Als de verklaarde variatie veel groter is dan de onverklaarde variatie, wordt de F-waarde groot. Dat betekent dat het model of de groepering betekenisvolle verschillen verklaart.
Hoewel de interpretatie afhangt van de analyse die je uitvoert, wordt de F-statistiek het vaakst gebruikt in ANOVA en regressieanalyse.
Een eenvoudig rekenvoorbeeld
Laten we een eenvoudig voorbeeld doornemen om dit te verduidelijken.
Stel dat je conversieratio’s vergelijkt van drie marketingcampagnes. Na het berekenen van de sommen van kwadraten en delen door de vrijheidsgraden krijg je:
- Mean square tussen groepen (MS_between) = 20
- Mean square binnen groepen (MS_within) = 5
Bereken nu de F-statistiek: F = 20 / 5 = 4
De F-waarde is dus 4.
Dit betekent dat de variatie tussen de campagnegemiddelden vier keer zo groot is als de variatie binnen elke campagne. Met andere woorden: de verschillen tussen campagnes zijn relatief groot vergeleken met de willekeurige variatie binnen de campagnes.
De F-statistiek en de F-verdeling
De F-statistiek volgt een F-verdeling wanneer de nulhypothese waar is.
Deze verdeling laat zien hoe groot de F-waarde kan worden puur door willekeurige variatie. We gebruiken haar om te checken of de waargenomen F-waarde ongewoon groot is.
De reden komt voort uit hoe de F-statistiek is opgebouwd.
Elk deel van de F-ratio is een maat voor variantie. De ene vangt variatie door het model of de groepen, de andere vangt willekeurige variatie. Als de nulhypothese waar is, komen beide uit dezelfde onderliggende variantie.
Kort gezegd vergelijkt de F-statistiek twee onafhankelijke schattingen van dezelfde variantie. In dat geval volgt hun verhouding de F-verdeling.
De twee vrijheidsgraden in de F-verdeling
De F-verdeling wordt bepaald door twee parameters voor vrijheidsgraden. Deze bepalen de exacte vorm van de verdeling.
- Vrijheidsgraden teller (df₁): komt overeen met de variantschatting in de teller van de F-statistiek.
- Vrijheidsgraden noemer (df₂): komt overeen met de variantschatting in de noemer.
In de praktijk hangen deze waarden af van de gebruikte statistische methode.
Bijvoorbeeld:
In ANOVA:
- Teller-df = aantal groepen − 1
- Noemer-df = totaal aantal observaties − aantal groepen
In regressie:
- Teller-df = aantal voorspellers
- Noemer-df = steekproefgrootte − voorspellers − 1
Deze vrijheidsgraden bepalen hoe variabel de variantschattingen zijn. Kleinere vrijheidsgraden leiden tot grotere variabiliteit, wat de vorm van de verdeling verandert.
De F-verdeling is scheef naar rechts. De meeste waarden liggen dicht bij nul, terwijl grotere waarden doorlopen in de rechterstaart. Dit komt doordat variantschattingen niet negatief kunnen zijn. De verhouding van twee variantschattingen levert daarom alleen positieve waarden op.
De vrijheidsgraden beïnvloeden de exacte vorm van de verdeling:
- Kleinere vrijheidsgraden geven een bredere verdeling met een langere rechterstaart.
- Grotere vrijheidsgraden maken de verdeling meer geconcentreerd.
Wanneer de waargenomen F-statistiek ver in de rechterstaart van de verdeling valt, duidt dit erop dat de verklaarde variatie veel groter is dan de onverklaarde variatie. Dit levert bewijs tegen de nulhypothese.
F-statistiek in ANOVA
In analyse van variantie (ANOVA) test de F-statistiek of meerdere groepsgemiddelden gelijk zijn.
Voor een eenweg-ANOVA stelt de nulhypothese dat alle groepsgemiddelden gelijk zijn. Het alternatief stelt dat ten minste één groepsgemiddelde afwijkt.
De test vergelijkt variatie tussen groepen met variatie binnen groepen. Als de verschillen tussen groepsgemiddelden veel groter zijn dan de variatie binnen de groepen, wordt de F-waarde groot.
Gebruikte componenten
ANOVA splitst de totale variatie in twee delen:
- SS tussen (sum of squares tussen groepen): Meet hoe ver elk groepsgemiddelde van het totale gemiddelde ligt
- SS binnen (sum of squares binnen groepen): Meet hoeveel observaties rond hun eigen groepsgemiddelde variëren
Deze worden vervolgens omgezet in mean squares door te delen door hun vrijheidsgraden:
- MS tussen schat de variantie verklaard door groepsverschillen.
- MS binnen schat de resterende onverklaarde variantie.
De F-statistiek wordt vervolgens berekend als de verhouding van deze twee mean squares.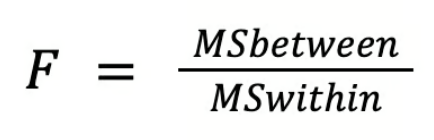
Hoe je de F-waarde interpreteert
De F-waarde laat zien hoeveel groepsverschillen opvallen vergeleken met willekeurige variatie. Je kunt hem zo interpreteren:
- Kleine F-waarde: Variatie tussen groepen lijkt op variatie binnen groepen. De gemiddelden zijn waarschijnlijk gelijk.
- Grote F-waarde: Variatie tussen groepen is veel groter. Dit suggereert dat ten minste één groepsgemiddelde anders is.
Belangrijke aannames
ANOVA steunt op een paar aannames:
- Observaties zijn onafhankelijk
- Data binnen elke groep is ongeveer normaal verdeeld
- Varianties zijn vergelijkbaar tussen groepen
F-statistiek in regressie
In regressieanalyse test de F-statistiek of het model de data beter verklaart dan een model zonder voorspellers.
Het vergelijkingsmodel bevat alleen een intercept en voorspelt de gemiddelde waarde van de uitkomst. Dit staat bekend als de F-toets van algehele significantie. De hypothesen zijn:
- Nulhypothese (H₀): Het model zonder voorspellers past de data net zo goed als het regressiemodel
- Alternatieve hypothese (H₁): Het regressiemodel past beter dan het model met alleen een intercept
De F-statistiek vergelijkt de variatie die door het model wordt verklaard met de variatie die onverklaard blijft.
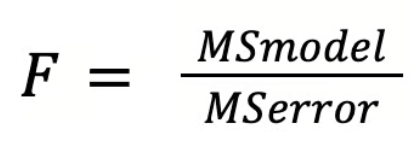
- MS model staat voor de variantie die door de voorspellers wordt verklaard.
- MS error staat voor de resterende onverklaarde variantie.
Als de verklaarde variatie veel groter is dan de onverklaarde variatie, wordt de F-waarde groot. Dit duidt erop dat het model betekenisvolle patronen in de data vastlegt.
Relatie tussen de F-statistiek en R²
De F-statistiek is nauw verwant aan R², dat meet hoeveel variatie in de uitkomstvariabele door het model wordt verklaard.
Naarmate het model meer variatie verklaart, stijgt R². Dit vergroot doorgaans ook de F-statistiek omdat de verklaarde variatie groter wordt ten opzichte van de onverklaarde variatie.
Toch hebben de twee maten verschillende doelen:
- R² laat zien hoeveel variatie het model verklaart
- F-toets beoordeelt of die verklaarde variatie statistisch significant is
Interpretatie in meervoudige regressie
In meervoudige regressie beoordeelt de F-toets de algehele significantie van het model. De nulhypothese stelt dat alle regressiecoëfficiënten gelijk zijn aan nul:
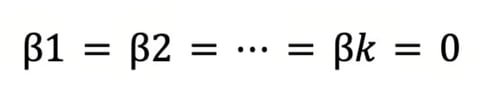
Als de F-statistiek groot genoeg is, wordt de nulhypothese verworpen. Dit betekent dat ten minste één voorspeller een niet-nul effect heeft op de uitkomstvariabele.
De F-toets beoordeelt het model als geheel. Daarna worden afzonderlijke voorspellers onderzocht met t-toetsen.
Hoe je de F-statistiek en p-waarde interpreteert
Volg deze stappen om een F-toets te interpreteren:
- Bereken de F-statistiek: De F-waarde wordt berekend als een verhouding van twee mean squares. De exacte formule hangt af van de gebruikte methode, zoals ANOVA of regressie.
- Raadpleeg de F-verdeling: De berekende F-waarde wordt vergeleken met een F-verdeling die wordt bepaald door twee vrijheidsgraden:
- Vrijheidsgraden teller (df₁)
- Vrijheidsgraden noemer (df₂)
- Bereken de p-waarde: De p-waarde staat voor de kans om een F-waarde minstens zo groot als de verkregen waarde te observeren, aangenomen dat de nulhypothese waar is.
Als de p-waarde kleiner is dan het gekozen significantieniveau, wordt het resultaat als statistisch significant beschouwd.
Wat statistische significantie betekent
Een statistisch significante F-toets laat zien dat het model variatie verklaart die verder gaat dan wat door toeval zou ontstaan.
- In ANOVA suggereert dit dat ten minste één groepsgemiddelde anders is
- In regressie suggereert dit dat het model de uitkomst beter verklaart dan een model met alleen een intercept
Wat statistische significantie niet betekent
Een significant F-resultaat kent grenzen:
- Het identificeert niet welke specifieke groep afwijkt in ANOVA. Daarvoor zijn post-hoc-toetsen nodig
- Het zegt niets over praktische relevantie. Kleine effecten kunnen nog steeds statistisch significant zijn, vooral bij grote datasets
Daarom rapporteren analisten vaak extra maten om de sterkte van het effect te begrijpen.
Effectgroottes die de F-toets aanvullen
Effectgroottes helpen te kwantificeren hoeveel variatie het model verklaart.
In ANOVA is een gangbare maat:
- Eta-kwadraat (η²), dat het aandeel variantie schat dat door groepsverschillen wordt verklaard.
In regressie zijn gangbare maten onder andere:
- R², dat het aandeel variantie meet dat door het model wordt verklaard.
- Aangepaste R², dat corrigeert voor het aantal onafhankelijke variabelen in het model.
Aannames bij de F-statistiek en wanneer die kan misleiden
De F-toets werkt goed wanneer een paar belangrijke aannames redelijkerwijs zijn vervuld. Als deze aannames worden geschonden, kan de F-statistiek misleidende resultaten opleveren.
Onafhankelijkheid van observaties
De observaties in de dataset moeten onafhankelijk van elkaar zijn — de ene observatie mag de andere niet beïnvloeden.
Als bijvoorbeeld meerdere metingen van dezelfde persoon of dezelfde experimentele eenheid komen, kan de onafhankelijkheid worden geschonden. Wanneer observaties niet onafhankelijk zijn, kan de F-statistiek de variabiliteit onderschatten en onbetrouwbare resultaten opleveren.
Ongeveer normale fouten
Veel F-toetsen gaan ervan uit dat fouten ongeveer normaal verdeeld zijn. Simpel gezegd: de verschillen tussen de geobserveerde waarden en de modelvoorspellingen zouden ruwweg een normale verdeling moeten volgen.
Deze aanname wordt minder kritisch bij grotere steekproeven. Met genoeg data werkt de F-toets vaak redelijk goed, zelfs als de verdeling niet perfect normaal is.
Gelijke varianties
Klassieke ANOVA gaat uit van vergelijkbare varianties tussen groepen. Deze voorwaarde heet homogeniteit van variantie.
Als één groep veel hogere variabiliteit heeft dan de andere, kan de F-toets ten onrechte verschillen tussen groepsgemiddelden detecteren. Het probleem wordt ernstiger wanneer de groepsgroottes sterk verschillen.
Wanneer de F-toets robuuster is
In veel praktijksituaties presteert de F-toets nog steeds redelijk goed.
ANOVA is bijvoorbeeld behoorlijk robuust wanneer de groepsgroottes in balans zijn, wat betekent dat elke groep een vergelijkbaar aantal observaties bevat. In zulke gevallen hebben matige schendingen van normaliteit of gelijke variantie vaak beperkte impact.
Problemen nemen echter toe wanneer twee omstandigheden samen voorkomen, zoals:
- Sterke verschillen in groepsvarianties
- Ongelijke groepsgroottes
Deze combinatie kan de F-statistiek vertekenen en het risico op onjuiste conclusies vergroten.
Alternatieven wanneer aannames worden geschonden
Als je data niet aan de aannames van de F-toets voldoet, kun je alternatieve methoden gebruiken die hier beter mee omgaan:
- Welch’s ANOVA: Kan omgaan met ongelijke varianties tussen groepen
- Robuuste regressiemethoden: Verminderen de invloed van extreme waarden of uitschieters
- Permutatietoetsen: Schatten significantie door de data herhaaldelijk te herschikken in plaats van te vertrouwen op theoretische verdelingen
Dingen die mensen verwarrend vinden aan de F-statistiek
De F-statistiek wordt veel gebruikt, maar een paar punten verwarren beginners vaak. De meeste daarvan hebben te maken met de relatie tot andere statistische toetsen.
F-statistiek vs t-statistiek
De F-statistiek en t-statistiek zijn nauw verwant. In eenvoudige gevallen testen ze hetzelfde idee.
Wanneer een regressiemodel bijvoorbeeld maar één voorspeller heeft:
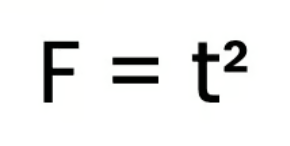
Dit betekent dat beide toetsen tot dezelfde conclusie over statistische significantie leiden.
In complexere modellen hebben ze verschillende rollen. De t-toets beoordeelt één coëfficiënt tegelijk, terwijl de F-toets meerdere parameters gezamenlijk beoordeelt.
Algehele significantie vs significantie van afzonderlijke coëfficiënten
Een ander veelvoorkomend punt van verwarring is het verschil tussen significantie op modelniveau en variabelniveau.
- De F-toets beoordeelt het model als geheel. Hij controleert of het model de uitkomst beter verklaart dan een model zonder voorspellers
- De t-toets beoordeelt individuele coëfficiënten. Hij controleert of een specifieke voorspeller een significant effect heeft
Daardoor kun je resultaten zien zoals:
- De algehele F-toets is significant
- Sommige afzonderlijke coëfficiënten zijn niet significant
Dit gebeurt wanneer meerdere variabelen samen de uitkomst verklaren, ook als elk afzonderlijk een klein effect heeft.
Grote F-waarden in grote steekproeven
Een grote F-waarde leidt vaak tot statistische significantie, maar dat betekent niet altijd dat het resultaat in de praktijk belangrijk is.
Bij grote steekproeven kunnen zelfs kleine verschillen significante F-waarden opleveren. Het model kan enige variatie verklaren, maar het effect kan in werkelijkheid klein zijn.
Daarom kijken analisten ook naar effectgroottes zoals R² of eta-kwadraat.
Post-hoc-toetsen na ANOVA
In ANOVA beantwoordt de F-statistiek één vraag: zijn alle groepsgemiddelden gelijk?
Als het resultaat significant is, laat het zien dat ten minste één groepsgemiddelde afwijkt. Het laat niet zien welke groepen verschillen.
Om de verschillen te identificeren, voeren analisten post-hoc-toetsen uit die groepen paarsgewijs vergelijken.
Veelvoorkomende voorbeelden zijn:
- Tukey’s toets: Corrigeert voor multiple comparisons
- Bonferroni-correctie: Maakt significantiedrempels strenger bij veel toetsen
Deze toetsen wijzen precies aan waar de verschillen bestaan nadat de algehele F-toets significantie aantoont.
Tot slot
Je weet nu hoe de F-statistiek werkt en hoe je die interpreteert in ANOVA en regressie. Pas dit nu toe in de praktijk.
Voer eenvoudige ANOVA- of regressie-analyses uit en let erop dat je de F-waarde, p-waarde en effectgrootte samen bekijkt. Zo ga je van rekenen naar echte interpretatie.
Wil je een sterkere basis in statistiek opbouwen, verdiep je dan in kernconcepten zoals variantie, hypothesetoetsing en regressiemodellering.




De F-statistiek helpt je te controleren of verschillen in data betekenisvol zijn of slechts willekeurige variatie. Hij vergelijkt de variatie die door een model of indeling wordt verklaard met de variatie die onverklaard blijft.
Je komt de F-statistiek tegen in veelgebruikte statistische methoden zoals ANOVA en regressieanalyse. In beide gevallen beantwoordt hij een basisvraag: verklaart het model de data beter dan toeval?
In deze gids leggen we uit wat de F-statistiek meet, hoe hij wordt berekend, waar hij voorkomt in ANOVA en regressie, en hoe je de resultaten correct interpreteert.
Wat de F-statistiek meet
De F-statistiek meet of de variatie die door een model wordt verklaard groter is dan de variatie veroorzaakt door willekeurige ruis. Hij vergelijkt twee bronnen van variantie: de ene staat voor het signaal en de andere voor de ruis.
Wiskundig is de F-statistiek een verhouding van mean squares (varianties):
In veel statistische toetsen wordt dit geschreven als
De F-statistiek vergelijkt deze twee grootheden.
Als de variantie tussen groepen veel groter is, wordt de F-waarde groot. Dat wijst erop dat de verschillen tussen groepen betekenisvol zijn. Als de variantie binnen groepen domineert, wordt de F-waarde klein. Dat suggereert dat de waargenomen verschillen waarschijnlijk willekeurig zijn.
Waar de F-statistiek wordt gebruikt
Je kunt de F-statistiek tegenkomen in de volgende statistische methoden:
Hoe je de F-statistiek berekent
De F-statistiek wordt berekend als de verhouding van twee mean squares. Een mean square is een schatting van de variantie. Die laat zien hoeveel variatie er in een specifiek deel van de data zit.
De generieke formule ziet er zo uit: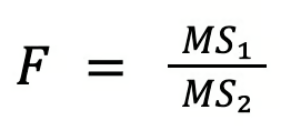
Hier:
Als de verklaarde variatie veel groter is dan de onverklaarde variatie, wordt de F-waarde groot. Dat betekent dat het model of de groepering betekenisvolle verschillen verklaart.
Hoewel de interpretatie afhangt van de analyse die je uitvoert, wordt de F-statistiek het vaakst gebruikt in ANOVA en regressieanalyse.
Een eenvoudig rekenvoorbeeld
Laten we een eenvoudig voorbeeld doornemen om dit te verduidelijken.
Stel dat je conversieratio’s vergelijkt van drie marketingcampagnes. Na het berekenen van de sommen van kwadraten en delen door de vrijheidsgraden krijg je:
Bereken nu de F-statistiek: F = 20 / 5 = 4
De F-waarde is dus 4.
Dit betekent dat de variatie tussen de campagnegemiddelden vier keer zo groot is als de variatie binnen elke campagne. Met andere woorden: de verschillen tussen campagnes zijn relatief groot vergeleken met de willekeurige variatie binnen de campagnes.
De F-statistiek en de F-verdeling
De F-statistiek volgt een F-verdeling wanneer de nulhypothese waar is.
Deze verdeling laat zien hoe groot de F-waarde kan worden puur door willekeurige variatie. We gebruiken haar om te checken of de waargenomen F-waarde ongewoon groot is.
De reden komt voort uit hoe de F-statistiek is opgebouwd.
Elk deel van de F-ratio is een maat voor variantie. De ene vangt variatie door het model of de groepen, de andere vangt willekeurige variatie. Als de nulhypothese waar is, komen beide uit dezelfde onderliggende variantie.
Kort gezegd vergelijkt de F-statistiek twee onafhankelijke schattingen van dezelfde variantie. In dat geval volgt hun verhouding de F-verdeling.
De twee vrijheidsgraden in de F-verdeling
De F-verdeling wordt bepaald door twee parameters voor vrijheidsgraden. Deze bepalen de exacte vorm van de verdeling.
In de praktijk hangen deze waarden af van de gebruikte statistische methode.
Bijvoorbeeld:
In ANOVA:
In regressie:
Deze vrijheidsgraden bepalen hoe variabel de variantschattingen zijn. Kleinere vrijheidsgraden leiden tot grotere variabiliteit, wat de vorm van de verdeling verandert.
De F-verdeling is scheef naar rechts. De meeste waarden liggen dicht bij nul, terwijl grotere waarden doorlopen in de rechterstaart. Dit komt doordat variantschattingen niet negatief kunnen zijn. De verhouding van twee variantschattingen levert daarom alleen positieve waarden op.
De vrijheidsgraden beïnvloeden de exacte vorm van de verdeling:
Wanneer de waargenomen F-statistiek ver in de rechterstaart van de verdeling valt, duidt dit erop dat de verklaarde variatie veel groter is dan de onverklaarde variatie. Dit levert bewijs tegen de nulhypothese.
F-statistiek in ANOVA
In analyse van variantie (ANOVA) test de F-statistiek of meerdere groepsgemiddelden gelijk zijn.
Voor een eenweg-ANOVA stelt de nulhypothese dat alle groepsgemiddelden gelijk zijn. Het alternatief stelt dat ten minste één groepsgemiddelde afwijkt.
De test vergelijkt variatie tussen groepen met variatie binnen groepen. Als de verschillen tussen groepsgemiddelden veel groter zijn dan de variatie binnen de groepen, wordt de F-waarde groot.
Gebruikte componenten
ANOVA splitst de totale variatie in twee delen:
Deze worden vervolgens omgezet in mean squares door te delen door hun vrijheidsgraden:
De F-statistiek wordt vervolgens berekend als de verhouding van deze twee mean squares.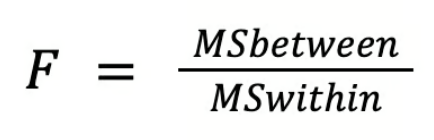
Hoe je de F-waarde interpreteert
De F-waarde laat zien hoeveel groepsverschillen opvallen vergeleken met willekeurige variatie. Je kunt hem zo interpreteren:
Belangrijke aannames
ANOVA steunt op een paar aannames:
F-statistiek in regressie
In regressieanalyse test de F-statistiek of het model de data beter verklaart dan een model zonder voorspellers.
Het vergelijkingsmodel bevat alleen een intercept en voorspelt de gemiddelde waarde van de uitkomst. Dit staat bekend als de F-toets van algehele significantie. De hypothesen zijn:
De F-statistiek vergelijkt de variatie die door het model wordt verklaard met de variatie die onverklaard blijft.
Als de verklaarde variatie veel groter is dan de onverklaarde variatie, wordt de F-waarde groot. Dit duidt erop dat het model betekenisvolle patronen in de data vastlegt.
Relatie tussen de F-statistiek en R²
De F-statistiek is nauw verwant aan R², dat meet hoeveel variatie in de uitkomstvariabele door het model wordt verklaard.
Naarmate het model meer variatie verklaart, stijgt R². Dit vergroot doorgaans ook de F-statistiek omdat de verklaarde variatie groter wordt ten opzichte van de onverklaarde variatie.
Toch hebben de twee maten verschillende doelen:
Interpretatie in meervoudige regressie
In meervoudige regressie beoordeelt de F-toets de algehele significantie van het model. De nulhypothese stelt dat alle regressiecoëfficiënten gelijk zijn aan nul:
Als de F-statistiek groot genoeg is, wordt de nulhypothese verworpen. Dit betekent dat ten minste één voorspeller een niet-nul effect heeft op de uitkomstvariabele.
De F-toets beoordeelt het model als geheel. Daarna worden afzonderlijke voorspellers onderzocht met t-toetsen.
Hoe je de F-statistiek en p-waarde interpreteert
Volg deze stappen om een F-toets te interpreteren:
Als de p-waarde kleiner is dan het gekozen significantieniveau, wordt het resultaat als statistisch significant beschouwd.
Wat statistische significantie betekent
Een statistisch significante F-toets laat zien dat het model variatie verklaart die verder gaat dan wat door toeval zou ontstaan.
Wat statistische significantie niet betekent
Een significant F-resultaat kent grenzen:
Daarom rapporteren analisten vaak extra maten om de sterkte van het effect te begrijpen.
Effectgroottes die de F-toets aanvullen
Effectgroottes helpen te kwantificeren hoeveel variatie het model verklaart.
In ANOVA is een gangbare maat:
In regressie zijn gangbare maten onder andere:
Aannames bij de F-statistiek en wanneer die kan misleiden
De F-toets werkt goed wanneer een paar belangrijke aannames redelijkerwijs zijn vervuld. Als deze aannames worden geschonden, kan de F-statistiek misleidende resultaten opleveren.
Onafhankelijkheid van observaties
De observaties in de dataset moeten onafhankelijk van elkaar zijn — de ene observatie mag de andere niet beïnvloeden.
Als bijvoorbeeld meerdere metingen van dezelfde persoon of dezelfde experimentele eenheid komen, kan de onafhankelijkheid worden geschonden. Wanneer observaties niet onafhankelijk zijn, kan de F-statistiek de variabiliteit onderschatten en onbetrouwbare resultaten opleveren.
Ongeveer normale fouten
Veel F-toetsen gaan ervan uit dat fouten ongeveer normaal verdeeld zijn. Simpel gezegd: de verschillen tussen de geobserveerde waarden en de modelvoorspellingen zouden ruwweg een normale verdeling moeten volgen.
Deze aanname wordt minder kritisch bij grotere steekproeven. Met genoeg data werkt de F-toets vaak redelijk goed, zelfs als de verdeling niet perfect normaal is.
Gelijke varianties
Klassieke ANOVA gaat uit van vergelijkbare varianties tussen groepen. Deze voorwaarde heet homogeniteit van variantie.
Als één groep veel hogere variabiliteit heeft dan de andere, kan de F-toets ten onrechte verschillen tussen groepsgemiddelden detecteren. Het probleem wordt ernstiger wanneer de groepsgroottes sterk verschillen.
Wanneer de F-toets robuuster is
In veel praktijksituaties presteert de F-toets nog steeds redelijk goed.
ANOVA is bijvoorbeeld behoorlijk robuust wanneer de groepsgroottes in balans zijn, wat betekent dat elke groep een vergelijkbaar aantal observaties bevat. In zulke gevallen hebben matige schendingen van normaliteit of gelijke variantie vaak beperkte impact.
Problemen nemen echter toe wanneer twee omstandigheden samen voorkomen, zoals:
Deze combinatie kan de F-statistiek vertekenen en het risico op onjuiste conclusies vergroten.
Alternatieven wanneer aannames worden geschonden
Als je data niet aan de aannames van de F-toets voldoet, kun je alternatieve methoden gebruiken die hier beter mee omgaan:
Dingen die mensen verwarrend vinden aan de F-statistiek
De F-statistiek wordt veel gebruikt, maar een paar punten verwarren beginners vaak. De meeste daarvan hebben te maken met de relatie tot andere statistische toetsen.
F-statistiek vs t-statistiek
De F-statistiek en t-statistiek zijn nauw verwant. In eenvoudige gevallen testen ze hetzelfde idee.
Wanneer een regressiemodel bijvoorbeeld maar één voorspeller heeft:
Dit betekent dat beide toetsen tot dezelfde conclusie over statistische significantie leiden.
In complexere modellen hebben ze verschillende rollen. De t-toets beoordeelt één coëfficiënt tegelijk, terwijl de F-toets meerdere parameters gezamenlijk beoordeelt.
Algehele significantie vs significantie van afzonderlijke coëfficiënten
Een ander veelvoorkomend punt van verwarring is het verschil tussen significantie op modelniveau en variabelniveau.
Daardoor kun je resultaten zien zoals:
Dit gebeurt wanneer meerdere variabelen samen de uitkomst verklaren, ook als elk afzonderlijk een klein effect heeft.
Grote F-waarden in grote steekproeven
Een grote F-waarde leidt vaak tot statistische significantie, maar dat betekent niet altijd dat het resultaat in de praktijk belangrijk is.
Bij grote steekproeven kunnen zelfs kleine verschillen significante F-waarden opleveren. Het model kan enige variatie verklaren, maar het effect kan in werkelijkheid klein zijn.
Daarom kijken analisten ook naar effectgroottes zoals R² of eta-kwadraat.
Post-hoc-toetsen na ANOVA
In ANOVA beantwoordt de F-statistiek één vraag: zijn alle groepsgemiddelden gelijk?
Als het resultaat significant is, laat het zien dat ten minste één groepsgemiddelde afwijkt. Het laat niet zien welke groepen verschillen.
Om de verschillen te identificeren, voeren analisten post-hoc-toetsen uit die groepen paarsgewijs vergelijken.
Veelvoorkomende voorbeelden zijn:
Deze toetsen wijzen precies aan waar de verschillen bestaan nadat de algehele F-toets significantie aantoont.
Tot slot
Je weet nu hoe de F-statistiek werkt en hoe je die interpreteert in ANOVA en regressie. Pas dit nu toe in de praktijk.
Voer eenvoudige ANOVA- of regressie-analyses uit en let erop dat je de F-waarde, p-waarde en effectgrootte samen bekijkt. Zo ga je van rekenen naar echte interpretatie.
Wil je een sterkere basis in statistiek opbouwen, verdiep je dan in kernconcepten zoals variantie, hypothesetoetsing en regressiemodellering.