La statistica F ti aiuta a verificare se le differenze nei dati sono significative o solo variazioni casuali. Confronta la variazione spiegata da un modello o da un raggruppamento con la variazione che rimane non spiegata.
Troverai la statistica F in metodi statistici comuni come l'ANOVA e l'analisi di regressione. In entrambi i casi risponde a una domanda di base: il modello spiega i dati meglio del caso?
In questa guida vedremo così misura la statistica F, come si calcola, dove compare in ANOVA e regressione e come interpretare correttamente i risultati.
Cosa misura la statistica F
La statistica F misura se la variazione spiegata da un modello è maggiore della variazione dovuta al rumore casuale. Confronta due fonti di varianza: una rappresenta il segnale e l'altra il rumore.
Matematicamente, la statistica F è un rapporto di quadrati medi (varianze):
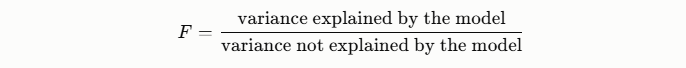
In molti test statistici, questo si scrive come
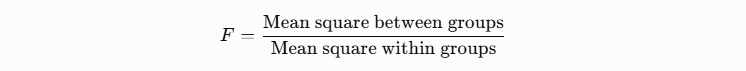
La statistica F confronta queste due quantità.
- Varianza tra gruppi: misura quanto le medie dei gruppi differiscono tra loro. Grandi differenze suggeriscono che i gruppi si comportano in modo diverso.
- Varianza entro i gruppi: misura quanto i singoli valori all'interno di ciascun gruppo variano attorno alla propria media di gruppo. Rappresenta il rumore casuale o la variabilità naturale nei dati.
Se la varianza tra gruppi è molto più grande, il valore F aumenta. Ciò suggerisce che le differenze tra gruppi sono significative. Se domina la varianza entro i gruppi, il valore F diventa piccolo. Questo suggerisce che le differenze osservate sono probabilmente casuali.
Dove si usa la statistica F
Puoi incontrare la statistica F nei seguenti metodi statistici:
- Analisi della varianza (ANOVA): l'ANOVA usa la statistica F per verificare se più medie di gruppo sono diverse. Per esempio, può testare se tre campagne di marketing producono tassi di conversione medi differenti.
- Significatività complessiva della regressione: nella regressione lineare, la statistica F verifica se il modello spiega una quota significativa della variabile dipendente. In parole semplici, testa se i predittori nel loro insieme migliorano la previsione rispetto all'uso della sola media.
- Confronto di modelli annidati: la statistica F può anche confrontare due modelli di regressione in cui uno è una versione più semplice dell'altro. Aiuta a stabilire se aggiungere variabili extra migliora abbastanza il modello da giustificarne la maggiore complessità.
Come calcolare la statistica F
La statistica F si calcola come rapporto tra due quadrati medi. Un quadrato medio rappresenta una stima della varianza. Indica quanta variazione esiste in una parte specifica dei dati.
La formula generica è questa: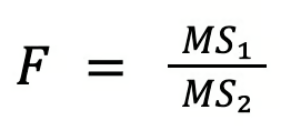
Qui:
- MS₁ rappresenta la variazione spiegata da un modello o da una struttura di raggruppamento.
- MS₂ rappresenta la variazione che rimane non spiegata.
Se la variazione spiegata è molto più grande di quella non spiegata, il valore F aumenta. Ciò significa che il modello o il raggruppamento spiega differenze significative.
Sebbene l'interpretazione dipenda dall'analisi che stai eseguendo, la statistica F è più comunemente usata in ANOVA e nell'analisi di regressione.
Un semplice esempio numerico
Vediamo un esempio semplice per chiarire.
Immagina di confrontare i tassi di conversione tra tre campagne di marketing. Dopo aver calcolato le somme dei quadrati e diviso per i gradi di libertà, ottieni:
- Quadrato medio tra gruppi (MS_between) = 20
- Quadrato medio entro i gruppi (MS_within) = 5
Ora calcola la statistica F: F = 20 / 5 = 4
Quindi, il valore F è 4.
Ciò significa che la variazione tra le medie delle campagne è quattro volte più grande della variazione all'interno di ciascuna campagna. In altre parole, le differenze tra le campagne sono relativamente grandi rispetto alla variazione casuale al loro interno.
La statistica F e la distribuzione F
La statistica F segue una distribuzione F quando l'ipotesi nulla è vera.
Questa distribuzione mostra quanto può diventare grande il valore F solo per variazione casuale. La usiamo per verificare se il valore F osservato è insolitamente grande.
Il motivo deriva da come è costruita la statistica F.
Ciascuna parte del rapporto F è una misura di varianza. Una cattura la variazione spiegata dal modello o dai gruppi, l'altra cattura la variazione casuale. Quando l'ipotesi nulla è vera, entrambe provengono dalla stessa varianza sottostante.
In poche parole, la statistica F confronta due stime indipendenti della stessa varianza. In tal caso, il loro rapporto segue la distribuzione F.
I due gradi di libertà nella distribuzione F
La distribuzione F è definita da due parametri di gradi di libertà. Questi controllano l'esatta forma della distribuzione.
- Gradi di libertà del numeratore (df₁): corrispondono alla stima della varianza al numeratore della statistica F.
- Gradi di libertà del denominatore (df₂): corrispondono alla stima della varianza al denominatore.
In pratica, questi valori dipendono dal metodo statistico utilizzato.
Per esempio:
In ANOVA:
- df del numeratore = numero di gruppi − 1
- df del denominatore = osservazioni totali − numero di gruppi
Nella regressione:
- df del numeratore = numero di predittori
- df del denominatore = dimensione del campione − predittori − 1
Questi gradi di libertà determinano quanto sono variabili le stime di varianza. Gradi di libertà più piccoli portano a maggiore variabilità, il che cambia la forma della distribuzione.
La distribuzione F è asimmetrica a destra. La maggior parte dei valori appare vicino a zero, mentre valori più grandi si estendono nella coda destra. Ciò accade perché le stime di varianza non possono essere negative. Il rapporto tra due stime di varianza, quindi, produce solo valori positivi.
I gradi di libertà influenzano l'esatta forma della distribuzione:
- Gradi di libertà più piccoli producono una distribuzione più ampia con una coda destra più lunga.
- Gradi di libertà più grandi rendono la distribuzione più concentrata.
Quando la statistica F osservata cade molto nella coda destra della distribuzione, indica che la variazione spiegata è molto più grande di quella non spiegata. Questo fornisce evidenza contro l'ipotesi nulla.
La statistica F nell'ANOVA
Nell'analisi della varianza (ANOVA), la statistica F verifica se più medie di gruppo sono uguali.
Per una ANOVA a una via, l'ipotesi nulla afferma che tutte le medie dei gruppi sono uguali. L'alternativa afferma che almeno una media di gruppo è diversa.
Il test confronta la variazione tra gruppi con la variazione entro i gruppi. Se le differenze tra le medie dei gruppi sono molto più grandi della variazione all'interno dei gruppi, il valore F aumenta.
Componenti utilizzati
L'ANOVA suddivide la variazione totale in due parti:
- SS between (somma dei quadrati tra gruppi): misura quanto ciascuna media di gruppo si discosta dalla media complessiva
- SS within (somma dei quadrati entro i gruppi): misura quanto le osservazioni variano attorno alla propria media di gruppo
Questi poi vengono convertiti in quadrati medi dividendo per i rispettivi gradi di libertà:
- MS between stima la varianza spiegata dalle differenze tra gruppi.
- MS within stima la varianza rimanente non spiegata.
La statistica F viene quindi calcolata come rapporto tra questi due quadrati medi.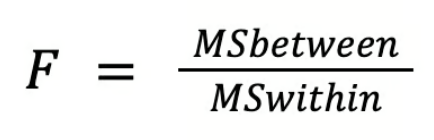
Come interpretare il valore F
Il valore F mostra quanto le differenze tra gruppi spiccano rispetto alla variazione casuale. Puoi interpretarlo così:
- Valore F piccolo: la variazione tra gruppi è simile alla variazione entro i gruppi. Le medie sono probabilmente uguali.
- Valore F grande: la variazione tra gruppi è molto più grande. Ciò suggerisce che almeno una media di gruppo è diversa.
Assunzioni chiave
L'ANOVA si basa su alcune assunzioni:
- Le osservazioni sono indipendenti
- I dati all'interno di ciascun gruppo sono approssimativamente distribuiti in modo normale
- Le varianze tra i gruppi sono simili
La statistica F nella regressione
Nell'analisi di regressione, la statistica F verifica se il modello spiega i dati meglio di un modello senza predittori.
Il modello di confronto include solo un intercetta e predice il valore medio dell'esito. Questo è noto come test F di significatività complessiva. Le ipotesi sono:
- Ipotesi nulla (H₀): il modello senza predittori si adatta ai dati altrettanto bene del modello di regressione
- Ipotesi alternativa (H₁): il modello di regressione fornisce un adattamento migliore del modello con sola intercetta
La statistica F confronta la variazione spiegata dal modello con la variazione che rimane non spiegata.
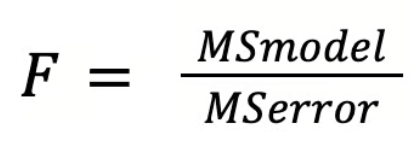
- MS model rappresenta la varianza spiegata dai predittori.
- MS error rappresenta la varianza rimanente non spiegata.
Se la variazione spiegata è molto più grande di quella non spiegata, il valore F aumenta. Ciò indica che il modello cattura schemi significativi nei dati.
Relazione tra la statistica F e R²
La statistica F è strettamente correlata a R², che misura quanta variazione della variabile di esito è spiegata dal modello.
Man mano che il modello spiega più variazione, R² aumenta. Questo tende anche ad aumentare la statistica F perché la variazione spiegata diventa maggiore rispetto a quella non spiegata.
Tuttavia, le due misure hanno scopi diversi:
- R² mostra quanta variazione spiega il modello
- Il test F valuta se quella variazione spiegata è statisticamente significativa
Interpretazione nella regressione multipla
Nella regressione multipla, il test F valuta la significatività complessiva del modello. L'ipotesi nulla afferma che tutti i coefficienti di regressione sono uguali a zero:
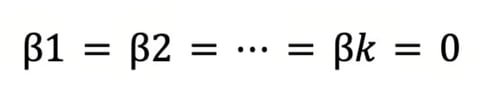
Se la statistica F è sufficientemente grande, l'ipotesi nulla viene rifiutata. Ciò significa che almeno un predittore ha un effetto diverso da zero sulla variabile di esito.
Il test F valuta il modello nel suo insieme. Dopo di che, i singoli predittori vengono esaminati con test t.
Come interpretare la statistica F e il p-value
Per interpretare un test F, segui questi passaggi:
- Calcola la statistica F: il valore F è calcolato come rapporto tra due quadrati medi. La formula esatta dipende dal metodo utilizzato, come ANOVA o regressione.
- Riferisciti alla distribuzione F: il valore F calcolato viene confrontato con una distribuzione F definita da due gradi di libertà:
- Gradi di libertà del numeratore (df₁)
- Gradi di libertà del denominatore (df₂)
- Calcola il p-value: il p-value rappresenta la probabilità di osservare un valore F almeno grande quanto quello ottenuto, assumendo che l'ipotesi nulla sia vera.
Se il p-value è inferiore al livello di significatività scelto, il risultato è considerato statisticamente significativo.
Cosa significa significatività statistica
Un test F statisticamente significativo mostra che il modello spiega variazione oltre quanto produrrebbe il caso.
- In ANOVA, ciò suggerisce che almeno una media di gruppo è diversa
- Nella regressione, suggerisce che il modello spiega l'esito meglio di un modello con sola intercetta
Cosa non significa significatività statistica
Un risultato F significativo ha dei limiti:
- Non identifica quale specifico gruppo differisce in ANOVA. Servono test post hoc
- Non indica l'importanza pratica. Effetti piccoli possono essere comunque statisticamente significativi, specialmente con dataset ampi
Per questo, spesso si riportano misure aggiuntive per comprendere l'entità dell'effetto.
Misure di dimensione dell'effetto che completano il test F
Le statistiche di dimensione dell'effetto aiutano a quantificare quanta variazione spiega il modello.
In ANOVA, una misura comune è:
- Eta quadrato (η²), che stima la quota di varianza spiegata dalle differenze tra gruppi.
Nella regressione, misure comuni includono:
- R², che misura la quota di varianza spiegata dal modello.
- R² aggiustato, che tiene conto del numero di variabili indipendenti nel modello.
Assunzioni della statistica F e quando può trarre in inganno
Il test F funziona bene quando alcune assunzioni chiave sono ragionevolmente soddisfatte. Se queste assunzioni vengono violate, la statistica F può produrre risultati fuorvianti.
Indipendenza delle osservazioni
Le osservazioni nel dataset dovrebbero essere indipendenti tra loro: una osservazione non dovrebbe influenzarne un'altra.
Per esempio, se più misurazioni provengono dalla stessa persona o dalla stessa unità sperimentale, l'indipendenza potrebbe essere violata. Quando le osservazioni non sono indipendenti, la statistica F può sottostimare la variabilità e produrre risultati inaffidabili.
Errori approssimativamente normali
Molti test F assumono che gli errori siano approssimativamente distribuiti in modo normale. In parole semplici, le differenze tra i valori osservati e le previsioni del modello dovrebbero seguire un andamento grossomodo normale.
Questa assunzione diventa meno critica con campioni più grandi. Con abbastanza dati, il test F spesso funziona ragionevolmente bene anche se la distribuzione non è perfettamente normale.
Varianze uguali
L'ANOVA classica assume che le varianze tra i gruppi siano simili. Questa condizione si chiama omogeneità della varianza.
Se un gruppo ha una variabilità molto più alta degli altri, il test F potrebbe rilevare erroneamente differenze tra le medie dei gruppi. Il problema peggiora quando le dimensioni dei gruppi sono molto diverse.
Quando il test F è più robusto
In molte situazioni pratiche, il test F offre comunque prestazioni ragionevoli.
Per esempio, l'ANOVA è abbastanza robusta quando le dimensioni dei gruppi sono bilanciate, cioè ogni gruppo contiene un numero simile di osservazioni. In questi casi, violazioni moderate della normalità o dell'uguaglianza delle varianze hanno spesso un impatto limitato.
Tuttavia, i problemi aumentano quando si verificano insieme due condizioni come:
- Forti differenze nelle varianze tra gruppi
- Dimensioni dei gruppi diseguali
Questa combinazione può distorcere la statistica F e aumentare il rischio di conclusioni errate.
Alternative quando le assunzioni sono violate
Se i tuoi dati non rispettano le assunzioni del test F, puoi usare metodi alternativi che gestiscono meglio questi problemi:
- ANOVA di Welch: gestisce varianze disuguali tra gruppi
- Metodi di regressione robusta: riducono l'impatto di valori estremi o outlier
- Test di permutazione: stimano la significatività rimescolando ripetutamente i dati invece di basarsi su distribuzioni teoriche
Cose che confondono le persone sulla statistica F
La statistica F è molto utilizzata, ma alcuni punti confondono spesso chi inizia. Molti derivano da come si relaziona ad altri test statistici.
Statistica F vs statistica t
La statistica F e la statistica t sono strettamente correlate. Nei casi semplici, testano la stessa idea.
Per esempio, quando un modello di regressione ha un solo predittore:
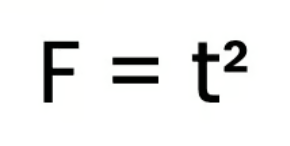
Ciò significa che entrambi i test portano alla stessa conclusione sulla significatività statistica.
Nei modelli più complessi, svolgono ruoli diversi. Il test t valuta un coefficiente alla volta, mentre il test F valuta più parametri insieme.
Significatività complessiva vs significatività dei singoli coefficienti
Un altro punto di confusione comune è la differenza tra significatività a livello di modello e a livello di variabile.
- Il test F valuta il modello nel suo complesso. Verifica se il modello spiega l'esito meglio di un modello senza predittori
- Il test t valuta i singoli coefficienti. Verifica se un predittore specifico ha un effetto significativo
Per questo, puoi vedere risultati come:
- Il test F complessivo è significativo
- Alcuni coefficienti individuali non sono significativi
Ciò accade quando più variabili insieme spiegano l'esito, anche se ciascuna ha un piccolo effetto individuale.
Valori F grandi in campioni grandi
Un valore F grande spesso porta a significatività statistica, ma non significa sempre che il risultato sia importante nella pratica.
Con campioni di grandi dimensioni, anche differenze piccole possono produrre valori F significativi. Il modello può spiegare una parte di variazione, ma l'effetto può essere piccolo in termini reali.
Ecco perché gli analisti guardano anche a misure di dimensione dell'effetto come R² o eta quadrato.
Test post hoc dopo ANOVA
In ANOVA, la statistica F risponde a una domanda: tutte le medie di gruppo sono uguali?
Se il risultato è significativo, mostra che almeno una media di gruppo è diversa. Non mostra quali gruppi differiscono.
Per identificare le differenze, gli analisti eseguono test post hoc che confrontano i gruppi a coppie.
Esempi comuni includono:
- Test di Tukey: controlla per confronti multipli
- Correzione di Bonferroni: restringe le soglie di significatività quando si eseguono molti test
Questi test individuano esattamente dove esistono le differenze dopo che il test F complessivo mostra significatività.
Considerazioni finali
Ora sai come funziona la statistica F e come interpretarla in ANOVA e in regressione. È il momento di applicarla nella pratica.
Esegui semplici analisi ANOVA o di regressione e concentra l'attenzione sulla lettura congiunta di valore F, p-value e dimensione dell'effetto. Questo ti aiuterà a passare dal calcolo all'interpretazione reale.
Se vuoi costruire una base più solida di statistica, approfondisci concetti chiave come varianza, test di ipotesi e modellazione di regressione.





La statistica F ti aiuta a verificare se le differenze nei dati sono significative o solo variazioni casuali. Confronta la variazione spiegata da un modello o da un raggruppamento con la variazione che rimane non spiegata.
Troverai la statistica F in metodi statistici comuni come l'ANOVA e l'analisi di regressione. In entrambi i casi risponde a una domanda di base: il modello spiega i dati meglio del caso?
In questa guida vedremo così misura la statistica F, come si calcola, dove compare in ANOVA e regressione e come interpretare correttamente i risultati.
Cosa misura la statistica F
La statistica F misura se la variazione spiegata da un modello è maggiore della variazione dovuta al rumore casuale. Confronta due fonti di varianza: una rappresenta il segnale e l'altra il rumore.
Matematicamente, la statistica F è un rapporto di quadrati medi (varianze):
In molti test statistici, questo si scrive come
La statistica F confronta queste due quantità.
Se la varianza tra gruppi è molto più grande, il valore F aumenta. Ciò suggerisce che le differenze tra gruppi sono significative. Se domina la varianza entro i gruppi, il valore F diventa piccolo. Questo suggerisce che le differenze osservate sono probabilmente casuali.
Dove si usa la statistica F
Puoi incontrare la statistica F nei seguenti metodi statistici:
Come calcolare la statistica F
La statistica F si calcola come rapporto tra due quadrati medi. Un quadrato medio rappresenta una stima della varianza. Indica quanta variazione esiste in una parte specifica dei dati.
La formula generica è questa: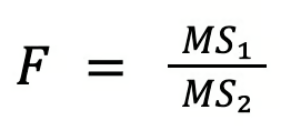
Qui:
Se la variazione spiegata è molto più grande di quella non spiegata, il valore F aumenta. Ciò significa che il modello o il raggruppamento spiega differenze significative.
Sebbene l'interpretazione dipenda dall'analisi che stai eseguendo, la statistica F è più comunemente usata in ANOVA e nell'analisi di regressione.
Un semplice esempio numerico
Vediamo un esempio semplice per chiarire.
Immagina di confrontare i tassi di conversione tra tre campagne di marketing. Dopo aver calcolato le somme dei quadrati e diviso per i gradi di libertà, ottieni:
Ora calcola la statistica F: F = 20 / 5 = 4
Quindi, il valore F è 4.
Ciò significa che la variazione tra le medie delle campagne è quattro volte più grande della variazione all'interno di ciascuna campagna. In altre parole, le differenze tra le campagne sono relativamente grandi rispetto alla variazione casuale al loro interno.
La statistica F e la distribuzione F
La statistica F segue una distribuzione F quando l'ipotesi nulla è vera.
Questa distribuzione mostra quanto può diventare grande il valore F solo per variazione casuale. La usiamo per verificare se il valore F osservato è insolitamente grande.
Il motivo deriva da come è costruita la statistica F.
Ciascuna parte del rapporto F è una misura di varianza. Una cattura la variazione spiegata dal modello o dai gruppi, l'altra cattura la variazione casuale. Quando l'ipotesi nulla è vera, entrambe provengono dalla stessa varianza sottostante.
In poche parole, la statistica F confronta due stime indipendenti della stessa varianza. In tal caso, il loro rapporto segue la distribuzione F.
I due gradi di libertà nella distribuzione F
La distribuzione F è definita da due parametri di gradi di libertà. Questi controllano l'esatta forma della distribuzione.
In pratica, questi valori dipendono dal metodo statistico utilizzato.
Per esempio:
In ANOVA:
Nella regressione:
Questi gradi di libertà determinano quanto sono variabili le stime di varianza. Gradi di libertà più piccoli portano a maggiore variabilità, il che cambia la forma della distribuzione.
La distribuzione F è asimmetrica a destra. La maggior parte dei valori appare vicino a zero, mentre valori più grandi si estendono nella coda destra. Ciò accade perché le stime di varianza non possono essere negative. Il rapporto tra due stime di varianza, quindi, produce solo valori positivi.
I gradi di libertà influenzano l'esatta forma della distribuzione:
Quando la statistica F osservata cade molto nella coda destra della distribuzione, indica che la variazione spiegata è molto più grande di quella non spiegata. Questo fornisce evidenza contro l'ipotesi nulla.
La statistica F nell'ANOVA
Nell'analisi della varianza (ANOVA), la statistica F verifica se più medie di gruppo sono uguali.
Per una ANOVA a una via, l'ipotesi nulla afferma che tutte le medie dei gruppi sono uguali. L'alternativa afferma che almeno una media di gruppo è diversa.
Il test confronta la variazione tra gruppi con la variazione entro i gruppi. Se le differenze tra le medie dei gruppi sono molto più grandi della variazione all'interno dei gruppi, il valore F aumenta.
Componenti utilizzati
L'ANOVA suddivide la variazione totale in due parti:
Questi poi vengono convertiti in quadrati medi dividendo per i rispettivi gradi di libertà:
La statistica F viene quindi calcolata come rapporto tra questi due quadrati medi.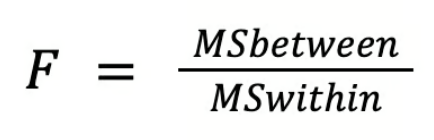
Come interpretare il valore F
Il valore F mostra quanto le differenze tra gruppi spiccano rispetto alla variazione casuale. Puoi interpretarlo così:
Assunzioni chiave
L'ANOVA si basa su alcune assunzioni:
La statistica F nella regressione
Nell'analisi di regressione, la statistica F verifica se il modello spiega i dati meglio di un modello senza predittori.
Il modello di confronto include solo un intercetta e predice il valore medio dell'esito. Questo è noto come test F di significatività complessiva. Le ipotesi sono:
La statistica F confronta la variazione spiegata dal modello con la variazione che rimane non spiegata.
Se la variazione spiegata è molto più grande di quella non spiegata, il valore F aumenta. Ciò indica che il modello cattura schemi significativi nei dati.
Relazione tra la statistica F e R²
La statistica F è strettamente correlata a R², che misura quanta variazione della variabile di esito è spiegata dal modello.
Man mano che il modello spiega più variazione, R² aumenta. Questo tende anche ad aumentare la statistica F perché la variazione spiegata diventa maggiore rispetto a quella non spiegata.
Tuttavia, le due misure hanno scopi diversi:
Interpretazione nella regressione multipla
Nella regressione multipla, il test F valuta la significatività complessiva del modello. L'ipotesi nulla afferma che tutti i coefficienti di regressione sono uguali a zero:
Se la statistica F è sufficientemente grande, l'ipotesi nulla viene rifiutata. Ciò significa che almeno un predittore ha un effetto diverso da zero sulla variabile di esito.
Il test F valuta il modello nel suo insieme. Dopo di che, i singoli predittori vengono esaminati con test t.
Come interpretare la statistica F e il p-value
Per interpretare un test F, segui questi passaggi:
Se il p-value è inferiore al livello di significatività scelto, il risultato è considerato statisticamente significativo.
Cosa significa significatività statistica
Un test F statisticamente significativo mostra che il modello spiega variazione oltre quanto produrrebbe il caso.
Cosa non significa significatività statistica
Un risultato F significativo ha dei limiti:
Per questo, spesso si riportano misure aggiuntive per comprendere l'entità dell'effetto.
Misure di dimensione dell'effetto che completano il test F
Le statistiche di dimensione dell'effetto aiutano a quantificare quanta variazione spiega il modello.
In ANOVA, una misura comune è:
Nella regressione, misure comuni includono:
Assunzioni della statistica F e quando può trarre in inganno
Il test F funziona bene quando alcune assunzioni chiave sono ragionevolmente soddisfatte. Se queste assunzioni vengono violate, la statistica F può produrre risultati fuorvianti.
Indipendenza delle osservazioni
Le osservazioni nel dataset dovrebbero essere indipendenti tra loro: una osservazione non dovrebbe influenzarne un'altra.
Per esempio, se più misurazioni provengono dalla stessa persona o dalla stessa unità sperimentale, l'indipendenza potrebbe essere violata. Quando le osservazioni non sono indipendenti, la statistica F può sottostimare la variabilità e produrre risultati inaffidabili.
Errori approssimativamente normali
Molti test F assumono che gli errori siano approssimativamente distribuiti in modo normale. In parole semplici, le differenze tra i valori osservati e le previsioni del modello dovrebbero seguire un andamento grossomodo normale.
Questa assunzione diventa meno critica con campioni più grandi. Con abbastanza dati, il test F spesso funziona ragionevolmente bene anche se la distribuzione non è perfettamente normale.
Varianze uguali
L'ANOVA classica assume che le varianze tra i gruppi siano simili. Questa condizione si chiama omogeneità della varianza.
Se un gruppo ha una variabilità molto più alta degli altri, il test F potrebbe rilevare erroneamente differenze tra le medie dei gruppi. Il problema peggiora quando le dimensioni dei gruppi sono molto diverse.
Quando il test F è più robusto
In molte situazioni pratiche, il test F offre comunque prestazioni ragionevoli.
Per esempio, l'ANOVA è abbastanza robusta quando le dimensioni dei gruppi sono bilanciate, cioè ogni gruppo contiene un numero simile di osservazioni. In questi casi, violazioni moderate della normalità o dell'uguaglianza delle varianze hanno spesso un impatto limitato.
Tuttavia, i problemi aumentano quando si verificano insieme due condizioni come:
Questa combinazione può distorcere la statistica F e aumentare il rischio di conclusioni errate.
Alternative quando le assunzioni sono violate
Se i tuoi dati non rispettano le assunzioni del test F, puoi usare metodi alternativi che gestiscono meglio questi problemi:
Cose che confondono le persone sulla statistica F
La statistica F è molto utilizzata, ma alcuni punti confondono spesso chi inizia. Molti derivano da come si relaziona ad altri test statistici.
Statistica F vs statistica t
La statistica F e la statistica t sono strettamente correlate. Nei casi semplici, testano la stessa idea.
Per esempio, quando un modello di regressione ha un solo predittore:
Ciò significa che entrambi i test portano alla stessa conclusione sulla significatività statistica.
Nei modelli più complessi, svolgono ruoli diversi. Il test t valuta un coefficiente alla volta, mentre il test F valuta più parametri insieme.
Significatività complessiva vs significatività dei singoli coefficienti
Un altro punto di confusione comune è la differenza tra significatività a livello di modello e a livello di variabile.
Per questo, puoi vedere risultati come:
Ciò accade quando più variabili insieme spiegano l'esito, anche se ciascuna ha un piccolo effetto individuale.
Valori F grandi in campioni grandi
Un valore F grande spesso porta a significatività statistica, ma non significa sempre che il risultato sia importante nella pratica.
Con campioni di grandi dimensioni, anche differenze piccole possono produrre valori F significativi. Il modello può spiegare una parte di variazione, ma l'effetto può essere piccolo in termini reali.
Ecco perché gli analisti guardano anche a misure di dimensione dell'effetto come R² o eta quadrato.
Test post hoc dopo ANOVA
In ANOVA, la statistica F risponde a una domanda: tutte le medie di gruppo sono uguali?
Se il risultato è significativo, mostra che almeno una media di gruppo è diversa. Non mostra quali gruppi differiscono.
Per identificare le differenze, gli analisti eseguono test post hoc che confrontano i gruppi a coppie.
Esempi comuni includono:
Questi test individuano esattamente dove esistono le differenze dopo che il test F complessivo mostra significatività.
Considerazioni finali
Ora sai come funziona la statistica F e come interpretarla in ANOVA e in regressione. È il momento di applicarla nella pratica.
Esegui semplici analisi ANOVA o di regressione e concentra l'attenzione sulla lettura congiunta di valore F, p-value e dimensione dell'effetto. Questo ti aiuterà a passare dal calcolo all'interpretazione reale.
Se vuoi costruire una base più solida di statistica, approfondisci concetti chiave come varianza, test di ipotesi e modellazione di regressione.