La statistique F vous aide à vérifier si les différences observées dans les données sont significatives ou simplement dues au hasard. Elle compare la part de variation expliquée par un modèle ou un regroupement à la variation qui reste inexpliquée.
Vous rencontrerez la statistique F dans des méthodes courantes comme l’ANOVA et l’analyse de régression. Dans les deux cas, elle répond à une question simple : le modèle explique-t-il les données mieux que le hasard ?
Dans ce guide, nous allons voir ce que mesure la statistique F, comment elle se calcule, où elle intervient en ANOVA et en régression, et comment en interpréter correctement les résultats.
Ce que mesure la statistique F
La statistique F évalue si la variation expliquée par un modèle est plus grande que celle due au bruit aléatoire. Elle compare deux sources de variance : l’une représente le signal et l’autre le bruit.
Mathématiquement, la statistique F est un ratio de carrés moyens (variances) :
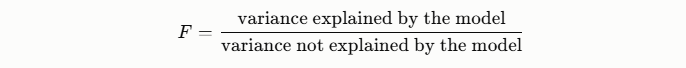
Dans de nombreux tests statistiques, cela s’écrit
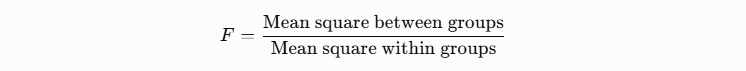
La statistique F compare ces deux quantités.
- Variance intergroupes : mesure dans quelle mesure les moyennes des groupes diffèrent entre elles. De grandes différences suggèrent des comportements de groupe distincts.
- Variance intragroupe : mesure l’écart des valeurs individuelles autour de la moyenne de leur propre groupe. Elle représente le bruit aléatoire ou la variabilité naturelle des données.
Si la variance intergroupes est bien plus grande, la valeur de F devient élevée, ce qui suggère que les différences entre groupes sont significatives. Si la variance intragroupe domine, la valeur de F est faible, ce qui suggère que les différences observées sont probablement aléatoires.
Où la statistique F est utilisée
Vous pouvez voir la statistique F dans les méthodes suivantes :
- Analyse de la variance (ANOVA) : l’ANOVA utilise la statistique F pour tester si plusieurs moyennes de groupes diffèrent. Par exemple, elle peut tester si trois campagnes marketing produisent des taux de conversion moyens différents.
- Significativité globale de la régression : en régression linéaire, la statistique F vérifie si le modèle explique une part significative de la variable à prédire. En termes simples, elle teste si les prédicteurs, pris ensemble, améliorent la prédiction par rapport à l’utilisation de la moyenne seule.
- Comparaison de modèles emboîtés : la statistique F peut également comparer deux modèles de régression lorsque l’un est une version plus simple de l’autre. Cela permet de déterminer si l’ajout de variables améliore suffisamment le modèle pour justifier la complexité supplémentaire.
La statistique F se calcule comme le ratio de deux carrés moyens. Un carré moyen est une estimation de variance. Il montre l’ampleur de la variation dans une partie spécifique des données.
La formule générique ressemble à ceci :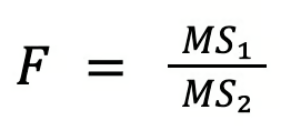
Ici :
- MS₁ représente la variation expliquée par un modèle ou une structure de regroupement.
- MS₂ représente la variation qui reste inexpliquée.
Si la variation expliquée est bien plus grande que la variation inexpliquée, la valeur de F augmente. Cela signifie que le modèle ou le regroupement met en évidence des différences réelles.
Même si l’interprétation dépend de l’analyse menée, la statistique F est le plus souvent utilisée en ANOVA et en analyse de régression.
Un exemple numérique simple
Voyons un exemple simple pour clarifier.
Imaginez que vous compariez les taux de conversion de trois campagnes marketing. Après avoir calculé les sommes des carrés et divisé par les degrés de liberté, vous obtenez :
- Carré moyen intergroupes (MS_between) = 20
- Carré moyen intragroupe (MS_within) = 5
Calculez alors la statistique F : F = 20 / 5 = 4
La valeur de F est donc 4.
Cela signifie que la variation entre les moyennes des campagnes est quatre fois plus grande que la variation au sein de chaque campagne. Autrement dit, les différences entre campagnes sont relativement importantes par rapport à la variation aléatoire interne.
La statistique F et la loi de Fisher (F)
Lorsque l’hypothèse nulle est vraie, la statistique F suit une loi F.
Cette distribution indique jusqu’où la valeur de F peut aller sous l’effet du hasard. Nous l’utilisons pour vérifier si la valeur de F observée est inhabituellement élevée.
La raison tient à la construction de la statistique F.
Chaque terme du ratio F est une mesure de variance. L’un capte la variation expliquée par le modèle ou les groupes, l’autre capte la variation aléatoire. Quand l’hypothèse nulle est vraie, les deux proviennent de la même variance sous-jacente.
En bref, la statistique F compare deux estimations indépendantes d’une même variance. Dans ce cas, leur ratio suit la loi F.
Les deux degrés de liberté de la loi F
La loi F est définie par deux paramètres de degrés de liberté, qui en déterminent la forme exacte.
- Degrés de liberté du numérateur (df₁) : correspondent à l’estimation de variance au numérateur de la statistique F.
- Degrés de liberté du dénominateur (df₂) : correspondent à l’estimation de variance au dénominateur.
En pratique, ces valeurs dépendent de la méthode statistique utilisée.
Par exemple :
En ANOVA :
- df du numérateur = nombre de groupes − 1
- df du dénominateur = nombre total d’observations − nombre de groupes
En régression :
- df du numérateur = nombre de prédicteurs
- df du dénominateur = taille de l’échantillon − prédicteurs − 1
Ces degrés de liberté déterminent la variabilité des estimations de variance. Plus ils sont faibles, plus la variabilité est grande, ce qui modifie la forme de la distribution.
La loi F est asymétrique vers la droite. La plupart des valeurs se situent près de zéro et les plus grandes s’étendent dans la queue droite. Cela vient du fait qu’une variance ne peut pas être négative. Le ratio de deux variances ne produit donc que des valeurs positives.
Les degrés de liberté influencent la forme exacte de la distribution :
- Des degrés de liberté plus faibles produisent une distribution plus étalée avec une longue queue à droite.
- Des degrés de liberté plus élevés rendent la distribution plus concentrée.
Quand la statistique F observée se situe loin dans la queue droite, cela indique que la variation expliquée est bien supérieure à la variation inexpliquée. Cela constitue un argument contre l’hypothèse nulle.
Statistique F en ANOVA
En analyse de variance (ANOVA), la statistique F teste l’égalité de plusieurs moyennes de groupes.
Pour une ANOVA à un facteur, l’hypothèse nulle stipule que toutes les moyennes de groupes sont égales. L’hypothèse alternative stipule qu’au moins une moyenne diffère.
Le test compare la variation entre groupes à la variation au sein des groupes. Si les différences entre moyennes de groupe sont bien plus grandes que la variation interne, la valeur de F augmente.
Composants utilisés
L’ANOVA décompose la variation totale en deux parties :
- SS inter (somme des carrés entre groupes) : mesure l’écart de chaque moyenne de groupe par rapport à la moyenne générale
- SS intra (somme des carrés intragroupes) : mesure l’ampleur des écarts des observations autour de la moyenne de leur groupe
On les convertit ensuite en carrés moyens en les divisant par leurs degrés de liberté :
- MS inter estime la variance expliquée par les différences entre groupes.
- MS intra estime la variance restante inexpliquée.
La statistique F est alors calculée comme le ratio de ces deux carrés moyens.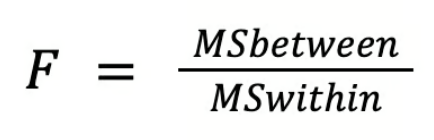
La valeur de F indique à quel point les différences entre groupes ressortent par rapport à la variation aléatoire. Vous pouvez l’interpréter ainsi :
- Petite valeur de F : la variation entre groupes est similaire à la variation intragroupe. Les moyennes sont probablement égales.
- Grande valeur de F : la variation intergroupes est bien plus importante, ce qui suggère qu’au moins une moyenne de groupe diffère.
Hypothèses clés
L’ANOVA repose sur quelques hypothèses :
- Indépendance des observations
- Distribution approximativement normale des données dans chaque groupe
- Variances similaires entre groupes
Statistique F en régression
En analyse de régression, la statistique F teste si le modèle explique mieux les données qu’un modèle sans prédicteurs.
Le modèle de comparaison ne contient qu’une constante et prédit la valeur moyenne de la cible. C’est ce que l’on appelle le test F de significativité globale. Les hypothèses sont :
- Hypothèse nulle (H₀) : le modèle sans prédicteurs ajuste les données aussi bien que le modèle de régression
- Hypothèse alternative (H₁) : le modèle de régression ajuste mieux les données que le modèle à constante seule
La statistique F compare la variation expliquée par le modèle à la variation qui reste inexpliquée.
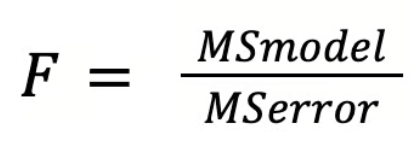
- MS modèle représente la variance expliquée par les prédicteurs.
- MS erreur représente la variance restante inexpliquée.
Si la variation expliquée est bien plus grande que la variation inexpliquée, la valeur de F devient élevée. Cela indique que le modèle capte des tendances pertinentes dans les données.
Lien entre la statistique F et R²
La statistique F est étroitement liée à R², qui mesure la part de variation de la variable cible expliquée par le modèle.
À mesure que le modèle explique davantage de variation, R² augmente. La statistique F a alors tendance à augmenter également, car la variation expliquée devient plus grande relativement à la variation inexpliquée.
Cependant, ces mesures poursuivent des objectifs différents :
- R² indique la part de variation expliquée par le modèle
- Le test F évalue si cette variation expliquée est statistiquement significative
Interprétation en régression multiple
En régression multiple, le test F évalue la significativité globale du modèle. L’hypothèse nulle stipule que tous les coefficients de régression sont égaux à zéro :
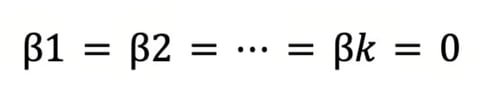
Si la statistique F est suffisamment grande, on rejette l’hypothèse nulle. Cela signifie qu’au moins un prédicteur a un effet non nul sur la variable cible.
Le test F évalue le modèle dans son ensemble. Ensuite, on examine chaque prédicteur individuellement via des tests t.
Pour interpréter un test F, suivez ces étapes :
- Calculez la statistique F : la valeur de F est le ratio de deux carrés moyens. La formule exacte dépend de la méthode (ANOVA ou régression).
- Référez-vous à la loi F : comparez la valeur de F calculée à une loi F définie par deux degrés de liberté :
- Degrés de liberté du numérateur (df₁)
- Degrés de liberté du dénominateur (df₂)
- Calculez la p-valeur : la p-valeur est la probabilité d’observer une valeur de F au moins aussi grande que celle obtenue, en supposant l’hypothèse nulle vraie.
Si la p-valeur est inférieure au seuil de significativité choisi, le résultat est jugé statistiquement significatif.
Que signifie la significativité statistique
Un test F statistiquement significatif montre que le modèle explique une part de variation au-delà de ce que produirait le hasard.
- En ANOVA, cela suggère qu’au moins une moyenne de groupe est différente
- En régression, cela suggère que le modèle explique mieux la cible qu’un modèle à constante seule
Ce que la significativité statistique ne signifie pas
Un résultat significatif présente des limites :
- Il n’identifie pas quel groupe diffère en ANOVA. Des tests post hoc sont nécessaires
- Il n’indique pas l’importance pratique. De petits effets peuvent être significatifs, surtout avec de grands jeux de données
C’est pourquoi les analystes rapportent souvent des mesures complémentaires pour évaluer l’ampleur de l’effet.
Mesures de taille d’effet qui complètent le test F
Les statistiques de taille d’effet quantifient la part de variation expliquée par le modèle.
En ANOVA, une mesure courante est :
- Eta squared (η²) qui estime la proportion de variance expliquée par les différences entre groupes.
En régression, des mesures fréquentes incluent :
- R², qui mesure la proportion de variance expliquée par le modèle.
- R² ajusté, qui tient compte du nombre de variables indépendantes dans le modèle.
Hypothèses de la statistique F et cas où elle peut induire en erreur
Le test F fonctionne bien lorsque quelques hypothèses clés sont raisonnablement satisfaites. Si ces hypothèses sont violées, la statistique F peut donner des résultats trompeurs.
Indépendance des observations
Les observations doivent être indépendantes — une observation ne doit pas en influencer une autre.
Par exemple, si plusieurs mesures proviennent de la même personne ou de la même unité expérimentale, l’indépendance peut être violée. En cas de non-indépendance, la statistique F peut sous-estimer la variabilité et produire des résultats peu fiables.
Erreurs approximativement normales
De nombreux tests F supposent des erreurs approximativement normales. En termes simples, les écarts entre les valeurs observées et les prédictions du modèle devraient suivre une forme à peu près normale.
Cette hypothèse devient moins cruciale avec de grands échantillons. Avec suffisamment de données, le test F reste souvent valide même si la distribution n’est pas parfaitement normale.
Variances égales
L’ANOVA classique suppose des variances similaires entre groupes (homogénéité des variances).
Si un groupe présente une variabilité bien plus élevée que les autres, le test F peut détecter à tort des différences entre moyennes. Le problème s’aggrave lorsque les tailles de groupe sont très différentes.
Quand le test F est plus robuste
Dans de nombreux cas pratiques, le test F reste performant.
Par exemple, l’ANOVA est plutôt robuste lorsque les tailles de groupes sont équilibrées, c’est-à-dire qu’elles contiennent un nombre similaire d’observations. Dans ces situations, des écarts modérés à la normalité ou à l’égalité des variances ont souvent un impact limité.
En revanche, les problèmes augmentent lorsque deux conditions se cumulent, telles que :
- De fortes différences de variances entre groupes
- Des tailles de groupes inégales
Cette combinaison peut fausser la statistique F et accroître le risque de conclusions erronées.
Alternatives lorsque les hypothèses sont violées
Si vos données ne respectent pas les hypothèses du test F, vous pouvez recourir à des méthodes alternatives qui gèrent mieux ces problèmes :
- ANOVA de Welch : adaptée à des variances inégales entre groupes
- Méthodes de régression robuste : réduisent l’impact des valeurs extrêmes ou atypiques
- Tests de permutation : estiment la significativité en rebrassant les données de manière répétée au lieu de s’appuyer sur des lois théoriques
Ce qui prête à confusion à propos de la statistique F
La statistique F est très utilisée, mais plusieurs points déconcertent souvent les débutants, en particulier ses liens avec d’autres tests.
Statistique F vs statistique t
Les statistiques F et t sont étroitement liées. Dans des cas simples, elles testent la même idée.
Par exemple, lorsqu’un modèle de régression n’a qu’un seul prédicteur :
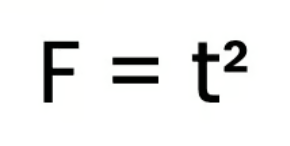
Cela signifie que les deux tests conduisent à la même conclusion en matière de significativité statistique.
Dans des modèles plus complexes, leurs rôles diffèrent : le test t évalue un coefficient à la fois, tandis que le test F évalue simultanément plusieurs paramètres.
Significativité globale vs significativité des coefficients individuels
Autre source de confusion fréquente : la différence entre la significativité au niveau du modèle et au niveau des variables.
- Le test F évalue le modèle dans son ensemble. Il vérifie si le modèle explique mieux la cible qu’un modèle sans prédicteurs
- Le test t évalue des coefficients individuels et vérifie si un prédicteur donné a un effet significatif
De ce fait, vous pouvez observer des résultats tels que :
- Le test F global est significatif
- Certains coefficients individuels ne sont pas significatifs
Cela arrive lorsque plusieurs variables, ensemble, expliquent la cible, même si chacune a un faible effet individuel.
Grandes valeurs de F avec de grands échantillons
Une grande valeur de F conduit souvent à la significativité statistique, mais cela ne signifie pas toujours que le résultat est important en pratique.
Avec de grands échantillons, de petites différences peuvent produire des valeurs de F significatives. Le modèle peut expliquer une partie de la variation, mais l’effet peut rester modeste en termes concrets.
C’est pourquoi les analystes examinent aussi des mesures de taille d’effet comme R² ou eta squared.
Tests post hoc après ANOVA
En ANOVA, la statistique F répond à une question : toutes les moyennes de groupes sont-elles égales ?
Si le résultat est significatif, cela montre qu’au moins une moyenne de groupe diffère. Cela ne dit pas quels groupes diffèrent.
Pour identifier ces différences, on réalise des tests post hoc qui comparent les groupes deux à deux.
Parmi les plus courants :
- Test de Tukey : contrôle les comparaisons multiples
- Ajustement de Bonferroni : durcit les seuils de significativité lors de nombreux tests
Ces tests identifient précisément où se situent les différences après qu’un test F global a montré une significativité.
Dernières réflexions
Vous comprenez désormais le fonctionnement de la statistique F et son interprétation en ANOVA et en régression. Il est temps de passer à la pratique.
Lancez des analyses simples d’ANOVA ou de régression et concentrez-vous sur la lecture conjointe de la valeur de F, de la p-valeur et de la taille d’effet. Vous passerez ainsi du calcul à une interprétation opérationnelle.
Si vous souhaitez consolider vos bases en statistiques, approfondissez les notions clés comme la variance, les tests d’hypothèse et la modélisation par régression.







La statistique F vous aide à vérifier si les différences observées dans les données sont significatives ou simplement dues au hasard. Elle compare la part de variation expliquée par un modèle ou un regroupement à la variation qui reste inexpliquée.
Vous rencontrerez la statistique F dans des méthodes courantes comme l’ANOVA et l’analyse de régression. Dans les deux cas, elle répond à une question simple : le modèle explique-t-il les données mieux que le hasard ?
Dans ce guide, nous allons voir ce que mesure la statistique F, comment elle se calcule, où elle intervient en ANOVA et en régression, et comment en interpréter correctement les résultats.
Ce que mesure la statistique F
La statistique F évalue si la variation expliquée par un modèle est plus grande que celle due au bruit aléatoire. Elle compare deux sources de variance : l’une représente le signal et l’autre le bruit.
Mathématiquement, la statistique F est un ratio de carrés moyens (variances) :
Dans de nombreux tests statistiques, cela s’écrit
La statistique F compare ces deux quantités.
Si la variance intergroupes est bien plus grande, la valeur de F devient élevée, ce qui suggère que les différences entre groupes sont significatives. Si la variance intragroupe domine, la valeur de F est faible, ce qui suggère que les différences observées sont probablement aléatoires.
Où la statistique F est utilisée
Vous pouvez voir la statistique F dans les méthodes suivantes :
Comment calculer la statistique F
La statistique F se calcule comme le ratio de deux carrés moyens. Un carré moyen est une estimation de variance. Il montre l’ampleur de la variation dans une partie spécifique des données.
La formule générique ressemble à ceci :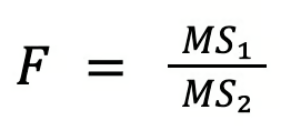
Ici :
Si la variation expliquée est bien plus grande que la variation inexpliquée, la valeur de F augmente. Cela signifie que le modèle ou le regroupement met en évidence des différences réelles.
Même si l’interprétation dépend de l’analyse menée, la statistique F est le plus souvent utilisée en ANOVA et en analyse de régression.
Un exemple numérique simple
Voyons un exemple simple pour clarifier.
Imaginez que vous compariez les taux de conversion de trois campagnes marketing. Après avoir calculé les sommes des carrés et divisé par les degrés de liberté, vous obtenez :
Calculez alors la statistique F : F = 20 / 5 = 4
La valeur de F est donc 4.
Cela signifie que la variation entre les moyennes des campagnes est quatre fois plus grande que la variation au sein de chaque campagne. Autrement dit, les différences entre campagnes sont relativement importantes par rapport à la variation aléatoire interne.
La statistique F et la loi de Fisher (F)
Lorsque l’hypothèse nulle est vraie, la statistique F suit une loi F.
Cette distribution indique jusqu’où la valeur de F peut aller sous l’effet du hasard. Nous l’utilisons pour vérifier si la valeur de F observée est inhabituellement élevée.
La raison tient à la construction de la statistique F.
Chaque terme du ratio F est une mesure de variance. L’un capte la variation expliquée par le modèle ou les groupes, l’autre capte la variation aléatoire. Quand l’hypothèse nulle est vraie, les deux proviennent de la même variance sous-jacente.
En bref, la statistique F compare deux estimations indépendantes d’une même variance. Dans ce cas, leur ratio suit la loi F.
Les deux degrés de liberté de la loi F
La loi F est définie par deux paramètres de degrés de liberté, qui en déterminent la forme exacte.
En pratique, ces valeurs dépendent de la méthode statistique utilisée.
Par exemple :
En ANOVA :
En régression :
Ces degrés de liberté déterminent la variabilité des estimations de variance. Plus ils sont faibles, plus la variabilité est grande, ce qui modifie la forme de la distribution.
La loi F est asymétrique vers la droite. La plupart des valeurs se situent près de zéro et les plus grandes s’étendent dans la queue droite. Cela vient du fait qu’une variance ne peut pas être négative. Le ratio de deux variances ne produit donc que des valeurs positives.
Les degrés de liberté influencent la forme exacte de la distribution :
Quand la statistique F observée se situe loin dans la queue droite, cela indique que la variation expliquée est bien supérieure à la variation inexpliquée. Cela constitue un argument contre l’hypothèse nulle.
Statistique F en ANOVA
En analyse de variance (ANOVA), la statistique F teste l’égalité de plusieurs moyennes de groupes.
Pour une ANOVA à un facteur, l’hypothèse nulle stipule que toutes les moyennes de groupes sont égales. L’hypothèse alternative stipule qu’au moins une moyenne diffère.
Le test compare la variation entre groupes à la variation au sein des groupes. Si les différences entre moyennes de groupe sont bien plus grandes que la variation interne, la valeur de F augmente.
Composants utilisés
L’ANOVA décompose la variation totale en deux parties :
On les convertit ensuite en carrés moyens en les divisant par leurs degrés de liberté :
La statistique F est alors calculée comme le ratio de ces deux carrés moyens.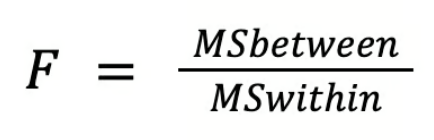
Comment interpréter la valeur de F
La valeur de F indique à quel point les différences entre groupes ressortent par rapport à la variation aléatoire. Vous pouvez l’interpréter ainsi :
Hypothèses clés
L’ANOVA repose sur quelques hypothèses :
Statistique F en régression
En analyse de régression, la statistique F teste si le modèle explique mieux les données qu’un modèle sans prédicteurs.
Le modèle de comparaison ne contient qu’une constante et prédit la valeur moyenne de la cible. C’est ce que l’on appelle le test F de significativité globale. Les hypothèses sont :
La statistique F compare la variation expliquée par le modèle à la variation qui reste inexpliquée.
Si la variation expliquée est bien plus grande que la variation inexpliquée, la valeur de F devient élevée. Cela indique que le modèle capte des tendances pertinentes dans les données.
Lien entre la statistique F et R²
La statistique F est étroitement liée à R², qui mesure la part de variation de la variable cible expliquée par le modèle.
À mesure que le modèle explique davantage de variation, R² augmente. La statistique F a alors tendance à augmenter également, car la variation expliquée devient plus grande relativement à la variation inexpliquée.
Cependant, ces mesures poursuivent des objectifs différents :
Interprétation en régression multiple
En régression multiple, le test F évalue la significativité globale du modèle. L’hypothèse nulle stipule que tous les coefficients de régression sont égaux à zéro :
Si la statistique F est suffisamment grande, on rejette l’hypothèse nulle. Cela signifie qu’au moins un prédicteur a un effet non nul sur la variable cible.
Le test F évalue le modèle dans son ensemble. Ensuite, on examine chaque prédicteur individuellement via des tests t.
Comment interpréter la statistique F et la p-valeur
Pour interpréter un test F, suivez ces étapes :
Si la p-valeur est inférieure au seuil de significativité choisi, le résultat est jugé statistiquement significatif.
Que signifie la significativité statistique
Un test F statistiquement significatif montre que le modèle explique une part de variation au-delà de ce que produirait le hasard.
Ce que la significativité statistique ne signifie pas
Un résultat significatif présente des limites :
C’est pourquoi les analystes rapportent souvent des mesures complémentaires pour évaluer l’ampleur de l’effet.
Mesures de taille d’effet qui complètent le test F
Les statistiques de taille d’effet quantifient la part de variation expliquée par le modèle.
En ANOVA, une mesure courante est :
En régression, des mesures fréquentes incluent :
Hypothèses de la statistique F et cas où elle peut induire en erreur
Le test F fonctionne bien lorsque quelques hypothèses clés sont raisonnablement satisfaites. Si ces hypothèses sont violées, la statistique F peut donner des résultats trompeurs.
Indépendance des observations
Les observations doivent être indépendantes — une observation ne doit pas en influencer une autre.
Par exemple, si plusieurs mesures proviennent de la même personne ou de la même unité expérimentale, l’indépendance peut être violée. En cas de non-indépendance, la statistique F peut sous-estimer la variabilité et produire des résultats peu fiables.
Erreurs approximativement normales
De nombreux tests F supposent des erreurs approximativement normales. En termes simples, les écarts entre les valeurs observées et les prédictions du modèle devraient suivre une forme à peu près normale.
Cette hypothèse devient moins cruciale avec de grands échantillons. Avec suffisamment de données, le test F reste souvent valide même si la distribution n’est pas parfaitement normale.
Variances égales
L’ANOVA classique suppose des variances similaires entre groupes (homogénéité des variances).
Si un groupe présente une variabilité bien plus élevée que les autres, le test F peut détecter à tort des différences entre moyennes. Le problème s’aggrave lorsque les tailles de groupe sont très différentes.
Quand le test F est plus robuste
Dans de nombreux cas pratiques, le test F reste performant.
Par exemple, l’ANOVA est plutôt robuste lorsque les tailles de groupes sont équilibrées, c’est-à-dire qu’elles contiennent un nombre similaire d’observations. Dans ces situations, des écarts modérés à la normalité ou à l’égalité des variances ont souvent un impact limité.
En revanche, les problèmes augmentent lorsque deux conditions se cumulent, telles que :
Cette combinaison peut fausser la statistique F et accroître le risque de conclusions erronées.
Alternatives lorsque les hypothèses sont violées
Si vos données ne respectent pas les hypothèses du test F, vous pouvez recourir à des méthodes alternatives qui gèrent mieux ces problèmes :
Ce qui prête à confusion à propos de la statistique F
La statistique F est très utilisée, mais plusieurs points déconcertent souvent les débutants, en particulier ses liens avec d’autres tests.
Statistique F vs statistique t
Les statistiques F et t sont étroitement liées. Dans des cas simples, elles testent la même idée.
Par exemple, lorsqu’un modèle de régression n’a qu’un seul prédicteur :
Cela signifie que les deux tests conduisent à la même conclusion en matière de significativité statistique.
Dans des modèles plus complexes, leurs rôles diffèrent : le test t évalue un coefficient à la fois, tandis que le test F évalue simultanément plusieurs paramètres.
Significativité globale vs significativité des coefficients individuels
Autre source de confusion fréquente : la différence entre la significativité au niveau du modèle et au niveau des variables.
De ce fait, vous pouvez observer des résultats tels que :
Cela arrive lorsque plusieurs variables, ensemble, expliquent la cible, même si chacune a un faible effet individuel.
Grandes valeurs de F avec de grands échantillons
Une grande valeur de F conduit souvent à la significativité statistique, mais cela ne signifie pas toujours que le résultat est important en pratique.
Avec de grands échantillons, de petites différences peuvent produire des valeurs de F significatives. Le modèle peut expliquer une partie de la variation, mais l’effet peut rester modeste en termes concrets.
C’est pourquoi les analystes examinent aussi des mesures de taille d’effet comme R² ou eta squared.
Tests post hoc après ANOVA
En ANOVA, la statistique F répond à une question : toutes les moyennes de groupes sont-elles égales ?
Si le résultat est significatif, cela montre qu’au moins une moyenne de groupe diffère. Cela ne dit pas quels groupes diffèrent.
Pour identifier ces différences, on réalise des tests post hoc qui comparent les groupes deux à deux.
Parmi les plus courants :
Ces tests identifient précisément où se situent les différences après qu’un test F global a montré une significativité.
Dernières réflexions
Vous comprenez désormais le fonctionnement de la statistique F et son interprétation en ANOVA et en régression. Il est temps de passer à la pratique.
Lancez des analyses simples d’ANOVA ou de régression et concentrez-vous sur la lecture conjointe de la valeur de F, de la p-valeur et de la taille d’effet. Vous passerez ainsi du calcul à une interprétation opérationnelle.
Si vous souhaitez consolider vos bases en statistiques, approfondissez les notions clés comme la variance, les tests d’hypothèse et la modélisation par régression.