Thống kê F giúp bạn kiểm tra liệu các khác biệt trong dữ liệu có ý nghĩa hay chỉ là biến thiên ngẫu nhiên. Nó so sánh biến thiên được giải thích bởi một mô hình hoặc cấu trúc phân nhóm với biến thiên còn lại chưa được giải thích.
Bạn sẽ thấy thống kê F trong các phương pháp thống kê phổ biến như ANOVA và phân tích hồi quy. Ở cả hai trường hợp, nó trả lời một câu hỏi cơ bản: Mô hình có giải thích dữ liệu tốt hơn ngẫu nhiên không?
Trong hướng dẫn này, chúng tôi sẽ giới thiệu thống kê F đo lường điều gì, cách tính, nơi nó xuất hiện trong ANOVA và hồi quy, và cách diễn giải kết quả cho đúng.
Thống kê F đo lường điều gì
Thống kê F đo xem biến thiên được giải thích bởi mô hình có lớn hơn biến thiên do nhiễu ngẫu nhiên gây ra hay không. Nó so sánh hai nguồn phương sai: một đại diện cho tín hiệu và một đại diện cho nhiễu.
Về mặt toán học, thống kê F là một tỷ số của trung bình bình phương (phương sai):
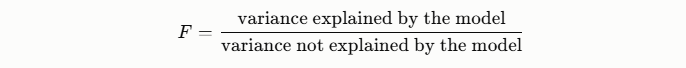
Trong nhiều kiểm định thống kê, điều này được viết là
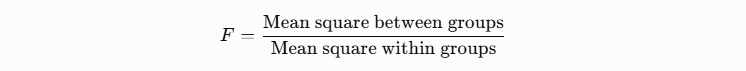
Thống kê F so sánh hai đại lượng này.
- Phương sai giữa các nhóm: Đo mức độ khác nhau giữa các giá trị trung bình của các nhóm. Khác biệt lớn gợi ý các nhóm có hành vi khác nhau.
- Phương sai trong nhóm: Đo mức độ các giá trị cá nhân trong mỗi nhóm dao động quanh trung bình nhóm của chính nó. Điều này đại diện cho nhiễu ngẫu nhiên hoặc biến thiên tự nhiên trong dữ liệu.
Nếu phương sai giữa nhóm lớn hơn nhiều, giá trị F sẽ lớn. Điều này cho thấy khác biệt giữa các nhóm là có ý nghĩa. Nếu phương sai trong nhóm chiếm ưu thế, giá trị F sẽ nhỏ, gợi ý các khác biệt quan sát được có khả năng là ngẫu nhiên.
Thống kê F được dùng ở đâu
Bạn có thể thấy thống kê F trong các phương pháp sau:
- Phân tích phương sai (ANOVA): ANOVA dùng thống kê F để kiểm tra liệu nhiều trung bình nhóm có khác nhau không. Ví dụ, nó có thể kiểm tra liệu ba chiến dịch marketing tạo ra các tỷ lệ chuyển đổi trung bình khác nhau.
- Mức ý nghĩa tổng thể của hồi quy: Trong hồi quy tuyến tính, thống kê F kiểm tra liệu mô hình giải thích một phần có ý nghĩa của biến kết quả. Nói đơn giản, nó kiểm tra liệu các biến dự báo cùng nhau cải thiện dự đoán so với chỉ dùng giá trị trung bình hay không.
- So sánh các mô hình lồng nhau: Thống kê F cũng có thể so sánh hai mô hình hồi quy khi một mô hình là phiên bản đơn giản hơn của mô hình kia. Điều này giúp xác định việc thêm biến có cải thiện mô hình đủ để biện minh cho độ phức tạp tăng thêm hay không.
Cách tính thống kê F
Thống kê F được tính như tỷ số của hai trung bình bình phương. Một trung bình bình phương đại diện cho ước lượng phương sai. Nó cho thấy có bao nhiêu biến thiên tồn tại trong một phần cụ thể của dữ liệu.
Công thức tổng quát như sau: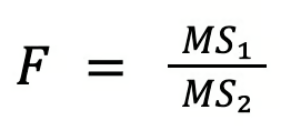
Trong đó:
- MS₁ đại diện cho biến thiên được giải thích bởi mô hình hoặc cấu trúc phân nhóm.
- MS₂ đại diện cho biến thiên còn lại chưa được giải thích.
Nếu biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích, giá trị F sẽ lớn. Điều đó nghĩa là mô hình hoặc phân nhóm giải thích các khác biệt có ý nghĩa.
Mặc dù cách diễn giải phụ thuộc vào phân tích bạn thực hiện, thống kê F thường được dùng nhất trong ANOVA và phân tích hồi quy.
Ví dụ số đơn giản
Hãy cùng đi qua một ví dụ đơn giản để rõ hơn.
Giả sử bạn đang so sánh tỷ lệ chuyển đổi giữa ba chiến dịch marketing. Sau khi tính tổng bình phương và chia cho bậc tự do, bạn thu được:
- Trung bình bình phương giữa các nhóm (MS_between) = 20
- Trung bình bình phương trong các nhóm (MS_within) = 5
Giờ tính thống kê F: F = 20 / 5 = 4
Vậy, giá trị F là 4.
Điều này nghĩa là biến thiên giữa các trung bình chiến dịch lớn gấp bốn lần biến thiên trong mỗi chiến dịch. Nói cách khác, các khác biệt giữa các chiến dịch tương đối lớn so với biến thiên ngẫu nhiên bên trong chúng.
Thống kê F và phân phối F
Thống kê F tuân theo phân phối F khi giả thuyết không đúng.
Phân phối này cho thấy giá trị F có thể lớn đến mức nào chỉ do biến thiên ngẫu nhiên. Chúng ta dùng nó để kiểm tra liệu giá trị F quan sát được có lớn bất thường không.
Lý do xuất phát từ cách thống kê F được xây dựng.
Mỗi phần của tỷ số F là một thước đo phương sai. Một phần nắm bắt biến thiên được giải thích bởi mô hình hoặc các nhóm, phần kia nắm bắt biến thiên ngẫu nhiên. Khi giả thuyết không đúng, cả hai xuất phát từ cùng một phương sai cơ bản.
Nói ngắn gọn, thống kê F so sánh hai ước lượng độc lập của cùng một phương sai. Khi đó, tỷ số của chúng tuân theo phân phối F.
Hai bậc tự do trong phân phối F
Phân phối F được xác định bởi hai tham số bậc tự do. Chúng kiểm soát hình dạng chính xác của phân phối.
- Bậc tự do của tử số (df₁): Tương ứng với ước lượng phương sai ở tử số của thống kê F.
- Bậc tự do của mẫu số (df₂): Tương ứng với ước lượng phương sai ở mẫu số.
Trong thực tế, các giá trị này phụ thuộc vào phương pháp thống kê được sử dụng.
Ví dụ:
Trong ANOVA:
- df tử số = số nhóm − 1
- df mẫu số = tổng số quan sát − số nhóm
Trong hồi quy:
- df tử số = số biến dự báo
- df mẫu số = kích thước mẫu − số biến dự báo − 1
Các bậc tự do này quyết định mức độ biến động của các ước lượng phương sai. Bậc tự do nhỏ hơn dẫn đến biến động lớn hơn, làm thay đổi hình dạng phân phối.
Phân phối F lệch phải. Hầu hết các giá trị xuất hiện gần 0, trong khi các giá trị lớn hơn kéo dài về phía đuôi phải. Điều này xảy ra vì các ước lượng phương sai không thể âm. Do đó, tỷ số của hai ước lượng phương sai chỉ tạo ra các giá trị dương.
Các bậc tự do ảnh hưởng đến hình dạng chính xác của phân phối:
- Bậc tự do nhỏ tạo ra phân phối rộng hơn với đuôi phải dài hơn.
- Bậc tự do lớn làm phân phối tập trung hơn.
Khi thống kê F quan sát rơi xa vào đuôi phải của phân phối, điều đó cho thấy biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích. Đây là bằng chứng chống lại giả thuyết không.
Thống kê F trong ANOVA
Trong phân tích phương sai (ANOVA), thống kê F kiểm tra liệu nhiều trung bình nhóm có bằng nhau hay không.
Với ANOVA một nhân tố, giả thuyết không phát biểu rằng tất cả trung bình nhóm bằng nhau. Giả thuyết đối đặt ra rằng có ít nhất một trung bình nhóm khác biệt.
Bài kiểm định so sánh biến thiên giữa nhóm với biến thiên trong nhóm. Nếu khác biệt giữa các giá trị trung bình nhóm lớn hơn nhiều so với biến thiên bên trong các nhóm, giá trị F sẽ lớn.
Các thành phần sử dụng
ANOVA tách tổng biến thiên thành hai phần:
- SS between (tổng bình phương giữa các nhóm): Đo khoảng cách của mỗi trung bình nhóm so với trung bình chung
- SS within (tổng bình phương trong các nhóm): Đo mức độ các quan sát dao động quanh trung bình nhóm của chính chúng
Sau đó, chúng được chuyển thành trung bình bình phương bằng cách chia cho bậc tự do của chúng:
- MS between ước lượng phương sai được giải thích bởi khác biệt giữa các nhóm.
- MS within ước lượng phương sai còn lại chưa giải thích.
Sau đó thống kê F được tính là tỷ số của hai trung bình bình phương này.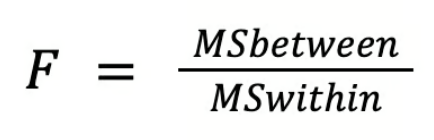
Cách diễn giải giá trị F
Giá trị F cho thấy mức độ nổi bật của khác biệt giữa các nhóm so với biến thiên ngẫu nhiên. Bạn có thể diễn giải như sau:
- Giá trị F nhỏ: Biến thiên giữa các nhóm tương tự biến thiên trong các nhóm. Nhiều khả năng các trung bình bằng nhau.
- Giá trị F lớn: Biến thiên giữa nhóm lớn hơn nhiều. Điều này gợi ý có ít nhất một trung bình nhóm khác biệt.
Các giả định chính
ANOVA dựa trên một vài giả định:
- Các quan sát độc lập
- Dữ liệu trong mỗi nhóm xấp xỉ phân phối chuẩn
- Phương sai giữa các nhóm tương tự nhau
Thống kê F trong hồi quy
Trong phân tích hồi quy, thống kê F kiểm tra liệu mô hình giải thích dữ liệu tốt hơn một mô hình không có biến dự báo hay không.
Mô hình so sánh chỉ bao gồm hệ số chặn và dự đoán giá trị trung bình của biến kết quả. Đây được gọi là kiểm định F về mức ý nghĩa tổng thể. Các giả thuyết là:
- Giả thuyết không (H₀): Mô hình không có biến dự báo phù hợp dữ liệu ngang với mô hình hồi quy
- Giả thuyết đối (H₁): Mô hình hồi quy phù hợp tốt hơn mô hình chỉ có hệ số chặn
Thống kê F so sánh biến thiên được giải thích bởi mô hình với biến thiên còn lại chưa giải thích.
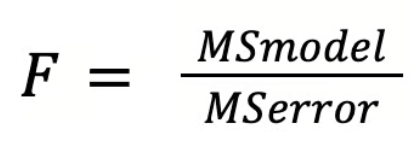
- MS model đại diện cho phương sai được giải thích bởi các biến dự báo.
- MS error đại diện cho phương sai còn lại chưa giải thích.
Nếu biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích, giá trị F sẽ lớn. Điều này cho thấy mô hình nắm bắt các mẫu hình có ý nghĩa trong dữ liệu.
Mối quan hệ giữa thống kê F và R²
Thống kê F có liên hệ chặt chẽ với R², thước đo mức độ biến thiên của biến kết quả được mô hình giải thích.
Khi mô hình giải thích nhiều biến thiên hơn, R² tăng. Điều này cũng thường làm tăng thống kê F vì biến thiên được giải thích trở nên lớn hơn so với biến thiên chưa giải thích.
Tuy nhiên, hai thước đo phục vụ các mục đích khác nhau:
- R² cho thấy mô hình giải thích bao nhiêu biến thiên
- Kiểm định F đánh giá liệu biến thiên được giải thích đó có ý nghĩa thống kê hay không
Diễn giải trong hồi quy bội
Trong hồi quy bội, kiểm định F đánh giá mức ý nghĩa tổng thể của mô hình. Giả thuyết không phát biểu rằng tất cả các hệ số hồi quy đều bằng 0:
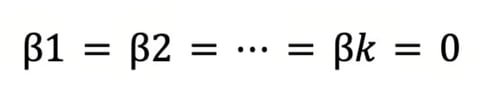
Nếu thống kê F đủ lớn, giả thuyết không bị bác bỏ. Điều này nghĩa là có ít nhất một biến dự báo có tác động khác 0 lên biến kết quả.
Kiểm định F đánh giá mô hình như một tổng thể. Sau đó, các biến dự báo riêng lẻ được kiểm tra bằng các kiểm định t.
Cách diễn giải thống kê F và p-value
Để diễn giải một kiểm định F, hãy làm theo các bước sau:
- Tính thống kê F: Giá trị F được tính như tỷ số của hai trung bình bình phương. Công thức cụ thể phụ thuộc vào phương pháp sử dụng, như ANOVA hoặc hồi quy.
- Tham chiếu phân phối F: Giá trị F tính được được so sánh với một phân phối F xác định bởi hai bậc tự do:
- Bậc tự do của tử số (df₁)
- Bậc tự do của mẫu số (df₂)
- Tính p-value: p-value biểu thị xác suất quan sát được một giá trị F ít nhất lớn như giá trị thu được, giả sử giả thuyết không là đúng.
Nếu p-value nhỏ hơn mức ý nghĩa đã chọn, kết quả được xem là có ý nghĩa thống kê.
Ý nghĩa thống kê nghĩa là gì
Một kiểm định F có ý nghĩa thống kê cho thấy mô hình giải thích biến thiên vượt quá những gì ngẫu nhiên có thể tạo ra.
- Trong ANOVA, điều này gợi ý có ít nhất một trung bình nhóm khác biệt
- Trong hồi quy, điều này gợi ý mô hình giải thích biến kết quả tốt hơn mô hình chỉ có hệ số chặn
Ý nghĩa thống kê không có nghĩa là gì
Một kết quả F có ý nghĩa có những giới hạn:
- Nó không xác định nhóm cụ thể nào khác biệt trong ANOVA. Cần các kiểm định hậu nghiệm
- Nó không chỉ ra tầm quan trọng thực tiễn. Hiệu ứng nhỏ vẫn có thể có ý nghĩa thống kê, đặc biệt với bộ dữ liệu lớn
Vì vậy, các nhà phân tích thường báo cáo thêm các thước đo để hiểu sức mạnh của hiệu ứng.
Các thước đo kích thước hiệu ứng bổ trợ cho kiểm định F
Các thống kê kích thước hiệu ứng giúp định lượng mô hình giải thích bao nhiêu biến thiên.
Trong ANOVA, một thước đo phổ biến là:
- Eta squared (η²), ước tính tỷ lệ phương sai được giải thích bởi khác biệt giữa các nhóm.
Trong hồi quy, các thước đo phổ biến gồm:
- R², đo tỷ lệ phương sai được mô hình giải thích.
- R² điều chỉnh, điều chỉnh theo số lượng biến độc lập trong mô hình.
Các giả định của thống kê F và khi nào nó có thể gây hiểu lầm
Kiểm định F hoạt động tốt khi một vài giả định chủ chốt được đáp ứng ở mức hợp lý. Nếu các giả định này bị vi phạm, thống kê F có thể đưa ra kết quả gây hiểu lầm.
Tính độc lập của các quan sát
Các quan sát trong bộ dữ liệu nên độc lập với nhau — một quan sát không nên ảnh hưởng đến quan sát khác.
Ví dụ, nếu nhiều đo lường đến từ cùng một người hoặc cùng một đơn vị thí nghiệm, tính độc lập có thể bị vi phạm. Khi các quan sát không độc lập, thống kê F có thể đánh giá thấp biến thiên và tạo ra kết quả không đáng tin cậy.
Sai số xấp xỉ chuẩn
Nhiều kiểm định F giả định rằng sai số xấp xỉ phân phối chuẩn. Nói đơn giản, chênh lệch giữa giá trị quan sát và dự đoán của mô hình nên tuân theo một dạng gần chuẩn.
Giả định này trở nên bớt quan trọng với mẫu lớn hơn. Với đủ dữ liệu, kiểm định F thường vẫn hoạt động khá tốt ngay cả khi phân phối không hoàn toàn chuẩn.
Phương sai bằng nhau
ANOVA cổ điển giả định rằng phương sai giữa các nhóm tương tự nhau. Điều kiện này gọi là tính đồng nhất phương sai.
Nếu một nhóm có mức biến thiên cao hơn nhiều so với các nhóm khác, kiểm định F có thể phát hiện sai khác biệt giữa các trung bình nhóm. Vấn đề trầm trọng hơn khi kích thước nhóm rất khác nhau.
Khi kiểm định F vững hơn
Trong nhiều tình huống thực tế, kiểm định F vẫn cho hiệu năng hợp lý.
Ví dụ, ANOVA khá vững khi kích thước các nhóm cân bằng, nghĩa là mỗi nhóm có số quan sát tương tự nhau. Trong các trường hợp này, các vi phạm vừa phải về tính chuẩn hoặc phương sai bằng nhau thường có tác động hạn chế.
Tuy nhiên, vấn đề tăng lên khi hai điều kiện xảy ra cùng lúc như:
- Khác biệt mạnh về phương sai giữa các nhóm
- Kích thước nhóm không bằng nhau
Sự kết hợp này có thể làm sai lệch thống kê F và tăng rủi ro kết luận sai.
Các lựa chọn thay thế khi giả định bị vi phạm
Nếu dữ liệu của bạn không đáp ứng các giả định của kiểm định F, bạn có thể dùng các phương pháp thay thế xử lý những vấn đề này hiệu quả hơn:
- ANOVA của Welch: Xử lý phương sai không bằng nhau giữa các nhóm
- Các phương pháp hồi quy vững: Giảm ảnh hưởng của các giá trị cực đoan hoặc ngoại lai
- Kiểm định hoán vị: Ước lượng mức ý nghĩa bằng cách tráo dữ liệu lặp lại thay vì dựa vào các phân phối lý thuyết
Những điều gây nhầm lẫn về thống kê F
Thống kê F được sử dụng rộng rãi, nhưng một vài điểm thường gây nhầm lẫn cho người mới bắt đầu. Hầu hết đến từ mối liên hệ của nó với các kiểm định thống kê khác.
Thống kê F so với thống kê t
Thống kê F và thống kê t có liên hệ chặt chẽ. Trong các trường hợp đơn giản, chúng kiểm tra cùng một ý tưởng.
Ví dụ, khi một mô hình hồi quy chỉ có một biến dự báo:
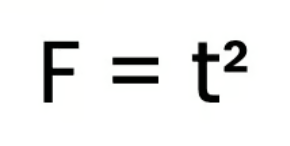
Điều này có nghĩa cả hai kiểm định dẫn đến cùng một kết luận về ý nghĩa thống kê.
Trong các mô hình phức tạp hơn, chúng đóng vai trò khác nhau. Kiểm định t đánh giá từng hệ số một, trong khi kiểm định F đánh giá nhiều tham số cùng lúc.
Mức ý nghĩa tổng thể so với mức ý nghĩa của từng hệ số
Một điểm nhầm lẫn phổ biến khác là sự khác biệt giữa mức ý nghĩa ở cấp độ mô hình và cấp độ biến.
- Kiểm định F đánh giá mô hình như một tổng thể. Nó kiểm tra liệu mô hình giải thích biến kết quả tốt hơn một mô hình không có biến dự báo
- Kiểm định t đánh giá các hệ số riêng lẻ. Nó kiểm tra liệu một biến dự báo cụ thể có tác động đáng kể hay không
Vì vậy, bạn có thể thấy các kết quả như:
- Kiểm định F tổng thể có ý nghĩa
- Một số hệ số riêng lẻ không có ý nghĩa
Điều này xảy ra khi nhiều biến cùng nhau giải thích biến kết quả, ngay cả khi mỗi biến chỉ có tác động nhỏ riêng lẻ.
Giá trị F lớn trong các mẫu lớn
Giá trị F lớn thường dẫn đến ý nghĩa thống kê, nhưng không phải lúc nào cũng có nghĩa là kết quả quan trọng trong thực tiễn.
Với kích thước mẫu lớn, ngay cả khác biệt nhỏ cũng có thể tạo ra giá trị F có ý nghĩa. Mô hình có thể giải thích một phần biến thiên, nhưng hiệu ứng có thể nhỏ về mặt thực tế.
Đó là lý do các nhà phân tích cũng xem xét các thước đo kích thước hiệu ứng như R² hoặc eta squared.
Kiểm định hậu nghiệm sau ANOVA
Trong ANOVA, thống kê F trả lời một câu hỏi: tất cả trung bình nhóm có bằng nhau không?
Nếu kết quả có ý nghĩa, nó cho thấy có ít nhất một trung bình nhóm khác biệt. Nó không cho biết các nhóm nào khác nhau.
Để xác định khác biệt, các nhà phân tích chạy các kiểm định hậu nghiệm so sánh các nhóm theo từng cặp.
Ví dụ phổ biến gồm:
- Kiểm định của Tukey: Kiểm soát so sánh đa bội
- Điều chỉnh Bonferroni: Thắt chặt ngưỡng ý nghĩa khi chạy nhiều kiểm định
Các kiểm định này xác định chính xác nơi tồn tại khác biệt sau khi kiểm định F tổng thể cho thấy có ý nghĩa.
Kết luận
Giờ đây bạn đã hiểu thống kê F hoạt động như thế nào và cách diễn giải trong ANOVA và hồi quy. Hãy áp dụng điều này trong thực hành.
Chạy các phân tích ANOVA hoặc hồi quy đơn giản và tập trung đọc cùng lúc giá trị F, p-value và kích thước hiệu ứng. Điều này sẽ giúp bạn chuyển từ tính toán sang diễn giải thực sự.
Nếu bạn muốn xây dựng nền tảng thống kê vững chắc hơn, hãy đi sâu vào các khái niệm cốt lõi như phương sai, kiểm định giả thuyết và mô hình hồi quy.


Thống kê F giúp bạn kiểm tra liệu các khác biệt trong dữ liệu có ý nghĩa hay chỉ là biến thiên ngẫu nhiên. Nó so sánh biến thiên được giải thích bởi một mô hình hoặc cấu trúc phân nhóm với biến thiên còn lại chưa được giải thích.
Bạn sẽ thấy thống kê F trong các phương pháp thống kê phổ biến như ANOVA và phân tích hồi quy. Ở cả hai trường hợp, nó trả lời một câu hỏi cơ bản: Mô hình có giải thích dữ liệu tốt hơn ngẫu nhiên không?
Trong hướng dẫn này, chúng tôi sẽ giới thiệu thống kê F đo lường điều gì, cách tính, nơi nó xuất hiện trong ANOVA và hồi quy, và cách diễn giải kết quả cho đúng.
Thống kê F đo lường điều gì
Thống kê F đo xem biến thiên được giải thích bởi mô hình có lớn hơn biến thiên do nhiễu ngẫu nhiên gây ra hay không. Nó so sánh hai nguồn phương sai: một đại diện cho tín hiệu và một đại diện cho nhiễu.
Về mặt toán học, thống kê F là một tỷ số của trung bình bình phương (phương sai):
Trong nhiều kiểm định thống kê, điều này được viết là
Thống kê F so sánh hai đại lượng này.
Nếu phương sai giữa nhóm lớn hơn nhiều, giá trị F sẽ lớn. Điều này cho thấy khác biệt giữa các nhóm là có ý nghĩa. Nếu phương sai trong nhóm chiếm ưu thế, giá trị F sẽ nhỏ, gợi ý các khác biệt quan sát được có khả năng là ngẫu nhiên.
Thống kê F được dùng ở đâu
Bạn có thể thấy thống kê F trong các phương pháp sau:
Cách tính thống kê F
Thống kê F được tính như tỷ số của hai trung bình bình phương. Một trung bình bình phương đại diện cho ước lượng phương sai. Nó cho thấy có bao nhiêu biến thiên tồn tại trong một phần cụ thể của dữ liệu.
Công thức tổng quát như sau: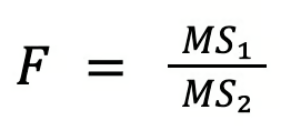
Trong đó:
Nếu biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích, giá trị F sẽ lớn. Điều đó nghĩa là mô hình hoặc phân nhóm giải thích các khác biệt có ý nghĩa.
Mặc dù cách diễn giải phụ thuộc vào phân tích bạn thực hiện, thống kê F thường được dùng nhất trong ANOVA và phân tích hồi quy.
Ví dụ số đơn giản
Hãy cùng đi qua một ví dụ đơn giản để rõ hơn.
Giả sử bạn đang so sánh tỷ lệ chuyển đổi giữa ba chiến dịch marketing. Sau khi tính tổng bình phương và chia cho bậc tự do, bạn thu được:
Giờ tính thống kê F: F = 20 / 5 = 4
Vậy, giá trị F là 4.
Điều này nghĩa là biến thiên giữa các trung bình chiến dịch lớn gấp bốn lần biến thiên trong mỗi chiến dịch. Nói cách khác, các khác biệt giữa các chiến dịch tương đối lớn so với biến thiên ngẫu nhiên bên trong chúng.
Thống kê F và phân phối F
Thống kê F tuân theo phân phối F khi giả thuyết không đúng.
Phân phối này cho thấy giá trị F có thể lớn đến mức nào chỉ do biến thiên ngẫu nhiên. Chúng ta dùng nó để kiểm tra liệu giá trị F quan sát được có lớn bất thường không.
Lý do xuất phát từ cách thống kê F được xây dựng.
Mỗi phần của tỷ số F là một thước đo phương sai. Một phần nắm bắt biến thiên được giải thích bởi mô hình hoặc các nhóm, phần kia nắm bắt biến thiên ngẫu nhiên. Khi giả thuyết không đúng, cả hai xuất phát từ cùng một phương sai cơ bản.
Nói ngắn gọn, thống kê F so sánh hai ước lượng độc lập của cùng một phương sai. Khi đó, tỷ số của chúng tuân theo phân phối F.
Hai bậc tự do trong phân phối F
Phân phối F được xác định bởi hai tham số bậc tự do. Chúng kiểm soát hình dạng chính xác của phân phối.
Trong thực tế, các giá trị này phụ thuộc vào phương pháp thống kê được sử dụng.
Ví dụ:
Trong ANOVA:
Trong hồi quy:
Các bậc tự do này quyết định mức độ biến động của các ước lượng phương sai. Bậc tự do nhỏ hơn dẫn đến biến động lớn hơn, làm thay đổi hình dạng phân phối.
Phân phối F lệch phải. Hầu hết các giá trị xuất hiện gần 0, trong khi các giá trị lớn hơn kéo dài về phía đuôi phải. Điều này xảy ra vì các ước lượng phương sai không thể âm. Do đó, tỷ số của hai ước lượng phương sai chỉ tạo ra các giá trị dương.
Các bậc tự do ảnh hưởng đến hình dạng chính xác của phân phối:
Khi thống kê F quan sát rơi xa vào đuôi phải của phân phối, điều đó cho thấy biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích. Đây là bằng chứng chống lại giả thuyết không.
Thống kê F trong ANOVA
Trong phân tích phương sai (ANOVA), thống kê F kiểm tra liệu nhiều trung bình nhóm có bằng nhau hay không.
Với ANOVA một nhân tố, giả thuyết không phát biểu rằng tất cả trung bình nhóm bằng nhau. Giả thuyết đối đặt ra rằng có ít nhất một trung bình nhóm khác biệt.
Bài kiểm định so sánh biến thiên giữa nhóm với biến thiên trong nhóm. Nếu khác biệt giữa các giá trị trung bình nhóm lớn hơn nhiều so với biến thiên bên trong các nhóm, giá trị F sẽ lớn.
Các thành phần sử dụng
ANOVA tách tổng biến thiên thành hai phần:
Sau đó, chúng được chuyển thành trung bình bình phương bằng cách chia cho bậc tự do của chúng:
Sau đó thống kê F được tính là tỷ số của hai trung bình bình phương này.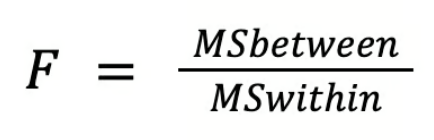
Cách diễn giải giá trị F
Giá trị F cho thấy mức độ nổi bật của khác biệt giữa các nhóm so với biến thiên ngẫu nhiên. Bạn có thể diễn giải như sau:
Các giả định chính
ANOVA dựa trên một vài giả định:
Thống kê F trong hồi quy
Trong phân tích hồi quy, thống kê F kiểm tra liệu mô hình giải thích dữ liệu tốt hơn một mô hình không có biến dự báo hay không.
Mô hình so sánh chỉ bao gồm hệ số chặn và dự đoán giá trị trung bình của biến kết quả. Đây được gọi là kiểm định F về mức ý nghĩa tổng thể. Các giả thuyết là:
Thống kê F so sánh biến thiên được giải thích bởi mô hình với biến thiên còn lại chưa giải thích.
Nếu biến thiên được giải thích lớn hơn nhiều so với biến thiên chưa giải thích, giá trị F sẽ lớn. Điều này cho thấy mô hình nắm bắt các mẫu hình có ý nghĩa trong dữ liệu.
Mối quan hệ giữa thống kê F và R²
Thống kê F có liên hệ chặt chẽ với R², thước đo mức độ biến thiên của biến kết quả được mô hình giải thích.
Khi mô hình giải thích nhiều biến thiên hơn, R² tăng. Điều này cũng thường làm tăng thống kê F vì biến thiên được giải thích trở nên lớn hơn so với biến thiên chưa giải thích.
Tuy nhiên, hai thước đo phục vụ các mục đích khác nhau:
Diễn giải trong hồi quy bội
Trong hồi quy bội, kiểm định F đánh giá mức ý nghĩa tổng thể của mô hình. Giả thuyết không phát biểu rằng tất cả các hệ số hồi quy đều bằng 0:
Nếu thống kê F đủ lớn, giả thuyết không bị bác bỏ. Điều này nghĩa là có ít nhất một biến dự báo có tác động khác 0 lên biến kết quả.
Kiểm định F đánh giá mô hình như một tổng thể. Sau đó, các biến dự báo riêng lẻ được kiểm tra bằng các kiểm định t.
Cách diễn giải thống kê F và p-value
Để diễn giải một kiểm định F, hãy làm theo các bước sau:
Nếu p-value nhỏ hơn mức ý nghĩa đã chọn, kết quả được xem là có ý nghĩa thống kê.
Ý nghĩa thống kê nghĩa là gì
Một kiểm định F có ý nghĩa thống kê cho thấy mô hình giải thích biến thiên vượt quá những gì ngẫu nhiên có thể tạo ra.
Ý nghĩa thống kê không có nghĩa là gì
Một kết quả F có ý nghĩa có những giới hạn:
Vì vậy, các nhà phân tích thường báo cáo thêm các thước đo để hiểu sức mạnh của hiệu ứng.
Các thước đo kích thước hiệu ứng bổ trợ cho kiểm định F
Các thống kê kích thước hiệu ứng giúp định lượng mô hình giải thích bao nhiêu biến thiên.
Trong ANOVA, một thước đo phổ biến là:
Trong hồi quy, các thước đo phổ biến gồm:
Các giả định của thống kê F và khi nào nó có thể gây hiểu lầm
Kiểm định F hoạt động tốt khi một vài giả định chủ chốt được đáp ứng ở mức hợp lý. Nếu các giả định này bị vi phạm, thống kê F có thể đưa ra kết quả gây hiểu lầm.
Tính độc lập của các quan sát
Các quan sát trong bộ dữ liệu nên độc lập với nhau — một quan sát không nên ảnh hưởng đến quan sát khác.
Ví dụ, nếu nhiều đo lường đến từ cùng một người hoặc cùng một đơn vị thí nghiệm, tính độc lập có thể bị vi phạm. Khi các quan sát không độc lập, thống kê F có thể đánh giá thấp biến thiên và tạo ra kết quả không đáng tin cậy.
Sai số xấp xỉ chuẩn
Nhiều kiểm định F giả định rằng sai số xấp xỉ phân phối chuẩn. Nói đơn giản, chênh lệch giữa giá trị quan sát và dự đoán của mô hình nên tuân theo một dạng gần chuẩn.
Giả định này trở nên bớt quan trọng với mẫu lớn hơn. Với đủ dữ liệu, kiểm định F thường vẫn hoạt động khá tốt ngay cả khi phân phối không hoàn toàn chuẩn.
Phương sai bằng nhau
ANOVA cổ điển giả định rằng phương sai giữa các nhóm tương tự nhau. Điều kiện này gọi là tính đồng nhất phương sai.
Nếu một nhóm có mức biến thiên cao hơn nhiều so với các nhóm khác, kiểm định F có thể phát hiện sai khác biệt giữa các trung bình nhóm. Vấn đề trầm trọng hơn khi kích thước nhóm rất khác nhau.
Khi kiểm định F vững hơn
Trong nhiều tình huống thực tế, kiểm định F vẫn cho hiệu năng hợp lý.
Ví dụ, ANOVA khá vững khi kích thước các nhóm cân bằng, nghĩa là mỗi nhóm có số quan sát tương tự nhau. Trong các trường hợp này, các vi phạm vừa phải về tính chuẩn hoặc phương sai bằng nhau thường có tác động hạn chế.
Tuy nhiên, vấn đề tăng lên khi hai điều kiện xảy ra cùng lúc như:
Sự kết hợp này có thể làm sai lệch thống kê F và tăng rủi ro kết luận sai.
Các lựa chọn thay thế khi giả định bị vi phạm
Nếu dữ liệu của bạn không đáp ứng các giả định của kiểm định F, bạn có thể dùng các phương pháp thay thế xử lý những vấn đề này hiệu quả hơn:
Những điều gây nhầm lẫn về thống kê F
Thống kê F được sử dụng rộng rãi, nhưng một vài điểm thường gây nhầm lẫn cho người mới bắt đầu. Hầu hết đến từ mối liên hệ của nó với các kiểm định thống kê khác.
Thống kê F so với thống kê t
Thống kê F và thống kê t có liên hệ chặt chẽ. Trong các trường hợp đơn giản, chúng kiểm tra cùng một ý tưởng.
Ví dụ, khi một mô hình hồi quy chỉ có một biến dự báo:
Điều này có nghĩa cả hai kiểm định dẫn đến cùng một kết luận về ý nghĩa thống kê.
Trong các mô hình phức tạp hơn, chúng đóng vai trò khác nhau. Kiểm định t đánh giá từng hệ số một, trong khi kiểm định F đánh giá nhiều tham số cùng lúc.
Mức ý nghĩa tổng thể so với mức ý nghĩa của từng hệ số
Một điểm nhầm lẫn phổ biến khác là sự khác biệt giữa mức ý nghĩa ở cấp độ mô hình và cấp độ biến.
Vì vậy, bạn có thể thấy các kết quả như:
Điều này xảy ra khi nhiều biến cùng nhau giải thích biến kết quả, ngay cả khi mỗi biến chỉ có tác động nhỏ riêng lẻ.
Giá trị F lớn trong các mẫu lớn
Giá trị F lớn thường dẫn đến ý nghĩa thống kê, nhưng không phải lúc nào cũng có nghĩa là kết quả quan trọng trong thực tiễn.
Với kích thước mẫu lớn, ngay cả khác biệt nhỏ cũng có thể tạo ra giá trị F có ý nghĩa. Mô hình có thể giải thích một phần biến thiên, nhưng hiệu ứng có thể nhỏ về mặt thực tế.
Đó là lý do các nhà phân tích cũng xem xét các thước đo kích thước hiệu ứng như R² hoặc eta squared.
Kiểm định hậu nghiệm sau ANOVA
Trong ANOVA, thống kê F trả lời một câu hỏi: tất cả trung bình nhóm có bằng nhau không?
Nếu kết quả có ý nghĩa, nó cho thấy có ít nhất một trung bình nhóm khác biệt. Nó không cho biết các nhóm nào khác nhau.
Để xác định khác biệt, các nhà phân tích chạy các kiểm định hậu nghiệm so sánh các nhóm theo từng cặp.
Ví dụ phổ biến gồm:
Các kiểm định này xác định chính xác nơi tồn tại khác biệt sau khi kiểm định F tổng thể cho thấy có ý nghĩa.
Kết luận
Giờ đây bạn đã hiểu thống kê F hoạt động như thế nào và cách diễn giải trong ANOVA và hồi quy. Hãy áp dụng điều này trong thực hành.
Chạy các phân tích ANOVA hoặc hồi quy đơn giản và tập trung đọc cùng lúc giá trị F, p-value và kích thước hiệu ứng. Điều này sẽ giúp bạn chuyển từ tính toán sang diễn giải thực sự.
Nếu bạn muốn xây dựng nền tảng thống kê vững chắc hơn, hãy đi sâu vào các khái niệm cốt lõi như phương sai, kiểm định giả thuyết và mô hình hồi quy.