F istatistiği, verilerdeki farkların anlamlı mı yoksa sadece rastgele dalgalanma mı olduğunu kontrol etmenize yardımcı olur. Bir modelin veya gruplamanın açıkladığı değişkenliği, açıklanamayan değişkenlikle karşılaştırır.
F istatistiğini ANOVA ve regresyon analizi gibi yaygın istatistiksel yöntemlerde görürsünüz. Her iki durumda da temel bir soruya yanıt verir: Model verileri şanstan daha iyi açıklıyor mu?
Bu kılavuzda, F istatistiğinin neyi ölçtüğünü, nasıl hesaplandığını, ANOVA ve regresyonda nerede karşımıza çıktığını ve sonuçları doğru şekilde nasıl yorumlayacağınızı adım adım anlatacağız.
F İstatistiğinin Ölçtüğü Şey
F istatistiği, bir modelin açıkladığı değişkenliğin, rastgele gürültünün neden olduğu değişkenlikten daha büyük olup olmadığını ölçer. İkisi de varyansın iki kaynağını karşılaştırır: biri sinyali, diğeri gürültüyü temsil eder.
Matematiksel olarak, F istatistiği ortalama kareler (varyanslar) oranıdır:
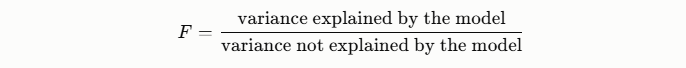
Birçok istatistiksel testte bu şöyle yazılır
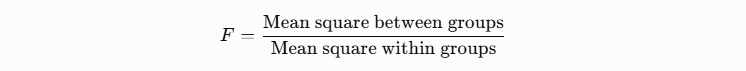
F istatistiği bu iki büyüklüğü karşılaştırır.
- Gruplar arası varyans: Bu, grup ortalamalarının birbirinden ne kadar farklı olduğunu ölçer. Büyük farklar, grupların farklı davrandığını düşündürür.
- Grup içi varyans: Bu, her gruptaki bireysel değerlerin kendi grup ortalaması etrafında ne kadar değiştiğini ölçer. Bu, verilerdeki rastgele gürültüyü veya doğal değişkenliği temsil eder.
Gruplar arası varyans çok daha büyükse, F değeri büyür. Bu, gruplar arasındaki farkların anlamlı olabileceğini gösterir. Grup içi varyans baskınsa, F değeri küçük olur. Bu da gözlenen farkların muhtemelen rastgele olduğunu düşündürür.
F istatistiğinin kullanıldığı yerler
F istatistiğini şu istatistiksel yöntemlerde görebilirsiniz:
- Varyans analizi (ANOVA): ANOVA, birden fazla grup ortalamasının farklı olup olmadığını test etmek için F istatistiğini kullanır. Örneğin, üç pazarlama kampanyasının farklı ortalama dönüşüm oranları üretip üretmediğini test edebilir.
- Genel regresyon anlamlılığı: Doğrusal regresyonda F istatistiği, modelin sonuç değişkeninin anlamlı bir bölümünü açıklayıp açıklamadığını kontrol eder. Basitçe söylersek, yordayıcıların birlikte sadece ortalamayı kullanmaya kıyasla tahmini iyileştirip iyileştirmediğini test eder.
- İç içe modellerin karşılaştırılması: F istatistiği, bir modelin diğerinin daha basit bir versiyonu olduğu iki regresyon modelini de karşılaştırabilir. Bu, ek değişkenler eklemenin, getirilen karmaşıklığı haklı çıkaracak kadar modeli iyileştirip iyileştirmediğini belirlemeye yardımcı olur.
F İstatistiği Nasıl Hesaplanır
F istatistiği, iki ortalama karenin oranı olarak hesaplanır. Bir ortalama kare, bir varyans tahminini temsil eder. Verinin belirli bir bölümünde ne kadar değişkenlik olduğunu gösterir.
Genel formül şu şekildedir: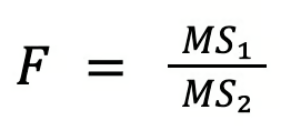
Burada:
- MS₁ bir model veya gruplama yapısı tarafından açıklanan değişkenliği temsil eder.
- MS₂ açıklanamayan değişkenliği temsil eder.
Açıklanan değişkenlik, açıklanamayan değişkenlikten çok daha büyükse, F değeri büyür. Bu, modelin veya gruplamanın anlamlı farkları açıkladığı anlamına gelir.
Yorumlama, yürüttüğünüz analize bağlı olsa da, F istatistiği en yaygın olarak ANOVA ve regresyon analizinde kullanılır.
Basit bir sayısal örnek
Bunu daha netleştirmek için basit bir örnek üzerinden gidelim.
Üç pazarlama kampanyası arasındaki dönüşüm oranlarını karşılaştırdığınızı hayal edin. Kareler toplamını hesaplayıp serbestlik derecelerine böldükten sonra şunları elde ediyorsunuz:
- Gruplar arası ortalama kare (MS_between) = 20
- Gruplar içi ortalama kare (MS_within) = 5
Şimdi F istatistiğini hesaplayın: F = 20 / 5 = 4
Yani F değeri 4.
Bu, kampanya ortalamaları arasındaki değişkenliğin, her kampanyanın kendi içindeki değişkenliğin dört katı olduğu anlamına gelir. Başka bir deyişle, kampanyalar arasındaki farklar, içlerindeki rastgele değişkenliğe kıyasla göreli olarak büyüktür.
F İstatistiği ve F Dağılımı
Sıfır hipotezi doğruyken F istatistiği, F dağılımını takip eder.
Bu dağılım, yalnızca rastgele değişkenlikten kaynaklı olarak F değerinin ne kadar büyüyebileceğini gösterir. Gözlenen F değerinin olağandışı derecede büyük olup olmadığını kontrol etmek için kullanırız.
Bunun nedeni, F istatistiğinin nasıl oluşturulduğundan gelir.
F oranının her bir parçası bir varyans ölçüsüdür. Biri model veya gruplar tarafından açıklanan değişkenliği, diğeri rastgele değişkenliği yakalar. Sıfır hipotezi doğru olduğunda, ikisi de aynı temel varyanstan gelir.
Basitçe söylemek gerekirse, F istatistiği aynı varyansın iki bağımsız tahminini karşılaştırır. Böyle olduğunda, oranları F dağılımını izler.
F dağılımında iki serbestlik derecesi
F dağılımı, iki serbestlik derecesi parametresiyle tanımlanır. Bunlar dağılımın tam şeklini belirler.
- Pay serbestlik derecesi (df₁): F istatistiğinin payındaki varyans tahminine karşılık gelir.
- Payda serbestlik derecesi (df₂): Paydadaki varyans tahminine karşılık gelir.
Uygulamada bu değerler, kullanılan istatistiksel yönteme bağlıdır.
Örneğin:
ANOVA’da:
- Pay serbestlik derecesi = grup sayısı − 1
- Payda serbestlik derecesi = toplam gözlem − grup sayısı
Regresyonda:
- Pay serbestlik derecesi = yordayıcı sayısı
- Payda serbestlik derecesi = örneklem büyüklüğü − yordayıcılar − 1
Bu serbestlik dereceleri, varyans tahminlerinin ne kadar değişken olduğunu belirler. Daha küçük serbestlik dereceleri daha büyük değişkenliğe yol açar ve bu da dağılımın şeklini değiştirir.
F dağılımı sağa çarpıktır. Çoğu değer sıfıra yakındır; daha büyük değerler sağ kuyruğa doğru uzanır. Bu, varyans tahminlerinin negatif olamayışı nedeniyle gerçekleşir. İki varyans tahmininin oranı bu nedenle yalnızca pozitif değerler üretir.
Serbestlik dereceleri dağılımın tam şeklini etkiler:
- Daha küçük serbestlik dereceleri, daha geniş ve sağ kuyruğu daha uzun bir dağılım üretir.
- Daha büyük serbestlik dereceleri, dağılımı daha yoğun hale getirir.
Gözlenen F istatistiği dağılımın sağ kuyruğuna doğru çok uzaklara düşüyorsa, bu açıklanan değişkenliğin açıklanamayan değişkenlikten çok daha büyük olduğunu gösterir. Bu da sıfır hipotezine karşı kanıt sağlar.
ANOVA’da F İstatistiği
Varyans analizinde (ANOVA), F istatistiği birden çok grup ortalamasının eşit olup olmadığını test eder.
Tek yönlü ANOVA için sıfır hipotezi, tüm grup ortalamalarının eşit olduğunu söyler. Alternatif hipotez ise en az bir grup ortalamasının farklı olduğunu belirtir.
Test, gruplar arası değişkenliği grup içi değişkenlikle karşılaştırır. Grup ortalamaları arasındaki farklar, grupların içindeki değişkenlikten çok daha büyükse, F değeri büyür.
Kullanılan bileşenler
ANOVA, toplam değişkenliği iki kısma ayırır:
- SS between (gruplar arası kareler toplamı): Her grup ortalamasının genel ortalamadan ne kadar uzak olduğunu ölçer
- SS within (grup içi kareler toplamı): Gözlemlerin kendi grup ortalamaları etrafında ne kadar değiştiğini ölçer
Bunlar daha sonra serbestlik derecelerine bölünerek ortalama karelere dönüştürülür:
- MS between grup farklarıyla açıklanan varyansı tahmin eder.
- MS within kalan açıklanamayan varyansı tahmin eder.
Ardından F istatistiği bu iki ortalama karenin oranı olarak hesaplanır.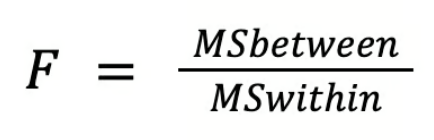
F değerini nasıl yorumlamalı
F değeri, grup farklarının rastgele değişkenliğe kıyasla ne kadar öne çıktığını gösterir. Şu şekilde yorumlayabilirsiniz:
- Küçük F değeri: Gruplar arası değişkenlik, grup içi değişkenliğe benzerdir. Ortalamalar muhtemelen eşittir.
- Büyük F değeri: Gruplar arası değişkenlik çok daha büyüktür. Bu, en az bir grup ortalamasının farklı olduğunu düşündürür.
Temel varsayımlar
ANOVA birkaç varsayıma dayanır:
- Gözlemler bağımsızdır
- Her gruptaki veriler yaklaşık olarak normal dağılır
- Gruplar arası varyanslar benzerdir
Regresyonda F İstatistiği
Regresyon analizinde F istatistiği, modelin, yordayıcı içermeyen bir modelden daha iyi açıklama yapıp yapmadığını test eder.
Karşılaştırma modeli yalnızca sabit terimi içerir ve sonucun ortalama değerini tahmin eder. Bu, genel anlamlılık için F testi olarak bilinir. Hipotezler şunlardır:
- Sıfır hipotezi (H₀): Yordayıcısız model, regresyon modeli kadar iyi uyum sağlar
- Alternatif hipotez (H₁): Regresyon modeli, yalnızca sabit terimli modelden daha iyi uyum sağlar
F istatistiği, modelin açıkladığı değişkenlikle açıklanamayan değişkenliği karşılaştırır.
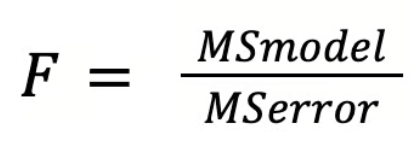
- MS model, yordayıcılar tarafından açıklanan varyansı temsil eder.
- MS error, kalan açıklanamayan varyansı temsil eder.
Açıklanan değişkenlik açıklanamayan değişkenlikten çok daha büyükse, F değeri büyür. Bu, modelin verilerde anlamlı kalıpları yakaladığını gösterir.
F istatistiği ile R² arasındaki ilişki
F istatistiği, R² ile yakından ilişkilidir; R² modelin sonuç değişkenindeki değişkenliğin ne kadarını açıkladığını ölçer.
Model daha fazla değişkenlik açıkladıkça R² artar. Bu, genellikle F istatistiğinin de artmasına yol açar; çünkü açıklanan değişkenlik, açıklanamayan değişkenliğe göre büyür.
Ancak bu iki ölçüt farklı amaçlara hizmet eder:
- R² modelin ne kadar değişkenliği açıkladığını gösterir
- F testi bu açıklanan değişkenliğin istatistiksel olarak anlamlı olup olmadığını değerlendirir
Çoklu regresyonda yorum
Çoklu regresyonda F testi, modelin genel anlamlılığını değerlendirir. Sıfır hipotezi, tüm regresyon katsayılarının sıfıra eşit olduğunu söyler:
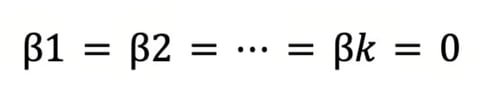
F istatistiği yeterince büyükse, sıfır hipotezi reddedilir. Bu, en az bir yordayıcının sonuç değişkeni üzerinde sıfırdan farklı bir etkiye sahip olduğu anlamına gelir.
F testi modeli bir bütün olarak değerlendirir. Bundan sonra, tek tek yordayıcılar t testleriyle incelenir.
F İstatistiği ve p-Değeri Nasıl Yorumlanır
Bir F testini yorumlamak için şu adımları izleyin:
- F istatistiğini hesaplayın: F değeri iki ortalama karenin oranı olarak hesaplanır. Kesin formül, ANOVA veya regresyon gibi kullanılan yönteme bağlıdır.
- F dağılımına başvurun: Hesaplanan F değeri, iki serbestlik derecesiyle tanımlanan bir F dağılımıyla karşılaştırılır:
- Pay serbestlik derecesi (df₁)
- Payda serbestlik derecesi (df₂)
- p-değerini hesaplayın: p-değeri, sıfır hipotezi doğru kabul edildiğinde, elde edilene en az bu kadar büyük bir F değeri gözleme olasılığını temsil eder.
p-değeri seçilen anlamlılık düzeyinden küçükse, sonuç istatistiksel olarak anlamlı kabul edilir.
İstatistiksel anlamlılık ne anlama gelir
İstatistiksel olarak anlamlı bir F testi, modelin rastgele şansın üreteceğinin ötesinde değişkenliği açıkladığını gösterir.
- ANOVA’da bu, en az bir grup ortalamasının farklı olduğunu düşündürür
- Regresyonda bu, modelin yalnızca sabit terimli bir modelden daha iyi açıkladığını düşündürür
İstatistiksel anlamlılığın ne anlama gelmediği
Anlamlı bir F sonucunun sınırları vardır:
- ANOVA’da hangi spesifik grubun farklı olduğunu belirtmez. Art işlemler (post hoc) testleri gerekir
- Pratik önemi göstermez. Büyük veri kümelerinde küçük etkiler bile istatistiksel olarak anlamlı olabilir
Bu nedenle, analistler genellikle etkinin gücünü anlamak için ek ölçüler rapor eder.
F testini tamamlayan etki büyüklüğü ölçütleri
Etki büyüklüğü istatistikleri, modelin ne kadar değişkenliği açıkladığını nicelleştirmeye yardımcı olur.
ANOVA’da yaygın bir ölçü şudur:
- Eta kare (η²), grup farkları tarafından açıklanan varyans oranını tahmin eder.
Regresyonda yaygın ölçüler şunlardır:
- R², modelin açıkladığı varyans oranını ölçer.
- Düzeltilmiş R², modeldeki bağımsız değişken sayısını dikkate alır.
F İstatistiği Varsayımları ve Yanıltabileceği Durumlar
F testi, birkaç kilit varsayım makul ölçüde sağlandığında iyi çalışır. Bu varsayımlar ihlal edilirse, F istatistiği yanıltıcı sonuçlar üretebilir.
Gözlemlerin bağımsızlığı
Veri kümesindeki gözlemler birbirinden bağımsız olmalıdır — bir gözlem bir diğerini etkilememelidir.
Örneğin, birden fazla ölçüm aynı kişiden veya aynı deney biriminden geliyorsa bağımsızlık ihlal edilebilir. Gözlemler bağımsız değilse, F istatistiği değişkenliği olduğundan düşük tahmin edebilir ve güvenilmez sonuçlar üretebilir.
Yaklaşık normal hatalar
Birçok F testi, hataların yaklaşık olarak normal dağıldığını varsayar. Basitçe, gözlenen değerlerle model tahminleri arasındaki farklar kabaca normal bir örüntü izlemelidir.
Bu varsayım, daha büyük örneklemlerde daha az kritik hale gelir. Yeterli veriyle, dağılım tam olarak normal olmasa bile F testi genellikle makul şekilde çalışır.
Eşit varyanslar
Klasik ANOVA, gruplar arası varyansların benzer olduğunu varsayar. Bu koşula varyans homojenliği denir.
Bir grubun değişkenliği diğerlerinden çok daha yüksekse, F testi grup ortalamaları arasındaki farkları yanlış şekilde tespit edebilir. Grup büyüklükleri çok farklı olduğunda sorun daha da ciddileşir.
F testinin daha dayanıklı olduğu durumlar
Pek çok pratik durumda F testi yine de makul ölçüde iyi performans gösterir.
Örneğin, ANOVA, grup büyüklükleri dengeli olduğunda — yani her grupta benzer sayıda gözlem bulunduğunda — oldukça dayanıklıdır. Bu durumlarda, normallikten veya eşit varyanstan orta düzeyde sapmalar genellikle sınırlı etkiye sahiptir.
Ancak şu iki koşul birlikte gerçekleştiğinde sorunlar artar:
- Gruplar arası varyanslarda güçlü farklılıklar
- Eşit olmayan grup büyüklükleri
Bu kombinasyon, F istatistiğini bozabilir ve yanlış sonuç çıkarma riskini artırabilir.
Varsayımlar ihlal edildiğinde alternatifler
Verileriniz F testinin varsayımlarını karşılamıyorsa, bu sorunları daha etkili biçimde ele alan alternatif yöntemler kullanabilirsiniz:
- Welch’in ANOVA’sı: Gruplar arası eşit olmayan varyansları ele alır
- Sağlam (robust) regresyon yöntemleri: Aykırı değerlerin veya uç değerlerin etkisini azaltır
- Permütasyon testleri: Teorik dağılımlara dayanmak yerine veriyi tekrar tekrar yeniden karıştırarak anlamlılığı tahmin eder
F İstatistiği Hakkında Kafa Karıştıran Noktalar
F istatistiği yaygın olarak kullanılır, ancak bazı noktalar yeni başlayanları sıklıkla şaşırtır. Bunların çoğu, diğer istatistiksel testlerle ilişkili oluşundan kaynaklanır.
F istatistiği vs t istatistiği
F istatistiği ve t istatistiği yakından ilişkilidir. Basit durumlarda aynı fikri test ederler.
Örneğin, bir regresyon modeli yalnızca bir yordayıcıya sahip olduğunda:
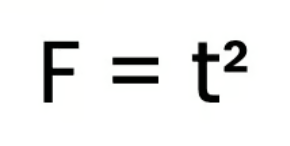
Bu, her iki testin de istatistiksel anlamlılık hakkında aynı sonuca ulaştığı anlamına gelir.
Daha karmaşık modellerde ise farklı roller üstlenirler. t testi bir seferde tek bir katsayıyı değerlendirirken, F testi birden fazla parametreyi birlikte değerlendirir.
Genel anlamlılık vs tekil katsayı anlamlılığı
Bir diğer yaygın kafa karışıklığı, model düzeyindeki anlamlılıkla değişken düzeyindeki anlamlılık arasındaki farktır.
- F testi modeli bir bütün olarak değerlendirir. Modelin, hiç yordayıcı içermeyen bir modelden daha iyi açıklayıp açıklamadığını kontrol eder
- t testi tekil katsayıları değerlendirir. Belirli bir yordayıcının anlamlı bir etkisi olup olmadığını kontrol eder
Bu nedenle, şu gibi sonuçlar görebilirsiniz:
- Genel F testi anlamlı
- Bazı tekil katsayılar anlamlı değil
Bu, birkaç değişken birlikte sonucu açıklarken, her birinin tek başına küçük bir etkiye sahip olduğu durumlarda ortaya çıkar.
Büyük örneklemlerde büyük F değerleri
Büyük bir F değeri genellikle istatistiksel anlamlılığa yol açar, ancak bu her zaman sonucun pratikte önemli olduğu anlamına gelmez.
Büyük örneklem büyüklüklerinde, küçük farklar bile anlamlı F değerleri üretebilir. Model bir miktar değişkenliği açıklayabilir, ancak etkinin gerçek hayattaki büyüklüğü küçük olabilir.
Bu yüzden analistler R² veya eta kare gibi etki büyüklüğü ölçülerine de bakarlar.
ANOVA sonrasında post hoc testler
ANOVA’da F istatistiği tek bir soruya yanıt verir: Tüm grup ortalamaları eşit mi?
Sonuç anlamlıysa, en az bir grup ortalamasının farklı olduğunu gösterir. Hangi grupların farklı olduğunu göstermez.
Farkları belirlemek için analistler, grupları ikili olarak karşılaştıran post hoc testler uygular.
Yaygın örnekler şunlardır:
- Tukey testi: Çoklu karşılaştırmaları kontrol eder
- Bonferroni düzeltmesi: Çok sayıda test yapılırken anlamlılık eşiklerini sıkılaştırır
Bu testler, genel F testi anlamlılık gösterdikten sonra farkların tam olarak nerede olduğunu belirler.
Son Düşünceler
Artık F istatistiğinin nasıl çalıştığını ve ANOVA ile regresyonda nasıl yorumlanacağını biliyorsunuz. Şimdi bunu pratikte uygulayın.
Basit ANOVA veya regresyon analizleri çalıştırın ve F değeri, p-değeri ile etki büyüklüğünü birlikte okumaya odaklanın. Bu, hesaplamadan gerçek yorumlamaya geçmenize yardımcı olacaktır.
Daha güçlü bir istatistik temeli oluşturmak istiyorsanız, varyans, hipotez testleri ve regresyon modellemesi gibi temel kavramlara daha derinlemesine inin.





F istatistiği, verilerdeki farkların anlamlı mı yoksa sadece rastgele dalgalanma mı olduğunu kontrol etmenize yardımcı olur. Bir modelin veya gruplamanın açıkladığı değişkenliği, açıklanamayan değişkenlikle karşılaştırır.
F istatistiğini ANOVA ve regresyon analizi gibi yaygın istatistiksel yöntemlerde görürsünüz. Her iki durumda da temel bir soruya yanıt verir: Model verileri şanstan daha iyi açıklıyor mu?
Bu kılavuzda, F istatistiğinin neyi ölçtüğünü, nasıl hesaplandığını, ANOVA ve regresyonda nerede karşımıza çıktığını ve sonuçları doğru şekilde nasıl yorumlayacağınızı adım adım anlatacağız.
F İstatistiğinin Ölçtüğü Şey
F istatistiği, bir modelin açıkladığı değişkenliğin, rastgele gürültünün neden olduğu değişkenlikten daha büyük olup olmadığını ölçer. İkisi de varyansın iki kaynağını karşılaştırır: biri sinyali, diğeri gürültüyü temsil eder.
Matematiksel olarak, F istatistiği ortalama kareler (varyanslar) oranıdır:
Birçok istatistiksel testte bu şöyle yazılır
F istatistiği bu iki büyüklüğü karşılaştırır.
Gruplar arası varyans çok daha büyükse, F değeri büyür. Bu, gruplar arasındaki farkların anlamlı olabileceğini gösterir. Grup içi varyans baskınsa, F değeri küçük olur. Bu da gözlenen farkların muhtemelen rastgele olduğunu düşündürür.
F istatistiğinin kullanıldığı yerler
F istatistiğini şu istatistiksel yöntemlerde görebilirsiniz:
F İstatistiği Nasıl Hesaplanır
F istatistiği, iki ortalama karenin oranı olarak hesaplanır. Bir ortalama kare, bir varyans tahminini temsil eder. Verinin belirli bir bölümünde ne kadar değişkenlik olduğunu gösterir.
Genel formül şu şekildedir: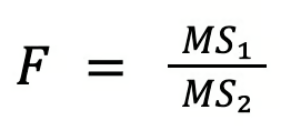
Burada:
Açıklanan değişkenlik, açıklanamayan değişkenlikten çok daha büyükse, F değeri büyür. Bu, modelin veya gruplamanın anlamlı farkları açıkladığı anlamına gelir.
Yorumlama, yürüttüğünüz analize bağlı olsa da, F istatistiği en yaygın olarak ANOVA ve regresyon analizinde kullanılır.
Basit bir sayısal örnek
Bunu daha netleştirmek için basit bir örnek üzerinden gidelim.
Üç pazarlama kampanyası arasındaki dönüşüm oranlarını karşılaştırdığınızı hayal edin. Kareler toplamını hesaplayıp serbestlik derecelerine böldükten sonra şunları elde ediyorsunuz:
Şimdi F istatistiğini hesaplayın: F = 20 / 5 = 4
Yani F değeri 4.
Bu, kampanya ortalamaları arasındaki değişkenliğin, her kampanyanın kendi içindeki değişkenliğin dört katı olduğu anlamına gelir. Başka bir deyişle, kampanyalar arasındaki farklar, içlerindeki rastgele değişkenliğe kıyasla göreli olarak büyüktür.
F İstatistiği ve F Dağılımı
Sıfır hipotezi doğruyken F istatistiği, F dağılımını takip eder.
Bu dağılım, yalnızca rastgele değişkenlikten kaynaklı olarak F değerinin ne kadar büyüyebileceğini gösterir. Gözlenen F değerinin olağandışı derecede büyük olup olmadığını kontrol etmek için kullanırız.
Bunun nedeni, F istatistiğinin nasıl oluşturulduğundan gelir.
F oranının her bir parçası bir varyans ölçüsüdür. Biri model veya gruplar tarafından açıklanan değişkenliği, diğeri rastgele değişkenliği yakalar. Sıfır hipotezi doğru olduğunda, ikisi de aynı temel varyanstan gelir.
Basitçe söylemek gerekirse, F istatistiği aynı varyansın iki bağımsız tahminini karşılaştırır. Böyle olduğunda, oranları F dağılımını izler.
F dağılımında iki serbestlik derecesi
F dağılımı, iki serbestlik derecesi parametresiyle tanımlanır. Bunlar dağılımın tam şeklini belirler.
Uygulamada bu değerler, kullanılan istatistiksel yönteme bağlıdır.
Örneğin:
ANOVA’da:
Regresyonda:
Bu serbestlik dereceleri, varyans tahminlerinin ne kadar değişken olduğunu belirler. Daha küçük serbestlik dereceleri daha büyük değişkenliğe yol açar ve bu da dağılımın şeklini değiştirir.
F dağılımı sağa çarpıktır. Çoğu değer sıfıra yakındır; daha büyük değerler sağ kuyruğa doğru uzanır. Bu, varyans tahminlerinin negatif olamayışı nedeniyle gerçekleşir. İki varyans tahmininin oranı bu nedenle yalnızca pozitif değerler üretir.
Serbestlik dereceleri dağılımın tam şeklini etkiler:
Gözlenen F istatistiği dağılımın sağ kuyruğuna doğru çok uzaklara düşüyorsa, bu açıklanan değişkenliğin açıklanamayan değişkenlikten çok daha büyük olduğunu gösterir. Bu da sıfır hipotezine karşı kanıt sağlar.
ANOVA’da F İstatistiği
Varyans analizinde (ANOVA), F istatistiği birden çok grup ortalamasının eşit olup olmadığını test eder.
Tek yönlü ANOVA için sıfır hipotezi, tüm grup ortalamalarının eşit olduğunu söyler. Alternatif hipotez ise en az bir grup ortalamasının farklı olduğunu belirtir.
Test, gruplar arası değişkenliği grup içi değişkenlikle karşılaştırır. Grup ortalamaları arasındaki farklar, grupların içindeki değişkenlikten çok daha büyükse, F değeri büyür.
Kullanılan bileşenler
ANOVA, toplam değişkenliği iki kısma ayırır:
Bunlar daha sonra serbestlik derecelerine bölünerek ortalama karelere dönüştürülür:
Ardından F istatistiği bu iki ortalama karenin oranı olarak hesaplanır.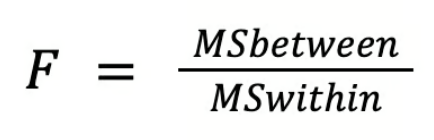
F değerini nasıl yorumlamalı
F değeri, grup farklarının rastgele değişkenliğe kıyasla ne kadar öne çıktığını gösterir. Şu şekilde yorumlayabilirsiniz:
Temel varsayımlar
ANOVA birkaç varsayıma dayanır:
Regresyonda F İstatistiği
Regresyon analizinde F istatistiği, modelin, yordayıcı içermeyen bir modelden daha iyi açıklama yapıp yapmadığını test eder.
Karşılaştırma modeli yalnızca sabit terimi içerir ve sonucun ortalama değerini tahmin eder. Bu, genel anlamlılık için F testi olarak bilinir. Hipotezler şunlardır:
F istatistiği, modelin açıkladığı değişkenlikle açıklanamayan değişkenliği karşılaştırır.
Açıklanan değişkenlik açıklanamayan değişkenlikten çok daha büyükse, F değeri büyür. Bu, modelin verilerde anlamlı kalıpları yakaladığını gösterir.
F istatistiği ile R² arasındaki ilişki
F istatistiği, R² ile yakından ilişkilidir; R² modelin sonuç değişkenindeki değişkenliğin ne kadarını açıkladığını ölçer.
Model daha fazla değişkenlik açıkladıkça R² artar. Bu, genellikle F istatistiğinin de artmasına yol açar; çünkü açıklanan değişkenlik, açıklanamayan değişkenliğe göre büyür.
Ancak bu iki ölçüt farklı amaçlara hizmet eder:
Çoklu regresyonda yorum
Çoklu regresyonda F testi, modelin genel anlamlılığını değerlendirir. Sıfır hipotezi, tüm regresyon katsayılarının sıfıra eşit olduğunu söyler:
F istatistiği yeterince büyükse, sıfır hipotezi reddedilir. Bu, en az bir yordayıcının sonuç değişkeni üzerinde sıfırdan farklı bir etkiye sahip olduğu anlamına gelir.
F testi modeli bir bütün olarak değerlendirir. Bundan sonra, tek tek yordayıcılar t testleriyle incelenir.
F İstatistiği ve p-Değeri Nasıl Yorumlanır
Bir F testini yorumlamak için şu adımları izleyin:
p-değeri seçilen anlamlılık düzeyinden küçükse, sonuç istatistiksel olarak anlamlı kabul edilir.
İstatistiksel anlamlılık ne anlama gelir
İstatistiksel olarak anlamlı bir F testi, modelin rastgele şansın üreteceğinin ötesinde değişkenliği açıkladığını gösterir.
İstatistiksel anlamlılığın ne anlama gelmediği
Anlamlı bir F sonucunun sınırları vardır:
Bu nedenle, analistler genellikle etkinin gücünü anlamak için ek ölçüler rapor eder.
F testini tamamlayan etki büyüklüğü ölçütleri
Etki büyüklüğü istatistikleri, modelin ne kadar değişkenliği açıkladığını nicelleştirmeye yardımcı olur.
ANOVA’da yaygın bir ölçü şudur:
Regresyonda yaygın ölçüler şunlardır:
F İstatistiği Varsayımları ve Yanıltabileceği Durumlar
F testi, birkaç kilit varsayım makul ölçüde sağlandığında iyi çalışır. Bu varsayımlar ihlal edilirse, F istatistiği yanıltıcı sonuçlar üretebilir.
Gözlemlerin bağımsızlığı
Veri kümesindeki gözlemler birbirinden bağımsız olmalıdır — bir gözlem bir diğerini etkilememelidir.
Örneğin, birden fazla ölçüm aynı kişiden veya aynı deney biriminden geliyorsa bağımsızlık ihlal edilebilir. Gözlemler bağımsız değilse, F istatistiği değişkenliği olduğundan düşük tahmin edebilir ve güvenilmez sonuçlar üretebilir.
Yaklaşık normal hatalar
Birçok F testi, hataların yaklaşık olarak normal dağıldığını varsayar. Basitçe, gözlenen değerlerle model tahminleri arasındaki farklar kabaca normal bir örüntü izlemelidir.
Bu varsayım, daha büyük örneklemlerde daha az kritik hale gelir. Yeterli veriyle, dağılım tam olarak normal olmasa bile F testi genellikle makul şekilde çalışır.
Eşit varyanslar
Klasik ANOVA, gruplar arası varyansların benzer olduğunu varsayar. Bu koşula varyans homojenliği denir.
Bir grubun değişkenliği diğerlerinden çok daha yüksekse, F testi grup ortalamaları arasındaki farkları yanlış şekilde tespit edebilir. Grup büyüklükleri çok farklı olduğunda sorun daha da ciddileşir.
F testinin daha dayanıklı olduğu durumlar
Pek çok pratik durumda F testi yine de makul ölçüde iyi performans gösterir.
Örneğin, ANOVA, grup büyüklükleri dengeli olduğunda — yani her grupta benzer sayıda gözlem bulunduğunda — oldukça dayanıklıdır. Bu durumlarda, normallikten veya eşit varyanstan orta düzeyde sapmalar genellikle sınırlı etkiye sahiptir.
Ancak şu iki koşul birlikte gerçekleştiğinde sorunlar artar:
Bu kombinasyon, F istatistiğini bozabilir ve yanlış sonuç çıkarma riskini artırabilir.
Varsayımlar ihlal edildiğinde alternatifler
Verileriniz F testinin varsayımlarını karşılamıyorsa, bu sorunları daha etkili biçimde ele alan alternatif yöntemler kullanabilirsiniz:
F İstatistiği Hakkında Kafa Karıştıran Noktalar
F istatistiği yaygın olarak kullanılır, ancak bazı noktalar yeni başlayanları sıklıkla şaşırtır. Bunların çoğu, diğer istatistiksel testlerle ilişkili oluşundan kaynaklanır.
F istatistiği vs t istatistiği
F istatistiği ve t istatistiği yakından ilişkilidir. Basit durumlarda aynı fikri test ederler.
Örneğin, bir regresyon modeli yalnızca bir yordayıcıya sahip olduğunda:
Bu, her iki testin de istatistiksel anlamlılık hakkında aynı sonuca ulaştığı anlamına gelir.
Daha karmaşık modellerde ise farklı roller üstlenirler. t testi bir seferde tek bir katsayıyı değerlendirirken, F testi birden fazla parametreyi birlikte değerlendirir.
Genel anlamlılık vs tekil katsayı anlamlılığı
Bir diğer yaygın kafa karışıklığı, model düzeyindeki anlamlılıkla değişken düzeyindeki anlamlılık arasındaki farktır.
Bu nedenle, şu gibi sonuçlar görebilirsiniz:
Bu, birkaç değişken birlikte sonucu açıklarken, her birinin tek başına küçük bir etkiye sahip olduğu durumlarda ortaya çıkar.
Büyük örneklemlerde büyük F değerleri
Büyük bir F değeri genellikle istatistiksel anlamlılığa yol açar, ancak bu her zaman sonucun pratikte önemli olduğu anlamına gelmez.
Büyük örneklem büyüklüklerinde, küçük farklar bile anlamlı F değerleri üretebilir. Model bir miktar değişkenliği açıklayabilir, ancak etkinin gerçek hayattaki büyüklüğü küçük olabilir.
Bu yüzden analistler R² veya eta kare gibi etki büyüklüğü ölçülerine de bakarlar.
ANOVA sonrasında post hoc testler
ANOVA’da F istatistiği tek bir soruya yanıt verir: Tüm grup ortalamaları eşit mi?
Sonuç anlamlıysa, en az bir grup ortalamasının farklı olduğunu gösterir. Hangi grupların farklı olduğunu göstermez.
Farkları belirlemek için analistler, grupları ikili olarak karşılaştıran post hoc testler uygular.
Yaygın örnekler şunlardır:
Bu testler, genel F testi anlamlılık gösterdikten sonra farkların tam olarak nerede olduğunu belirler.
Son Düşünceler
Artık F istatistiğinin nasıl çalıştığını ve ANOVA ile regresyonda nasıl yorumlanacağını biliyorsunuz. Şimdi bunu pratikte uygulayın.
Basit ANOVA veya regresyon analizleri çalıştırın ve F değeri, p-değeri ile etki büyüklüğünü birlikte okumaya odaklanın. Bu, hesaplamadan gerçek yorumlamaya geçmenize yardımcı olacaktır.
Daha güçlü bir istatistik temeli oluşturmak istiyorsanız, varyans, hipotez testleri ve regresyon modellemesi gibi temel kavramlara daha derinlemesine inin.