Die F-Statistik hilft dir zu prüfen, ob Unterschiede in Daten aussagekräftig sind oder nur zufällige Schwankungen. Sie vergleicht die durch ein Modell oder eine Gruppierung erklärte Variation mit der nicht erklärten Variation.
Du begegnest der F-Statistik in gängigen Verfahren wie ANOVA und der Regressionsanalyse. In beiden Fällen beantwortet sie eine Grundfrage: Erklärt das Modell die Daten besser als der Zufall?
In diesem Leitfaden zeigen wir dir, was die F-Statistik misst, wie sie berechnet wird, wo sie in ANOVA und Regression auftaucht und wie du die Ergebnisse korrekt interpretierst.
Was die F-Statistik misst
Die F-Statistik prüft, ob die durch ein Modell erklärte Variation größer ist als die durch zufälliges Rauschen verursachte Variation. Sie vergleicht zwei Varianzquellen: eine repräsentiert das Signal, die andere das Rauschen.
Mathematisch ist die F-Statistik ein Verhältnis von mittleren Quadratsummen (Varianzen):
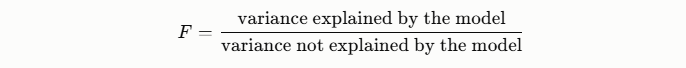
In vielen statistischen Tests wird das so geschrieben:
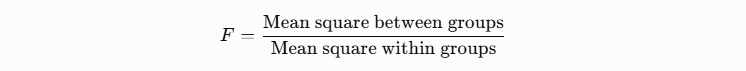
Die F-Statistik vergleicht diese beiden Größen.
- Zwischengruppenvarianz: Sie misst, wie stark sich die Gruppenmittelwerte voneinander unterscheiden. Große Unterschiede deuten darauf hin, dass sich die Gruppen unterschiedlich verhalten.
- Innengruppenvarianz: Sie misst, wie stark die Einzelwerte innerhalb einer Gruppe um ihren jeweiligen Gruppenmittelwert streuen. Das steht für zufälliges Rauschen oder natürliche Streuung in den Daten.
Ist die Zwischengruppenvarianz deutlich größer, wird der F-Wert groß. Das spricht dafür, dass die Unterschiede zwischen den Gruppen substanziell sind. Überwiegt die Innengruppenvarianz, wird der F-Wert klein. Dann sind die beobachteten Unterschiede wahrscheinlich zufällig.
Wo die F-Statistik eingesetzt wird
Du triffst die F-Statistik in folgenden Verfahren:
- Varianzanalyse (ANOVA): ANOVA nutzt die F-Statistik, um zu testen, ob sich mehrere Gruppenmittelwerte unterscheiden. Zum Beispiel lässt sich prüfen, ob drei Marketingkampagnen unterschiedliche durchschnittliche Conversion Rates erzielen.
- Gesamtsignifikanz der Regression: In der linearen Regression prüft die F-Statistik, ob das Modell einen substanziellen Teil der Zielgröße erklärt. Vereinfacht gesagt, testet sie, ob die Prädiktoren zusammen bessere Vorhersagen liefern als nur der Durchschnitt.
- Vergleich verschachtelter Modelle: Die F-Statistik kann auch zwei Regressionsmodelle vergleichen, bei denen eines die vereinfachte Version des anderen ist. So lässt sich beurteilen, ob zusätzliche Variablen genug Mehrwert bringen, um die höhere Komplexität zu rechtfertigen.
So berechnest du die F-Statistik
Die F-Statistik ist das Verhältnis zweier mittlerer Quadratsummen. Eine mittlere Quadratsumme ist eine Varianzschätzung. Sie zeigt, wie viel Streuung in einem bestimmten Datenanteil steckt.
Die allgemeine Formel sieht so aus: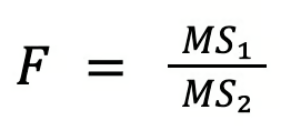
Dabei gilt:
- MS₁ steht für Variation, die durch ein Modell oder eine Gruppierung erklärt wird.
- MS₂ steht für die verbleibende, nicht erklärte Variation.
Ist die erklärte Variation deutlich größer als die unerklärte, wird der F-Wert groß. Das bedeutet, das Modell oder die Gruppierung erklärt relevante Unterschiede.
Die Interpretation hängt zwar von der jeweiligen Analyse ab, am häufigsten wird die F-Statistik in ANOVA und Regressionsanalyse verwendet.
Ein einfaches Zahlenbeispiel
Gehen wir ein simples Beispiel durch, um das zu veranschaulichen.
Stell dir vor, du vergleichst Conversion Rates von drei Marketingkampagnen. Nach der Berechnung der Quadratsummen und dem Teilen durch die Freiheitsgrade erhältst du:
- Mittlere Quadratsumme zwischen Gruppen (MS_between) = 20
- Mittlere Quadratsumme innerhalb der Gruppen (MS_within) = 5
Nun berechnest du die F-Statistik: F = 20 / 5 = 4
Der F-Wert beträgt also 4.
Das heißt, die Variation zwischen den Kampagnenmittelwerten ist viermal so groß wie die Variation innerhalb der Kampagnen. Anders gesagt: Die Unterschiede zwischen den Kampagnen sind relativ groß im Vergleich zur zufälligen Streuung innerhalb der Kampagnen.
Die F-Statistik und die F-Verteilung
Unter der Nullhypothese folgt die F-Statistik einer F-Verteilung.
Diese Verteilung zeigt, wie groß der F-Wert allein durch Zufall werden kann. Wir nutzen sie, um zu prüfen, ob der beobachtete F-Wert ungewöhnlich groß ist.
Der Grund liegt im Aufbau der F-Statistik.
Jeder Anteil im F-Verhältnis ist eine Varianzschätzung. Einer erfasst die durch Modell oder Gruppen erklärte Variation, der andere die zufällige Variation. Gilt die Nullhypothese, stammen beide aus derselben Grundvarianz.
Vereinfacht gesagt vergleicht die F-Statistik zwei unabhängige Schätzungen derselben Varianz. In diesem Fall folgt ihr Verhältnis der F-Verteilung.
Die zwei Freiheitsgrade der F-Verteilung
Die F-Verteilung wird durch zwei Freiheitsgrade festgelegt. Sie bestimmen die genaue Form der Verteilung.
- Freiheitsgrade Zähler (df₁): Entsprechen der Varianzschätzung im Zähler der F-Statistik.
- Freiheitsgrade Nenner (df₂): Entsprechen der Varianzschätzung im Nenner.
In der Praxis hängen diese Werte vom verwendeten Verfahren ab.
Zum Beispiel:
In ANOVA:
- df Zähler = Anzahl Gruppen − 1
- df Nenner = Gesamtzahl Beobachtungen − Anzahl Gruppen
In der Regression:
- df Zähler = Anzahl Prädiktoren
- df Nenner = Stichprobengröße − Prädiktoren − 1
Diese Freiheitsgrade bestimmen, wie variabel die Varianzschätzungen sind. Kleine Freiheitsgrade führen zu stärkerer Streuung und verändern die Form der Verteilung.
Die F-Verteilung ist rechtsschief. Die meisten Werte liegen nahe bei null, größere Werte ziehen sich in den rechten Schwanz. Das liegt daran, dass Varianzschätzungen nicht negativ sein können. Das Verhältnis zweier Varianzschätzungen liefert daher nur positive Werte.
Die Freiheitsgrade beeinflussen die genaue Form der Verteilung:
- Kleinere Freiheitsgrade erzeugen eine breitere Verteilung mit längerem rechten Schwanz.
- Größere Freiheitsgrade konzentrieren die Verteilung stärker.
Liegt der beobachtete F-Wert weit im rechten Schwanz der Verteilung, spricht das dafür, dass die erklärte Variation deutlich größer ist als die unerklärte. Das liefert Evidenz gegen die Nullhypothese.
F-Statistik in ANOVA
In der Varianzanalyse (ANOVA) testet die F-Statistik, ob mehrere Gruppenmittelwerte gleich sind.
Bei einer einfaktoriellen ANOVA besagt die Nullhypothese, dass alle Gruppenmittelwerte gleich sind. Die Alternative besagt, dass sich mindestens ein Gruppenmittelwert unterscheidet.
Der Test vergleicht Variation zwischen Gruppen mit Variation innerhalb der Gruppen. Sind die Unterschiede zwischen den Gruppenmitteln deutlich größer als die Streuung innerhalb der Gruppen, wird der F-Wert groß.
Verwendete Komponenten
ANOVA zerlegt die Gesamtvariation in zwei Teile:
- SS between (Quadratsumme zwischen Gruppen): Misst, wie weit die Gruppenmittel vom Gesamtmittel entfernt sind
- SS within (Quadratsumme innerhalb der Gruppen): Misst, wie stark Beobachtungen um ihren jeweiligen Gruppenmittelwert streuen
Diese werden durch Teilen durch ihre Freiheitsgrade in mittlere Quadratsummen umgewandelt:
- MS between schätzt die durch Gruppenunterschiede erklärte Varianz.
- MS within schätzt die verbleibende, unerklärte Varianz.
Die F-Statistik ergibt sich dann als Verhältnis dieser beiden mittleren Quadratsummen.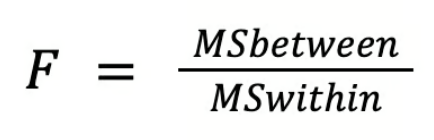
So interpretierst du den F-Wert
Der F-Wert zeigt, wie stark sich Gruppenunterschiede gegenüber zufälliger Streuung abheben. Du kannst ihn so lesen:
- Kleiner F-Wert: Variation zwischen Gruppen ähnelt der Variation innerhalb der Gruppen. Die Mittelwerte sind vermutlich gleich.
- Großer F-Wert: Die Zwischengruppenvariation ist deutlich größer. Das deutet darauf hin, dass mindestens ein Gruppenmittelwert abweicht.
Wichtige Annahmen
ANOVA beruht auf einigen Annahmen:
- Beobachtungen sind unabhängig
- Daten innerhalb jeder Gruppe sind näherungsweise normalverteilt
- Varianzen sind gruppenübergreifend ähnlich
F-Statistik in der Regression
In der Regressionsanalyse testet die F-Statistik, ob das Modell die Daten besser erklärt als ein Modell ohne Prädiktoren.
Das Vergleichsmodell enthält nur einen Achsenabschnitt und sagt den durchschnittlichen Wert der Zielgröße voraus. Das ist der F-Test auf Gesamtsignifikanz. Die Hypothesen lauten:
- Nullhypothese (H₀): Das Modell ohne Prädiktoren passt die Daten genauso gut wie das Regressionsmodell
- Alternativhypothese (H₁): Das Regressionsmodell passt besser als das reine Achsenabschnittsmodell
Die F-Statistik vergleicht die durch das Modell erklärte Variation mit der verbleibenden unerklärten Variation.
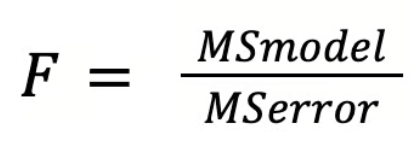
- MS model steht für die durch die Prädiktoren erklärte Varianz.
- MS error steht für die verbleibende, unerklärte Varianz.
Ist die erklärte Variation deutlich größer als die unerklärte, wird der F-Wert groß. Das zeigt, dass das Modell sinnvolle Muster in den Daten erfasst.
Zusammenhang zwischen F-Statistik und R²
Die F-Statistik ist eng mit R² verwandt, das misst, wie viel Variation der Zielgröße vom Modell erklärt wird.
Erklärt das Modell mehr Variation, steigt R². Das erhöht in der Regel auch die F-Statistik, weil die erklärte Variation relativ zur unerklärten größer wird.
Dennoch erfüllen beide Maße unterschiedliche Zwecke:
- R² zeigt, wie viel Variation das Modell erklärt
- F-Test bewertet, ob diese erklärte Variation statistisch signifikant ist
Interpretation in der multiplen Regression
In der multiplen Regression bewertet der F-Test die Gesamtsignifikanz des Modells. Die Nullhypothese besagt, dass alle Regressionskoeffizienten null sind:
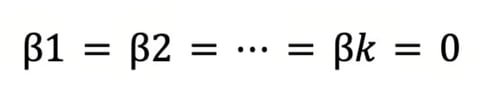
Ist die F-Statistik groß genug, wird die Nullhypothese verworfen. Das bedeutet, dass mindestens ein Prädiktor einen ungleich null Effekt auf die Zielgröße hat.
Der F-Test bewertet das Modell als Ganzes. Anschließend werden einzelne Prädiktoren mit t-Tests geprüft.
So interpretierst du die F-Statistik und den p-Wert
So interpretierst du einen F-Test Schritt für Schritt:
- F-Statistik berechnen: Der F-Wert ist das Verhältnis zweier mittlerer Quadratsummen. Die genaue Formel hängt vom Verfahren ab, z. B. ANOVA oder Regression.
- F-Verteilung heranziehen: Der berechnete F-Wert wird mit einer F-Verteilung verglichen, die durch zwei Freiheitsgrade festgelegt ist:
- Freiheitsgrade Zähler (df₁)
- Freiheitsgrade Nenner (df₂)
- p-Wert berechnen: Der p-Wert ist die Wahrscheinlichkeit, unter der Nullhypothese einen F-Wert mindestens so groß wie den beobachteten zu erhalten.
Ist der p-Wert kleiner als das gewählte Signifikanzniveau, gilt das Ergebnis als statistisch signifikant.
Was statistische Signifikanz bedeutet
Ein statistisch signifikanter F-Test zeigt, dass das Modell mehr Variation erklärt, als durch Zufall zu erwarten wäre.
- In ANOVA deutet das darauf hin, dass sich mindestens ein Gruppenmittelwert unterscheidet
- In der Regression deutet es darauf hin, dass das Modell die Zielgröße besser erklärt als ein Achsenabschnittsmodell
Was statistische Signifikanz nicht bedeutet
Ein signifikantes F-Ergebnis hat Grenzen:
- Es zeigt in ANOVA nicht, welche Gruppen sich unterscheiden. Dazu braucht es Post-hoc-Tests
- Es sagt nichts über praktische Relevanz aus. Kleine Effekte können insbesondere bei großen Datensätzen statistisch signifikant sein
Deshalb berichten Analysten oft zusätzliche Maße, um die Stärke des Effekts einzuordnen.
Effektstärkemaße als Ergänzung zum F-Test
Effektstärken quantifizieren, wie viel Variation das Modell erklärt.
In ANOVA ist ein gängiges Maß:
- Eta-Quadrat (η²), das den durch Gruppenunterschiede erklärten Varianzanteil schätzt.
In der Regression sind gängige Maße:
- R², der vom Modell erklärte Varianzanteil.
- Adjustiertes R², das die Anzahl der unabhängigen Variablen berücksichtigt.
Annahmen der F-Statistik und wann sie in die Irre führt
Der F-Test funktioniert gut, wenn einige zentrale Annahmen vernünftig erfüllt sind. Werden sie verletzt, kann die F-Statistik irreführende Ergebnisse liefern.
Unabhängigkeit der Beobachtungen
Die Beobachtungen sollten unabhängig voneinander sein — eine Beobachtung darf eine andere nicht beeinflussen.
Wenn zum Beispiel mehrere Messungen von derselben Person oder derselben Versuchseinheit stammen, kann die Unabhängigkeit verletzt sein. Sind Beobachtungen nicht unabhängig, unterschätzt die F-Statistik die Streuung und liefert unzuverlässige Ergebnisse.
Näherungsweise normale Fehler
Viele F-Tests setzen näherungsweise normalverteilte Fehler voraus. Vereinfacht: Die Differenzen zwischen beobachteten Werten und Modellvorhersagen sollten grob normalverteilt sein.
Diese Annahme wird bei größeren Stichproben weniger kritisch. Mit genügend Daten funktioniert der F-Test oft auch dann noch gut, wenn die Verteilung nicht perfekt normal ist.
Gleiche Varianzen
Die klassische ANOVA setzt ähnliche Varianzen über die Gruppen hinweg voraus. Diese Bedingung heißt Varianzhomogenität.
Hat eine Gruppe eine deutlich höhere Streuung als die anderen, kann der F-Test fälschlich Unterschiede der Gruppenmittel erkennen. Das Problem verschärft sich bei stark unterschiedlichen Gruppengrößen.
Wann der F-Test robuster ist
In vielen praktischen Fällen liefert der F-Test dennoch brauchbare Ergebnisse.
ANOVA ist zum Beispiel recht robust, wenn die Gruppengrößen ausgeglichen sind, also jede Gruppe ähnlich viele Beobachtungen enthält. Dann haben moderate Verletzungen von Normalität oder Varianzhomogenität oft nur begrenzten Einfluss.
Probleme nehmen jedoch zu, wenn zwei Bedingungen zusammenkommen, etwa:
- Starke Unterschiede in den Gruppenvarianzen
- Ungleiche Gruppengrößen
Diese Kombination kann die F-Statistik verzerren und das Risiko falscher Schlussfolgerungen erhöhen.
Alternativen bei verletzten Annahmen
Wenn deine Daten die Annahmen des F-Tests nicht erfüllen, gibt es Alternativen, die damit besser umgehen:
- Welch-ANOVA: Für ungleiche Gruppenvarianzen
- Robuste Regressionsmethoden: Verringern den Einfluss extremer Werte oder Ausreißer
- Permutations-Tests: Schätzen Signifikanz durch wiederholtes Zufalls-Umsortieren der Daten statt über theoretische Verteilungen
Typische Stolpersteine rund um die F-Statistik
Die F-Statistik ist weit verbreitet, dennoch verwirren einige Punkte häufig Einsteiger. Meist geht es um die Beziehung zu anderen Tests.
F-Statistik vs. t-Statistik
F- und t-Statistik sind eng verwandt. In einfachen Fällen prüfen sie dieselbe Idee.
Hat ein Regressionsmodell zum Beispiel nur einen Prädiktor:
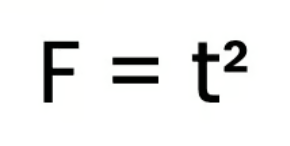
Dann führen beide Tests zur gleichen Aussage über statistische Signifikanz.
In komplexeren Modellen erfüllen sie unterschiedliche Rollen. Der t-Test prüft jeweils einen Koeffizienten, der F-Test bewertet mehrere Parameter gemeinsam.
Gesamtsignifikanz vs. Signifikanz einzelner Koeffizienten
Ein weiterer häufiger Knackpunkt ist der Unterschied zwischen Modell- und Variablensignifikanz.
- Der F-Test bewertet das gesamte Modell. Er prüft, ob das Modell die Zielgröße besser erklärt als ein Modell ohne Prädiktoren
- Der t-Test bewertet einzelne Koeffizienten. Er prüft, ob ein spezifischer Prädiktor einen signifikanten Effekt hat
Daher kannst du Ergebnisse sehen wie:
- Der Gesamt-F-Test ist signifikant
- Einige einzelne Koeffizienten sind nicht signifikant
Das passiert, wenn mehrere Variablen gemeinsam die Zielgröße erklären, auch wenn jede für sich nur einen kleinen Effekt hat.
Große F-Werte bei großen Stichproben
Ein großer F-Wert führt oft zu statistischer Signifikanz, doch das heißt nicht automatisch, dass das Ergebnis praktisch relevant ist.
Bei großen Stichproben können selbst kleine Unterschiede signifikante F-Werte erzeugen. Das Modell erklärt dann zwar etwas Variation, der Effekt ist aber unter Umständen in der Praxis gering.
Darum schauen Analysten zusätzlich auf Effektstärken wie R² oder Eta-Quadrat.
Post-hoc-Tests nach ANOVA
In ANOVA beantwortet die F-Statistik eine Frage: Sind alle Gruppenmittelwerte gleich?
Ist das Ergebnis signifikant, zeigt das, dass sich mindestens ein Gruppenmittelwert unterscheidet. Es zeigt jedoch nicht, welche Gruppen differieren.
Um die Unterschiede zu identifizieren, führen Analysten Post-hoc-Tests durch, die Gruppen paarweise vergleichen.
Gängige Beispiele sind:
- Tukey-Test: Kontrolliert Mehrfachvergleiche
- Bonferroni-Korrektur: Verschärft die Signifikanzschwellen bei vielen Tests
Diese Tests zeigen exakt, wo die Unterschiede liegen, nachdem der Gesamt-F-Test Signifikanz gezeigt hat.
Abschließende Gedanken
Du weißt jetzt, wie die F-Statistik funktioniert und wie du sie in ANOVA und Regression interpretierst. Setze das jetzt in der Praxis um.
Führe einfache ANOVA- oder Regressionsanalysen durch und lies F-Wert, p-Wert und Effektstärke gemeinsam. So kommst du von der reinen Berechnung zur fundierten Interpretation.
Wenn du dir eine stärkere Statistik-Grundlage aufbauen willst, vertiefe Kernkonzepte wie Varianz, Hypothesentests und Regressionsmodellierung.





Die F-Statistik hilft dir zu prüfen, ob Unterschiede in Daten aussagekräftig sind oder nur zufällige Schwankungen. Sie vergleicht die durch ein Modell oder eine Gruppierung erklärte Variation mit der nicht erklärten Variation.
Du begegnest der F-Statistik in gängigen Verfahren wie ANOVA und der Regressionsanalyse. In beiden Fällen beantwortet sie eine Grundfrage: Erklärt das Modell die Daten besser als der Zufall?
In diesem Leitfaden zeigen wir dir, was die F-Statistik misst, wie sie berechnet wird, wo sie in ANOVA und Regression auftaucht und wie du die Ergebnisse korrekt interpretierst.
Was die F-Statistik misst
Die F-Statistik prüft, ob die durch ein Modell erklärte Variation größer ist als die durch zufälliges Rauschen verursachte Variation. Sie vergleicht zwei Varianzquellen: eine repräsentiert das Signal, die andere das Rauschen.
Mathematisch ist die F-Statistik ein Verhältnis von mittleren Quadratsummen (Varianzen):
In vielen statistischen Tests wird das so geschrieben:
Die F-Statistik vergleicht diese beiden Größen.
Ist die Zwischengruppenvarianz deutlich größer, wird der F-Wert groß. Das spricht dafür, dass die Unterschiede zwischen den Gruppen substanziell sind. Überwiegt die Innengruppenvarianz, wird der F-Wert klein. Dann sind die beobachteten Unterschiede wahrscheinlich zufällig.
Wo die F-Statistik eingesetzt wird
Du triffst die F-Statistik in folgenden Verfahren:
So berechnest du die F-Statistik
Die F-Statistik ist das Verhältnis zweier mittlerer Quadratsummen. Eine mittlere Quadratsumme ist eine Varianzschätzung. Sie zeigt, wie viel Streuung in einem bestimmten Datenanteil steckt.
Die allgemeine Formel sieht so aus: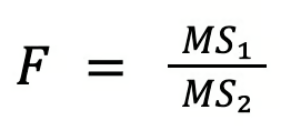
Dabei gilt:
Ist die erklärte Variation deutlich größer als die unerklärte, wird der F-Wert groß. Das bedeutet, das Modell oder die Gruppierung erklärt relevante Unterschiede.
Die Interpretation hängt zwar von der jeweiligen Analyse ab, am häufigsten wird die F-Statistik in ANOVA und Regressionsanalyse verwendet.
Ein einfaches Zahlenbeispiel
Gehen wir ein simples Beispiel durch, um das zu veranschaulichen.
Stell dir vor, du vergleichst Conversion Rates von drei Marketingkampagnen. Nach der Berechnung der Quadratsummen und dem Teilen durch die Freiheitsgrade erhältst du:
Nun berechnest du die F-Statistik: F = 20 / 5 = 4
Der F-Wert beträgt also 4.
Das heißt, die Variation zwischen den Kampagnenmittelwerten ist viermal so groß wie die Variation innerhalb der Kampagnen. Anders gesagt: Die Unterschiede zwischen den Kampagnen sind relativ groß im Vergleich zur zufälligen Streuung innerhalb der Kampagnen.
Die F-Statistik und die F-Verteilung
Unter der Nullhypothese folgt die F-Statistik einer F-Verteilung.
Diese Verteilung zeigt, wie groß der F-Wert allein durch Zufall werden kann. Wir nutzen sie, um zu prüfen, ob der beobachtete F-Wert ungewöhnlich groß ist.
Der Grund liegt im Aufbau der F-Statistik.
Jeder Anteil im F-Verhältnis ist eine Varianzschätzung. Einer erfasst die durch Modell oder Gruppen erklärte Variation, der andere die zufällige Variation. Gilt die Nullhypothese, stammen beide aus derselben Grundvarianz.
Vereinfacht gesagt vergleicht die F-Statistik zwei unabhängige Schätzungen derselben Varianz. In diesem Fall folgt ihr Verhältnis der F-Verteilung.
Die zwei Freiheitsgrade der F-Verteilung
Die F-Verteilung wird durch zwei Freiheitsgrade festgelegt. Sie bestimmen die genaue Form der Verteilung.
In der Praxis hängen diese Werte vom verwendeten Verfahren ab.
Zum Beispiel:
In ANOVA:
In der Regression:
Diese Freiheitsgrade bestimmen, wie variabel die Varianzschätzungen sind. Kleine Freiheitsgrade führen zu stärkerer Streuung und verändern die Form der Verteilung.
Die F-Verteilung ist rechtsschief. Die meisten Werte liegen nahe bei null, größere Werte ziehen sich in den rechten Schwanz. Das liegt daran, dass Varianzschätzungen nicht negativ sein können. Das Verhältnis zweier Varianzschätzungen liefert daher nur positive Werte.
Die Freiheitsgrade beeinflussen die genaue Form der Verteilung:
Liegt der beobachtete F-Wert weit im rechten Schwanz der Verteilung, spricht das dafür, dass die erklärte Variation deutlich größer ist als die unerklärte. Das liefert Evidenz gegen die Nullhypothese.
F-Statistik in ANOVA
In der Varianzanalyse (ANOVA) testet die F-Statistik, ob mehrere Gruppenmittelwerte gleich sind.
Bei einer einfaktoriellen ANOVA besagt die Nullhypothese, dass alle Gruppenmittelwerte gleich sind. Die Alternative besagt, dass sich mindestens ein Gruppenmittelwert unterscheidet.
Der Test vergleicht Variation zwischen Gruppen mit Variation innerhalb der Gruppen. Sind die Unterschiede zwischen den Gruppenmitteln deutlich größer als die Streuung innerhalb der Gruppen, wird der F-Wert groß.
Verwendete Komponenten
ANOVA zerlegt die Gesamtvariation in zwei Teile:
Diese werden durch Teilen durch ihre Freiheitsgrade in mittlere Quadratsummen umgewandelt:
Die F-Statistik ergibt sich dann als Verhältnis dieser beiden mittleren Quadratsummen.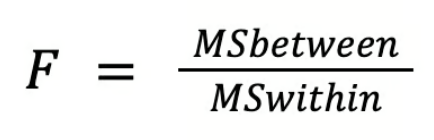
So interpretierst du den F-Wert
Der F-Wert zeigt, wie stark sich Gruppenunterschiede gegenüber zufälliger Streuung abheben. Du kannst ihn so lesen:
Wichtige Annahmen
ANOVA beruht auf einigen Annahmen:
F-Statistik in der Regression
In der Regressionsanalyse testet die F-Statistik, ob das Modell die Daten besser erklärt als ein Modell ohne Prädiktoren.
Das Vergleichsmodell enthält nur einen Achsenabschnitt und sagt den durchschnittlichen Wert der Zielgröße voraus. Das ist der F-Test auf Gesamtsignifikanz. Die Hypothesen lauten:
Die F-Statistik vergleicht die durch das Modell erklärte Variation mit der verbleibenden unerklärten Variation.
Ist die erklärte Variation deutlich größer als die unerklärte, wird der F-Wert groß. Das zeigt, dass das Modell sinnvolle Muster in den Daten erfasst.
Zusammenhang zwischen F-Statistik und R²
Die F-Statistik ist eng mit R² verwandt, das misst, wie viel Variation der Zielgröße vom Modell erklärt wird.
Erklärt das Modell mehr Variation, steigt R². Das erhöht in der Regel auch die F-Statistik, weil die erklärte Variation relativ zur unerklärten größer wird.
Dennoch erfüllen beide Maße unterschiedliche Zwecke:
Interpretation in der multiplen Regression
In der multiplen Regression bewertet der F-Test die Gesamtsignifikanz des Modells. Die Nullhypothese besagt, dass alle Regressionskoeffizienten null sind:
Ist die F-Statistik groß genug, wird die Nullhypothese verworfen. Das bedeutet, dass mindestens ein Prädiktor einen ungleich null Effekt auf die Zielgröße hat.
Der F-Test bewertet das Modell als Ganzes. Anschließend werden einzelne Prädiktoren mit t-Tests geprüft.
So interpretierst du die F-Statistik und den p-Wert
So interpretierst du einen F-Test Schritt für Schritt:
Ist der p-Wert kleiner als das gewählte Signifikanzniveau, gilt das Ergebnis als statistisch signifikant.
Was statistische Signifikanz bedeutet
Ein statistisch signifikanter F-Test zeigt, dass das Modell mehr Variation erklärt, als durch Zufall zu erwarten wäre.
Was statistische Signifikanz nicht bedeutet
Ein signifikantes F-Ergebnis hat Grenzen:
Deshalb berichten Analysten oft zusätzliche Maße, um die Stärke des Effekts einzuordnen.
Effektstärkemaße als Ergänzung zum F-Test
Effektstärken quantifizieren, wie viel Variation das Modell erklärt.
In ANOVA ist ein gängiges Maß:
In der Regression sind gängige Maße:
Annahmen der F-Statistik und wann sie in die Irre führt
Der F-Test funktioniert gut, wenn einige zentrale Annahmen vernünftig erfüllt sind. Werden sie verletzt, kann die F-Statistik irreführende Ergebnisse liefern.
Unabhängigkeit der Beobachtungen
Die Beobachtungen sollten unabhängig voneinander sein — eine Beobachtung darf eine andere nicht beeinflussen.
Wenn zum Beispiel mehrere Messungen von derselben Person oder derselben Versuchseinheit stammen, kann die Unabhängigkeit verletzt sein. Sind Beobachtungen nicht unabhängig, unterschätzt die F-Statistik die Streuung und liefert unzuverlässige Ergebnisse.
Näherungsweise normale Fehler
Viele F-Tests setzen näherungsweise normalverteilte Fehler voraus. Vereinfacht: Die Differenzen zwischen beobachteten Werten und Modellvorhersagen sollten grob normalverteilt sein.
Diese Annahme wird bei größeren Stichproben weniger kritisch. Mit genügend Daten funktioniert der F-Test oft auch dann noch gut, wenn die Verteilung nicht perfekt normal ist.
Gleiche Varianzen
Die klassische ANOVA setzt ähnliche Varianzen über die Gruppen hinweg voraus. Diese Bedingung heißt Varianzhomogenität.
Hat eine Gruppe eine deutlich höhere Streuung als die anderen, kann der F-Test fälschlich Unterschiede der Gruppenmittel erkennen. Das Problem verschärft sich bei stark unterschiedlichen Gruppengrößen.
Wann der F-Test robuster ist
In vielen praktischen Fällen liefert der F-Test dennoch brauchbare Ergebnisse.
ANOVA ist zum Beispiel recht robust, wenn die Gruppengrößen ausgeglichen sind, also jede Gruppe ähnlich viele Beobachtungen enthält. Dann haben moderate Verletzungen von Normalität oder Varianzhomogenität oft nur begrenzten Einfluss.
Probleme nehmen jedoch zu, wenn zwei Bedingungen zusammenkommen, etwa:
Diese Kombination kann die F-Statistik verzerren und das Risiko falscher Schlussfolgerungen erhöhen.
Alternativen bei verletzten Annahmen
Wenn deine Daten die Annahmen des F-Tests nicht erfüllen, gibt es Alternativen, die damit besser umgehen:
Typische Stolpersteine rund um die F-Statistik
Die F-Statistik ist weit verbreitet, dennoch verwirren einige Punkte häufig Einsteiger. Meist geht es um die Beziehung zu anderen Tests.
F-Statistik vs. t-Statistik
F- und t-Statistik sind eng verwandt. In einfachen Fällen prüfen sie dieselbe Idee.
Hat ein Regressionsmodell zum Beispiel nur einen Prädiktor:
Dann führen beide Tests zur gleichen Aussage über statistische Signifikanz.
In komplexeren Modellen erfüllen sie unterschiedliche Rollen. Der t-Test prüft jeweils einen Koeffizienten, der F-Test bewertet mehrere Parameter gemeinsam.
Gesamtsignifikanz vs. Signifikanz einzelner Koeffizienten
Ein weiterer häufiger Knackpunkt ist der Unterschied zwischen Modell- und Variablensignifikanz.
Daher kannst du Ergebnisse sehen wie:
Das passiert, wenn mehrere Variablen gemeinsam die Zielgröße erklären, auch wenn jede für sich nur einen kleinen Effekt hat.
Große F-Werte bei großen Stichproben
Ein großer F-Wert führt oft zu statistischer Signifikanz, doch das heißt nicht automatisch, dass das Ergebnis praktisch relevant ist.
Bei großen Stichproben können selbst kleine Unterschiede signifikante F-Werte erzeugen. Das Modell erklärt dann zwar etwas Variation, der Effekt ist aber unter Umständen in der Praxis gering.
Darum schauen Analysten zusätzlich auf Effektstärken wie R² oder Eta-Quadrat.
Post-hoc-Tests nach ANOVA
In ANOVA beantwortet die F-Statistik eine Frage: Sind alle Gruppenmittelwerte gleich?
Ist das Ergebnis signifikant, zeigt das, dass sich mindestens ein Gruppenmittelwert unterscheidet. Es zeigt jedoch nicht, welche Gruppen differieren.
Um die Unterschiede zu identifizieren, führen Analysten Post-hoc-Tests durch, die Gruppen paarweise vergleichen.
Gängige Beispiele sind:
Diese Tests zeigen exakt, wo die Unterschiede liegen, nachdem der Gesamt-F-Test Signifikanz gezeigt hat.
Abschließende Gedanken
Du weißt jetzt, wie die F-Statistik funktioniert und wie du sie in ANOVA und Regression interpretierst. Setze das jetzt in der Praxis um.
Führe einfache ANOVA- oder Regressionsanalysen durch und lies F-Wert, p-Wert und Effektstärke gemeinsam. So kommst du von der reinen Berechnung zur fundierten Interpretation.
Wenn du dir eine stärkere Statistik-Grundlage aufbauen willst, vertiefe Kernkonzepte wie Varianz, Hypothesentests und Regressionsmodellierung.