A estatística F ajuda você a verificar se as diferenças nos dados são significativas ou apenas variação aleatória. Ela compara a variação explicada por um modelo ou agrupamento com a variação que permanece sem explicação.
Você verá a estatística F em métodos estatísticos comuns como ANOVA e análise de regressão. Em ambos os casos, ela responde a uma pergunta básica: o modelo explica os dados melhor do que o acaso?
Neste guia, vamos mostrar o que a estatística F mede, como é calculada, onde aparece em ANOVA e regressão e como interpretar os resultados corretamente.
O que a estatística F mede
A estatística F mede se a variação explicada por um modelo é maior do que a variação causada por ruído aleatório. Ela compara duas fontes de variância: uma representa o sinal e a outra representa o ruído.
Matematicamente, a estatística F é uma razão de quadrados médios (variâncias):
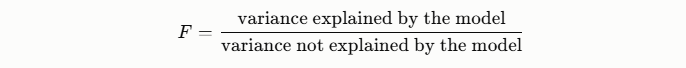
Em muitos testes estatísticos, isso é escrito como
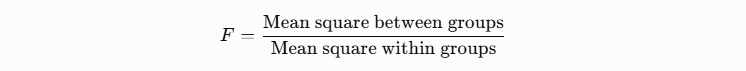
A estatística F compara essas duas quantidades.
- Variância entre grupos: mede quão diferentes são as médias dos grupos entre si. Diferenças grandes sugerem que os grupos se comportam de forma distinta.
- Variância dentro dos grupos: mede o quanto os valores individuais de cada grupo variam em torno da própria média do grupo. Isso representa ruído aleatório ou variabilidade natural dos dados.
Se a variância entre grupos for muito maior, o valor de F se torna alto. Isso sugere que as diferenças entre os grupos são significativas. Se a variância dentro dos grupos dominar, o valor de F fica pequeno, sugerindo que as diferenças observadas provavelmente são aleatórias.
Onde a estatística F é usada
Você pode ver a estatística F nos seguintes métodos estatísticos:
- Análise de variância (ANOVA): ANOVA usa a estatística F para testar se várias médias de grupos são diferentes. Por exemplo, pode testar se três campanhas de marketing geram taxas médias de conversão distintas.
- Significância global da regressão: na regressão linear, a estatística F verifica se o modelo explica uma parcela relevante da variável de desfecho. Em termos simples, testa se os preditores, juntos, melhoram a previsão em comparação com usar apenas a média.
- Comparação de modelos aninhados: a estatística F também pode comparar dois modelos de regressão em que um é uma versão mais simples do outro. Isso ajuda a decidir se incluir variáveis extras melhora o modelo o suficiente para justificar a complexidade adicional.
Como calcular a estatística F
A estatística F é calculada como a razão de dois quadrados médios. Um quadrado médio representa uma estimativa de variância e mostra quanta variação existe em uma parte específica dos dados.
A fórmula genérica é assim: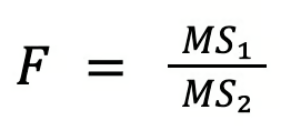
Aqui:
- MS₁ representa a variação explicada por um modelo ou estrutura de agrupamento.
- MS₂ representa a variação que permanece sem explicação.
Se a variação explicada for muito maior que a não explicada, o valor de F aumenta, indicando que o modelo ou agrupamento explica diferenças relevantes.
Embora a interpretação dependa da análise em execução, a estatística F é mais usada em ANOVA e análise de regressão.
Um exemplo numérico simples
Vamos passar por um exemplo simples para deixar mais claro.
Imagine que você está comparando taxas de conversão em três campanhas de marketing. Após calcular as somas de quadrados e dividir pelos graus de liberdade, você obtém:
- Quadrado médio entre grupos (MS_between) = 20
- Quadrado médio dentro dos grupos (MS_within) = 5
Agora calcule a estatística F: F = 20 / 5 = 4
Ou seja, o valor de F é 4.
Isso significa que a variação entre as médias das campanhas é quatro vezes maior do que a variação dentro de cada campanha. Em outras palavras, as diferenças entre as campanhas são relativamente grandes em comparação com a variação aleatória dentro delas.
A estatística F e a distribuição F
A estatística F segue uma distribuição F quando a hipótese nula é verdadeira.
Essa distribuição mostra quão grande o valor de F pode ser apenas por variação aleatória. Usamos isso para verificar se o F observado é excepcionalmente alto.
A razão vem de como a estatística F é construída.
Cada parte da razão F é uma medida de variância. Uma capta a variação explicada pelo modelo ou pelos grupos, e a outra capta a variação aleatória. Quando a hipótese nula é verdadeira, ambas vêm da mesma variância subjacente.
Em termos simples, a estatística F compara duas estimativas independentes da mesma variância. Nesse caso, sua razão segue a distribuição F.
Os dois graus de liberdade na distribuição F
A distribuição F é definida por dois parâmetros de graus de liberdade, que controlam o formato exato da distribuição.
- Graus de liberdade do numerador (df₁): correspondem à estimativa de variância no numerador da estatística F.
- Graus de liberdade do denominador (df₂): correspondem à estimativa de variância no denominador.
Na prática, esses valores dependem do método estatístico utilizado.
Por exemplo:
Em ANOVA:
- df do numerador = número de grupos − 1
- df do denominador = observações totais − número de grupos
Em regressão:
- df do numerador = número de preditores
- df do denominador = tamanho da amostra − preditores − 1
Esses graus de liberdade determinam o quão variáveis são as estimativas de variância. Graus de liberdade menores geram maior variabilidade, alterando o formato da distribuição.
A distribuição F é assimétrica à direita. A maioria dos valores aparece perto de zero, enquanto valores maiores se estendem para a cauda direita. Isso ocorre porque estimativas de variância não podem ser negativas. A razão entre duas estimativas de variância, portanto, produz apenas valores positivos.
Os graus de liberdade afetam o formato exato da distribuição:
- Graus de liberdade menores produzem uma distribuição mais ampla, com cauda direita mais longa.
- Graus de liberdade maiores tornam a distribuição mais concentrada.
Quando a estatística F observada cai bem na cauda direita da distribuição, indica que a variação explicada é muito maior que a não explicada. Isso fornece evidências contra a hipótese nula.
Estatística F em ANOVA
Na análise de variância (ANOVA), a estatística F testa se várias médias de grupos são iguais.
Para uma ANOVA de um fator, a hipótese nula afirma que todas as médias dos grupos são iguais. A alternativa afirma que pelo menos uma média difere.
O teste compara a variação entre grupos com a variação dentro dos grupos. Se as diferenças entre as médias dos grupos forem muito maiores que a variação dentro dos grupos, o valor de F aumenta.
Componentes utilizados
A ANOVA divide a variação total em duas partes:
- SS entre (soma de quadrados entre grupos): mede o quão distante cada média de grupo está da média geral
- SS dentro (soma de quadrados dentro dos grupos): mede o quanto as observações variam em torno da própria média do grupo
Depois, elas são convertidas em quadrados médios dividindo-se pelos respectivos graus de liberdade:
- MS entre estima a variância explicada pelas diferenças entre grupos.
- MS dentro estima a variância remanescente não explicada.
A estatística F é então calculada como a razão entre esses dois quadrados médios.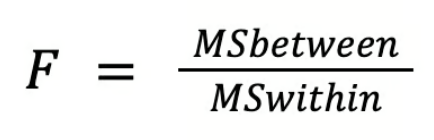
Como interpretar o valor de F
O valor de F mostra quanto as diferenças entre grupos se destacam em relação à variação aleatória. Você pode interpretá-lo assim:
- F pequeno: a variação entre grupos é semelhante à variação dentro dos grupos. As médias provavelmente são iguais.
- F grande: a variação entre grupos é muito maior. Isso sugere que pelo menos uma média de grupo é diferente.
Pressupostos importantes
A ANOVA depende de alguns pressupostos:
- As observações são independentes
- Os dados dentro de cada grupo são aproximadamente normais
- As variâncias entre grupos são semelhantes
Estatística F na regressão
Na análise de regressão, a estatística F testa se o modelo explica os dados melhor do que um modelo sem preditores.
O modelo de comparação inclui apenas um intercepto e prevê o valor médio do desfecho. Isso é conhecido como teste F de significância global. As hipóteses são:
- Hipótese nula (H₀): o modelo sem preditores se ajusta aos dados tão bem quanto o modelo de regressão
- Hipótese alternativa (H₁): o modelo de regressão se ajusta melhor do que o modelo apenas com intercepto
A estatística F compara a variação explicada pelo modelo com a variação que permanece sem explicação.
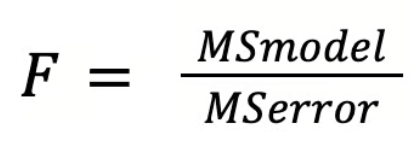
- MS do modelo representa a variância explicada pelos preditores.
- MS do erro representa a variância que permanece sem explicação.
Se a variação explicada for muito maior que a não explicada, o valor de F aumenta. Isso indica que o modelo capta padrões relevantes nos dados.
Relação entre a estatística F e R²
A estatística F é estreitamente relacionada ao R², que mede quanta variação na variável de desfecho é explicada pelo modelo.
À medida que o modelo explica mais variação, o R² aumenta. Isso também tende a elevar a estatística F, porque a variação explicada fica maior em relação à não explicada.
No entanto, as duas medidas têm finalidades diferentes:
- R² mostra quanta variação o modelo explica
- Teste F avalia se essa variação explicada é estatisticamente significativa
Interpretação em regressão múltipla
Em regressão múltipla, o teste F avalia a significância global do modelo. A hipótese nula afirma que todos os coeficientes de regressão são iguais a zero:
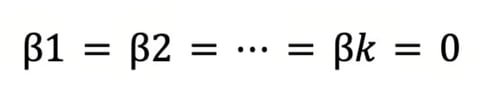
Se a estatística F for grande o suficiente, a hipótese nula é rejeitada. Isso significa que pelo menos um preditor tem efeito diferente de zero sobre a variável de desfecho.
O teste F avalia o modelo como um todo. Depois disso, os preditores individuais são examinados com testes t.
Como interpretar a estatística F e o p-valor
Para interpretar um teste F, siga estes passos:
- Calcule a estatística F: o valor de F é calculado como a razão entre dois quadrados médios. A fórmula exata depende do método usado, como ANOVA ou regressão.
- Consulte a distribuição F: o F calculado é comparado a uma distribuição F definida por dois graus de liberdade:
- Graus de liberdade do numerador (df₁)
- Graus de liberdade do denominador (df₂)
- Calcule o p-valor: o p-valor representa a probabilidade de observar um F pelo menos tão grande quanto o obtido, assumindo que a hipótese nula é verdadeira.
Se o p-valor for menor que o nível de significância escolhido, o resultado é considerado estatisticamente significativo.
O que significa significância estatística
Um teste F estatisticamente significativo mostra que o modelo explica variação além do que o acaso produziria.
- Em ANOVA, isso sugere que pelo menos uma média de grupo é diferente
- Em regressão, isso sugere que o modelo explica o desfecho melhor do que um modelo apenas com intercepto
O que significância estatística não significa
Um resultado F significativo tem limites:
- Não identifica quais grupos diferem em ANOVA. São necessários testes post hoc
- Não indica importância prática. Efeitos pequenos podem ser estatisticamente significativos, especialmente com bases grandes
Por isso, analistas costumam reportar medidas adicionais para entender a força do efeito.
Medidas de tamanho de efeito que complementam o teste F
Estatísticas de tamanho de efeito ajudam a quantificar quanta variação o modelo explica.
Em ANOVA, uma medida comum é:
- Eta quadrado (η²), que estima a proporção da variância explicada pelas diferenças entre grupos.
Em regressão, medidas comuns incluem:
- R², que mede a proporção da variância explicada pelo modelo.
- R² ajustado, que corrige pelo número de variáveis independentes no modelo.
Pressupostos da estatística F e quando ela pode enganar
O teste F funciona bem quando alguns pressupostos-chave são razoavelmente atendidos. Se esses pressupostos forem violados, a estatística F pode produzir resultados enganosos.
Independência das observações
As observações do conjunto de dados devem ser independentes entre si — uma observação não deve influenciar outra.
Por exemplo, se várias medições vêm da mesma pessoa ou da mesma unidade experimental, a independência pode ser violada. Quando as observações não são independentes, a estatística F pode subestimar a variabilidade e gerar resultados pouco confiáveis.
Erros aproximadamente normais
Muitos testes F assumem que os erros são aproximadamente distribuídos normalmente. Em termos simples, as diferenças entre os valores observados e as previsões do modelo devem seguir um padrão aproximadamente normal.
Esse pressuposto se torna menos crítico com amostras maiores. Com dados suficientes, o teste F costuma funcionar razoavelmente bem mesmo se a distribuição não for perfeitamente normal.
Variâncias iguais
A ANOVA clássica assume que as variâncias entre os grupos são semelhantes. Essa condição é chamada de homogeneidade de variâncias.
Se um grupo tiver variabilidade muito maior que os outros, o teste F pode detectar erroneamente diferenças entre as médias dos grupos. O problema fica mais grave quando os tamanhos dos grupos são muito diferentes.
Quando o teste F é mais robusto
Em muitas situações práticas, o teste F ainda apresenta bom desempenho.
Por exemplo, a ANOVA é relativamente robusta quando os tamanhos dos grupos são balanceados, ou seja, cada grupo tem número semelhante de observações. Nesses casos, violações moderadas de normalidade ou de igualdade de variâncias costumam ter impacto limitado.
Entretanto, os problemas aumentam quando duas condições ocorrem juntas, como:
- Diferenças fortes nas variâncias dos grupos
- Tamanhos de grupos desiguais
Essa combinação pode distorcer a estatística F e aumentar o risco de conclusões equivocadas.
Alternativas quando os pressupostos são violados
Se seus dados não atendem aos pressupostos do teste F, você pode usar métodos alternativos que lidam melhor com essas questões:
- ANOVA de Welch: lida com variâncias desiguais entre grupos
- Métodos de regressão robusta: reduzem o impacto de valores extremos ou outliers
- Testes de permutação: estimam a significância embaralhando os dados repetidamente, em vez de depender de distribuições teóricas
Coisas que geram dúvidas sobre a estatística F
A estatística F é muito usada, mas alguns pontos costumam confundir iniciantes — em geral, por sua relação com outros testes estatísticos.
Estatística F vs. estatística t
As estatísticas F e t são intimamente relacionadas. Em casos simples, testam a mesma ideia.
Por exemplo, quando um modelo de regressão tem apenas um preditor:
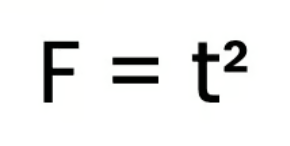
Isso significa que ambos os testes levam à mesma conclusão sobre significância estatística.
Em modelos mais complexos, eles cumprem papéis diferentes. O teste t avalia um coeficiente por vez, enquanto o teste F avalia vários parâmetros em conjunto.
Significância global vs. significância de coeficientes individuais
Outra confusão comum é a diferença entre significância no nível do modelo e no nível das variáveis.
- O teste F avalia o modelo como um todo. Verifica se ele explica o desfecho melhor do que um modelo sem preditores
- O teste t avalia coeficientes individuais. Verifica se um preditor específico tem efeito significativo
Por isso, você pode ver resultados como:
- O teste F global é significativo
- Alguns coeficientes individuais não são significativos
Isso acontece quando várias variáveis, juntas, explicam o desfecho, mesmo que cada uma tenha efeito individual pequeno.
Valores de F altos em amostras grandes
Um valor de F alto costuma levar à significância estatística, mas isso nem sempre significa que o resultado é importante na prática.
Com amostras grandes, até diferenças pequenas podem gerar valores de F significativos. O modelo pode explicar alguma variação, mas o efeito pode ser pequeno em termos reais.
Por isso, analistas também observam medidas de tamanho de efeito, como R² ou eta quadrado.
Testes post hoc após ANOVA
Na ANOVA, a estatística F responde a uma pergunta: todas as médias dos grupos são iguais?
Se o resultado for significativo, mostra que pelo menos uma média de grupo é diferente. Não mostra quais grupos diferem.
Para identificar as diferenças, analistas executam testes post hoc que comparam os grupos par a par.
Exemplos comuns incluem:
- Teste de Tukey: controla as comparações múltiplas
- Ajuste de Bonferroni: torna mais rigorosos os limiares de significância ao rodar muitos testes
Esses testes mostram exatamente onde estão as diferenças depois que o teste F global indica significância.
Considerações finais
Agora você entende como a estatística F funciona e como interpretá-la em ANOVA e regressão. Hora de colocar em prática.
Rode análises simples de ANOVA ou regressão e foque em ler em conjunto o valor de F, o p-valor e o tamanho de efeito. Isso vai ajudar você a sair do cálculo e chegar na interpretação real.
Se você quer construir uma base mais sólida em estatística, aprofunde-se em conceitos centrais como variância, testes de hipótese e modelagem de regressão.






A estatística F ajuda você a verificar se as diferenças nos dados são significativas ou apenas variação aleatória. Ela compara a variação explicada por um modelo ou agrupamento com a variação que permanece sem explicação.
Você verá a estatística F em métodos estatísticos comuns como ANOVA e análise de regressão. Em ambos os casos, ela responde a uma pergunta básica: o modelo explica os dados melhor do que o acaso?
Neste guia, vamos mostrar o que a estatística F mede, como é calculada, onde aparece em ANOVA e regressão e como interpretar os resultados corretamente.
O que a estatística F mede
A estatística F mede se a variação explicada por um modelo é maior do que a variação causada por ruído aleatório. Ela compara duas fontes de variância: uma representa o sinal e a outra representa o ruído.
Matematicamente, a estatística F é uma razão de quadrados médios (variâncias):
Em muitos testes estatísticos, isso é escrito como
A estatística F compara essas duas quantidades.
Se a variância entre grupos for muito maior, o valor de F se torna alto. Isso sugere que as diferenças entre os grupos são significativas. Se a variância dentro dos grupos dominar, o valor de F fica pequeno, sugerindo que as diferenças observadas provavelmente são aleatórias.
Onde a estatística F é usada
Você pode ver a estatística F nos seguintes métodos estatísticos:
Como calcular a estatística F
A estatística F é calculada como a razão de dois quadrados médios. Um quadrado médio representa uma estimativa de variância e mostra quanta variação existe em uma parte específica dos dados.
A fórmula genérica é assim: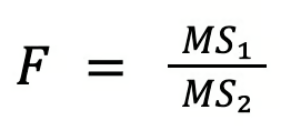
Aqui:
Se a variação explicada for muito maior que a não explicada, o valor de F aumenta, indicando que o modelo ou agrupamento explica diferenças relevantes.
Embora a interpretação dependa da análise em execução, a estatística F é mais usada em ANOVA e análise de regressão.
Um exemplo numérico simples
Vamos passar por um exemplo simples para deixar mais claro.
Imagine que você está comparando taxas de conversão em três campanhas de marketing. Após calcular as somas de quadrados e dividir pelos graus de liberdade, você obtém:
Agora calcule a estatística F: F = 20 / 5 = 4
Ou seja, o valor de F é 4.
Isso significa que a variação entre as médias das campanhas é quatro vezes maior do que a variação dentro de cada campanha. Em outras palavras, as diferenças entre as campanhas são relativamente grandes em comparação com a variação aleatória dentro delas.
A estatística F e a distribuição F
A estatística F segue uma distribuição F quando a hipótese nula é verdadeira.
Essa distribuição mostra quão grande o valor de F pode ser apenas por variação aleatória. Usamos isso para verificar se o F observado é excepcionalmente alto.
A razão vem de como a estatística F é construída.
Cada parte da razão F é uma medida de variância. Uma capta a variação explicada pelo modelo ou pelos grupos, e a outra capta a variação aleatória. Quando a hipótese nula é verdadeira, ambas vêm da mesma variância subjacente.
Em termos simples, a estatística F compara duas estimativas independentes da mesma variância. Nesse caso, sua razão segue a distribuição F.
Os dois graus de liberdade na distribuição F
A distribuição F é definida por dois parâmetros de graus de liberdade, que controlam o formato exato da distribuição.
Na prática, esses valores dependem do método estatístico utilizado.
Por exemplo:
Em ANOVA:
Em regressão:
Esses graus de liberdade determinam o quão variáveis são as estimativas de variância. Graus de liberdade menores geram maior variabilidade, alterando o formato da distribuição.
A distribuição F é assimétrica à direita. A maioria dos valores aparece perto de zero, enquanto valores maiores se estendem para a cauda direita. Isso ocorre porque estimativas de variância não podem ser negativas. A razão entre duas estimativas de variância, portanto, produz apenas valores positivos.
Os graus de liberdade afetam o formato exato da distribuição:
Quando a estatística F observada cai bem na cauda direita da distribuição, indica que a variação explicada é muito maior que a não explicada. Isso fornece evidências contra a hipótese nula.
Estatística F em ANOVA
Na análise de variância (ANOVA), a estatística F testa se várias médias de grupos são iguais.
Para uma ANOVA de um fator, a hipótese nula afirma que todas as médias dos grupos são iguais. A alternativa afirma que pelo menos uma média difere.
O teste compara a variação entre grupos com a variação dentro dos grupos. Se as diferenças entre as médias dos grupos forem muito maiores que a variação dentro dos grupos, o valor de F aumenta.
Componentes utilizados
A ANOVA divide a variação total em duas partes:
Depois, elas são convertidas em quadrados médios dividindo-se pelos respectivos graus de liberdade:
A estatística F é então calculada como a razão entre esses dois quadrados médios.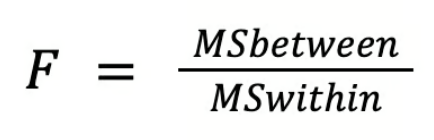
Como interpretar o valor de F
O valor de F mostra quanto as diferenças entre grupos se destacam em relação à variação aleatória. Você pode interpretá-lo assim:
Pressupostos importantes
A ANOVA depende de alguns pressupostos:
Estatística F na regressão
Na análise de regressão, a estatística F testa se o modelo explica os dados melhor do que um modelo sem preditores.
O modelo de comparação inclui apenas um intercepto e prevê o valor médio do desfecho. Isso é conhecido como teste F de significância global. As hipóteses são:
A estatística F compara a variação explicada pelo modelo com a variação que permanece sem explicação.
Se a variação explicada for muito maior que a não explicada, o valor de F aumenta. Isso indica que o modelo capta padrões relevantes nos dados.
Relação entre a estatística F e R²
A estatística F é estreitamente relacionada ao R², que mede quanta variação na variável de desfecho é explicada pelo modelo.
À medida que o modelo explica mais variação, o R² aumenta. Isso também tende a elevar a estatística F, porque a variação explicada fica maior em relação à não explicada.
No entanto, as duas medidas têm finalidades diferentes:
Interpretação em regressão múltipla
Em regressão múltipla, o teste F avalia a significância global do modelo. A hipótese nula afirma que todos os coeficientes de regressão são iguais a zero:
Se a estatística F for grande o suficiente, a hipótese nula é rejeitada. Isso significa que pelo menos um preditor tem efeito diferente de zero sobre a variável de desfecho.
O teste F avalia o modelo como um todo. Depois disso, os preditores individuais são examinados com testes t.
Como interpretar a estatística F e o p-valor
Para interpretar um teste F, siga estes passos:
Se o p-valor for menor que o nível de significância escolhido, o resultado é considerado estatisticamente significativo.
O que significa significância estatística
Um teste F estatisticamente significativo mostra que o modelo explica variação além do que o acaso produziria.
O que significância estatística não significa
Um resultado F significativo tem limites:
Por isso, analistas costumam reportar medidas adicionais para entender a força do efeito.
Medidas de tamanho de efeito que complementam o teste F
Estatísticas de tamanho de efeito ajudam a quantificar quanta variação o modelo explica.
Em ANOVA, uma medida comum é:
Em regressão, medidas comuns incluem:
Pressupostos da estatística F e quando ela pode enganar
O teste F funciona bem quando alguns pressupostos-chave são razoavelmente atendidos. Se esses pressupostos forem violados, a estatística F pode produzir resultados enganosos.
Independência das observações
As observações do conjunto de dados devem ser independentes entre si — uma observação não deve influenciar outra.
Por exemplo, se várias medições vêm da mesma pessoa ou da mesma unidade experimental, a independência pode ser violada. Quando as observações não são independentes, a estatística F pode subestimar a variabilidade e gerar resultados pouco confiáveis.
Erros aproximadamente normais
Muitos testes F assumem que os erros são aproximadamente distribuídos normalmente. Em termos simples, as diferenças entre os valores observados e as previsões do modelo devem seguir um padrão aproximadamente normal.
Esse pressuposto se torna menos crítico com amostras maiores. Com dados suficientes, o teste F costuma funcionar razoavelmente bem mesmo se a distribuição não for perfeitamente normal.
Variâncias iguais
A ANOVA clássica assume que as variâncias entre os grupos são semelhantes. Essa condição é chamada de homogeneidade de variâncias.
Se um grupo tiver variabilidade muito maior que os outros, o teste F pode detectar erroneamente diferenças entre as médias dos grupos. O problema fica mais grave quando os tamanhos dos grupos são muito diferentes.
Quando o teste F é mais robusto
Em muitas situações práticas, o teste F ainda apresenta bom desempenho.
Por exemplo, a ANOVA é relativamente robusta quando os tamanhos dos grupos são balanceados, ou seja, cada grupo tem número semelhante de observações. Nesses casos, violações moderadas de normalidade ou de igualdade de variâncias costumam ter impacto limitado.
Entretanto, os problemas aumentam quando duas condições ocorrem juntas, como:
Essa combinação pode distorcer a estatística F e aumentar o risco de conclusões equivocadas.
Alternativas quando os pressupostos são violados
Se seus dados não atendem aos pressupostos do teste F, você pode usar métodos alternativos que lidam melhor com essas questões:
Coisas que geram dúvidas sobre a estatística F
A estatística F é muito usada, mas alguns pontos costumam confundir iniciantes — em geral, por sua relação com outros testes estatísticos.
Estatística F vs. estatística t
As estatísticas F e t são intimamente relacionadas. Em casos simples, testam a mesma ideia.
Por exemplo, quando um modelo de regressão tem apenas um preditor:
Isso significa que ambos os testes levam à mesma conclusão sobre significância estatística.
Em modelos mais complexos, eles cumprem papéis diferentes. O teste t avalia um coeficiente por vez, enquanto o teste F avalia vários parâmetros em conjunto.
Significância global vs. significância de coeficientes individuais
Outra confusão comum é a diferença entre significância no nível do modelo e no nível das variáveis.
Por isso, você pode ver resultados como:
Isso acontece quando várias variáveis, juntas, explicam o desfecho, mesmo que cada uma tenha efeito individual pequeno.
Valores de F altos em amostras grandes
Um valor de F alto costuma levar à significância estatística, mas isso nem sempre significa que o resultado é importante na prática.
Com amostras grandes, até diferenças pequenas podem gerar valores de F significativos. O modelo pode explicar alguma variação, mas o efeito pode ser pequeno em termos reais.
Por isso, analistas também observam medidas de tamanho de efeito, como R² ou eta quadrado.
Testes post hoc após ANOVA
Na ANOVA, a estatística F responde a uma pergunta: todas as médias dos grupos são iguais?
Se o resultado for significativo, mostra que pelo menos uma média de grupo é diferente. Não mostra quais grupos diferem.
Para identificar as diferenças, analistas executam testes post hoc que comparam os grupos par a par.
Exemplos comuns incluem:
Esses testes mostram exatamente onde estão as diferenças depois que o teste F global indica significância.
Considerações finais
Agora você entende como a estatística F funciona e como interpretá-la em ANOVA e regressão. Hora de colocar em prática.
Rode análises simples de ANOVA ou regressão e foque em ler em conjunto o valor de F, o p-valor e o tamanho de efeito. Isso vai ajudar você a sair do cálculo e chegar na interpretação real.
Se você quer construir uma base mais sólida em estatística, aprofunde-se em conceitos centrais como variância, testes de hipótese e modelagem de regressão.