La estadística F te ayuda a comprobar si las diferencias en los datos son significativas o solo variación aleatoria. Compara la variación explicada por un modelo o por una agrupación con la variación que queda sin explicar.
Verás la F en métodos estadísticos habituales como ANOVA y el análisis de regresión. En ambos casos responde a una pregunta básica: ¿explica el modelo los datos mejor que el azar?
En esta guía veremos qué mide la estadística F, cómo se calcula, dónde aparece en ANOVA y regresión, y cómo interpretar bien los resultados.
Qué mide la estadística F
La estadística F mide si la variación explicada por un modelo es mayor que la variación causada por el ruido aleatorio. Compara dos fuentes de varianza: una representa la señal y la otra el ruido.
Matemáticamente, la F es un cociente de cuadrados medios (varianzas):
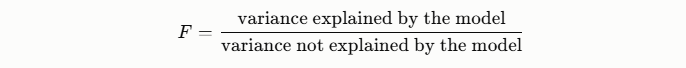
En muchas pruebas estadísticas se escribe así
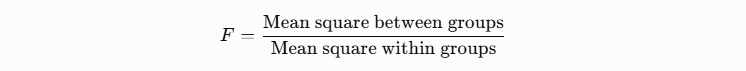
La F compara estas dos cantidades.
- Varianza entre grupos: mide cuánto difieren entre sí las medias de los grupos. Grandes diferencias sugieren que los grupos se comportan de forma distinta.
- Varianza dentro de los grupos: mide cuánto varían los valores individuales de cada grupo alrededor de su propia media. Representa ruido aleatorio o variabilidad natural en los datos.
Si la varianza entre grupos es mucho mayor, el valor F crece. Esto sugiere que las diferencias entre grupos son significativas. Si domina la varianza dentro de los grupos, la F es pequeña, lo que sugiere que las diferencias observadas probablemente sean aleatorias.
Dónde se usa la estadística F
Puedes encontrar la F en los siguientes métodos:
- Análisis de varianza (ANOVA): ANOVA utiliza la F para contrastar si varias medias de grupo son diferentes. Por ejemplo, puede evaluar si tres campañas de marketing producen tasas medias de conversión distintas.
- Significancia global en regresión: en regresión lineal, la F comprueba si el modelo explica una parte relevante de la variable respuesta. En términos simples, contrasta si los predictores, en conjunto, mejoran la predicción frente a usar solo la media.
- Comparación de modelos anidados: la F también puede comparar dos modelos de regresión donde uno es una versión más simple del otro. Ayuda a decidir si añadir variables extra mejora lo suficiente el modelo como para justificar la mayor complejidad.
Cómo calcular la estadística F
La F se calcula como el cociente de dos cuadrados medios. Un cuadrado medio es una estimación de varianza: muestra cuánta variación hay en una parte concreta de los datos.
La fórmula genérica es así: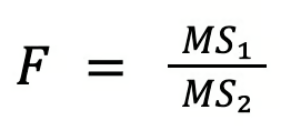
Aquí:
- MS₁ representa la variación explicada por un modelo o por la estructura de grupos.
- MS₂ representa la variación que queda sin explicar.
Si la variación explicada es mucho mayor que la no explicada, el valor F es grande. Eso significa que el modelo o la agrupación explican diferencias relevantes.
Aunque la interpretación depende del análisis que hagas, la F se usa sobre todo en ANOVA y en análisis de regresión.
Un ejemplo numérico sencillo
Veámoslo con un ejemplo simple.
Imagina que comparas tasas de conversión en tres campañas de marketing. Tras calcular las sumas de cuadrados y dividir por los grados de libertad, obtienes:
- Cuadrado medio entre grupos (MS_between) = 20
- Cuadrado medio dentro de grupos (MS_within) = 5
Ahora calcula la F: F = 20 / 5 = 4
Así que el valor F es 4.
Esto significa que la variación entre las medias de campaña es cuatro veces mayor que la variación dentro de cada campaña. En otras palabras, las diferencias entre campañas son relativamente grandes en comparación con la variación aleatoria dentro de ellas.
La estadística F y la distribución F
La estadística F sigue una distribución F cuando la hipótesis nula es cierta.
Esta distribución muestra cuán grande puede ser la F solo por variación aleatoria. La usamos para comprobar si la F observada es inusualmente grande.
La razón está en cómo se construye la F.
Cada parte del cociente F es una medida de varianza. Una captura la variación explicada por el modelo o los grupos y la otra la variación aleatoria. Si la hipótesis nula es cierta, ambas provienen de la misma varianza subyacente.
En resumen, la F compara dos estimaciones independientes de la misma varianza. En ese caso, su cociente sigue la distribución F.
Los dos grados de libertad en la distribución F
La distribución F se define por dos parámetros de grados de libertad, que determinan su forma exacta.
- Grados de libertad del numerador (df₁): corresponden a la estimación de varianza en el numerador de la F.
- Grados de libertad del denominador (df₂): corresponden a la estimación de varianza en el denominador.
En la práctica, estos valores dependen del método estadístico utilizado.
En ANOVA:
- df del numerador = número de grupos − 1
- df del denominador = observaciones totales − número de grupos
En regresión:
- df del numerador = número de predictores
- df del denominador = tamaño de muestra − predictores − 1
Estos grados de libertad determinan cuán variables son las estimaciones de varianza. Grados de libertad más pequeños generan mayor variabilidad y cambian la forma de la distribución.
La distribución F está sesgada a la derecha. La mayoría de los valores aparecen cerca de cero y los más grandes se extienden hacia la cola derecha. Esto ocurre porque las varianzas no pueden ser negativas, y el cociente de dos varianzas solo produce valores positivos.
Los grados de libertad afectan a la forma exacta de la distribución:
- Grados de libertad más pequeños producen una distribución más ancha con una cola derecha más larga.
- Grados de libertad mayores la concentran más.
Cuando la F observada cae muy a la derecha de la distribución, indica que la variación explicada es mucho mayor que la no explicada. Esto aporta evidencia contra la hipótesis nula.
La F en ANOVA
En el análisis de varianza (ANOVA), la F contrasta si varias medias de grupo son iguales.
En un ANOVA de un factor, la hipótesis nula afirma que todas las medias de grupo son iguales; la alternativa, que al menos una difiere.
La prueba compara la variación entre grupos con la variación dentro de los grupos. Si las diferencias entre medias de grupo son mucho mayores que la variación interna, la F aumenta.
Componentes utilizados
ANOVA descompone la variación total en dos partes:
- SS entre (suma de cuadrados entre grupos): mide cuán lejos está cada media de grupo de la media global
- SS dentro (suma de cuadrados dentro de grupos): mide cuánto varían las observaciones alrededor de su media de grupo
Luego se convierten en cuadrados medios dividiendo por sus grados de libertad:
- MS entre estima la varianza explicada por las diferencias entre grupos.
- MS dentro estima la varianza restante sin explicar.
La F se calcula como el cociente de estos dos cuadrados medios.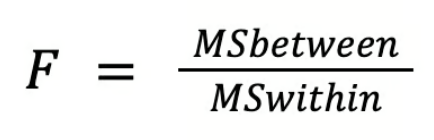
Cómo interpretar el valor F
El valor F muestra cuánto destacan las diferencias entre grupos frente a la variación aleatoria. Puedes interpretarlo así:
- F pequeña: la variación entre grupos es similar a la variación dentro de los grupos. Es probable que las medias sean iguales.
- F grande: la variación entre grupos es mucho mayor, lo que sugiere que al menos una media es distinta.
Supuestos clave
ANOVA se apoya en varios supuestos:
- Las observaciones son independientes
- Los datos dentro de cada grupo siguen aproximadamente una distribución normal
- Las varianzas entre grupos son similares
La F en regresión
En el análisis de regresión, la F contrasta si el modelo explica los datos mejor que un modelo sin predictores.
El modelo de comparación incluye solo un intercepto y predice el valor medio de la respuesta. Es la prueba F de significación global. Las hipótesis son:
- Hipótesis nula (H₀): el modelo sin predictores se ajusta tan bien como el modelo de regresión
- Hipótesis alternativa (H₁): el modelo de regresión se ajusta mejor que el modelo solo con intercepto
La F compara la variación explicada por el modelo con la variación que queda sin explicar.
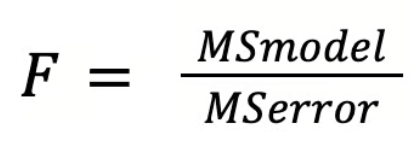
- MS del modelo representa la varianza explicada por los predictores.
- MS del error representa la varianza restante sin explicar.
Si la variación explicada es mucho mayor que la no explicada, la F aumenta. Esto indica que el modelo capta patrones relevantes en los datos.
Relación entre la F y R²
La F está estrechamente relacionada con R², que mide cuánta variación de la respuesta explica el modelo.
A medida que el modelo explica más variación, R² aumenta. Esto también tiende a incrementar la F porque la variación explicada crece en relación con la no explicada.
Sin embargo, sirven a fines distintos:
- R² muestra cuánta variación explica el modelo
- La prueba F evalúa si esa variación explicada es estadísticamente significativa
Interpretación en regresión múltiple
En regresión múltiple, la F evalúa la significación global del modelo. La hipótesis nula afirma que todos los coeficientes de regresión son cero:
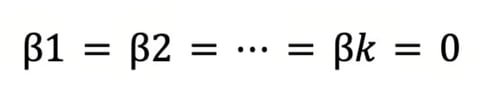
Si la F es lo bastante grande, se rechaza la hipótesis nula. Esto significa que al menos un predictor tiene un efecto distinto de cero sobre la variable respuesta.
La F evalúa el modelo en su conjunto. Después, se analizan los predictores individuales con pruebas t.
Cómo interpretar la F y el valor p
Para interpretar una prueba F, sigue estos pasos:
- Calcula la F: el valor F es el cociente de dos cuadrados medios. La fórmula exacta depende del método (ANOVA o regresión).
- Consulta la distribución F: compara la F calculada con una distribución F definida por dos grados de libertad:
- Grados de libertad del numerador (df₁)
- Grados de libertad del denominador (df₂)
- Calcula el valor p: representa la probabilidad de observar una F al menos tan grande como la obtenida, asumiendo que la hipótesis nula es cierta.
Si el valor p es menor que el nivel de significación elegido, el resultado se considera estadísticamente significativo.
Qué significa la significación estadística
Una F significativa indica que el modelo explica variación más allá de lo que produciría el azar.
- En ANOVA, sugiere que al menos una media de grupo es diferente
- En regresión, sugiere que el modelo explica la respuesta mejor que uno solo con intercepto
Lo que no significa la significación estadística
Un resultado significativo tiene límites:
- No identifica qué grupo(s) difieren en ANOVA. Hacen falta pruebas post hoc
- No indica importancia práctica. Con muestras grandes, efectos pequeños pueden ser significativos
Por eso, a menudo se reportan medidas adicionales para valorar la magnitud del efecto.
Medidas de tamaño del efecto que complementan la F
Las estadísticas de tamaño del efecto cuantifican cuánta variación explica el modelo.
En ANOVA, una medida común es:
- Eta cuadrado (η²), que estima la proporción de varianza explicada por las diferencias entre grupos.
En regresión, son habituales:
- R², que mide la proporción de varianza explicada por el modelo.
- R² ajustado, que corrige por el número de variables independientes.
Supuestos de la F y cuándo puede inducir a error
La prueba F funciona bien cuando se cumplen razonablemente algunos supuestos clave, pero si se violan, puede dar resultados engañosos.
Independencia de las observaciones
Las observaciones deben ser independientes: una no debe influir en otra.
Por ejemplo, si varias mediciones proceden de la misma persona o unidad experimental, se puede violar la independencia. Cuando no hay independencia, la F puede subestimar la variabilidad y producir resultados poco fiables.
Errores aproximadamente normales
Muchas pruebas F asumen que los errores se distribuyen aproximadamente de forma normal. En términos simples, las diferencias entre valores observados y predichos deberían seguir un patrón aproximadamente normal.
Este supuesto es menos crítico con muestras grandes. Con suficientes datos, la F suele funcionar razonablemente bien aunque la distribución no sea perfectamente normal.
Varianzas iguales
El ANOVA clásico asume que las varianzas entre grupos son similares (homogeneidad de varianzas).
Si un grupo tiene una variabilidad mucho mayor que los demás, la F puede detectar diferencias entre medias de forma incorrecta. El problema se agrava cuando los tamaños de grupo son muy distintos.
Cuándo la F es más robusta
En muchas situaciones prácticas, la F sigue funcionando razonablemente bien.
Por ejemplo, ANOVA es bastante robusto cuando los tamaños de grupo están equilibrados (número similar de observaciones por grupo). En estos casos, violaciones moderadas de normalidad o igualdad de varianzas suelen tener un impacto limitado.
Sin embargo, los problemas aumentan cuando coinciden dos condiciones:
- Diferencias fuertes en varianzas entre grupos
- Tamaños de grupo desiguales
Esta combinación puede distorsionar la F y aumentar el riesgo de conclusiones erróneas.
Alternativas cuando se violan los supuestos
Si tus datos no cumplen los supuestos de la F, puedes usar métodos alternativos que los manejan mejor:
- ANOVA de Welch: gestiona varianzas desiguales entre grupos
- Regresión robusta: reduce el impacto de valores extremos o atípicos
- Pruebas de permutación: estiman la significación reordenando los datos repetidamente en lugar de depender de distribuciones teóricas
Aspectos que suelen generar confusión sobre la F
La F es muy usada, pero hay puntos que suelen confundir a quienes empiezan, sobre todo por su relación con otras pruebas.
Estadística F vs. estadística t
La F y la t están estrechamente relacionadas. En casos simples, contrastan la misma idea.
Por ejemplo, cuando un modelo de regresión tiene un solo predictor:
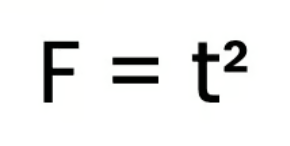
Esto significa que ambas pruebas llevan a la misma conclusión sobre la significación estadística.
En modelos más complejos, cumplen funciones distintas: la t evalúa un coeficiente cada vez; la F evalúa varios parámetros en conjunto.
Significancia global vs. significancia de coeficientes individuales
Otra confusión habitual es la diferencia entre la significación a nivel de modelo y a nivel de variable.
- La prueba F evalúa el modelo completo. Comprueba si explica mejor la respuesta que un modelo sin predictores
- La prueba t evalúa coeficientes individuales: comprueba si un predictor concreto tiene un efecto significativo
Por eso puedes ver resultados como:
- La F global es significativa
- Algunos coeficientes individuales no son significativos
Esto ocurre cuando varias variables explican la respuesta en conjunto, aunque cada una tenga un efecto pequeño por separado.
Valores F grandes en muestras grandes
Un valor F grande suele llevar a significación estadística, pero no siempre implica relevancia práctica.
Con tamaños muestrales grandes, diferencias pequeñas pueden producir F significativas. El modelo puede explicar algo de variación, pero el efecto puede ser reducido en términos reales.
Por eso también se miran medidas de tamaño del efecto como R² o eta cuadrado.
Pruebas post hoc tras ANOVA
En ANOVA, la F responde a una pregunta: ¿son iguales todas las medias de grupo?
Si el resultado es significativo, muestra que al menos una media es diferente, pero no cuáles.
Para identificar las diferencias, se realizan pruebas post hoc que comparan los grupos por pares.
Ejemplos comunes:
- Prueba de Tukey: controla las comparaciones múltiples
- Ajuste de Bonferroni: endurece los umbrales de significación cuando se realizan muchas pruebas
Estas pruebas señalan exactamente dónde están las diferencias cuando la F global resulta significativa.
Reflexión final
Ya sabes cómo funciona la F y cómo interpretarla en ANOVA y regresión. Toca ponerlo en práctica.
Ejecuta ANOVA o regresiones sencillas y fíjate en el valor F, el valor p y el tamaño del efecto en conjunto. Te ayudará a pasar del cálculo a la interpretación real.
Si quieres construir una base sólida de estadística, profundiza en conceptos clave como varianza, contrastes de hipótesis y modelización de regresión.




La estadística F te ayuda a comprobar si las diferencias en los datos son significativas o solo variación aleatoria. Compara la variación explicada por un modelo o por una agrupación con la variación que queda sin explicar.
Verás la F en métodos estadísticos habituales como ANOVA y el análisis de regresión. En ambos casos responde a una pregunta básica: ¿explica el modelo los datos mejor que el azar?
En esta guía veremos qué mide la estadística F, cómo se calcula, dónde aparece en ANOVA y regresión, y cómo interpretar bien los resultados.
Qué mide la estadística F
La estadística F mide si la variación explicada por un modelo es mayor que la variación causada por el ruido aleatorio. Compara dos fuentes de varianza: una representa la señal y la otra el ruido.
Matemáticamente, la F es un cociente de cuadrados medios (varianzas):
En muchas pruebas estadísticas se escribe así
La F compara estas dos cantidades.
Si la varianza entre grupos es mucho mayor, el valor F crece. Esto sugiere que las diferencias entre grupos son significativas. Si domina la varianza dentro de los grupos, la F es pequeña, lo que sugiere que las diferencias observadas probablemente sean aleatorias.
Dónde se usa la estadística F
Puedes encontrar la F en los siguientes métodos:
Cómo calcular la estadística F
La F se calcula como el cociente de dos cuadrados medios. Un cuadrado medio es una estimación de varianza: muestra cuánta variación hay en una parte concreta de los datos.
La fórmula genérica es así: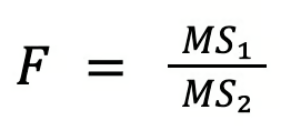
Aquí:
Si la variación explicada es mucho mayor que la no explicada, el valor F es grande. Eso significa que el modelo o la agrupación explican diferencias relevantes.
Aunque la interpretación depende del análisis que hagas, la F se usa sobre todo en ANOVA y en análisis de regresión.
Un ejemplo numérico sencillo
Veámoslo con un ejemplo simple.
Imagina que comparas tasas de conversión en tres campañas de marketing. Tras calcular las sumas de cuadrados y dividir por los grados de libertad, obtienes:
Ahora calcula la F: F = 20 / 5 = 4
Así que el valor F es 4.
Esto significa que la variación entre las medias de campaña es cuatro veces mayor que la variación dentro de cada campaña. En otras palabras, las diferencias entre campañas son relativamente grandes en comparación con la variación aleatoria dentro de ellas.
La estadística F y la distribución F
La estadística F sigue una distribución F cuando la hipótesis nula es cierta.
Esta distribución muestra cuán grande puede ser la F solo por variación aleatoria. La usamos para comprobar si la F observada es inusualmente grande.
La razón está en cómo se construye la F.
Cada parte del cociente F es una medida de varianza. Una captura la variación explicada por el modelo o los grupos y la otra la variación aleatoria. Si la hipótesis nula es cierta, ambas provienen de la misma varianza subyacente.
En resumen, la F compara dos estimaciones independientes de la misma varianza. En ese caso, su cociente sigue la distribución F.
Los dos grados de libertad en la distribución F
La distribución F se define por dos parámetros de grados de libertad, que determinan su forma exacta.
En la práctica, estos valores dependen del método estadístico utilizado.
En ANOVA:
En regresión:
Estos grados de libertad determinan cuán variables son las estimaciones de varianza. Grados de libertad más pequeños generan mayor variabilidad y cambian la forma de la distribución.
La distribución F está sesgada a la derecha. La mayoría de los valores aparecen cerca de cero y los más grandes se extienden hacia la cola derecha. Esto ocurre porque las varianzas no pueden ser negativas, y el cociente de dos varianzas solo produce valores positivos.
Los grados de libertad afectan a la forma exacta de la distribución:
Cuando la F observada cae muy a la derecha de la distribución, indica que la variación explicada es mucho mayor que la no explicada. Esto aporta evidencia contra la hipótesis nula.
La F en ANOVA
En el análisis de varianza (ANOVA), la F contrasta si varias medias de grupo son iguales.
En un ANOVA de un factor, la hipótesis nula afirma que todas las medias de grupo son iguales; la alternativa, que al menos una difiere.
La prueba compara la variación entre grupos con la variación dentro de los grupos. Si las diferencias entre medias de grupo son mucho mayores que la variación interna, la F aumenta.
Componentes utilizados
ANOVA descompone la variación total en dos partes:
Luego se convierten en cuadrados medios dividiendo por sus grados de libertad:
La F se calcula como el cociente de estos dos cuadrados medios.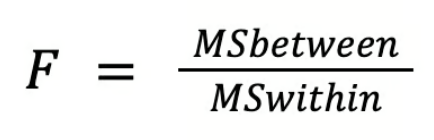
Cómo interpretar el valor F
El valor F muestra cuánto destacan las diferencias entre grupos frente a la variación aleatoria. Puedes interpretarlo así:
Supuestos clave
ANOVA se apoya en varios supuestos:
La F en regresión
En el análisis de regresión, la F contrasta si el modelo explica los datos mejor que un modelo sin predictores.
El modelo de comparación incluye solo un intercepto y predice el valor medio de la respuesta. Es la prueba F de significación global. Las hipótesis son:
La F compara la variación explicada por el modelo con la variación que queda sin explicar.
Si la variación explicada es mucho mayor que la no explicada, la F aumenta. Esto indica que el modelo capta patrones relevantes en los datos.
Relación entre la F y R²
La F está estrechamente relacionada con R², que mide cuánta variación de la respuesta explica el modelo.
A medida que el modelo explica más variación, R² aumenta. Esto también tiende a incrementar la F porque la variación explicada crece en relación con la no explicada.
Sin embargo, sirven a fines distintos:
Interpretación en regresión múltiple
En regresión múltiple, la F evalúa la significación global del modelo. La hipótesis nula afirma que todos los coeficientes de regresión son cero:
Si la F es lo bastante grande, se rechaza la hipótesis nula. Esto significa que al menos un predictor tiene un efecto distinto de cero sobre la variable respuesta.
La F evalúa el modelo en su conjunto. Después, se analizan los predictores individuales con pruebas t.
Cómo interpretar la F y el valor p
Para interpretar una prueba F, sigue estos pasos:
Si el valor p es menor que el nivel de significación elegido, el resultado se considera estadísticamente significativo.
Qué significa la significación estadística
Una F significativa indica que el modelo explica variación más allá de lo que produciría el azar.
Lo que no significa la significación estadística
Un resultado significativo tiene límites:
Por eso, a menudo se reportan medidas adicionales para valorar la magnitud del efecto.
Medidas de tamaño del efecto que complementan la F
Las estadísticas de tamaño del efecto cuantifican cuánta variación explica el modelo.
En ANOVA, una medida común es:
En regresión, son habituales:
Supuestos de la F y cuándo puede inducir a error
La prueba F funciona bien cuando se cumplen razonablemente algunos supuestos clave, pero si se violan, puede dar resultados engañosos.
Independencia de las observaciones
Las observaciones deben ser independientes: una no debe influir en otra.
Por ejemplo, si varias mediciones proceden de la misma persona o unidad experimental, se puede violar la independencia. Cuando no hay independencia, la F puede subestimar la variabilidad y producir resultados poco fiables.
Errores aproximadamente normales
Muchas pruebas F asumen que los errores se distribuyen aproximadamente de forma normal. En términos simples, las diferencias entre valores observados y predichos deberían seguir un patrón aproximadamente normal.
Este supuesto es menos crítico con muestras grandes. Con suficientes datos, la F suele funcionar razonablemente bien aunque la distribución no sea perfectamente normal.
Varianzas iguales
El ANOVA clásico asume que las varianzas entre grupos son similares (homogeneidad de varianzas).
Si un grupo tiene una variabilidad mucho mayor que los demás, la F puede detectar diferencias entre medias de forma incorrecta. El problema se agrava cuando los tamaños de grupo son muy distintos.
Cuándo la F es más robusta
En muchas situaciones prácticas, la F sigue funcionando razonablemente bien.
Por ejemplo, ANOVA es bastante robusto cuando los tamaños de grupo están equilibrados (número similar de observaciones por grupo). En estos casos, violaciones moderadas de normalidad o igualdad de varianzas suelen tener un impacto limitado.
Sin embargo, los problemas aumentan cuando coinciden dos condiciones:
Esta combinación puede distorsionar la F y aumentar el riesgo de conclusiones erróneas.
Alternativas cuando se violan los supuestos
Si tus datos no cumplen los supuestos de la F, puedes usar métodos alternativos que los manejan mejor:
Aspectos que suelen generar confusión sobre la F
La F es muy usada, pero hay puntos que suelen confundir a quienes empiezan, sobre todo por su relación con otras pruebas.
Estadística F vs. estadística t
La F y la t están estrechamente relacionadas. En casos simples, contrastan la misma idea.
Por ejemplo, cuando un modelo de regresión tiene un solo predictor:
Esto significa que ambas pruebas llevan a la misma conclusión sobre la significación estadística.
En modelos más complejos, cumplen funciones distintas: la t evalúa un coeficiente cada vez; la F evalúa varios parámetros en conjunto.
Significancia global vs. significancia de coeficientes individuales
Otra confusión habitual es la diferencia entre la significación a nivel de modelo y a nivel de variable.
Por eso puedes ver resultados como:
Esto ocurre cuando varias variables explican la respuesta en conjunto, aunque cada una tenga un efecto pequeño por separado.
Valores F grandes en muestras grandes
Un valor F grande suele llevar a significación estadística, pero no siempre implica relevancia práctica.
Con tamaños muestrales grandes, diferencias pequeñas pueden producir F significativas. El modelo puede explicar algo de variación, pero el efecto puede ser reducido en términos reales.
Por eso también se miran medidas de tamaño del efecto como R² o eta cuadrado.
Pruebas post hoc tras ANOVA
En ANOVA, la F responde a una pregunta: ¿son iguales todas las medias de grupo?
Si el resultado es significativo, muestra que al menos una media es diferente, pero no cuáles.
Para identificar las diferencias, se realizan pruebas post hoc que comparan los grupos por pares.
Ejemplos comunes:
Estas pruebas señalan exactamente dónde están las diferencias cuando la F global resulta significativa.
Reflexión final
Ya sabes cómo funciona la F y cómo interpretarla en ANOVA y regresión. Toca ponerlo en práctica.
Ejecuta ANOVA o regresiones sencillas y fíjate en el valor F, el valor p y el tamaño del efecto en conjunto. Te ayudará a pasar del cálculo a la interpretación real.
Si quieres construir una base sólida de estadística, profundiza en conceptos clave como varianza, contrastes de hipótesis y modelización de regresión.