
Kursus
Pengantar Statistika
4 jam
161.7K
Statistik F membantu Anda memeriksa apakah perbedaan dalam data bermakna atau hanya variasi acak. Ini membandingkan variasi yang dijelaskan oleh suatu model atau pengelompokan dengan variasi yang tetap tidak terjelaskan.
Anda akan melihat statistik F dalam metode statistik umum seperti ANOVA dan analisis regresi. Pada keduanya, ini menjawab pertanyaan dasar: Apakah model menjelaskan data lebih baik daripada kebetulan?
Dalam panduan ini, kami akan memandu Anda tentang apa yang diukur oleh statistik F, cara menghitungnya, di mana ia muncul dalam ANOVA dan regresi, serta cara menafsirkan hasilnya dengan benar.
Statistik F mengukur apakah variasi yang dijelaskan oleh model lebih besar daripada variasi yang disebabkan oleh kebisingan acak. Ini membandingkan dua sumber varians: satu mewakili sinyal dan yang lain mewakili kebisingan.
Secara matematis, statistik F adalah rasio mean square (varians):
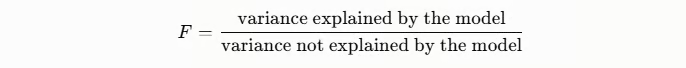
Dalam banyak uji statistik, ini ditulis sebagai
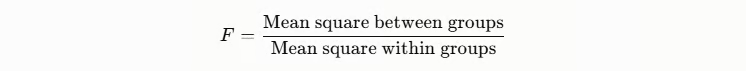
Statistik F membandingkan dua kuantitas ini.
Jika varians antar-kelompok jauh lebih besar, nilai F menjadi besar. Ini menunjukkan bahwa perbedaan antar-kelompok bermakna. Jika varians dalam-kelompok mendominasi, nilai F menjadi kecil. Ini menunjukkan bahwa perbedaan yang diamati kemungkinan bersifat acak.
Anda dapat melihat statistik F dalam metode statistik berikut:
Statistik F dihitung sebagai rasio dua mean square. Mean square mewakili estimasi varians. Ini menunjukkan seberapa besar variasi yang ada pada bagian tertentu dari data.
Rumus umum terlihat seperti ini: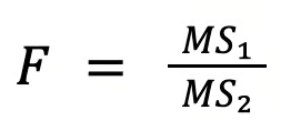
Berikut:
Jika variasi yang dijelaskan jauh lebih besar daripada variasi yang tidak terjelaskan, nilai F menjadi besar. Itu berarti model atau pengelompokan menjelaskan perbedaan yang bermakna.
Meski interpretasinya bergantung pada analisis yang Anda jalankan, statistik F paling sering digunakan dalam ANOVA dan analisis regresi.
Mari kita telusuri contoh sederhana untuk memperjelas.
Bayangkan Anda membandingkan tingkat konversi pada tiga kampanye pemasaran. Setelah menghitung jumlah kuadrat dan membaginya dengan derajat kebebasan, Anda mendapatkan:
Sekarang hitung statistik F: F = 20 / 5 = 4
Jadi, nilai F adalah 4.
Ini berarti variasi antara rata-rata kampanye empat kali lebih besar daripada variasi di dalam setiap kampanye. Dengan kata lain, perbedaan antar kampanye relatif besar dibandingkan variasi acak di dalamnya.
Statistik F mengikuti distribusi F ketika hipotesis nol benar.
Distribusi ini menunjukkan seberapa besar nilai F bisa terjadi hanya dari variasi acak. Kita menggunakannya untuk memeriksa apakah nilai F yang diamati tidak biasa besarnya.
Alasannya berasal dari bagaimana statistik F dibangun.
Setiap bagian dari rasio F adalah ukuran varians. Satu menangkap variasi yang dijelaskan oleh model atau kelompok, dan yang lain menangkap variasi acak. Ketika hipotesis nol benar, keduanya berasal dari varians dasar yang sama.
Sederhananya, statistik F membandingkan dua estimasi independen dari varians yang sama. Ketika demikian, rasionya mengikuti distribusi F.
Distribusi F ditentukan oleh dua parameter derajat kebebasan. Ini mengendalikan bentuk distribusi secara tepat.
Dalam praktiknya, nilai-nilai ini bergantung pada metode statistik yang digunakan.
Sebagai contoh:
Dalam ANOVA:
Dalam regresi:
Derajat kebebasan ini menentukan seberapa variabel estimasi variansnya. Derajat kebebasan yang lebih kecil menghasilkan variabilitas lebih besar, yang mengubah bentuk distribusi.
Distribusi F condong ke kanan. Sebagian besar nilai muncul dekat nol, sementara nilai yang lebih besar meluas ke ekor kanan. Ini terjadi karena estimasi varians tidak bisa negatif. Rasio dua estimasi varians, oleh karena itu, hanya menghasilkan nilai positif.
Derajat kebebasan memengaruhi bentuk distribusi secara tepat:
Ketika statistik F yang diamati jatuh jauh di ekor kanan distribusi, ini menunjukkan bahwa variasi yang dijelaskan jauh lebih besar daripada variasi yang tidak terjelaskan. Ini memberikan bukti melawan hipotesis nol.
Dalam analisis varians (ANOVA), statistik F menguji apakah beberapa mean kelompok adalah sama.
Untuk ANOVA satu arah, hipotesis nol menyatakan bahwa semua mean kelompok sama. Alternatifnya menyatakan bahwa setidaknya satu mean kelompok berbeda.
Uji ini membandingkan variasi antar-kelompok dengan variasi dalam-kelompok. Jika perbedaan antara rata-rata kelompok jauh lebih besar daripada variasi di dalam kelompok, nilai F menjadi besar.
ANOVA membagi total variasi menjadi dua bagian:
Ini kemudian diubah menjadi mean square dengan membaginya dengan derajat kebebasan masing-masing:
Statistik F kemudian dihitung sebagai rasio dari dua mean square ini.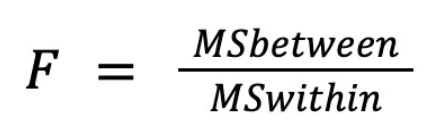
Nilai F menunjukkan seberapa menonjol perbedaan kelompok dibandingkan variasi acak. Anda dapat menafsirkannya sebagai berikut:
ANOVA bergantung pada beberapa asumsi:
Dalam analisis regresi, statistik F menguji apakah model menjelaskan data lebih baik daripada model tanpa prediktor.
Model pembanding hanya menyertakan intersep dan memprediksi nilai rata-rata keluaran. Ini dikenal sebagai uji F atas signifikansi keseluruhan. Hipotesisnya adalah:
Statistik F membandingkan variasi yang dijelaskan oleh model dengan variasi yang tetap tidak terjelaskan.
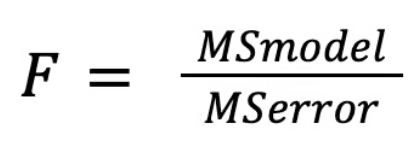
Jika variasi yang dijelaskan jauh lebih besar daripada variasi yang tidak terjelaskan, nilai F menjadi besar. Ini menunjukkan bahwa model menangkap pola yang bermakna dalam data.
Statistik F sangat terkait dengan R², yang mengukur seberapa besar variasi pada variabel keluaran yang dijelaskan oleh model.
Seiring model menjelaskan lebih banyak variasi, R² meningkat. Ini juga cenderung meningkatkan statistik F karena variasi yang dijelaskan menjadi lebih besar relatif terhadap variasi yang tidak terjelaskan.
Namun, kedua ukuran tersebut memiliki tujuan yang berbeda:
Dalam regresi berganda, uji F mengevaluasi signifikansi keseluruhan model. Hipotesis nol menyatakan bahwa semua koefisien regresi sama dengan nol:
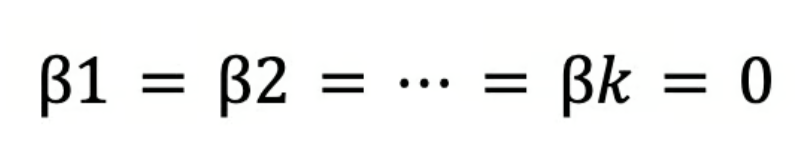
Jika statistik F cukup besar, hipotesis nol ditolak. Ini berarti setidaknya satu prediktor memiliki efek non-nol pada variabel keluaran.
Uji F mengevaluasi model secara keseluruhan. Setelah itu, prediktor individual diperiksa menggunakan uji t.
Untuk menafsirkan uji F, ikuti langkah-langkah berikut:
Jika p-value lebih kecil daripada tingkat signifikansi yang dipilih, hasilnya dianggap signifikan secara statistik.
Uji F yang signifikan secara statistik menunjukkan bahwa model menjelaskan variasi melebihi apa yang akan dihasilkan oleh kebetulan acak.
Hasil F yang signifikan memiliki batasan:
Karena itu, analis sering melaporkan ukuran tambahan untuk memahami kekuatan efek.
Statistik ukuran efek membantu mengukur seberapa besar variasi yang dijelaskan model.
Dalam ANOVA, ukuran yang umum adalah:
Dalam regresi, ukuran yang umum meliputi:
Uji F bekerja dengan baik ketika beberapa asumsi kunci terpenuhi secara wajar. Jika asumsi-asumsi ini dilanggar, statistik F dapat menghasilkan hasil yang menyesatkan.
Observasi dalam dataset harus saling independen — satu observasi tidak boleh memengaruhi yang lain.
Misalnya, jika beberapa pengukuran berasal dari orang yang sama atau unit eksperimen yang sama, independensi mungkin dilanggar. Saat observasi tidak independen, statistik F dapat meremehkan variabilitas dan menghasilkan hasil yang tidak andal.
Banyak uji F mengasumsikan bahwa kesalahan berdistribusi kira-kira normal. Secara sederhana, perbedaan antara nilai yang diamati dan prediksi model harus mengikuti pola yang kira-kira normal.
Asumsi ini menjadi kurang kritis dengan sampel yang lebih besar. Dengan cukup data, uji F sering bekerja cukup baik meskipun distribusinya tidak sempurna normal.
ANOVA klasik mengasumsikan bahwa varians antar kelompok serupa. Kondisi ini disebut homogenitas varians.
Jika satu kelompok memiliki variabilitas jauh lebih tinggi daripada yang lain, uji F mungkin secara keliru mendeteksi perbedaan antara mean kelompok. Masalahnya menjadi lebih parah ketika ukuran kelompok sangat berbeda.
Dalam banyak situasi praktis, uji F masih berkinerja cukup baik.
Sebagai contoh, ANOVA cukup robust ketika ukuran kelompok seimbang, artinya setiap kelompok berisi jumlah observasi yang serupa. Dalam kasus ini, pelanggaran moderat terhadap normalitas atau kesetaraan varians seringkali memiliki dampak terbatas.
Namun, masalah meningkat ketika dua kondisi terjadi bersamaan seperti:
Kombinasi ini dapat mendistorsi statistik F dan meningkatkan risiko kesimpulan yang keliru.
Jika data Anda tidak memenuhi asumsi uji F, Anda dapat menggunakan metode alternatif yang menangani masalah ini secara lebih efektif:
Statistik F banyak digunakan, tetapi beberapa hal sering membingungkan pemula. Sebagian besar berasal dari bagaimana kaitannya dengan uji statistik lain.
Statistik F dan statistik t sangat terkait. Dalam kasus sederhana, keduanya menguji gagasan yang sama.
Sebagai contoh, ketika model regresi hanya memiliki satu prediktor:
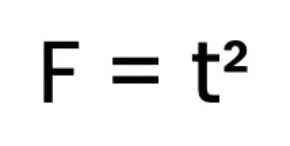
Ini berarti kedua uji menghasilkan kesimpulan yang sama tentang signifikansi statistik.
Dalam model yang lebih kompleks, keduanya memiliki peran berbeda. Uji t mengevaluasi satu koefisien dalam satu waktu, sedangkan uji F mengevaluasi beberapa parameter secara bersamaan.
Poin kebingungan umum lainnya adalah perbedaan antara signifikansi tingkat model dan tingkat variabel.
Karena itu, Anda dapat melihat hasil seperti:
Ini terjadi ketika beberapa variabel secara bersama-sama menjelaskan keluaran, meskipun masing-masing memiliki efek individual yang kecil.
Nilai F yang besar seringkali mengarah pada signifikansi statistik, tetapi itu tidak selalu berarti hasilnya penting dalam praktik.
Dengan ukuran sampel yang besar, bahkan perbedaan kecil dapat menghasilkan nilai F yang signifikan. Model mungkin menjelaskan sebagian variasi, tetapi efeknya mungkin kecil dalam istilah nyata.
Itulah sebabnya analis juga melihat ukuran efek seperti R² atau eta squared.
Dalam ANOVA, statistik F menjawab satu pertanyaan: apakah semua mean kelompok sama?
Jika hasilnya signifikan, ini menunjukkan bahwa setidaknya satu mean kelompok berbeda. Ini tidak menunjukkan kelompok mana yang berbeda.
Untuk mengidentifikasi perbedaannya, analis menjalankan uji post hoc yang membandingkan kelompok secara berpasangan.
Contoh umum meliputi:
Uji-uji ini menunjukkan dengan tepat di mana perbedaan itu ada setelah uji F keseluruhan menunjukkan signifikansi.
Sekarang Anda memahami cara kerja statistik F dan cara menafsirkannya dalam ANOVA dan regresi. Sekarang terapkan ini dalam praktik.
Jalankan analisis ANOVA atau regresi sederhana dan fokus membaca nilai F, p-value, dan ukuran efek secara bersama. Ini akan membantu Anda beralih dari perhitungan ke interpretasi yang nyata.
Jika Anda ingin membangun fondasi statistik yang lebih kuat, dalami konsep inti seperti varians, pengujian hipotesis, dan pemodelan regresi.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



