
Program
AI Temelleri
10 sa
Meta’nın ilk LLaMA sürümünü yayınlamasının ardından, GPT-3.5 (ChatGPT) gibi modellere rakip olabilecek daha iyi Büyük Dil Modelleri (LLM) geliştirme yarışı başladı. Açık kaynak topluluğu hızla giderek daha güçlü modeller yayınladı. Yapay zekâ meraklıları için sık sık duyurulan yeni gelişmelerle adeta Noel sabahı gibiydi.
Ancak bu ilerlemelerin bazı olumsuz tarafları da vardı. Açık kaynaklı modellerin çoğu, sadece araştırma amaçlı kullanıma izin veren kısıtlı lisanslarla geliyor. İkincisi, modelleri eğitmek veya ince ayar yapmak yalnızca büyük bütçeli şirketler veya araştırma enstitüleri için mümkündü. Son olarak, son teknoloji büyük modelleri yayına almak ve sürdürmek pahalıydı.
LLaMA modellerinin yeni sürümü bu sorunları ele almayı hedefliyor. Ticari bir lisansa sahip olması, daha fazla kuruluş için erişilebilir olmasını sağlıyor. Ayrıca, yeni metodolojiler sınırlı belleğe sahip tüketici GPU’larında ince ayar yapmayı mümkün kılıyor.
Yapay zekânın demokratikleşmesi, yaygın benimseme için kritik öneme sahip. Giriş engellerini aşarak, küçük şirketler bile kendi ihtiyaç ve bütçelerine uygun özelleştirilmiş modeller geliştirebilir.
Bu eğitimde Llama-2’yi inceleyecek ve Google Colab kullanarak yeni bir veri kümesi üzerinde nasıl ince ayar yapacağınızı göstereceğiz. Ayrıca, bellek kullanımını azaltmaya ve eğitim sürecini hızlandırmaya yardımcı olabilecek yeni metodolojiler ve ince ayar tekniklerini ele alacağız.
Görsel, yazar tarafından DALL-E 3 ile oluşturulmuştur
transformers, peft, trl, bitsandbytes) kullanarak ücretsiz Google Colab T4 GPU’sunda Llama 2 7B’ye ince ayar yaparLlama 2, Meta’nın ticari lisansla sunulan ikinci nesil açık kaynak LLM koleksiyonudur. 7 milyardan 70 milyar parametreye uzanan ölçeklerdeki modellerle geniş bir doğal dil işleme yelpazesini karşılamak üzere tasarlanmıştır. LLaMA modelleri hakkında daha fazlasını, Meta AI’nin LLaMA’sına Giriş: Yapay Zekâ İnovasyonunu Güçlendirmek yazımızı okuyarak keşfedin.
Diyalog için optimize edilen Llama-2-Chat, ChatGPT ve PaLM gibi popüler kapalı kaynak modellere benzer performans göstermiştir. Modeli yüksek kaliteli bir sohbet veri kümesiyle ince ayar yaparak performansı daha da artırabiliriz.
Makine öğreniminde ince ayar, belirli bir görevde performansı iyileştirmek için önceden eğitilmiş bir modelin ağırlık ve parametrelerini yeni veriler üzerinde ayarlama sürecidir. Bu, eldeki göreve özel yeni bir veri kümesi üzerinde modeli eğitmeyi ve modelin yeni veriye uyum sağlaması için ağırlıklarını güncellemeyi içerir. İnce ayar hakkında daha fazla bilgi için GPT 3.5’i ince ayarlama rehberimizi takip edin.
LLM’lere tüketici donanımında ince ayar yapmak, sınırlı VRAM ve hesaplama gücü nedeniyle zorludur. Ancak bu eğitimde, bu bellek ve hesaplama zorluklarını aşarak modelimizi ücretsiz Google Colab Notebook sürümünde eğiteceğiz.
Bu bölümde, 7 milyar parametreli Llama 2 modeline T4 GPU üzerinde ince ayar yapmak için gereken tüm adımları öğreneceğiz. Google Colab veya Kaggle’da ücretsiz GPU kullanma seçeneğiniz var. Kod her iki platformda da çalışır.
Colab T4 GPU 16 GB ile sınırlı VRAM’e sahiptir. Bu, Llama 2–7b’nin ağırlıklarını saklamak için zar zor yeterlidir; yani tam ince ayar mümkün değildir ve LoRA veya QLoRA gibi parametre-verimli ince ayar tekniklerini kullanmamız gerekir.
Modeli 4-bit hassasiyette ince ayarlamak ve VRAM kullanımını optimize etmek için QLoRA tekniğini kullanacağız. Bunun için Hugging Face LLM kitaplık ekosisteminden yararlanacağız: transformers, accelerate, peft, trl ve bitsandbytes.
Gerekli kütüphaneleri kurarak başlayacağız.
%%capture
%pip install accelerate peft bitsandbytes transformers trl
Ardından bu kütüphanelerden gerekli modülleri yükleyeceğiz.
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import LoraConfig
from trl import SFTTrainerMeta’nın resmi Llama-2 modeline Hugging Face üzerinden erişebilirsiniz, ancak talepte bulunup onay almak için birkaç gün beklemeniz gerekir. Beklemek yerine, temel modelimiz olarak NousResearch’ün Llama-2-7b-chat-hf sürümünü kullanacağız. Orijinaliyle aynıdır fakat daha kolay erişilebilir.
Hugging Face’ten görsel
Temel modelimize daha küçük bir veri kümesi olan mlabonne/guanaco-llama2-1k ile ince ayar yapacağız ve ince ayarlı model için bir ad belirleyeceğiz.
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"

# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"

# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"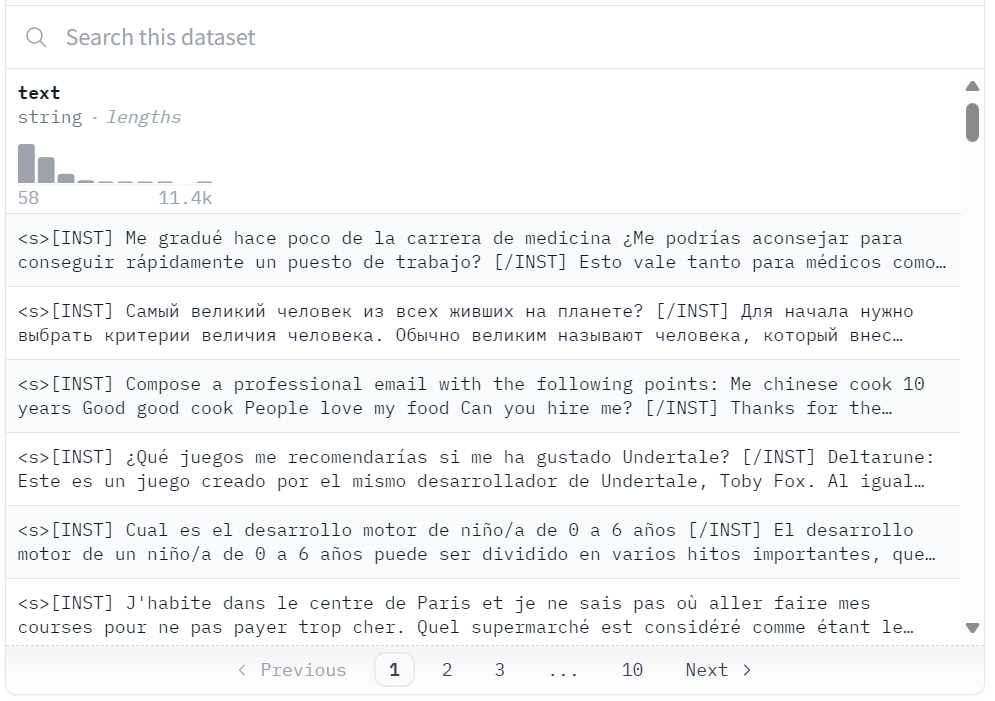
Hugging Face’te veri kümesi
Hugging Face hub’dan “guanaco-llama2-1k” veri kümesini yükleyeceğiz. Veri kümesi 1000 örnek içerir, Llama 2 istem biçimine uyacak şekilde işlenmiştir ve mükemmel timdettmers/openassistant-guanaco veri kümesinin bir alt kümesidir.
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.QLoRA ile 4-bit niceleme, büyük LLM modellerine tüketici donanımında yüksek performansı koruyarak verimli ince ayar yapılmasına olanak tanır. Bu, gerçek dünya uygulamaları için erişilebilirliği ve kullanılabilirliği büyük ölçüde artırır.
QLoRA, önceden eğitilmiş bir dil modelini 4 bite niceleyip parametreleri dondurur. Ardından modele az sayıda eğitilebilir Düşük Rütbeli Adaptör katmanı eklenir.
İnce ayar sırasında, gradyanlar dondurulmuş 4-bit nicelemeli modelden yalnızca Düşük Rütbeli Adaptör katmanlarına geri yayılır. Böylece tüm önceden eğitilmiş model 4 bitte sabit kalırken yalnızca adaptörler güncellenir. Ayrıca 4-bit niceleme, model performansını olumsuz etkilemez.
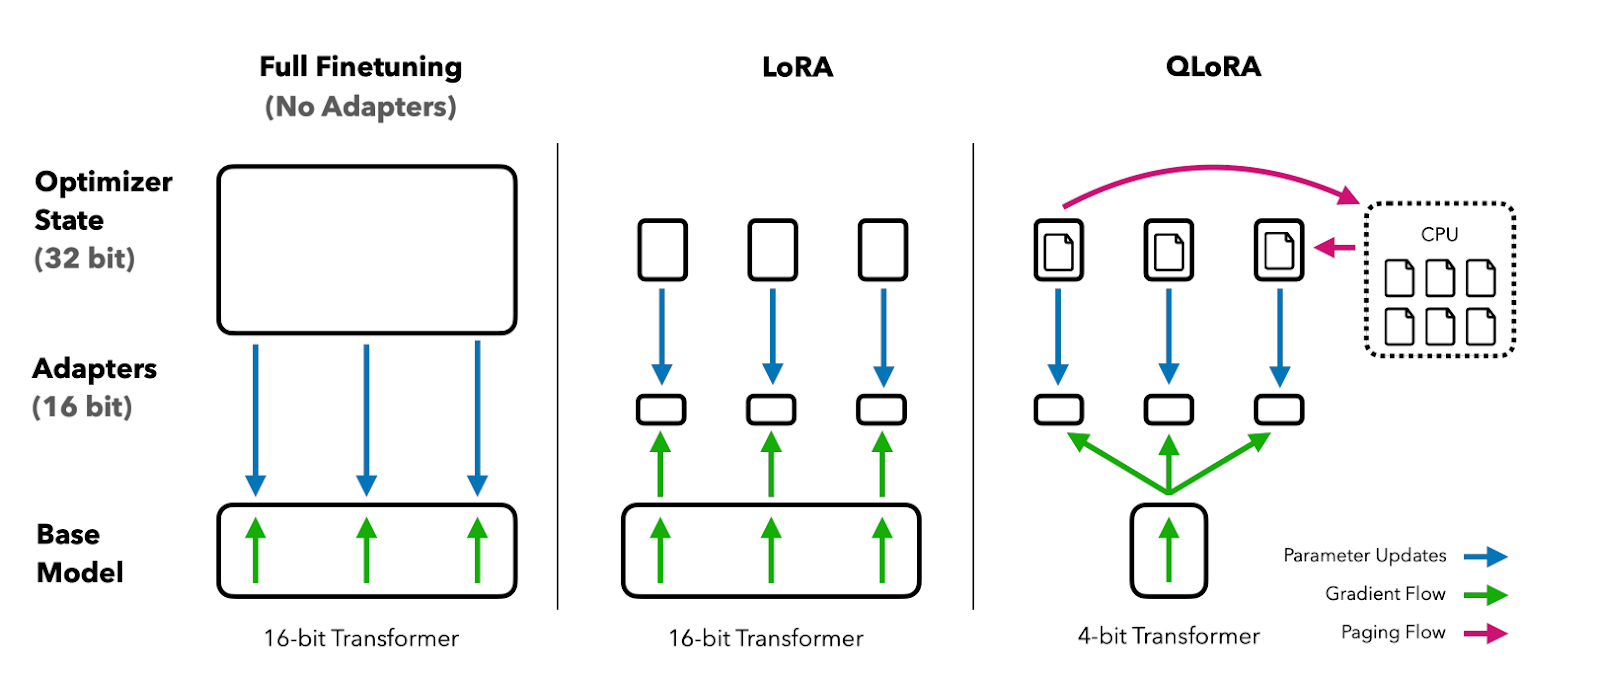
QLoRA makalesinden görsel
Daha iyi anlamak için makaleyi okuyabilirsiniz.
| Özellik | Tam İnce Ayar | LoRA | QLoRA |
|---|---|---|---|
| Güncellenen parametreler | Tüm model parametreleri | Küçük adaptör matrisleri (~%0,1–1) | Küçük adaptör matrisleri (~%0,1–1) |
| Temel model hassasiyeti | FP16 / BF16 | FP16 / BF16 | 4-bit (NF4) |
| 7B model için VRAM | ~60+ GB | ~16 GB | ~6–8 GB |
| Tüketici GPU uyumu | Hayır | Sınırlı | Evet (T4, RTX 3060+) |
| Kalite (tam ince ayara kıyasla) | Temel seviye | ~%98–99 | ~%96–98 |
| Eğitim hızı | En yavaş | Hızlı | Hızlı |
Bizim durumda, BitsAndBytes kullanarak NF4 tip yapılandırmasıyla 4-bit niceleme oluşturuyoruz.
compute_dtype = getattr(torch, "float16")

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)Şimdi Hugging Face’ten daha hızlı eğitim için "float16" hesaplama türüyle 4-bit hassasiyette bir model yükleyeceğiz.
model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=quant_config,
    device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 1Sonraki adımda, belirteçleyiciyi Hugging Face’ten yükleyip fp16 ile ilgili sorunu gidermek için padding_side’ı “right” olarak ayarlayacağız.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Geleneksel şekilde önceden eğitilmiş dil modellerine (PLM) ince ayar yapmak, modelin tüm parametrelerinin güncellenmesini gerektirir; bu da hesaplama açısından maliyetli olup çok fazla veri gerektirir.
Parametre-Verimli İnce Ayar (PEFT), modelin en etkili parametrelerinin yalnızca küçük bir alt kümesini güncelleyerek çalışır ve bunu çok daha verimli kılar. Parametreler hakkında bilgi edinmek için PEFT’in resmi dokümantasyonunu okuyun.
peft_params = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
)Aşağıda, eğitim sürecini optimize etmek için kullanılabilecek hiperparametrelerin bir listesi bulunmaktadır:
training_params = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="tensorboard"
)Denetimli ince ayar (SFT), insan geribildiriminden pekiştirmeli öğrenme (RLHF) sürecinde kilit bir adımdır. HuggingFace’in TRL kütüphanesi, yalnızca birkaç satır kodla SFT modelleri oluşturup kendi veri kümeniz üzerinde eğitmek için kullanımı kolay bir API sunar. Denetimli ince ayardan başlayarak ödül modelleme ve son olarak yakınsak politika optimizasyonu (PPO) ile dil modellerini pekiştirmeli öğrenmeyle eğitmeye yönelik araçlarla birlikte gelir.
SFT Trainer’a modeli, veri kümesini, Lora yapılandırmasını, belirteçleyiciyi ve eğitim parametrelerini sağlayacağız.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_params,
    dataset_text_field="text",
    max_seq_length=None,
    tokenizer=tokenizer,
    args=training_params,
    packing=False,
)
Llama 2 modeline yeni bir veri kümesi üzerinde ince ayar yapmak için .train() kullanacağız. Modelin 1 dönemi tamamlaması bir buçuk saat sürdü.
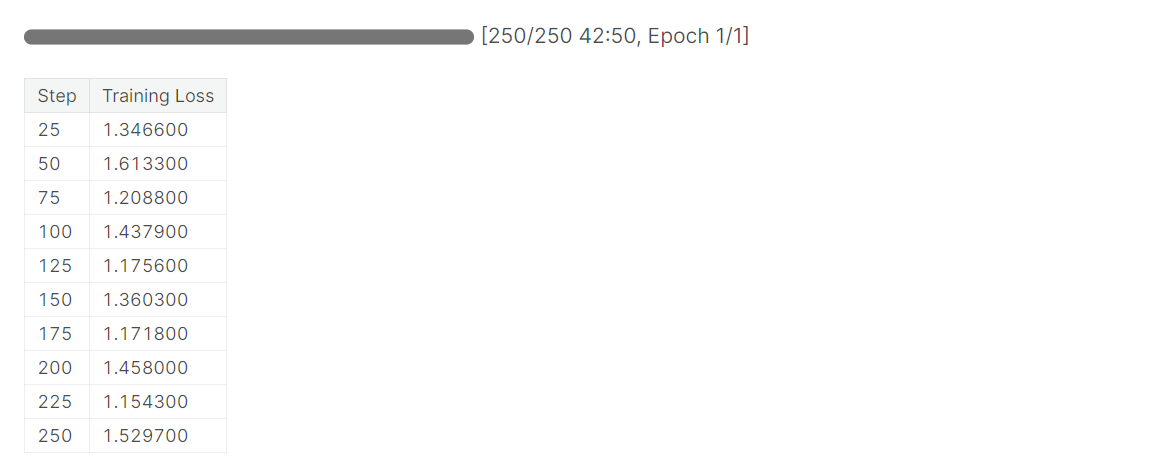
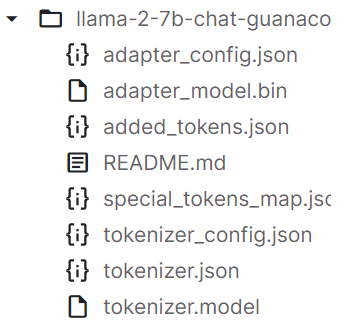
Modeli eğittikten sonra model adaptörünü ve belirteçleyiciyi kaydedeceğiz. Benzer bir API kullanarak modeli Hugging Face’e de yükleyebilirsiniz.
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
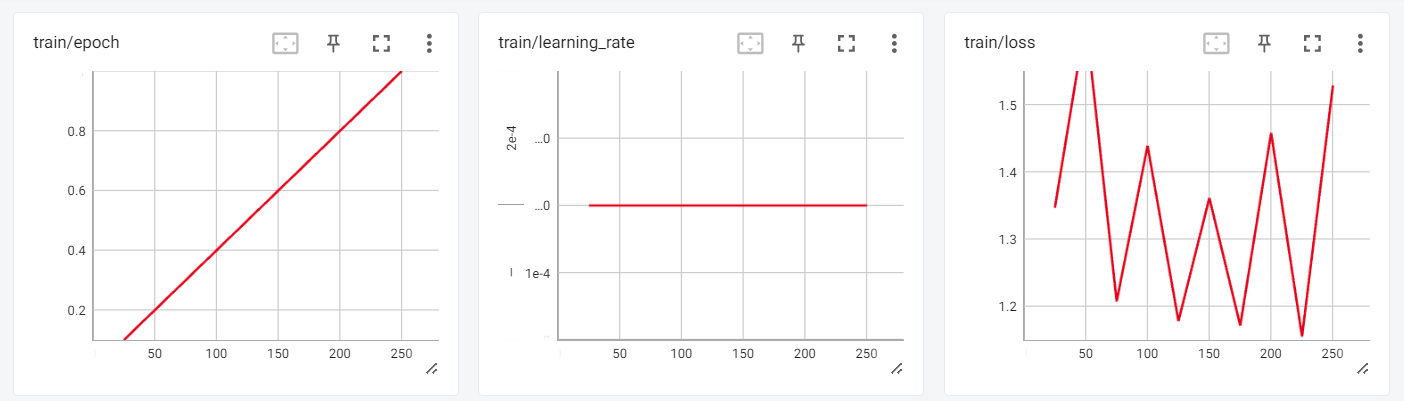
Artık Tensorboard’un etkileşimli oturumunda eğitim sonuçlarını inceleyebiliriz.
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
İnce ayarlı modelimizi test etmek için transformers metin üretim hattını kullanacak ve “Leonardo Da Vinci kimdir?” gibi basit sorular soracağız.
logging.set_verbosity(logging.CRITICAL)

prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Çıktı:
Model tutarlı ve ayrıntılı bir yanıt üretir.
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.

Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.

Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.

Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
Bir başka soru daha soralım.
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Çıktı:
Guanaco, geçmişte son teknoloji LLM’lerin ince ayarında kullanılan, yüksek kaliteli bir veri kümesidir. Tüm Guanaco veri kümesi Hugging Face’te mevcuttur ve çeşitli doğal dil görevlerinde daha da yüksek performans elde etme potansiyeline sahiptir.
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.

The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.

In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.

The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.

Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in
Colab Defteri kod ve çıktıların bulunduğu haliyle kodlama yolculuğunuzda size yardımcı olacaktır.
Sonrasında, LlamaIndex: Kişisel Verileri LLM’lere Ekleme eğitimini takip ederek LlamaIndex’i kullanabilir ve yeni eğitilmiş modelinizle kendi yapay zekâ uygulamanızı geliştirebilirsiniz. Projeniz için ilham almak üzere Üretken Modeller ve Açık Kaynak Araçlarla Oluşturabileceğiniz 5 Proje yazısına göz atın.
Llama 2’nin Temmuz 2023’teki çıkışından bu yana, Meta önemli iyileştirmelerle birkaç yeni model yayınladı. Llama 3 (Nisan 2024), tüm model boyutlarında daha büyük bir 128K-token sözlük ve grouped query attention (GQA) getirdi. Llama 3.1 (Temmuz 2024), bağlam uzunluğunu 128K tokene çıkardı ve 405B parametreli bir varyant ekledi. Llama 3.2 (Eylül 2024) ise çok kipli yetenekler ve uç cihazlar için optimize edilmiş hafif 1B/3B modeller sundu.
İnce ayar ekosistemi de önemli ölçüde evrildi. Unsloth gibi araçlar, standart Hugging Face PEFT’e kıyasla 2 kat daha hızlı eğitim ve %60 daha az bellek kullanımı sunuyor; LLaMA-Factory gibi GUI tabanlı araçlar ise kod yazmadan ince ayarı erişilebilir kılıyor. Bu eğitimde ele alınan temel QLoRA ve PEFT kavramları hâlâ temel niteliğindedir — en yeni yaklaşımlar için Llama 3.1’i ince ayarlama ve Llama 3.2’yi ince ayarlama eğitimlerimize göz atmanızı öneririz.
Bu eğitimde, bellek ve hesaplama kısıtlarını aşmak için QLoRA, PEFT ve SFT gibi teknikleri kullanarak LLaMA 2 modeline nasıl ince ayar yapılacağını ele aldık. transformers, accelerate, peft, trl ve bitsandbytes gibi Hugging Face kütüphanelerinden yararlanarak, 7B parametreli LLaMA 2 modeline bir tüketici GPU’sunda başarıyla ince ayar yapabildik.
Genel olarak bu eğitim, yakın dönemdeki ilerlemelerin büyük dil modellerinin demokratikleşmesini ve erişilebilirliğini nasıl mümkün kıldığını; sınırlı kaynaklarla bile meraklıların son teknoloji yapay zekâ geliştirebileceğini göstermektedir.
Öğrenmeye devam etmek için, daha yeni modellerle uygulamalı pratik sunan Llama 3 ile İnce Ayar kursunu alın veya bu eğitimde kullanılan ekosistemi derinlemesine anlamak için Hugging Face ile Çalışmak kursuna göz atın. Temel bilgi için Python’da LLM’lere Giriş veya Büyük Dil Modelleri (LLM) Kavramları kurslarıyla başlayın ve Yapay Zekâ Temelleri yetkinlik yolunu keşfedin.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




