
लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
Meta द्वारा LLaMA के पहले संस्करण के लॉन्च के बाद, ऐसे बेहतर बड़े भाषा मॉडल (LLMs) बनाने की नई होड़ शुरू हो गई जो GPT-3.5 (ChatGPT) जैसे मॉडलों टक्कर दे सकें। ओपन-सोर्स समुदाय ने तेजी से अधिक सक्षम मॉडल जारी किए। AI उत्साही लोगों के लिए यह जैसे क्रिसमस जैसा समय था, क्योंकि नए विकास अक्सर घोषित हो रहे थे।
हालाँकि, इन प्रगतियों के साथ कुछ कमियाँ भी रहीं। अधिकांश ओपन-सोर्स मॉडलों के लाइसेंस प्रतिबंधित होते हैं, यानी वे केवल शोध उद्देश्यों के लिए इस्तेमाल किए जा सकते हैं। दूसरा, केवल बड़ी कंपनियाँ या पर्याप्त बजट वाले शोध संस्थान ही मॉडलों को फाइन-ट्यून या ट्रेन करने का खर्च उठा सकते थे। अंततः, अत्याधुनिक बड़े मॉडलों को डिप्लॉय और मेंटेन करना महंगा था।
LLaMA मॉडलों का नया संस्करण इन मुद्दों को संबोधित करने का प्रयास करता है। इसमें वाणिज्यिक लाइसेंस है, जिससे यह अधिक संगठनों के लिए सुलभ हो जाता है। साथ ही, नई पद्धतियाँ अब सीमित मेमोरी वाले कंज़्यूमर GPU पर भी फाइन-ट्यूनिंग संभव बनाती हैं।
AI का यह लोकतंत्रीकरण व्यापक अपनाने के लिए महत्वपूर्ण है। प्रवेश बाधाओं को कम करके, छोटी कंपनियाँ भी अपनी आवश्यकताओं और बजट के अनुरूप कस्टम मॉडल बना सकती हैं।
इस ट्यूटोरियल में, हम Llama-2 का अन्वेषण करेंगे और दिखाएँगे कि Google Colab का उपयोग करके इसे एक नए डेटासेट पर कैसे फाइन-ट्यून किया जाए। इसके अतिरिक्त, हम ऐसी नई पद्धतियों और फाइन-ट्यूनिंग तकनीकों को कवर करेंगे जो मेमोरी उपयोग को कम करने और प्रशिक्षण प्रक्रिया को तेज करने में मदद करती हैं।
चित्र DALL-E 3 का उपयोग करके लेखक द्वारा जनित
transformers, peft, trl, bitsandbytes) का उपयोग करते हुए, Google Colab के मुफ्त T4 GPU पर Llama 2 7B को फाइन-ट्यून करता हैLlama 2, Meta के दूसरी पीढ़ी के ओपन-सोर्स LLMs का संग्रह है जो वाणिज्यिक लाइसेंस के साथ आता है। यह 7 बिलियन से 70 बिलियन पैरामीटर्स तक के स्केल वाले मॉडलों के साथ, विभिन्न प्राकृतिक भाषा संसाधन कार्यों को संभालने के लिए डिज़ाइन किया गया है। LLaMA मॉडलों के बारे में और जानने के लिए हमारा लेख Introduction to Meta AI's LLaMA: Empowering AI Innovation पढ़ें।
संवाद के लिए अनुकूलित Llama-2-Chat ने ChatGPT और PaLM जैसे लोकप्रिय क्लोज़्ड-सोर्स मॉडलों के समान प्रदर्शन दिखाया है। हम उच्च-गुणवत्ता वाले वार्तालापीय डेटासेट पर इसे फाइन-ट्यून करके मॉडल के प्रदर्शन को और बेहतर कर सकते हैं।
मशीन लर्निंग में फाइन-ट्यूनिंग वह प्रक्रिया है जिसमें किसी प्री-ट्रेंड मॉडल के वेट्स और पैरामीटर्स को नए डेटा पर समायोजित किया जाता है ताकि किसी विशिष्ट कार्य पर उसका प्रदर्शन बेहतर हो। इसमें संबंधित कार्य-विशिष्ट नए डेटासेट पर मॉडल को प्रशिक्षित करना शामिल है, और नए डेटा के अनुरूप वेट्स को अपडेट किया जाता है। फाइन-ट्यूनिंग के बारे में अधिक पढ़ने के लिए हमारा GPT 3.5 को फाइन-ट्यून करने का गाइड देखें।
कंज़्यूमर हार्डवेयर पर LLMs को फाइन-ट्यून करना सीमित VRAM और कंप्यूटिंग पावर के कारण चुनौतीपूर्ण है। हालाँकि, इस ट्यूटोरियल में, हम इन मेमोरी और कंप्यूटिंग चुनौतियों को पार करेंगे और Google Colab Notebook के नि:शुल्क संस्करण का उपयोग करके अपना मॉडल ट्रेन करेंगे।
इस भाग में, हम T4 GPU पर 7 अरब पैरामीटर वाले Llama 2 मॉडल को फाइन-ट्यून करने के लिए आवश्यक सभी चरणों के बारे में सीखेंगे। आपके पास Google Colab या Kaggle पर निःशुल्क GPU उपयोग करने का विकल्प है। कोड दोनों प्लेटफ़ॉर्म पर चलता है।
Colab का T4 GPU सीमित 16 GB VRAM के साथ आता है। यह Llama 2–7b के वेट्स स्टोर करने के लिए बस पर्याप्त है, जिसका अर्थ है कि पूर्ण फाइन-ट्यूनिंग संभव नहीं है, और हमें LoRA या QLoRA जैसी पैरामीटर-प्रभावी फाइन-ट्यूनिंग तकनीकों का उपयोग करना होगा।
हम QLoRA तकनीक का उपयोग करके मॉडल को 4-बिट प्रिसीजन में फाइन-ट्यून करेंगे और VRAM उपयोग को अनुकूलित करेंगे। इसके लिए हम Hugging Face के LLM लाइब्रेरी इकोसिस्टम का उपयोग करेंगे: transformers, accelerate, peft, trl, और bitsandbytes।
हम आवश्यक लाइब्रेरीज़ इंस्टॉल करके शुरू करेंगे।
%%capture
%pip install accelerate peft bitsandbytes transformers trl
इसके बाद, हम इन लाइब्रेरीज़ से आवश्यक मॉड्यूल लोड करेंगे।
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import LoraConfig
from trl import SFTTrainerआप Hugging Face से Meta का आधिकारिक Llama-2 मॉडल एक्सेस कर सकते हैं, लेकिन इसके लिए अनुरोध करना होता है और पुष्टि में कुछ दिन लग सकते हैं। प्रतीक्षा करने के बजाय, हम NousResearch का Llama-2-7b-chat-hf अपने बेस मॉडल के रूप में उपयोग करेंगे। यह मूल जैसा ही है लेकिन आसानी से उपलब्ध है।
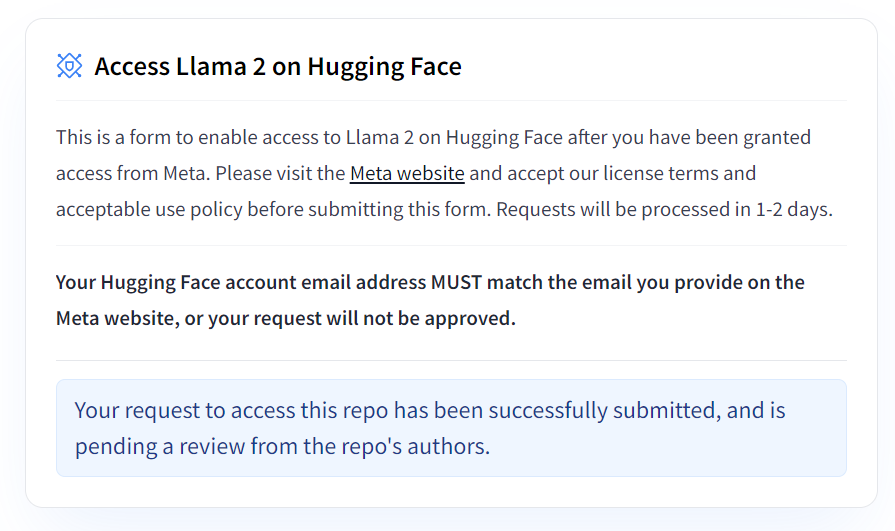
Hugging Face से छवि
हम एक छोटे डेटासेट mlabonne/guanaco-llama2-1k का उपयोग करके अपने बेस मॉडल को फाइन-ट्यून करेंगे और फाइन-ट्यून किए गए मॉडल का नाम लिखेंगे।
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"

# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"

# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"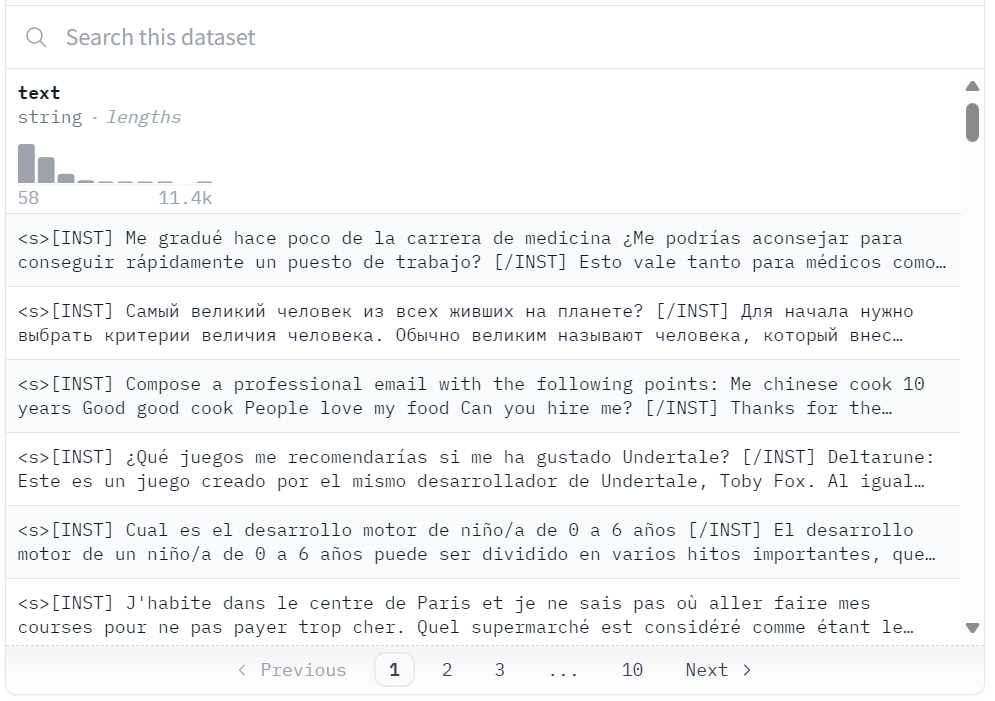
Hugging Face पर डेटासेट
हम Hugging Face हब से “guanaco-llama2-1k” डेटासेट लोड करेंगे। इस डेटासेट में 1000 नमूने हैं और इसे Llama 2 के प्रॉम्प्ट फ़ॉर्मेट से मिलाने के लिए प्रोसेस किया गया है। यह उत्कृष्ट timdettmers/openassistant-guanaco डेटासेट का एक सबसेट है।
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.QLoRA के माध्यम से 4-बिट क्वांटाइज़ेशन उपभोक्ता हार्डवेयर पर बड़े LLM मॉडलों का कुशल फाइन-ट्यूनिंग संभव बनाता है, जबकि उच्च प्रदर्शन बनाए रखता है। यह वास्तविक दुनिया के अनुप्रयोगों के लिए पहुंच और उपयोगिता को नाटकीय रूप से बढ़ाता है।
QLoRA एक प्री-ट्रेन्ड भाषा मॉडल को 4 बिट में क्वांटाइज़ करता है और पैरामीटर फ़्रीज़ कर देता है। इसके बाद मॉडल में कम संख्या में ट्रेन होने योग्य लो-रैंक एडेप्टर लेयर जोड़ी जाती हैं।
फाइन-ट्यूनिंग के दौरान, ग्रेडिएंट्स जमे हुए 4-बिट क्वांटाइज़्ड मॉडल से केवल लो-रैंक एडेप्टर लेयर तक बैकप्रोपेगेट होते हैं। इस प्रकार, पूरा प्रीट्रेन्ड मॉडल 4 बिट पर स्थिर रहता है और केवल एडेप्टर अपडेट होते हैं। साथ ही, 4-बिट क्वांटाइज़ेशन से मॉडल के प्रदर्शन पर असर नहीं पड़ता।
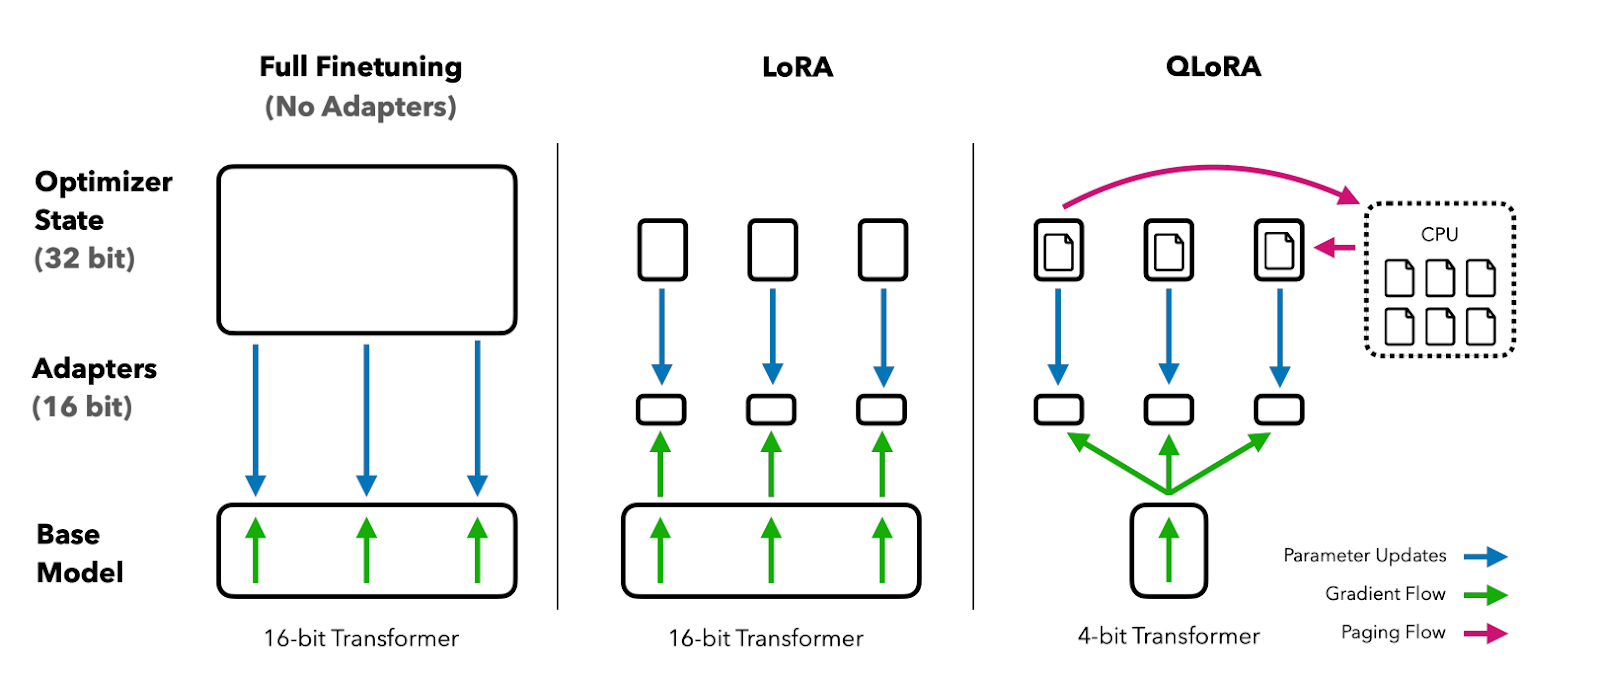
QLoRA पेपर से छवि
इसे बेहतर समझने के लिए आप पेपर पढ़ सकते हैं।
| विशेषता | पूर्ण फाइन-ट्यूनिंग | LoRA | QLoRA |
|---|---|---|---|
| अपडेट किए गए पैरामीटर | मॉडल के सभी पैरामीटर | छोटी एडेप्टर मैट्रिसेज़ (~0.1-1%) | छोटी एडेप्टर मैट्रिसेज़ (~0.1-1%) |
| बेस मॉडल प्रिसीजन | FP16 / BF16 | FP16 / BF16 | 4-बिट (NF4) |
| 7B मॉडल के लिए VRAM | ~60+ GB | ~16 GB | ~6-8 GB |
| कंज्यूमर GPU संगत | नहीं | सीमित | हाँ (T4, RTX 3060+) |
| पूर्ण फाइन-ट्यूनिंग के सापेक्ष गुणवत्ता | बेसलाइन | ~98-99% | ~96-98% |
| प्रशिक्षण गति | सबसे धीमी | तेज़ | तेज़ |
हमारे मामले में, हम BitsAndBytes का उपयोग करते हुए NF4 प्रकार की कॉन्फ़िगरेशन के साथ 4-बिट क्वांटाइज़ेशन बनाएंगे।
compute_dtype = getattr(torch, "float16")

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)अब हम Hugging Face से "float16" compute dtype के साथ 4-बिट प्रिसीजन में मॉडल लोड करेंगे ताकि प्रशिक्षण तेज़ हो।
model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=quant_config,
    device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 1अगला, हम Hugging Face से टोकनाइज़र लोड करेंगे और fp16 से जुड़ी समस्या को ठीक करने के लिए padding_side को “right” पर सेट करेंगे।
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"प्री-ट्रेन्ड भाषा मॉडलों (PLMs) का पारंपरिक फाइन-ट्यूनिंग मॉडल के सभी पैरामीटर अपडेट करने की मांग करता है, जो संगणना की दृष्टि से महंगा है और बहुत अधिक डेटा की आवश्यकता होती है।
Parameter-Efficient Fine-Tuning (PEFT) केवल मॉडल के सबसे प्रभावशाली पैरामीटर्स के एक छोटे उपसमुच्चय को अपडेट करके काम करता है, जिससे यह कहीं अधिक कुशल बनता है। पैरामीटर्स के बारे में जानने के लिए PEFT का आधिकारिक डॉक्यूमेंटेशन पढ़ें।
peft_params = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
)नीचे हाइपरपैरामीटर्स की सूची दी गई है जिनका उपयोग प्रशिक्षण प्रक्रिया को अनुकूलित करने के लिए किया जा सकता है:
training_params = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="tensorboard"
)सुपरवाइज़्ड फाइन-ट्यूनिंग (SFT) मानव फीडबैक से रिइनफोर्समेंट लर्निंग (RLHF) में एक प्रमुख चरण है। HuggingFace की TRL लाइब्रेरी SFT मॉडल बनाने और उन्हें आपके डेटासेट पर कुछ पंक्तियों के कोड से ट्रेन करने के लिए उपयोग में आसान API प्रदान करती है। यह रिइनफोर्समेंट लर्निंग का उपयोग करके भाषा मॉडल ट्रेन करने के टूल्स के साथ आती है—सुपरवाइज़्ड फाइन-ट्यूनिंग से शुरू होकर, फिर रिवार्ड मॉडलिंग और अंततः प्रॉक्सिमल पॉलिसी ऑप्टिमाइज़ेशन (PPO) तक।
हम SFT Trainer को मॉडल, डेटासेट, Lora कॉन्फ़िगरेशन, टोकनाइज़र और प्रशिक्षण पैरामीटर प्रदान करेंगे।
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_params,
    dataset_text_field="text",
    max_seq_length=None,
    tokenizer=tokenizer,
    args=training_params,
    packing=False,
)
हम .train() का उपयोग करके Llama 2 मॉडल को नए डेटासेट पर फाइन-ट्यून करेंगे। मॉडल को 1 ईपोच पूरा करने में डेढ़ घंटा लगा।
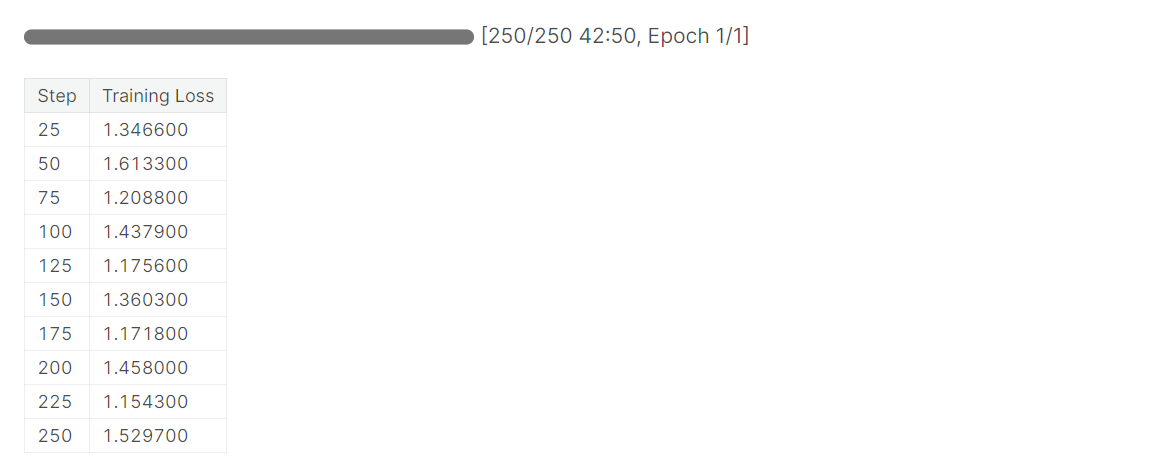
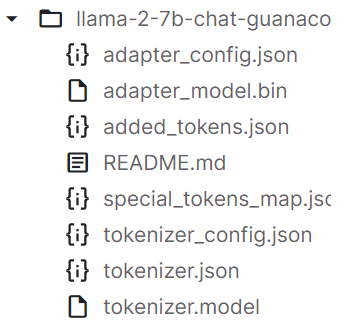
मॉडल को ट्रेन करने के बाद, हम मॉडल एडेप्टर और टोकनाइज़र को सेव करेंगे। आप समान API का उपयोग करके मॉडल को Hugging Face पर अपलोड भी कर सकते हैं।
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
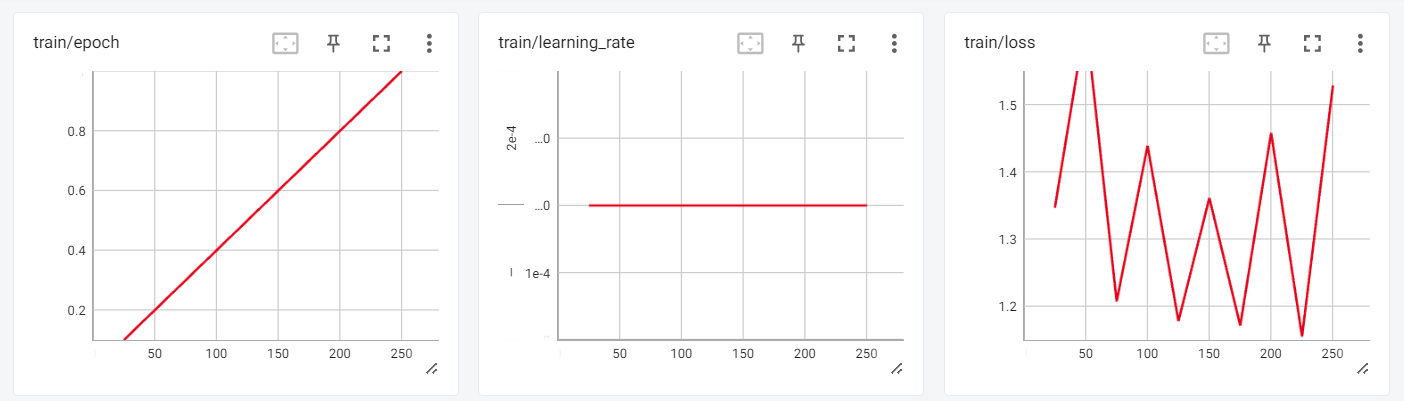
अब हम Tensorboard के इंटरैक्टिव सत्र में प्रशिक्षण के परिणामों की समीक्षा कर सकते हैं।
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
अपने फाइन-ट्यून किए गए मॉडल का परीक्षण करने के लिए, हम transformers के टेक्स्ट जनरेशन पाइपलाइन का उपयोग करेंगे और “Leonardo Da Vinci कौन हैं?” जैसे सरल प्रश्न पूछेंगे।
logging.set_verbosity(logging.CRITICAL)

prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
आउटपुट:
मॉडल एक सुसंगत और विस्तृत उत्तर जनरेट करता है।
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.

Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.

Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.

Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
आइए एक और प्रश्न पूछते हैं।
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
आउटपुट:
Guanaco एक उच्च-गुणवत्ता वाला डेटासेट है जिसका उपयोग पहले अत्याधुनिक LLMs को फाइन-ट्यून करने के लिए किया गया है। पूरा Guanaco डेटासेट Hugging Face पर उपलब्ध है और इसमें विभिन्न प्राकृतिक भाषा कार्यों पर और भी बेहतर प्रदर्शन हासिल करने की क्षमता है।
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.

The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.

In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.

The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.

Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in
यहाँ Colab Notebook है जिसमें कोड और आउटपुट दिए गए हैं, जो आपकी कोडिंग यात्रा में सहायता करेंगे।
अगले चरण में, आप LlamaIndex का उपयोग करके अपनी नई ट्रेनिंग मॉडल के साथ अपना AI अनुप्रयोग बना सकते हैं—इसके लिए LlamaIndex: Adding Personal Data to LLMs ट्यूटोरियल का अनुसरण करें। अपने प्रोजेक्ट के लिए प्रेरणा पाने हेतु 5 Projects Built with Generative Models and Open Source Tools देखें।
जुलाई 2023 में Llama 2 के रिलीज़ के बाद से, Meta ने कई नए मॉडल जारी किए हैं जिनमें बड़े सुधार हैं। Llama 3 (अप्रैल 2024) ने 128K-टोकन की बड़ी शब्दावली और सभी मॉडल आकारों में grouped query attention (GQA) पेश की। Llama 3.1 (जुलाई 2024) ने कॉन्टेक्स्ट लंबाई को 128K टोकन तक बढ़ाया और 405B पैरामीटर वाला वैरिएंट जोड़ा। Llama 3.2 (सितंबर 2024) ने मल्टीमॉडल क्षमताएँ और एज डिवाइसेज़ के लिए अनुकूलित हल्के 1B/3B मॉडल पेश किए।
फाइन-ट्यूनिंग इकोसिस्टम भी काफ़ी विकसित हुआ है। Unsloth जैसे टूल मानक Hugging Face PEFT की तुलना में 2x तेज़ प्रशिक्षण और 60% कम मेमोरी उपयोग प्रदान करते हैं, और LLaMA-Factory जैसे GUI-आधारित टूल बिना कोड लिखे फाइन-ट्यूनिंग को सुलभ बनाते हैं। इस ट्यूटोरियल में कवर किए गए QLoRA और PEFT के मूल सिद्धांत अब भी नींव हैं — हम नवीनतम तरीकों के लिए Llama 3.1 के फाइन-ट्यूनिंग और Llama 3.2 के फाइन-ट्यूनिंग पर हमारे ट्यूटोरियल्स देखने की सलाह देते हैं।
इस ट्यूटोरियल में, हमने QLoRA, PEFT, और SFT जैसी तकनीकों का उपयोग करके स्मृति और कंप्यूट सीमाओं को पार करते हुए LLaMA 2 मॉडल को फाइन-ट्यून करना सीखा। transformers, accelerate, peft, trl, और bitsandbytes जैसी Hugging Face लाइब्रेरीज़ का लाभ उठाकर, हम 7B पैरामीटर वाले LLaMA 2 मॉडल को एक कंज्यूमर GPU पर सफलतापूर्वक फाइन-ट्यून करने में सक्षम रहे।
कुल मिलाकर, इस ट्यूटोरियल ने दिखाया कि हालिया प्रगति ने बड़े भाषा मॉडलों का लोकतंत्रीकरण और पहुँच संभव बना दी है, जिससे सीमित संसाधनों के साथ शौक़ीन लोग भी अत्याधुनिक AI बना सकते हैं।
सीखना जारी रखने के लिए, नए मॉडलों पर व्यावहारिक अभ्यास हेतु Fine-Tuning with Llama 3 कोर्स करें, या इस ट्यूटोरियल में उपयोग किए गए इकोसिस्टम की समझ गहरी करने के लिए Working with Hugging Face कोर्स लें। बुनियादी जानकारी के लिए, Introduction to LLMs in Python या Large Language Models (LLMs) Concepts कोर्स से शुरुआत करें, और AI Fundamentals स्किल ट्रैक को एक्सप्लोर करें।
आज ही अपनी AI यात्रा शुरू करें!
लर्निंग पाथ
कोर्स
कोर्स