
Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
11.7K
Thinking Machines Lab là một công ty nghiên cứu và sản phẩm AI do Mira Murati sáng lập, cựu Giám đốc Công nghệ của OpenAI và từng là CEO tạm quyền. Sau khi rời OpenAI vào tháng 9/2024, Murati đã tập hợp một đội ngũ nhà nghiên cứu AI dày dạn kinh nghiệm và huy động khoảng 2 tỷ đô la với mức định giá 12 tỷ đô la. Quy mô vốn và nhân tài này tạo ra kỳ vọng lớn rằng Thinking Machines có thể trở thành đối thủ đáng gờm của các phòng thí nghiệm AI lâu năm như OpenAI.
Inkling là bản phát hành mô hình lớn đầu tiên do công ty tự phát triển và là mô hình đầu tiên trong một họ mô hình dự kiến. Đây là mô hình đa phương thức với trọng số mở, được thiết kế cho tư duy suy luận, lập trình, sử dụng công cụ và tùy biến, mang đến cái nhìn rõ ràng đầu tiên về những gì Murati và đội ngũ của cô ấy đang xây dựng.
Trong hướng dẫn này, tôi sẽ chỉ bạn cách chạy Inklink trên máy cục bộ, bắt đầu bằng cách thử nghiệm Inkling qua Tinker Playground miễn phí. Sau đó, tôi sẽ hướng dẫn cách tải một bản lượng tử hóa Unsloth GGUF, build nhánh thử nghiệm của llama.cpp, chạy mô hình trên bốn GPU NVIDIA RTX PRO 6000, và tương tác với mô hình qua Web UI tích hợp và API tương thích OpenAI.
Inkling là một mô hình đa phương thức mục đích chung, trọng số mở, đến từ Thinking Machines Lab.
Mô hình sử dụng kiến trúc Mixture-of-Experts với tổng cộng 975 tỷ tham số và 41 tỷ tham số hoạt động, hỗ trợ đầu vào văn bản, hình ảnh và âm thanh, đồng thời cung cấp cửa sổ ngữ cảnh lên đến một triệu token.
Mô hình được thiết kế cho suy luận, lập trình, sử dụng công cụ, tuân thủ hướng dẫn và fine-tune trên nhiều miền khác nhau.
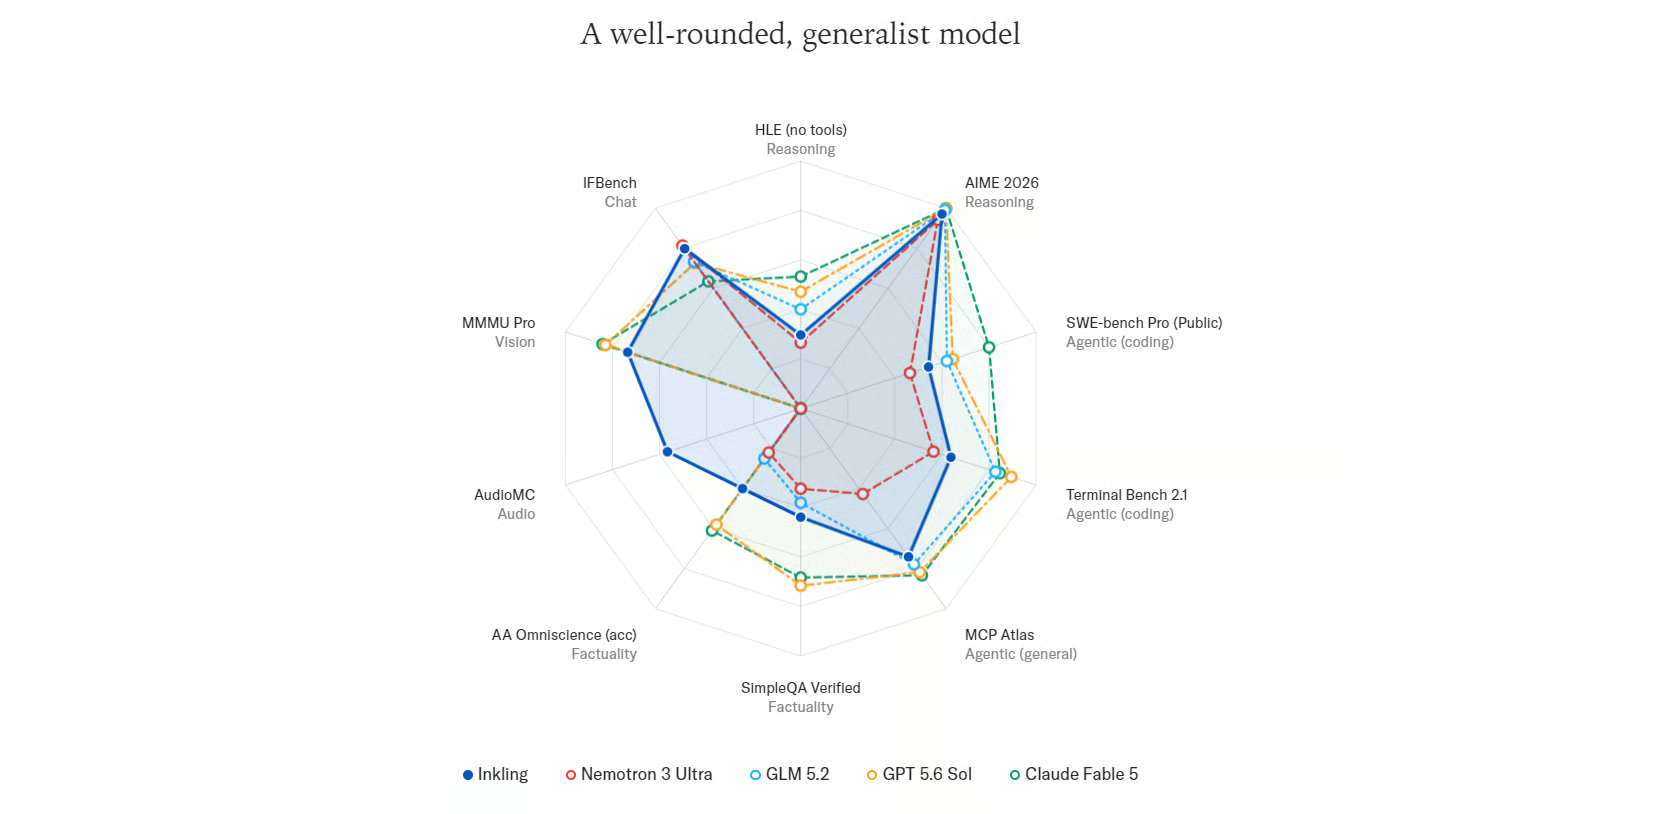
Nguồn: Inkling - Thinking Machines Lab
Inkling là một mô hình tổng quát cân bằng, mang lại hiệu năng hài hòa trên các bài đo về suy luận, lập trình tác vụ kiểu agent, tính xác thực, thị giác và âm thanh.
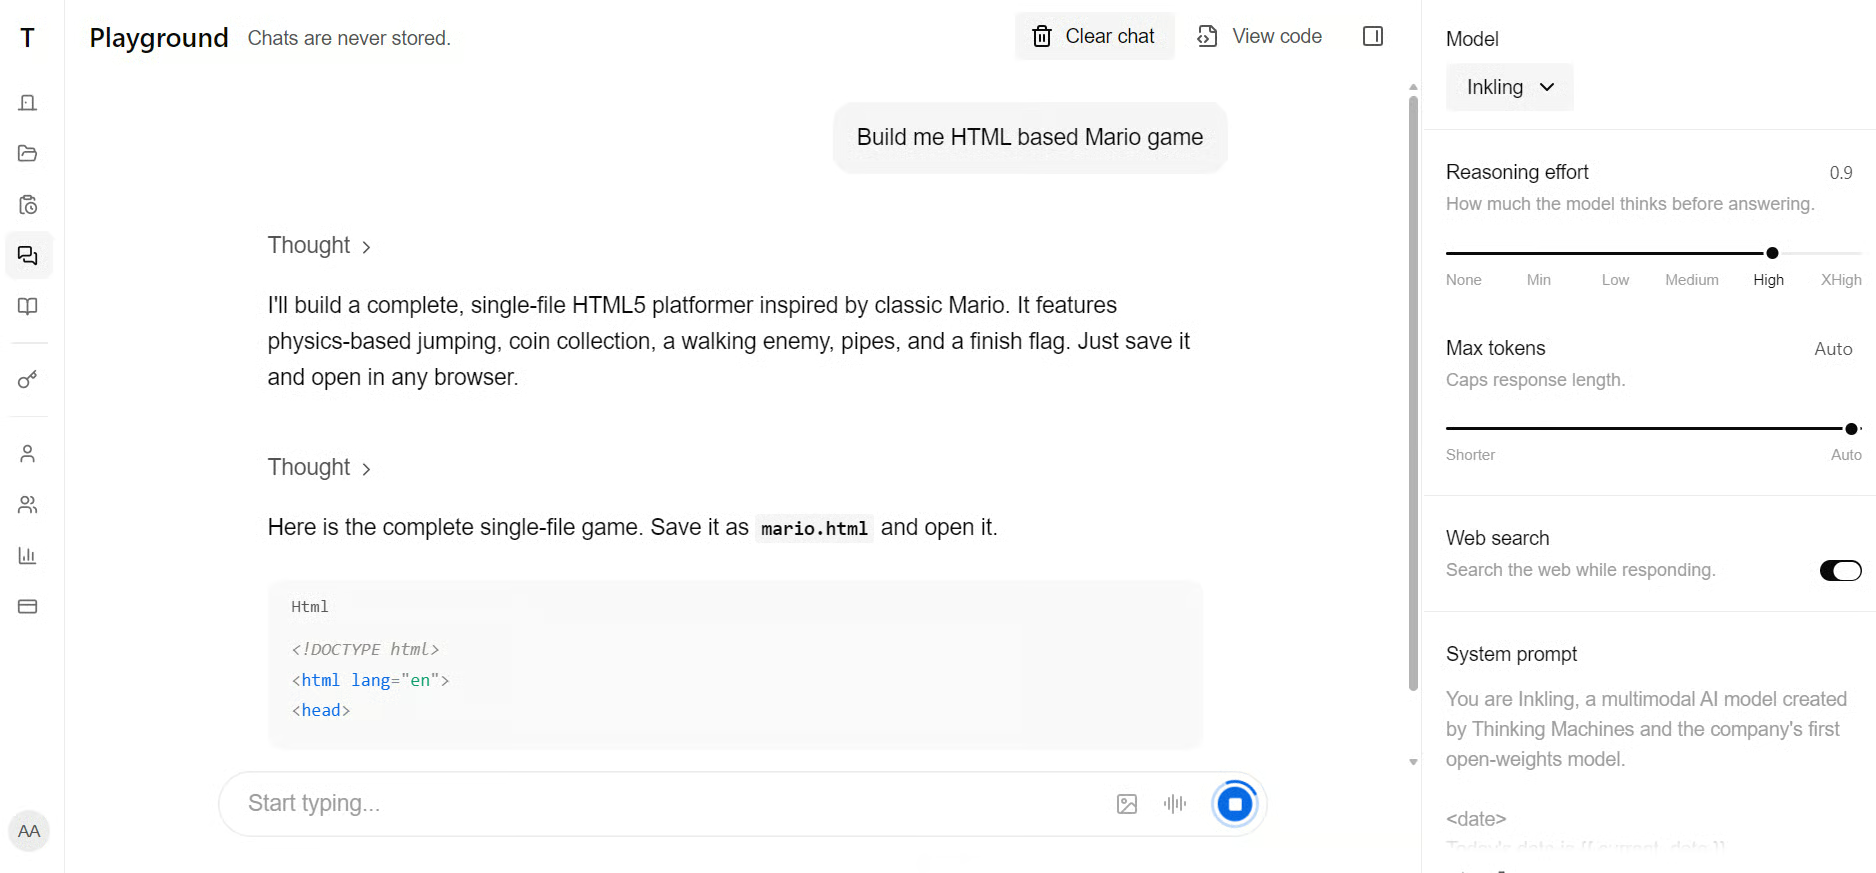
Trước khi chạy Inkling trên máy cục bộ, hãy thử qua Inkling Playground để khám phá phản hồi và hiểu cách mô hình hoạt động. Hiện đang có truy cập miễn phí trong thời gian giới hạn.
Chạy Inkling trên máy cục bộ đòi hỏi phần cứng cấp doanh nghiệp.
Bản lượng tử hóa UD-Q4_K_XL của Unsloth có kích thước khoảng 587 GB, trong khi mô hình BF16 độ chính xác đầy đủ cần khoảng 1,89 TB.
Bộ nhớ này có thể đến từ RAM và VRAM kết hợp, bộ nhớ hợp nhất, hoặc chỉ RAM, mặc dù suy luận chỉ dùng CPU sẽ chậm hơn nhiều.
Ngoài ra còn cần thêm bộ nhớ cho cửa sổ ngữ cảnh và chi phí vận hành.
Trong hướng dẫn này, chúng tôi dùng bản lượng tử hóa nhỏ hơn UD-Q2_K_XL, khoảng 317 GB, trên máy chủ RunPod cấu hình:
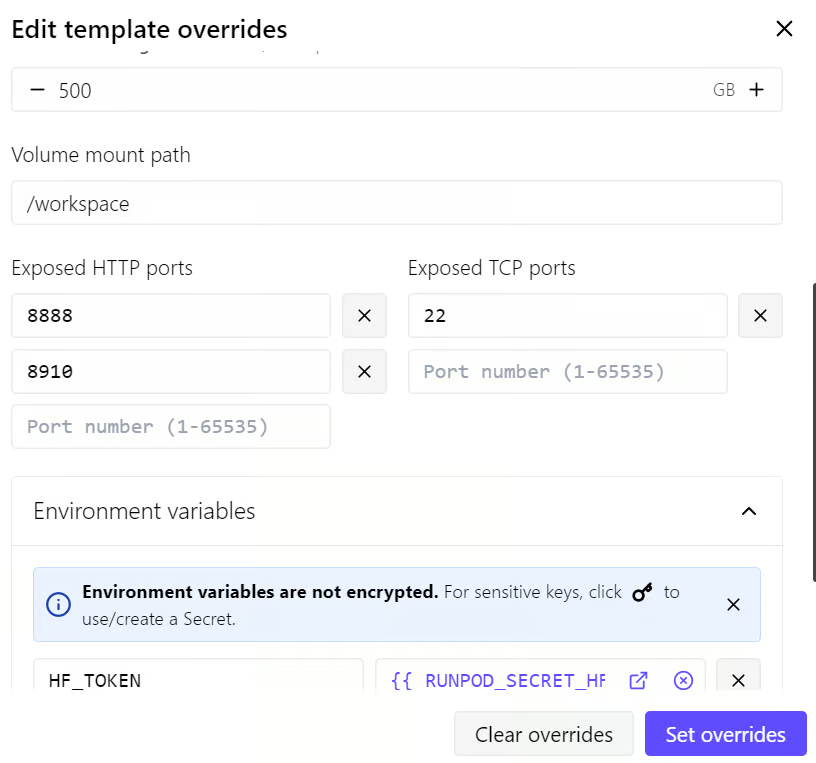
Các tệp mô hình lớn và bộ đệm Hugging Face sẽ được lưu trên ổ đĩa volume 500 GB để chúng vẫn sẵn có nếu Pod khởi động lại.
Ổ container 100 GB sẽ dùng cho gói hệ thống, phụ thuộc build và các yêu cầu runtime khác.
Chúng ta cũng sẽ cấu hình một token truy cập Hugging Face trước khi tải Inkling.
Tải xuống có xác thực giúp tránh giới hạn tốc độ ẩn danh và có thể mang lại tốc độ tải nhanh, ổn định hơn, điều quan trọng với mô hình kích thước như thế này.
Các binary llama.cpp tiêu chuẩn cài qua lệnh curl thông thường sẽ không chạy được với Inkling vì hỗ trợ kiến trúc này chưa được hợp nhất vào nhánh chính.
Hiện hỗ trợ Inkling có sẵn qua pull request thử nghiệm #25731, nên llama.cpp cần được biên dịch từ nhánh đó.
Sau khi triển khai Pod trên RunPod, mở thẻ Connect và nhấp vào liên kết Jupyter Notebook.
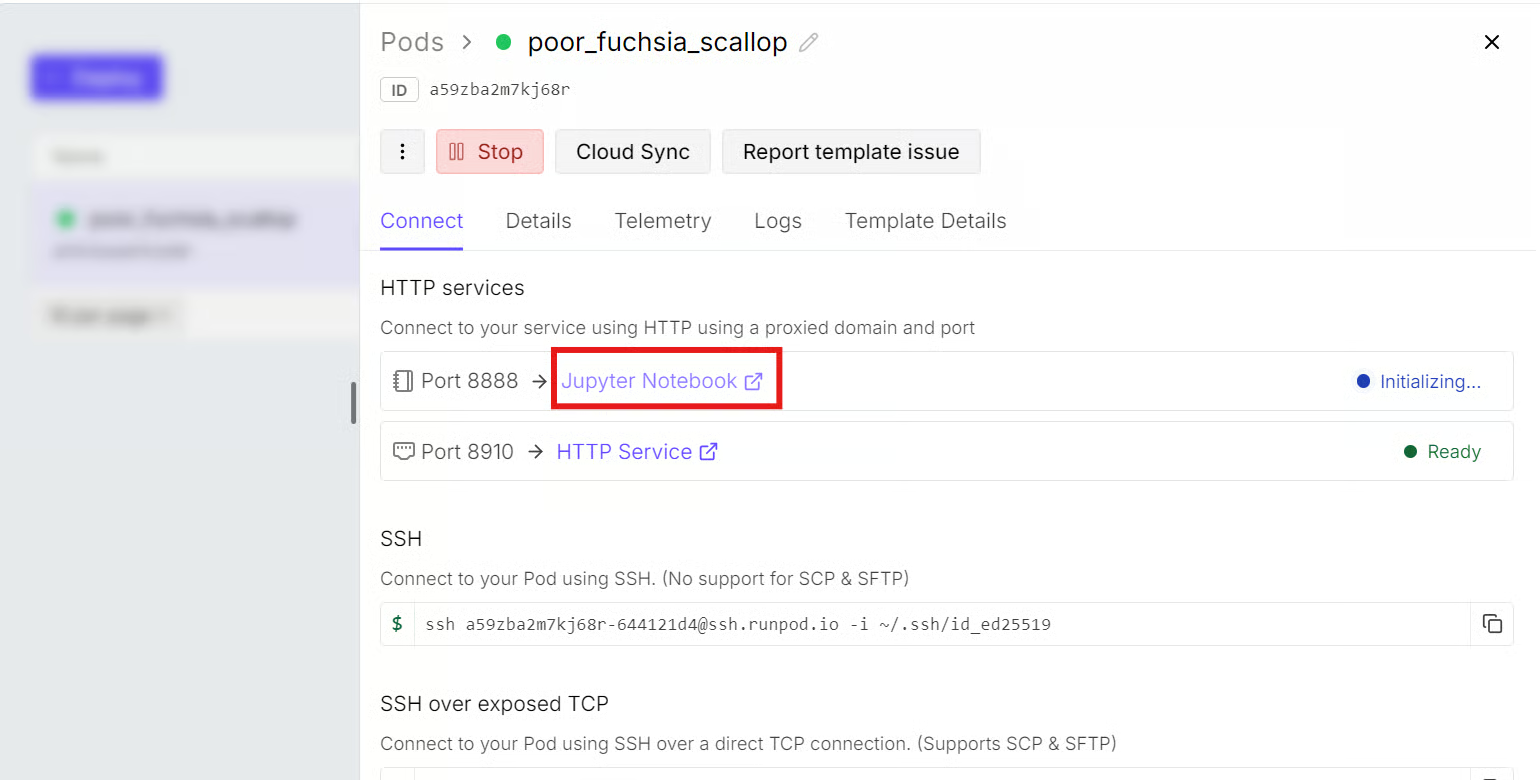
Từ JupyterLab, mở một terminal mới và cài các gói hệ thống cần thiết:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Tiếp theo, clone llama.cpp vào volume /workspace và chuyển sang nhánh có hỗ trợ Inkling:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Hỗ trợ Inkling hiện có qua một pull request nháp thử nghiệm thay vì nhánh chính của llama.cpp. Hãy fetch và chuyển sang nhánh đó:
git fetch origin pull/25731/head:inkling
git switch inkling
Build llama.cpp với CUDA được bật:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Biên dịch giao diện dòng lệnh, giao diện đa phương thức, máy chủ và các tiện ích GGUF:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"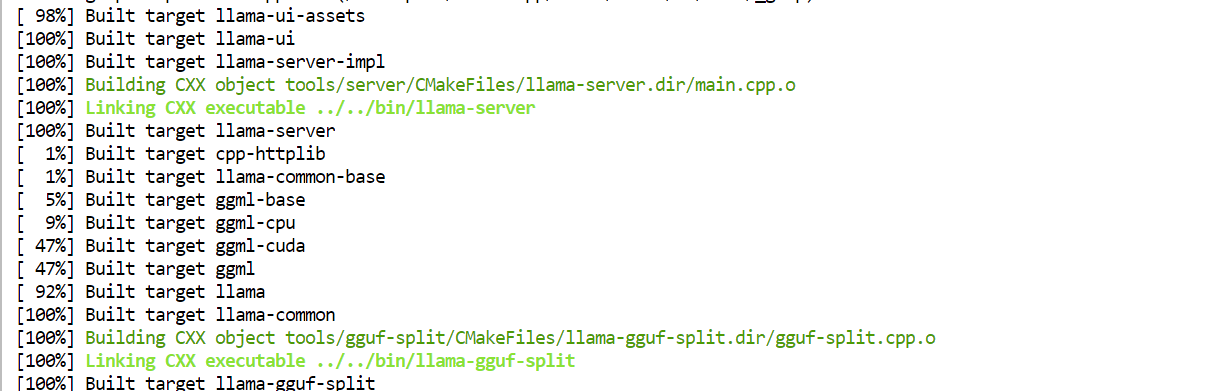
Cuối cùng, sao chép các tệp thực thi đã biên dịch vào thư mục chính của llama.cpp để dễ truy cập hơn:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Cài Hugging Face CLI và hỗ trợ tải qua Xet:
pip install -U huggingface_hub hf_xetToken Hugging Face đã được thêm vào biến môi trường của RunPod khi triển khai Pod, nên không cần đăng nhập thêm.
Tạo thư mục trên ổ volume 500 GB cho cache của Hugging Face và mô hình Inkling:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Đặt vị trí cache và bật tải hiệu năng cao:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
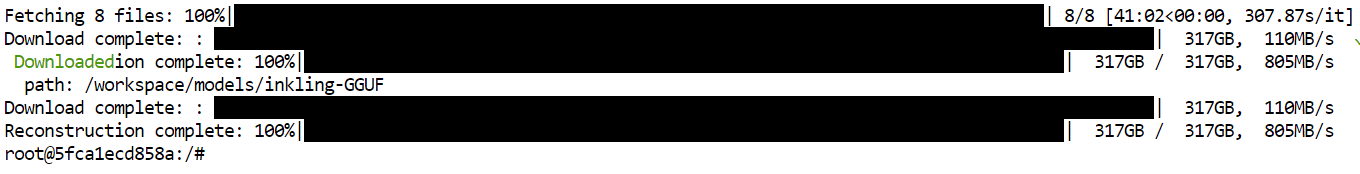
Chỉ tải bản lượng tử hóa UD-Q2_K_XL:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
Thời gian tải phụ thuộc vào kết nối internet của bạn.
Tốc độ tải của tôi bị giới hạn khoảng 130 MB/s, và mô hình mất khoảng 42 phút để tải xong.
Chạy lệnh sau để tải Inkling trên cả bốn GPU và khởi chạy máy chủ suy luận tương thích OpenAI:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja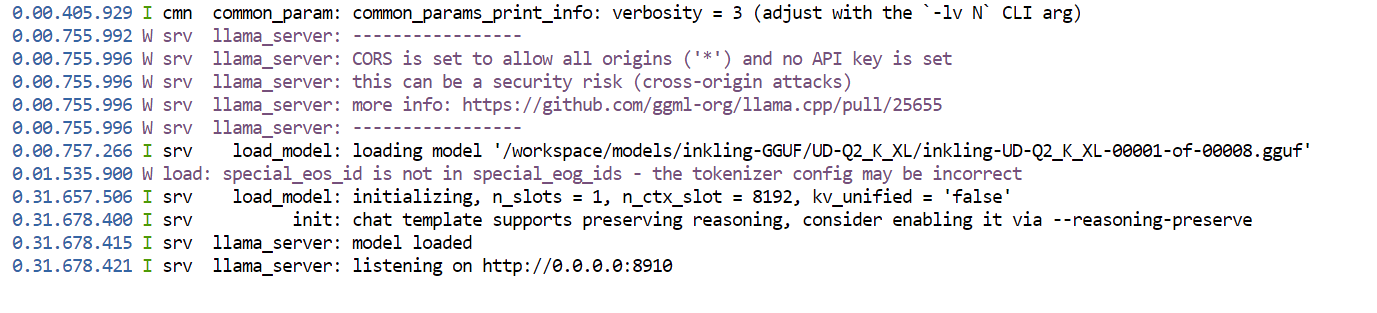
Lệnh này:
llama.cpp sẽ tự động phát hiện và tải bảy shard còn lại.8910.Mở một terminal Jupyter khác và kiểm tra mức sử dụng GPU:
nvidia-smi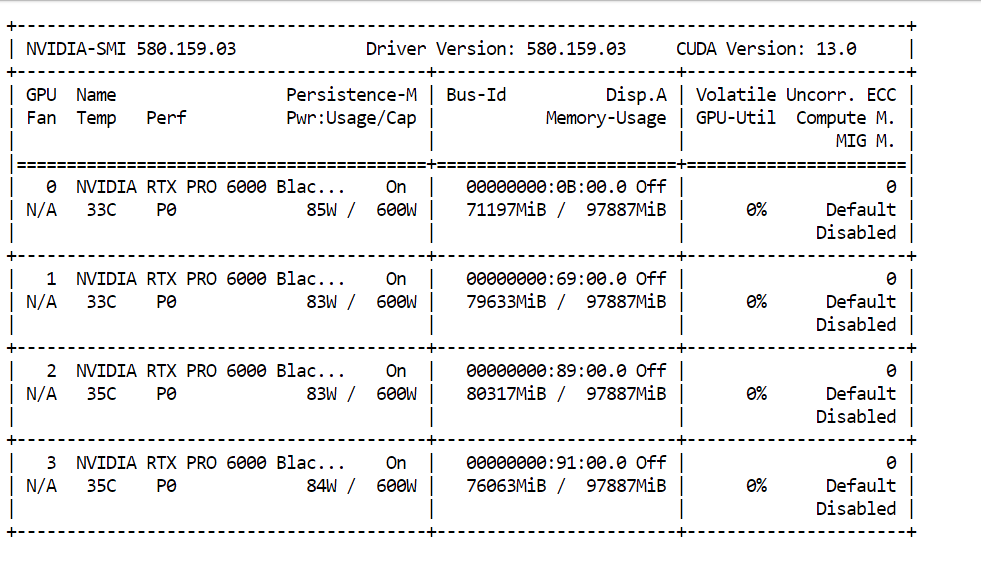
Trong thiết lập này, khoảng 85% bộ nhớ GPU khả dụng được sử dụng sau khi tải mô hình với cửa sổ ngữ cảnh 8.192 token.
Cửa sổ ngữ cảnh lớn hơn cần thêm bộ nhớ KV-cache, vì vậy chạy Inkling với ngữ cảnh như 100.000 token sẽ cần nhiều bộ nhớ khả dụng hơn đáng kể.
API tương thích OpenAI cục bộ có tại:
http://127.0.0.1:8910/v1Trước khi thử Inkling qua Web UI, hãy xác nhận máy chủ suy luận đang chạy và trả về phản hồi. Mở terminal mới và gửi yêu cầu thử nghiệm tới API cục bộ:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
API phản hồi thành công, xử lý prompt ở tốc độ 81,1 token/giây và tạo ở tốc độ 37,2 token/giây.
Mô hình dùng 25 token prompt và 256 token hoàn thành, nhưng dừng lại do chạm giới hạn đầu ra trước khi đưa ra câu trả lời cuối. Tăng max_tokens sẽ cho phép mô hình hoàn tất phản hồi.
Quay lại bảng điều khiển RunPod, mở thẻ Connect và nhấp vào liên kết liệt kê dưới HTTP Services cho cổng 8910.
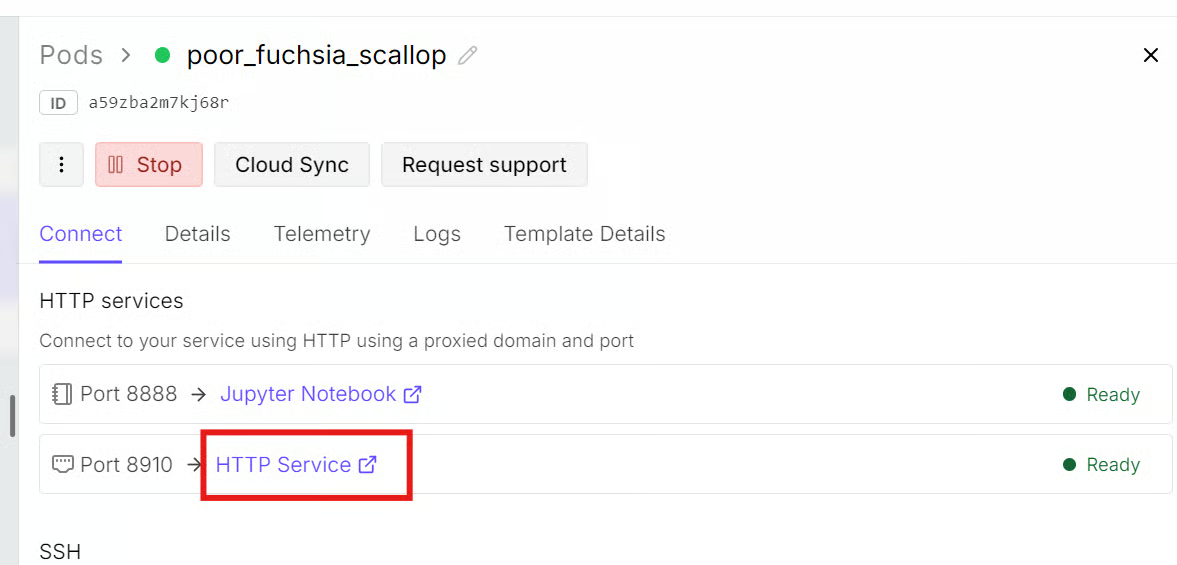
Web UI tích hợp của llama.cpp cung cấp giao diện kiểu ChatGPT đơn giản để gửi prompt, điều chỉnh thiết lập sinh và xem phản hồi.
Cùng máy chủ này cũng mở một API tương thích OpenAI để kết nối ứng dụng và công cụ bên ngoài.
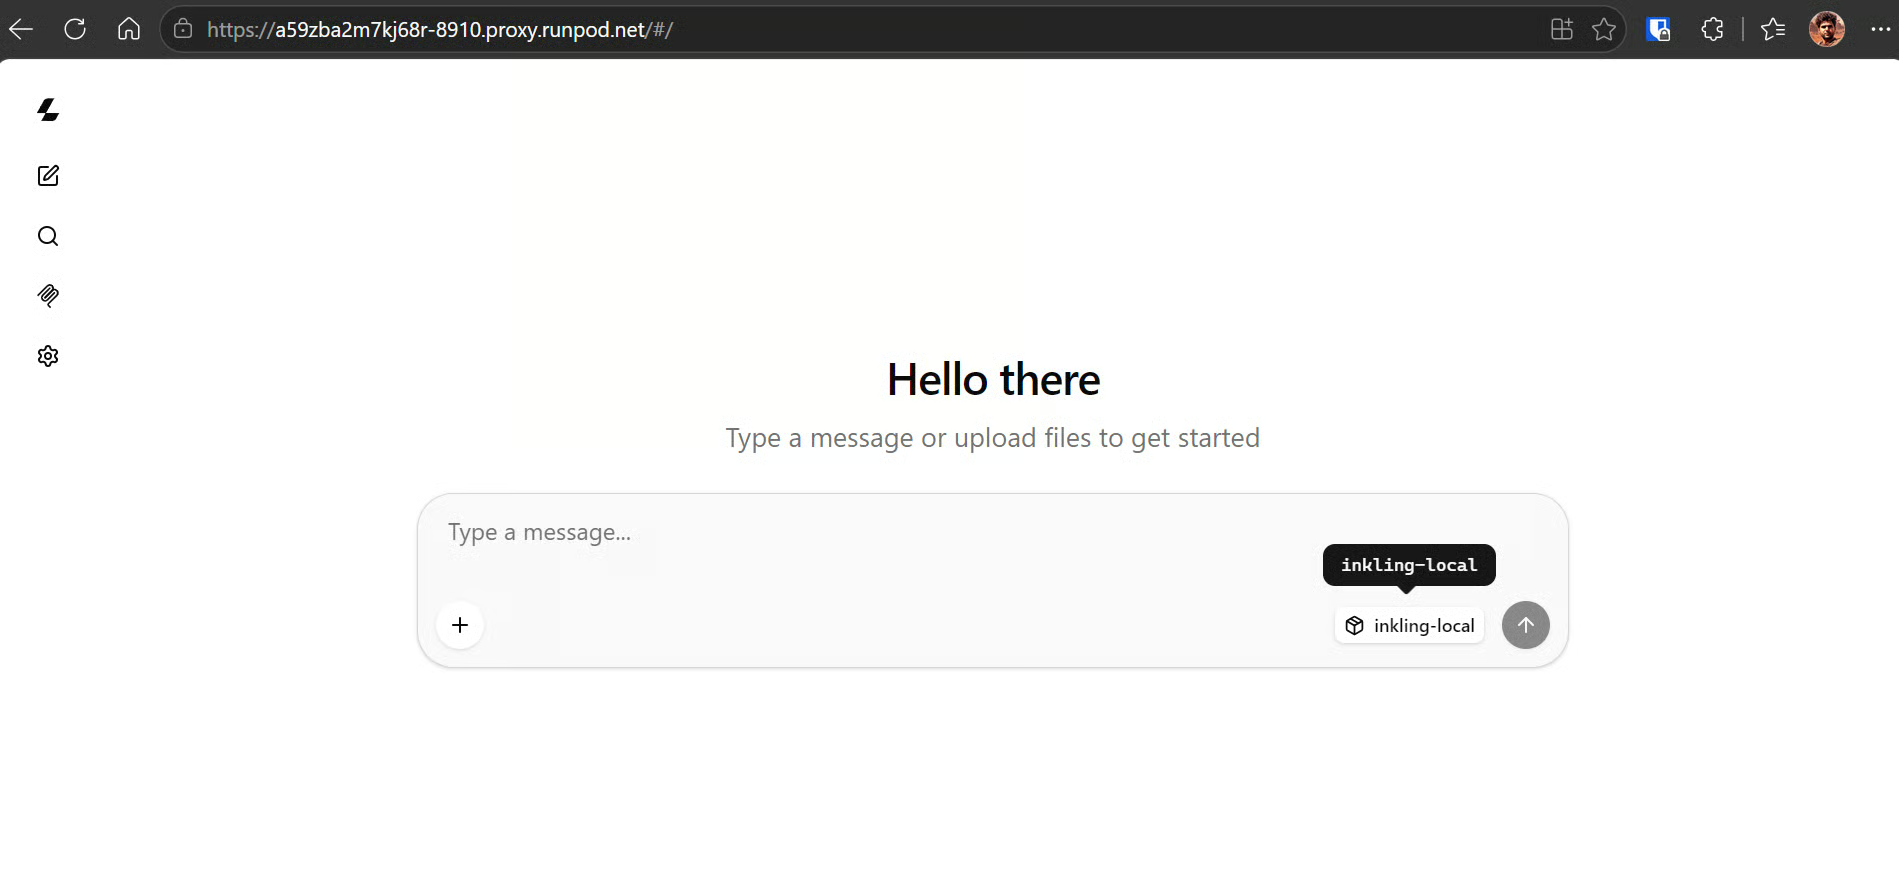
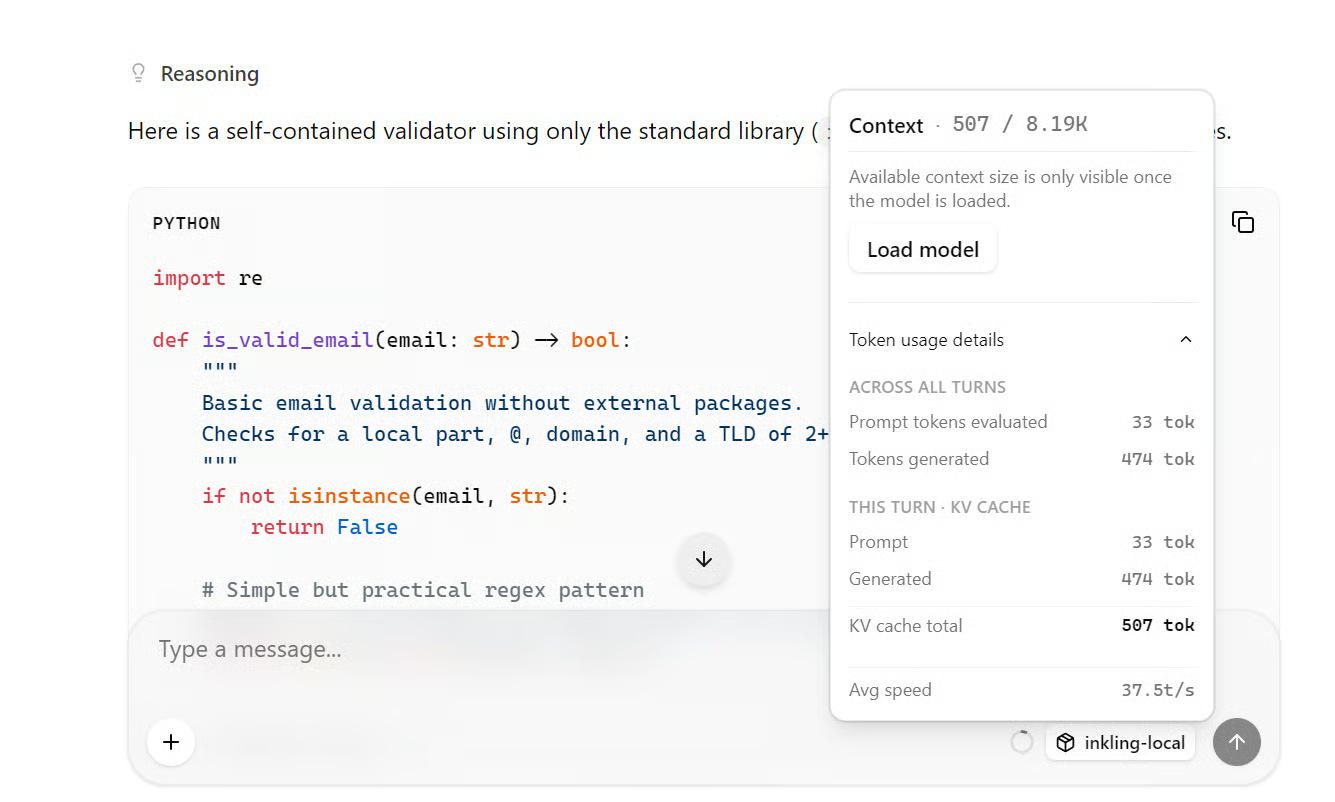
Bắt đầu với một prompt lập trình:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling tạo ra phần giải thích đầy đủ và mã hoạt động với tốc độ trung bình khoảng 37,5 token/giây.
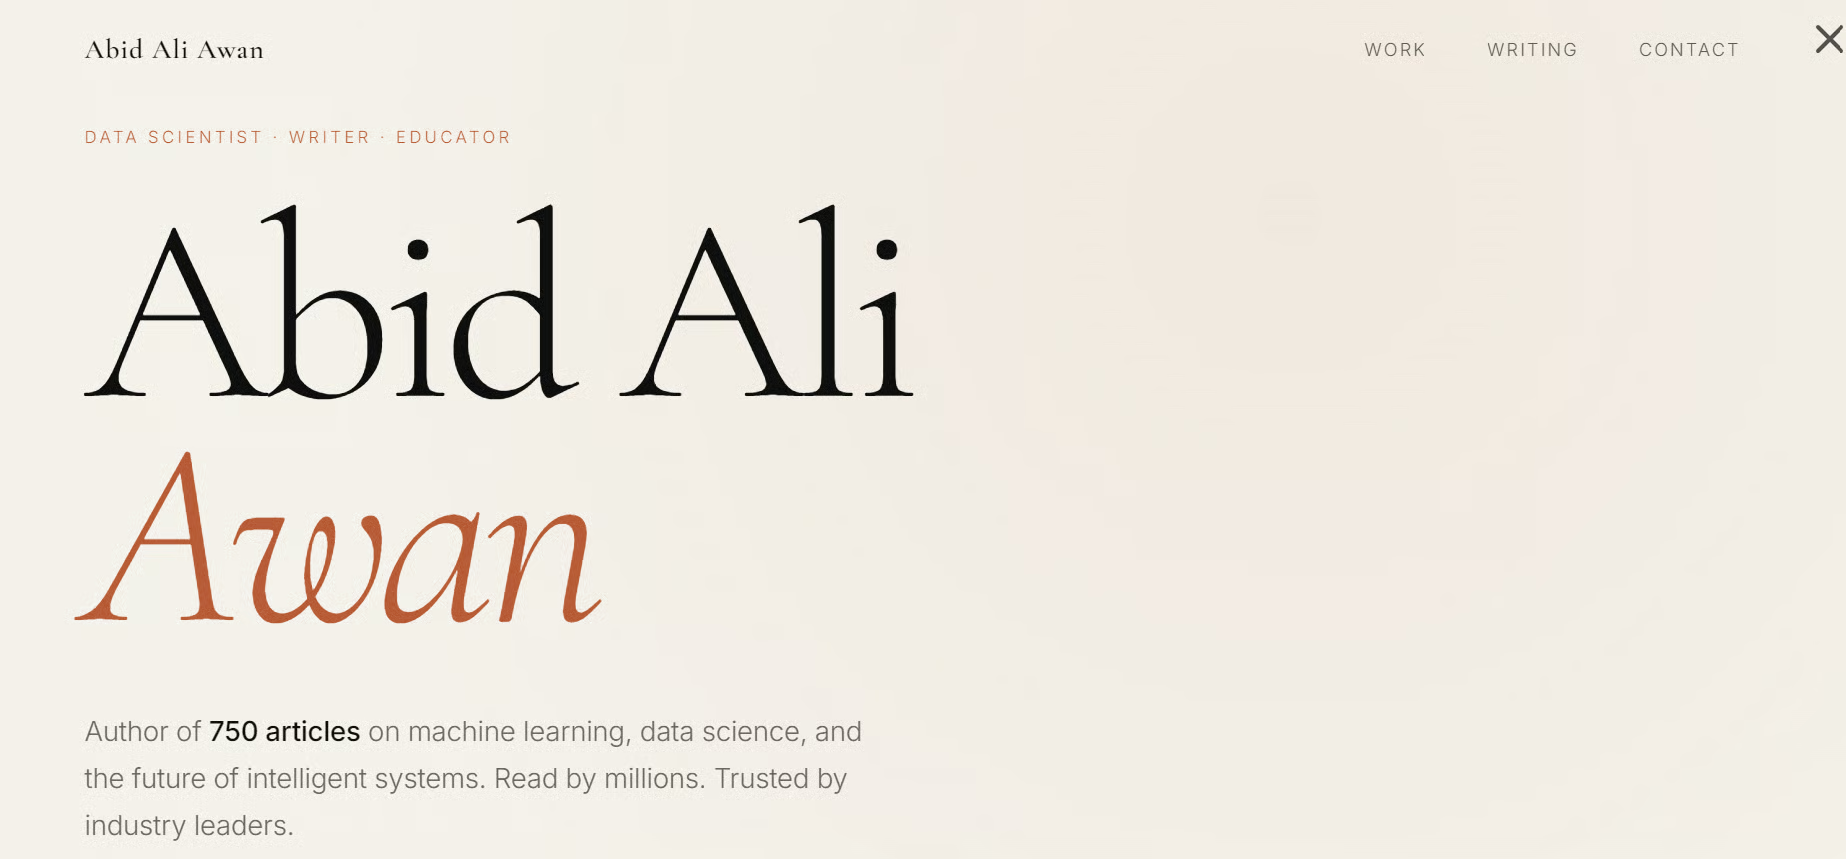
Tiếp theo, tôi yêu cầu mô hình tạo một trang web cá nhân. Dù dùng bản lượng tử hóa nặng, Inkling vẫn tạo ra bố cục trau chuốt, giao diện sạch và mã website hoạt động tốt.
Inkling không gây ấn tượng với tôi dù là khi thiết lập cục bộ hay trên Playground trực tuyến.
Các phản hồi sử dụng được nhưng ở mức trung bình, và một số mô hình nguồn mở nhỏ hơn cho kết quả tốt hơn trong các tác vụ tương tự.
Tuy nhiên, Inkling không được thiết kế để dẫn đầu một hạng mục duy nhất.
Đây là mô hình mục đích chung cân bằng, kết hợp khả năng lập trình, viết, suy luận, đa ngôn ngữ, thị giác và âm thanh. Mô hình đạt kết quả hợp lý trên nhiều bài đo thay vì dẫn đầu một lĩnh vực cụ thể.
Với các tác vụ lập trình, nghiên cứu hoặc viết chuyên sâu, có những lựa chọn nguồn mở và nguồn đóng mạnh hơn.
Giá trị của Inkling nằm ở tính linh hoạt: trọng số mở, đa phương thức, có thể tùy biến và có thể huấn luyện hoặc fine-tune qua Tinker, nền tảng nguồn mở của Thinking Machines dành cho huấn luyện và tùy biến mô hình.
Bản phát hành này có thể đã làm dịu bớt phần nào sự kỳ vọng ban đầu, nhưng cũng làm rõ hướng đi của công ty.
Thinking Machines có vẻ không chỉ tranh đua cho các điểm số cao nhất trên bảng xếp hạng. Thay vào đó, công ty đang xây dựng một hệ sinh thái rộng hơn quanh các mô hình có thể thích ứng, để các tổ chức fine-tune và sử dụng cho nhiều tác vụ khác nhau.
Khóa học nổi bật trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
