Curso
Codificação com IA para Desenvolvedores
1 h 30 min
11.7K
A Thinking Machines Lab é uma empresa de pesquisa e produtos em IA fundada por Mira Murati, ex-CTO da OpenAI e, por um breve período, CEO interina. Após sair da OpenAI em setembro de 2024, Murati montou um time de pesquisadores experientes em IA e levantou cerca de US$ 2 bilhões, com valuation de US$ 12 bilhões. A combinação de capital e talento gerou grande expectativa de que a Thinking Machines poderia se tornar uma concorrente de peso frente a laboratórios de IA já estabelecidos, como a OpenAI.
Inkling é o primeiro grande lançamento de modelo próprio da empresa — e o primeiro de uma família planejada. É um modelo multimodal com pesos abertos, voltado para raciocínio, programação, uso de ferramentas e customização, oferecendo o primeiro vislumbre claro do que Murati e sua equipe vêm construindo.
Neste guia, vou mostrar como rodar o Inkling localmente, começando por testá-lo no Tinker Playground gratuito. Em seguida, vou mostrar como baixar uma quantização GGUF do Unsloth, compilar a branch experimental do llama.cpp, rodar o modelo em quatro GPUs NVIDIA RTX PRO 6000 e interagir com ele pela Web UI nativa e pela API compatível com a OpenAI.
Inkling é um modelo multimodal de uso geral, com pesos abertos, da Thinking Machines Lab.
Ele adota uma arquitetura de Mixture-of-Experts com 975 bilhões de parâmetros totais e 41 bilhões de parâmetros ativos, aceita entradas de texto, imagem e áudio e oferece uma janela de contexto de até um milhão de tokens.
O modelo foi projetado para raciocínio, programação, uso de ferramentas, seguir instruções e fine-tuning em diferentes domínios.
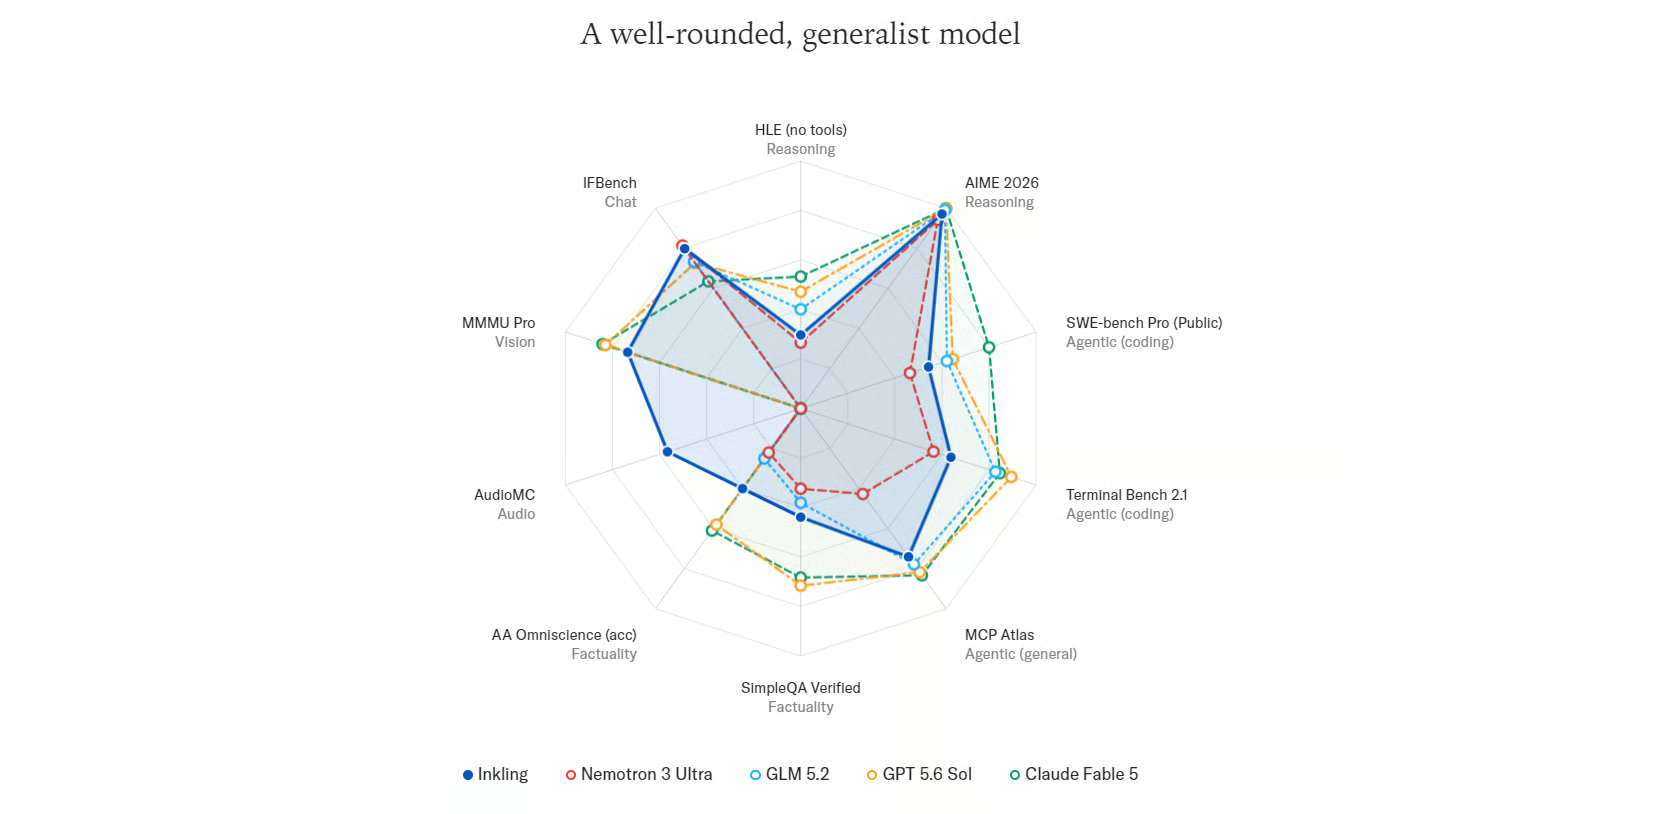
Fonte: Inkling - Thinking Machines Lab
Inkling é um modelo generalista bem equilibrado, com desempenho consistente em benchmarks de raciocínio, codificação agentiva, factualidade, visão e áudio.
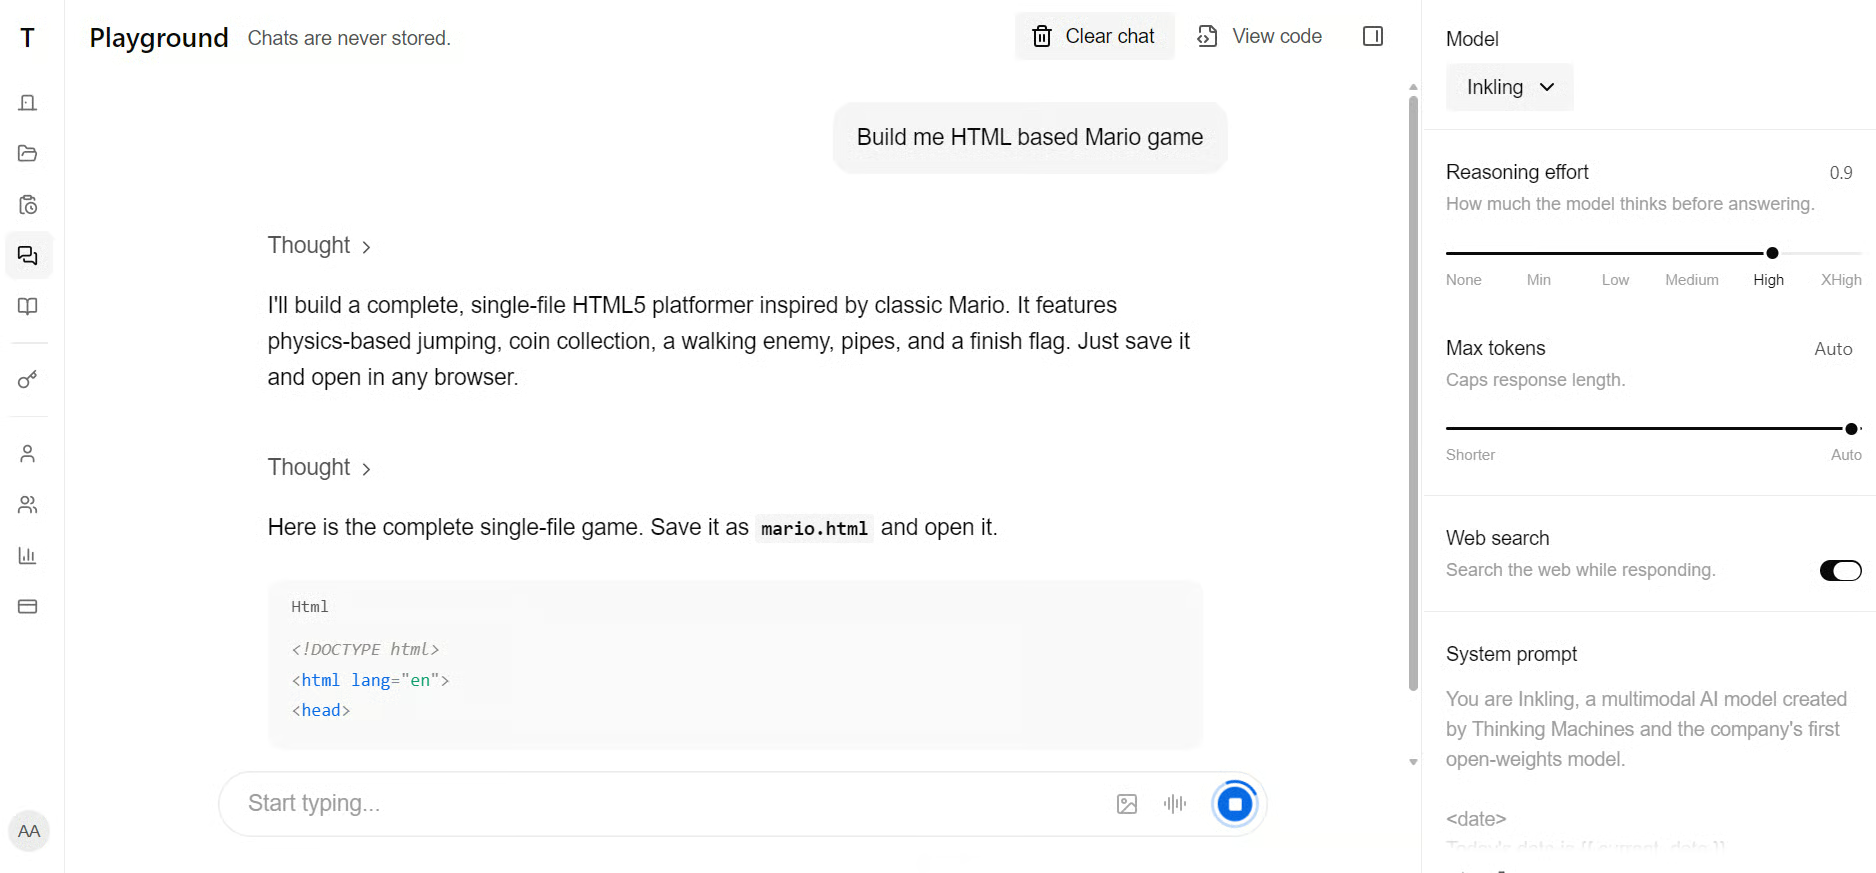
Antes de rodar o Inkling localmente, experimente-o no Inkling Playground para explorar as respostas e entender como o modelo se comporta. O acesso gratuito está disponível por tempo limitado.
Rodar o Inkling localmente exige hardware em nível corporativo.
A quantização UD-Q4_K_XL do Unsloth tem aproximadamente 587 GB, enquanto o modelo em BF16 com precisão total requer cerca de 1,89 TB.
Essa memória pode vir de RAM e VRAM combinadas, memória unificada ou apenas RAM — mas a inferência somente em CPU será bem mais lenta.
Também é necessária memória adicional para a janela de contexto e overhead de runtime.
Para este guia, usamos a quantização menor UD-Q2_K_XL, com aproximadamente 317 GB, em um servidor RunPod configurado com:
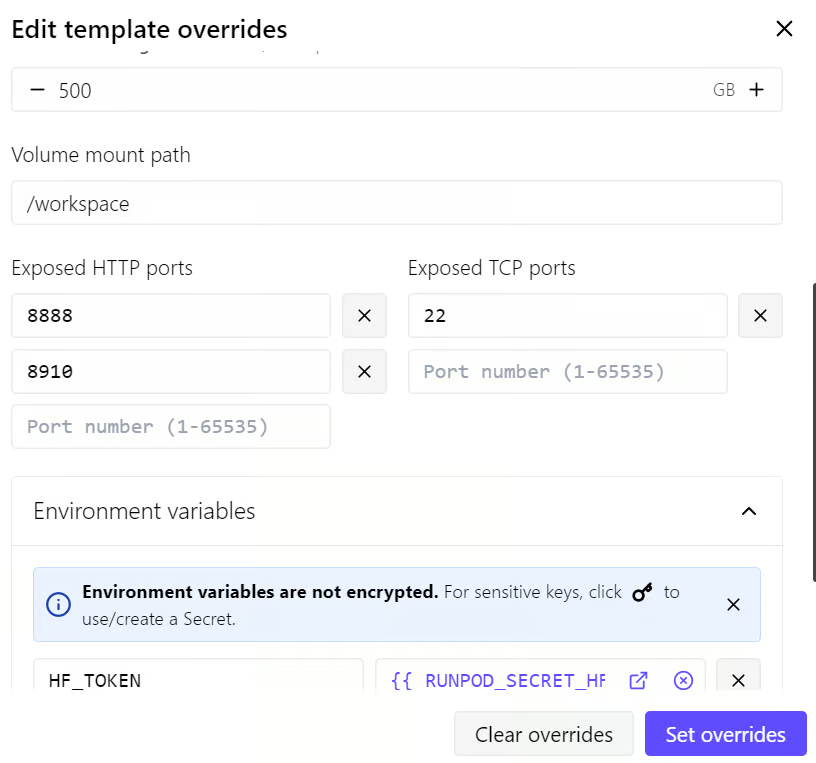
Os arquivos gigantes do modelo e o cache do Hugging Face serão armazenados no disco de 500 GB para permanecerem disponíveis caso o Pod reinicie.
O disco do container de 100 GB será usado para pacotes de sistema, dependências de build e outros requisitos de runtime.
Também vamos configurar um token de acesso do Hugging Face antes de baixar o Inkling.
Downloads autenticados ajudam a evitar limitações de taxa para usuários anônimos e podem oferecer velocidades mais rápidas e estáveis — algo essencial ao baixar um modelo desse porte.
Os binários padrão do llama.cpp instalados pelo comando tradicional curl não funcionam com o Inkling, porque o suporte à sua arquitetura ainda não foi incorporado à branch principal.
O suporte ao Inkling está disponível no pull request experimental #25731; por isso, o llama.cpp precisa ser compilado a partir dessa branch.
Depois de ativar o Pod no RunPod, abra a aba Connect e clique no link do Jupyter Notebook.
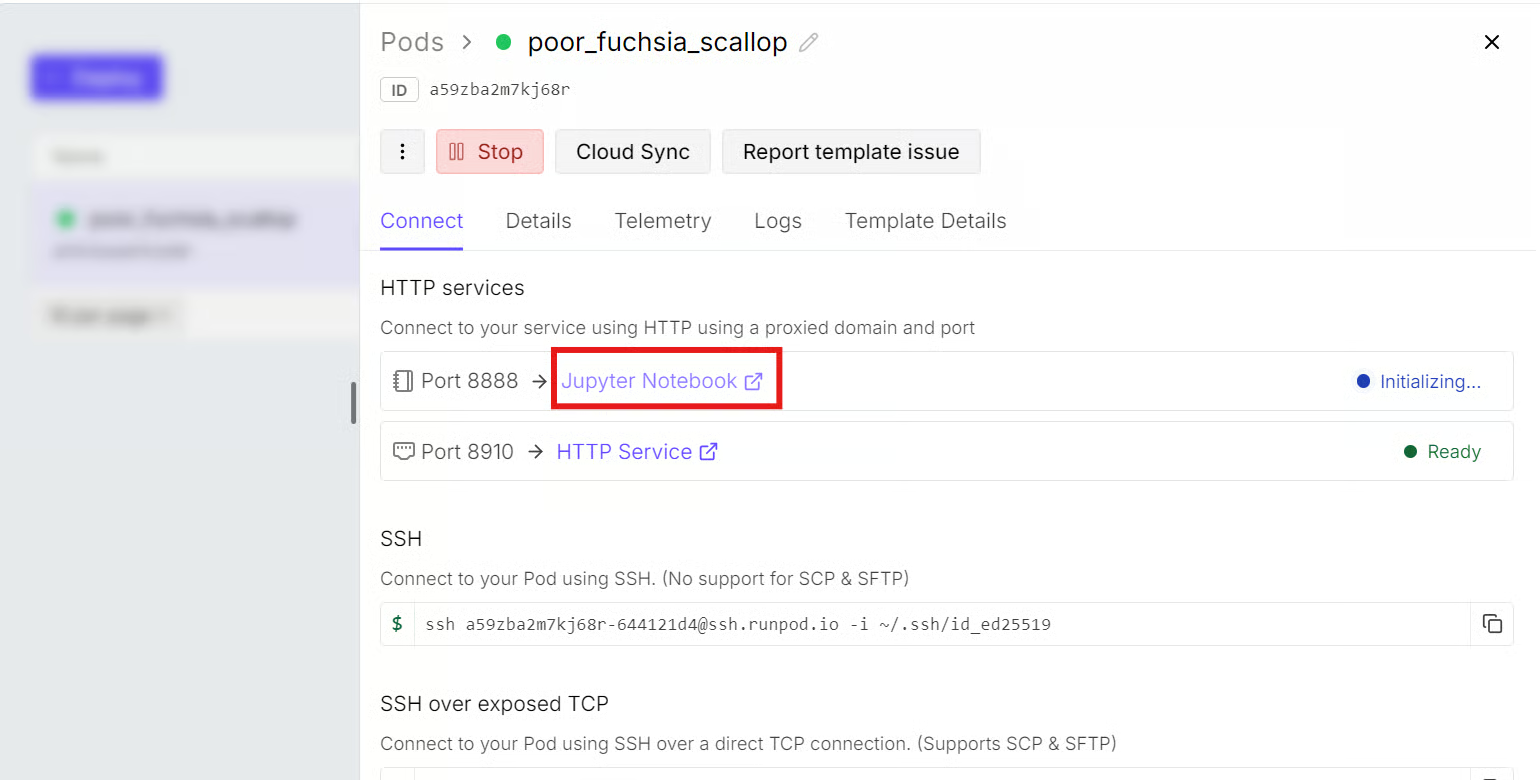
No JupyterLab, abra um novo terminal e instale os pacotes de sistema necessários:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Em seguida, clone o llama.cpp no volume /workspace e troque para a branch com suporte ao Inkling:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
O suporte ao Inkling está em um pull request experimental (draft), e não na branch principal do llama.cpp. Busque e troque para essa branch:
git fetch origin pull/25731/head:inkling
git switch inkling
Compile o llama.cpp com aceleração CUDA ativada:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Compile a interface de linha de comando, a interface multimodal, o servidor e as utilidades GGUF:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"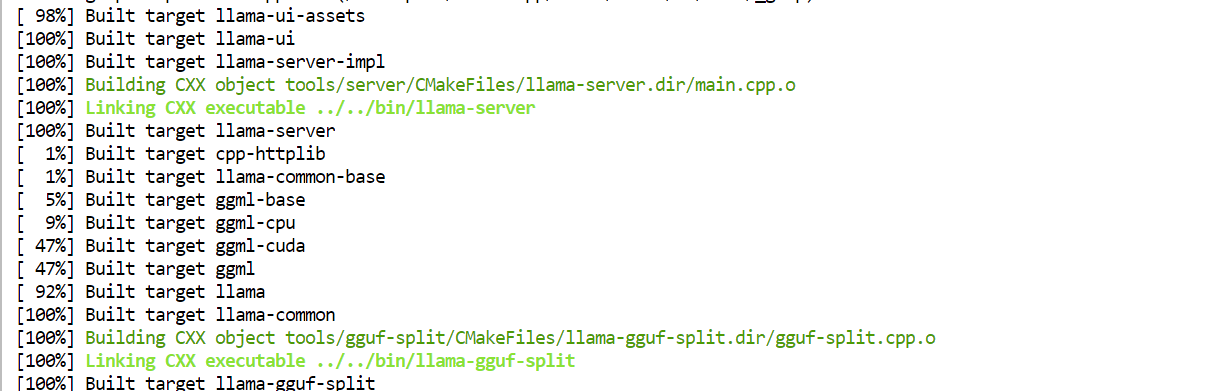
Por fim, copie os executáveis compilados para o diretório principal do llama.cpp, facilitando o acesso:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Instale a CLI do Hugging Face e o suporte a download via Xet:
pip install -U huggingface_hub hf_xetO token do Hugging Face já foi adicionado às variáveis de ambiente do RunPod quando o Pod foi criado, então não é necessário fazer login adicional.
Crie diretórios no disco de 500 GB para o cache do Hugging Face e o modelo do Inkling:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Defina o local do cache e ative downloads de alto desempenho:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
Baixe apenas a quantização UD-Q2_K_XL:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
O tempo de download vai depender da sua conexão.
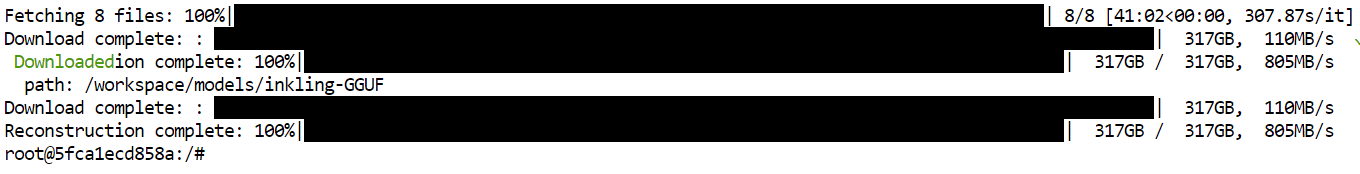
No meu caso, a velocidade ficou limitada a cerca de 130 MB/s, e o modelo levou aproximadamente 42 minutos para baixar.
Execute o comando abaixo para carregar o Inkling nas quatro GPUs e iniciar um servidor de inferência compatível com a OpenAI:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja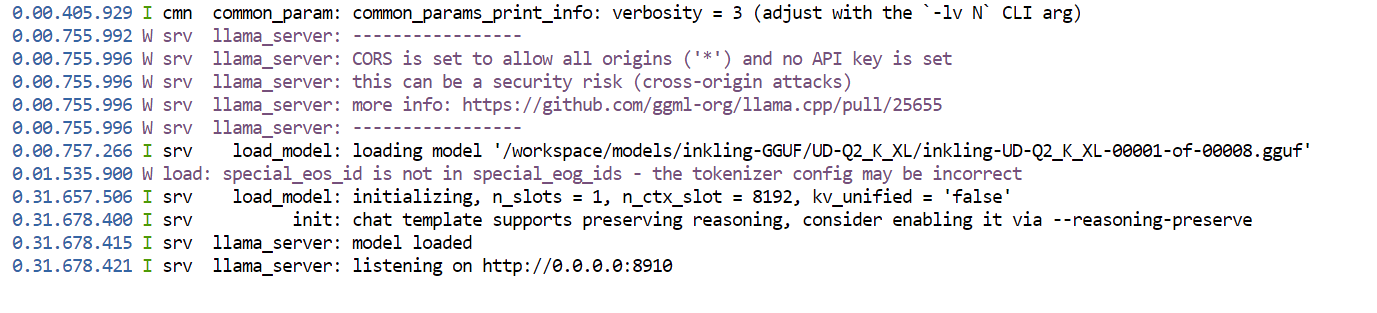
O comando:
llama.cpp detecta e carrega automaticamente os outros sete shards.8910.Abra outro terminal do Jupyter e verifique o uso das GPUs:
nvidia-smi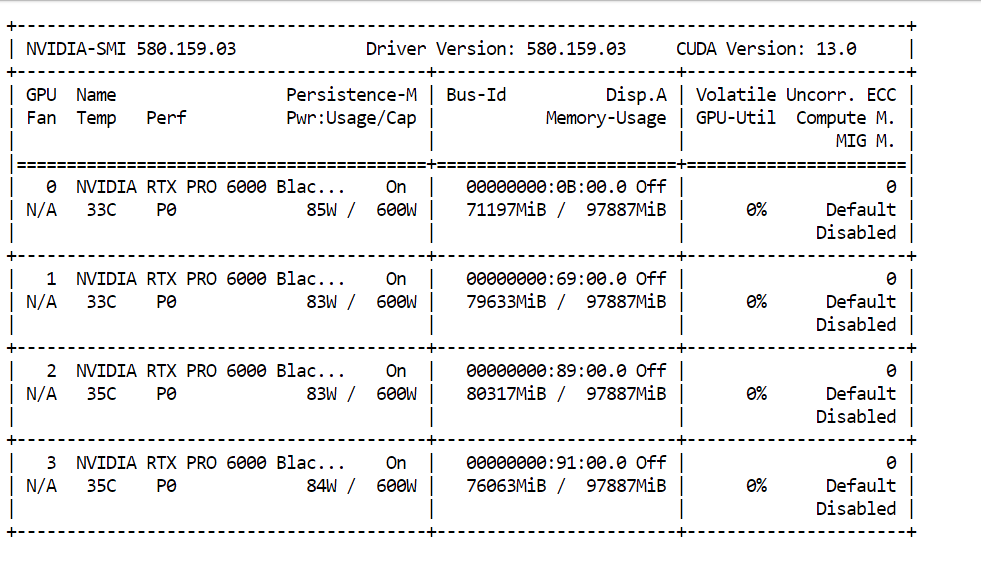
Nesta configuração, aproximadamente 85% da memória de GPU disponível foi utilizada após carregar o modelo com uma janela de contexto de 8.192 tokens.
Janelas de contexto maiores exigem memória extra para o KV-cache. Rodar o Inkling com algo como 100.000 tokens de contexto exigiria bem mais memória disponível.
A API local compatível com a OpenAI está disponível em:
http://127.0.0.1:8910/v1Antes de testar o Inkling pela Web UI, valide se o servidor de inferência está rodando e respondendo. Abra um novo terminal e envie uma requisição de teste para a API local:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
A API respondeu com sucesso, processando o prompt a 81,1 tokens por segundo e gerando a 37,2 tokens por segundo.
Foram usados 25 tokens de prompt e 256 tokens de resposta, mas a geração foi interrompida ao atingir o limite de saída antes da resposta final. Aumentar o max_tokens permite que o modelo conclua a resposta.
Volte ao dashboard do RunPod, abra a aba Connect e clique no link listado em HTTP Services para a porta 8910.
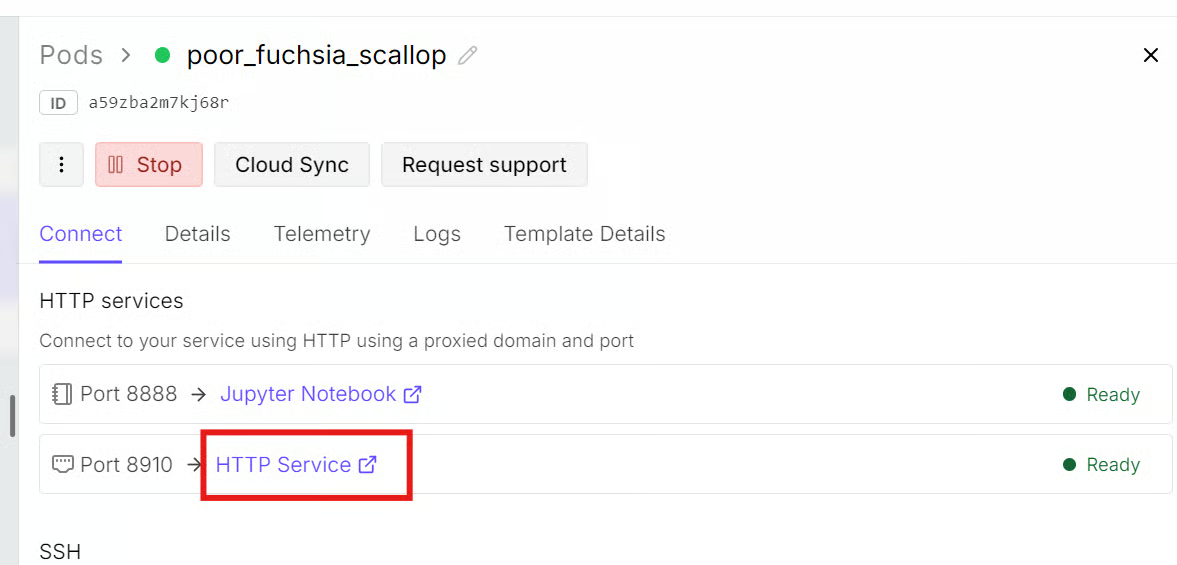
A Web UI embutida do llama.cpp oferece uma interface ao estilo ChatGPT para enviar prompts, ajustar parâmetros de geração e visualizar respostas.
O mesmo servidor também expõe uma API compatível com a OpenAI para conectar aplicativos e ferramentas externas.
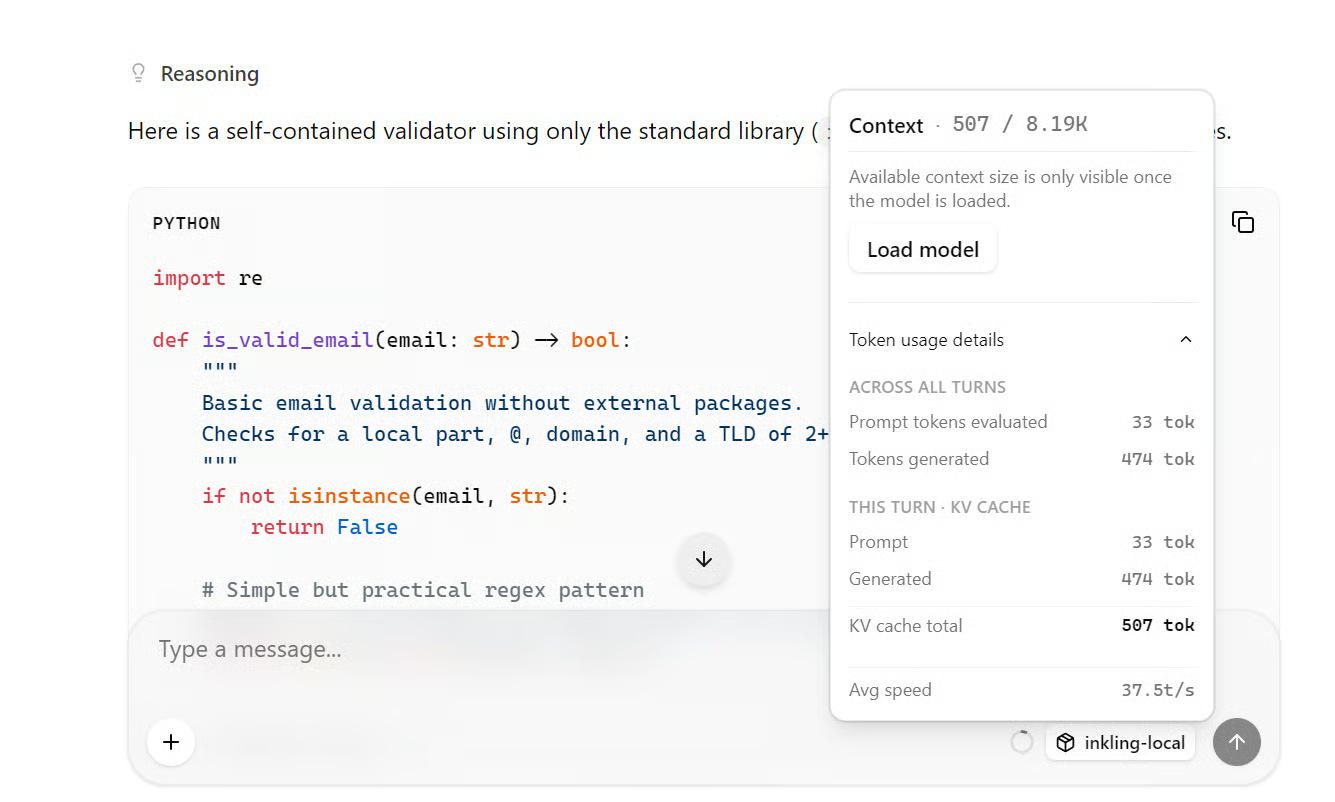
Comece com um prompt de programação:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
O Inkling gerou uma explicação completa e código funcional a uma velocidade média de cerca de 37,5 tokens por segundo.
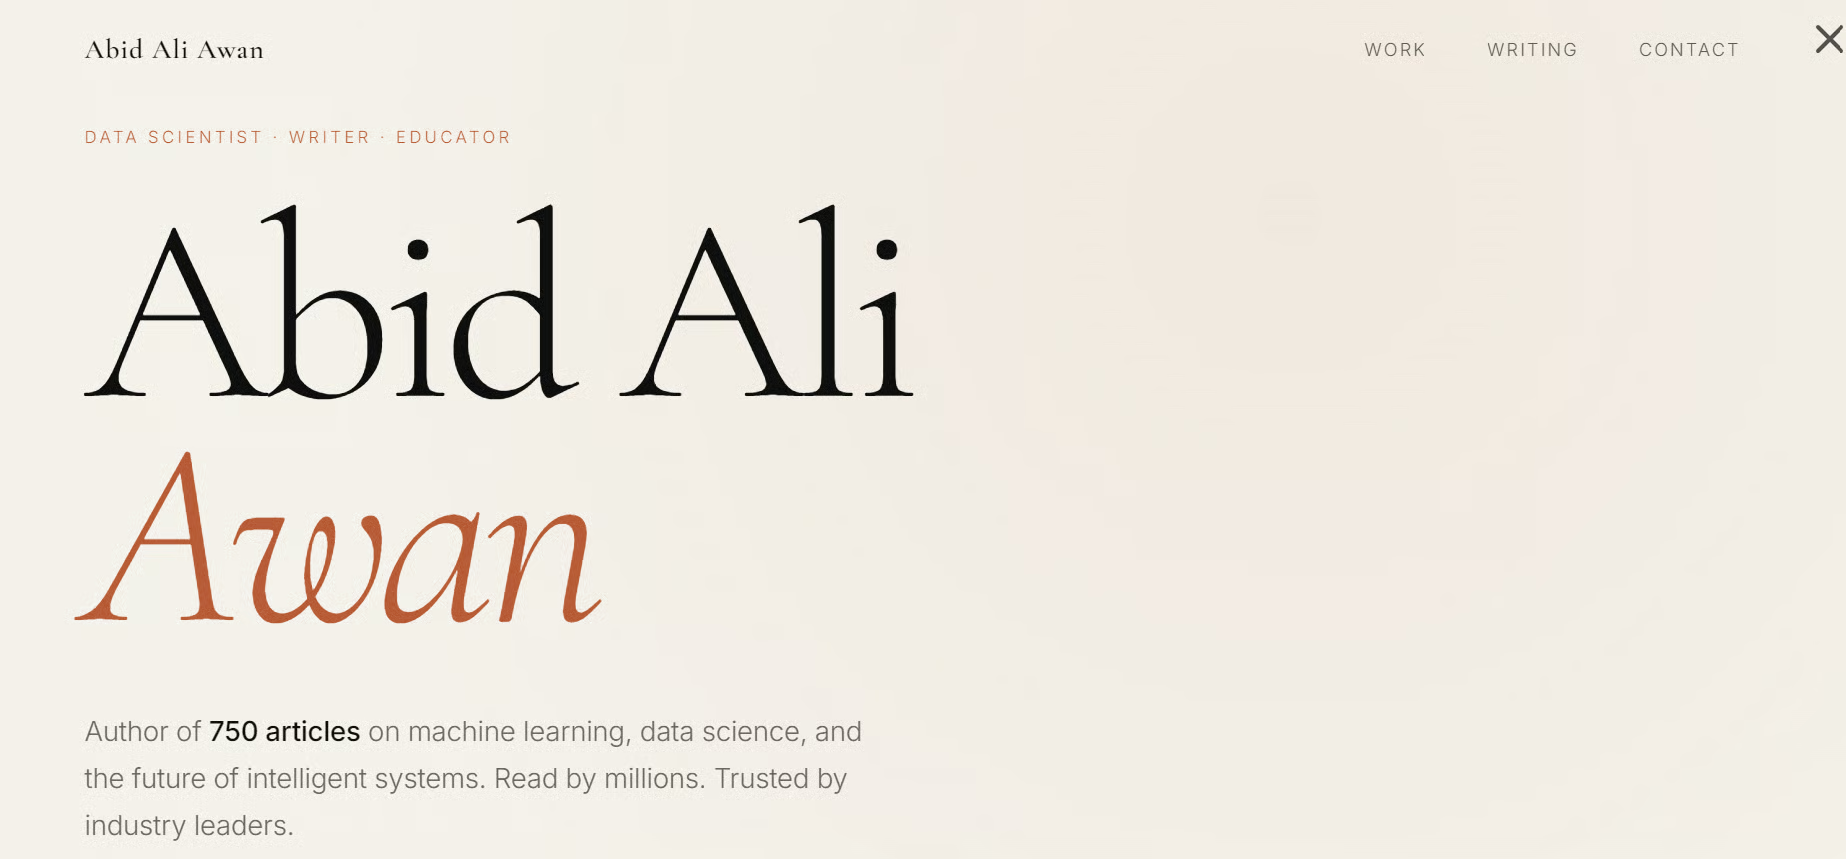
Depois, pedi para criar um site pessoal. Mesmo usando uma quantização bastante agressiva, o Inkling entregou um layout caprichado, interface limpa e código funcional para o site.
O Inkling não me impressionou nem no setup local nem no Playground online.
As respostas foram utilizáveis, porém medianas, e alguns modelos open source menores tiveram resultados melhores em tarefas semelhantes.
No entanto, o Inkling não foi pensado para dominar uma única categoria.
Ele é um modelo equilibrado e versátil, que combina habilidades de programação, escrita, raciocínio, multilinguismo, visão e áudio. Ele entrega um desempenho consistente em muitos benchmarks, em vez de liderar em uma área específica.
Para tarefas dedicadas de programação, pesquisa ou escrita, há alternativas mais fortes — open source e proprietárias.
O valor do Inkling está na flexibilidade: ele tem pesos abertos, é multimodal, personalizável e pode ser treinado ou ajustado via Tinker, a plataforma open source da Thinking Machines para treinamento e customização de modelos.
Este lançamento pode ter reduzido um pouco o hype inicial, mas também deixou mais clara a direção da empresa.
A Thinking Machines não parece competir apenas por scores máximos em benchmarks. Em vez disso, está construindo um ecossistema mais amplo, baseado em modelos adaptáveis que organizações podem ajustar e usar em diversas tarefas.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Zoumana Keita
11 min
Tutorial
Ryan Ong
12 min
Tutorial
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
12 min
Tutorial
Josep Ferrer
11 min