Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
11.7K
Thinking Machines Lab est une entreprise de recherche et de produits en IA fondée par Mira Murati, ancienne directrice technique d’OpenAI et, brièvement, sa CEO par intérim. Après avoir quitté OpenAI en septembre 2024, Murati a réuni une équipe de chercheurs expérimentés en IA et levé environ 2 milliards de dollars pour une valorisation de 12 milliards. L’ampleur des financements et des talents a alimenté de fortes attentes : Thinking Machines pourrait devenir un concurrent sérieux des grands laboratoires d’IA comme OpenAI.
Inkling est le premier grand modèle propriétaire de l’entreprise, et le premier d’une famille annoncée. Il s’agit d’un modèle multimodal à poids ouverts conçu pour le raisonnement, le code, l’utilisation d’outils et la personnalisation, offrant un premier aperçu clair de ce que Murati et son équipe développent.
Dans ce guide, je vous montre comment exécuter Inkling en local, en commençant par le tester via le Tinker Playground gratuit. Je vous explique ensuite comment télécharger une quantification GGUF Unsloth, compiler la branche expérimentale d’llama.cpp pour Inkling, exécuter le modèle sur quatre GPU NVIDIA RTX PRO 6000 et interagir avec lui via l’interface Web intégrée et l’API compatible OpenAI.
Inkling est un modèle multimodal généraliste à poids ouverts, développé par Thinking Machines Lab.
Il utilise une architecture Mixture-of-Experts avec 975 milliards de paramètres au total et 41 milliards de paramètres actifs, accepte des entrées texte, image et audio, et propose une fenêtre de contexte allant jusqu’à un million de tokens.
Le modèle est conçu pour le raisonnement, le code, l’utilisation d’outils, le suivi d’instructions et l’affinage sur différents domaines.
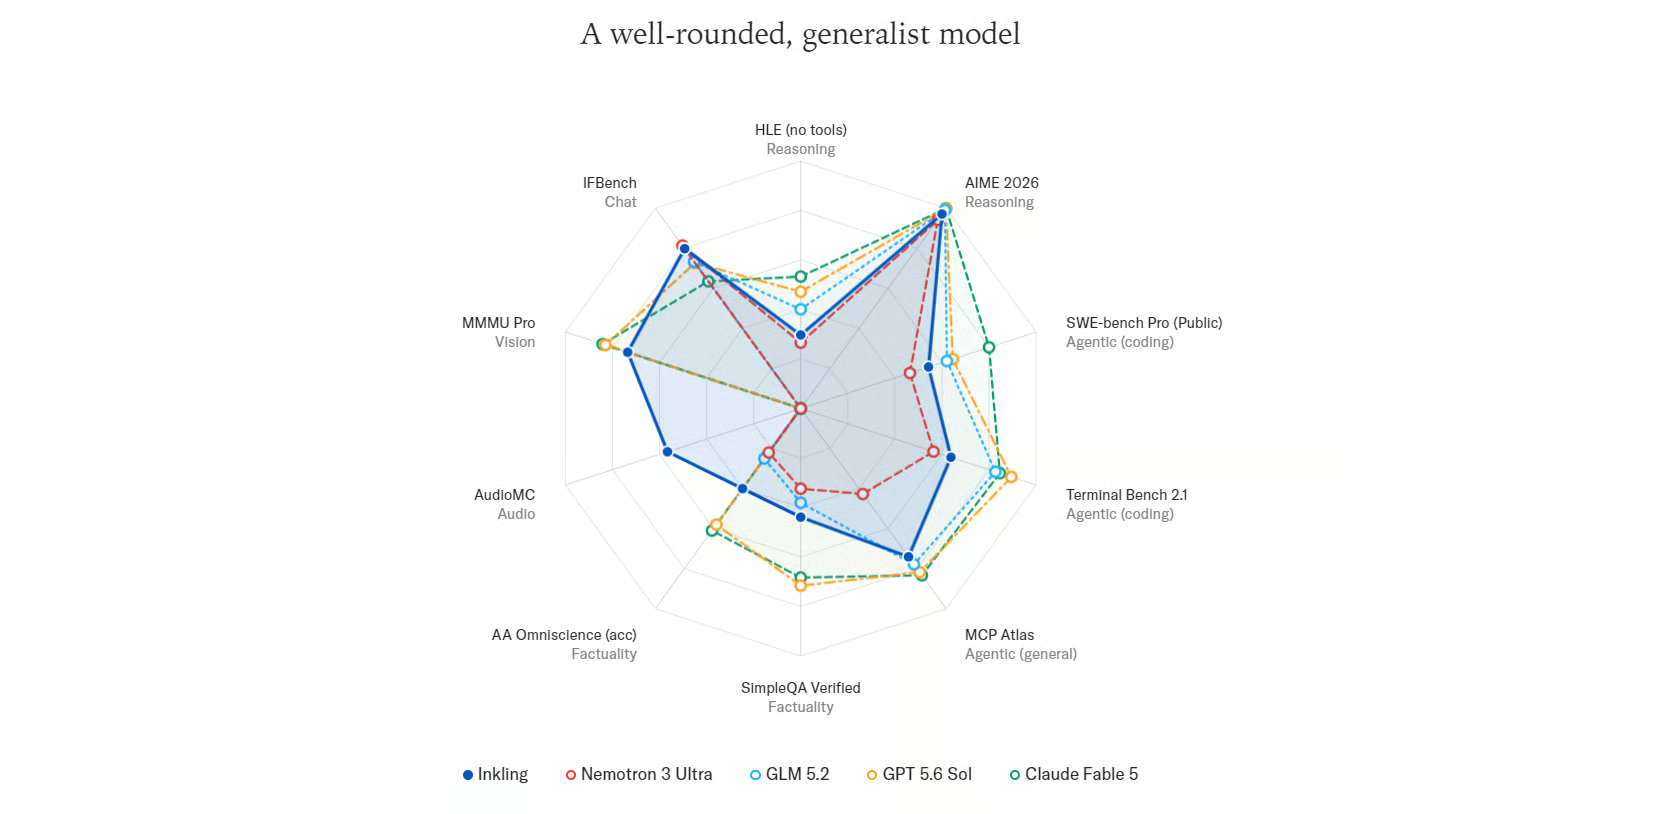
Source : Inkling - Thinking Machines Lab
Inkling est un bon généraliste, offrant des performances équilibrées sur les benchmarks de raisonnement, de code agentique, de factualité, de vision et d’audio.
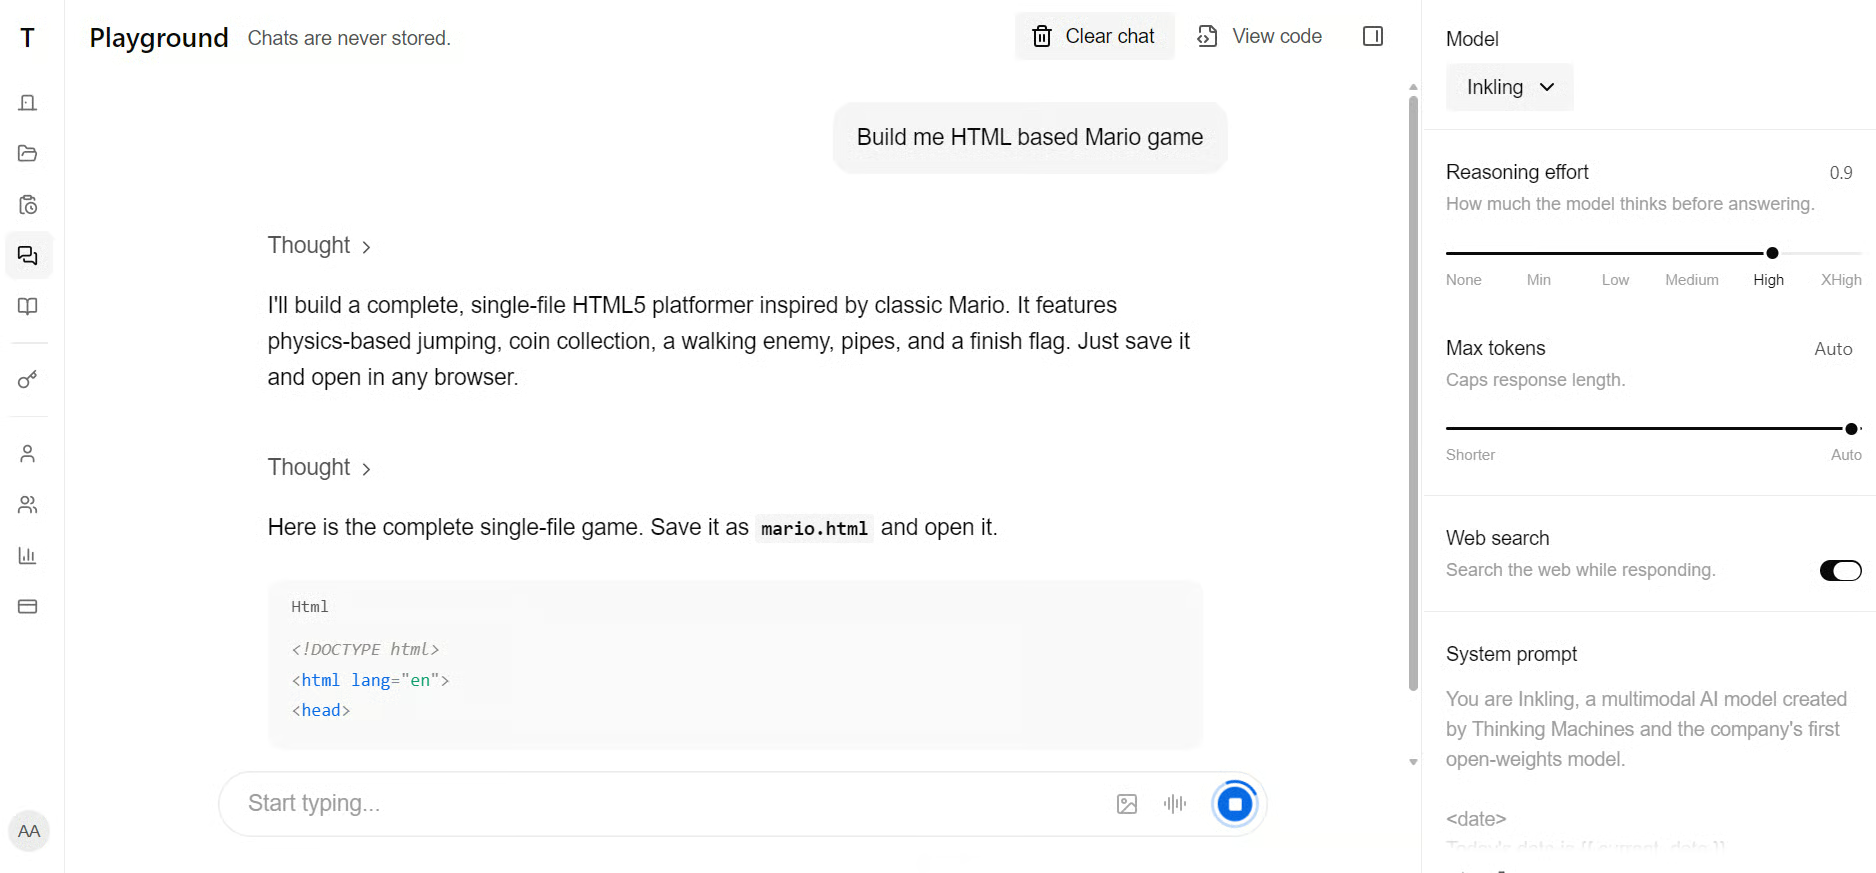
Avant de l’exécuter en local, essayez Inkling via le Inkling Playground pour explorer ses réponses et comprendre son fonctionnement. L’accès gratuit est proposé pour une durée limitée.
Exécuter Inkling en local requiert un matériel de niveau entreprise.
La quantification UD-Q4_K_XL d’Unsloth pèse environ 587 Go, tandis que le modèle en pleine précision BF16 requiert environ 1,89 To.
Cette mémoire peut provenir d’un ensemble RAM et VRAM, de mémoire unifiée ou de la seule RAM, bien que l’inférence sur CPU soit nettement plus lente.
Il faut également prévoir de la mémoire supplémentaire pour la fenêtre de contexte et les surcoûts à l’exécution.
Dans ce guide, nous utilisons la quantification UD-Q2_K_XL, plus légère (environ 317 Go), sur un serveur RunPod configuré comme suit :
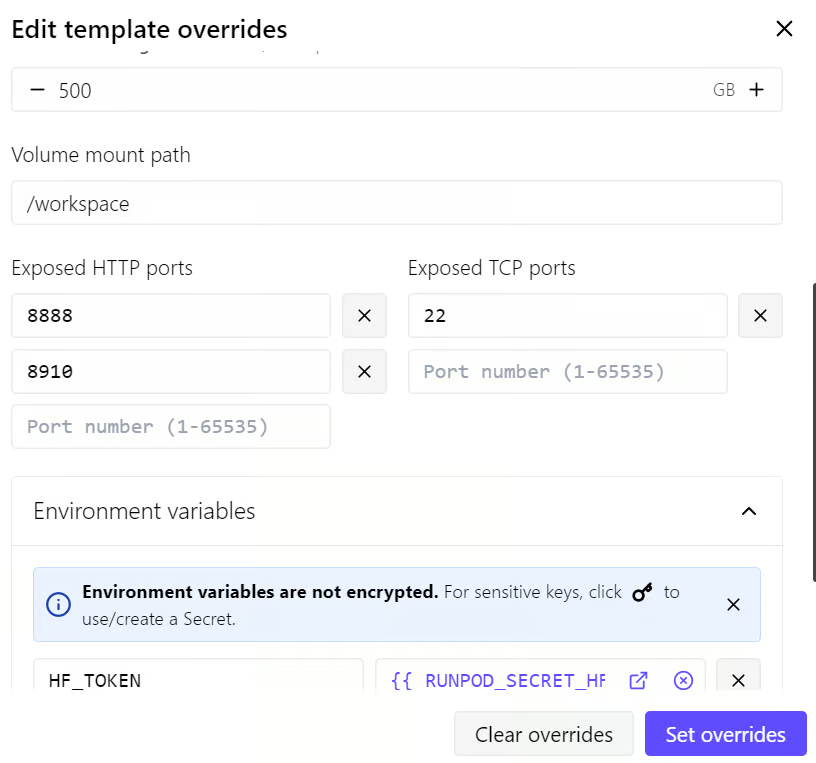
Les gros fichiers du modèle et le cache Hugging Face seront stockés sur le volume de 500 Go pour rester disponibles en cas de redémarrage du Pod.
Le disque conteneur de 100 Go sera utilisé pour les paquets système, les dépendances de build et autres besoins d’exécution.
Nous allons également configurer un jeton d’accès Hugging Face avant de télécharger Inkling.
Les téléchargements authentifiés évitent les limites de débit anonymes et offrent des vitesses plus rapides et plus fiables — un point clé pour un modèle de cette taille.
Les binaires standard de llama.cpp installés via la commande curl ne fonctionnent pas avec Inkling, car la prise en charge de son architecture n’a pas encore été fusionnée dans la branche principale.
Le support d’Inkling est actuellement disponible via la pull request expérimentale #25731, il faut donc compiler llama.cpp à partir de cette branche.
Après avoir déployé le Pod RunPod, ouvrez l’onglet Connect et cliquez sur le lien Jupyter Notebook.
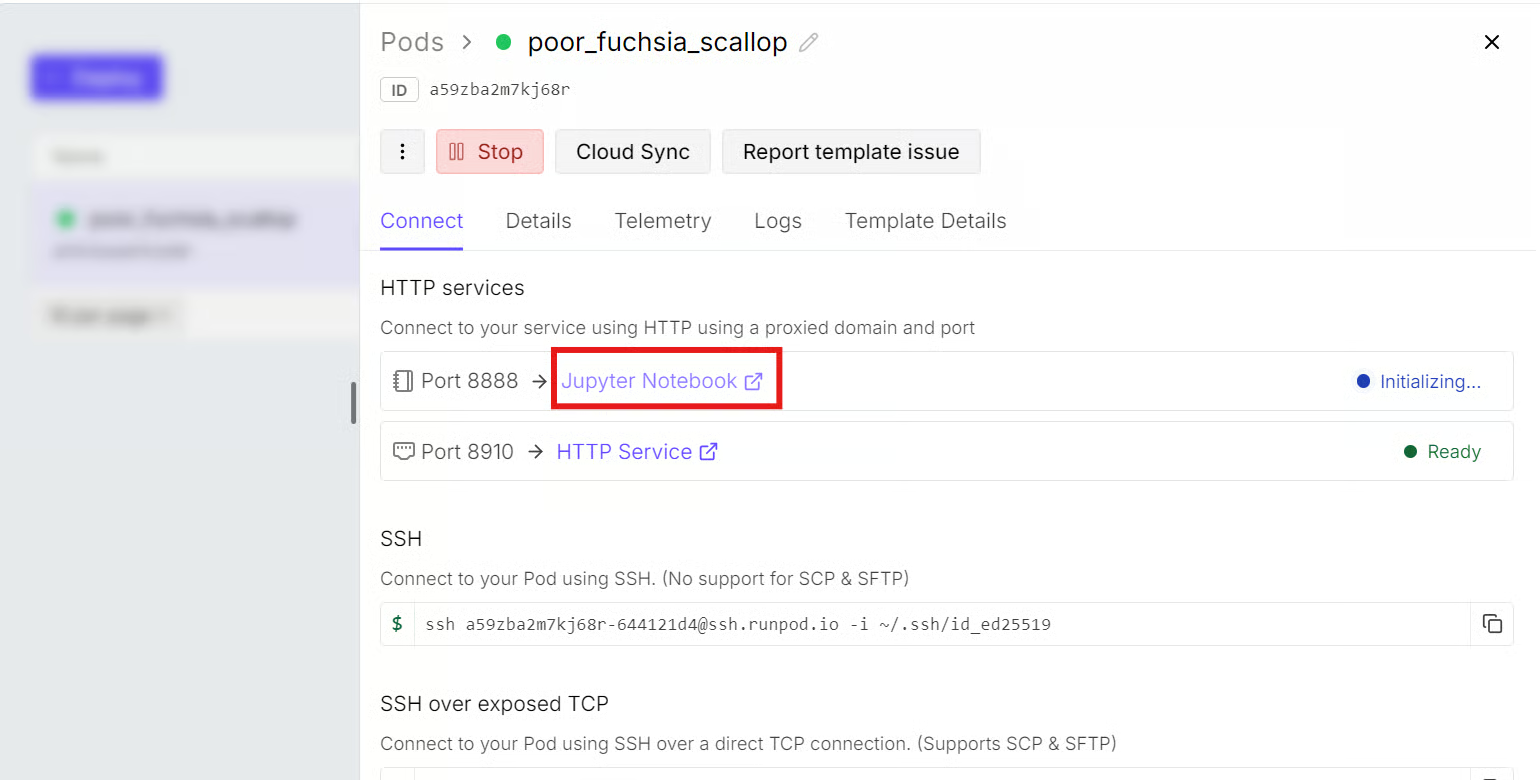
Depuis JupyterLab, lancez un nouveau terminal et installez les paquets système requis :
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Ensuite, clonez llama.cpp dans le volume /workspace et basculez sur la branche qui inclut le support d’Inkling :
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Le support d’Inkling est pour l’instant disponible via une pull request expérimentale en brouillon plutôt que dans la branche principale de llama.cpp. Récupérez et basculez sur cette branche :
git fetch origin pull/25731/head:inkling
git switch inkling
Compilez llama.cpp avec l’accélération CUDA activée :
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Compilez l’interface en ligne de commande, l’interface multimodale, le serveur et les utilitaires GGUF :
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"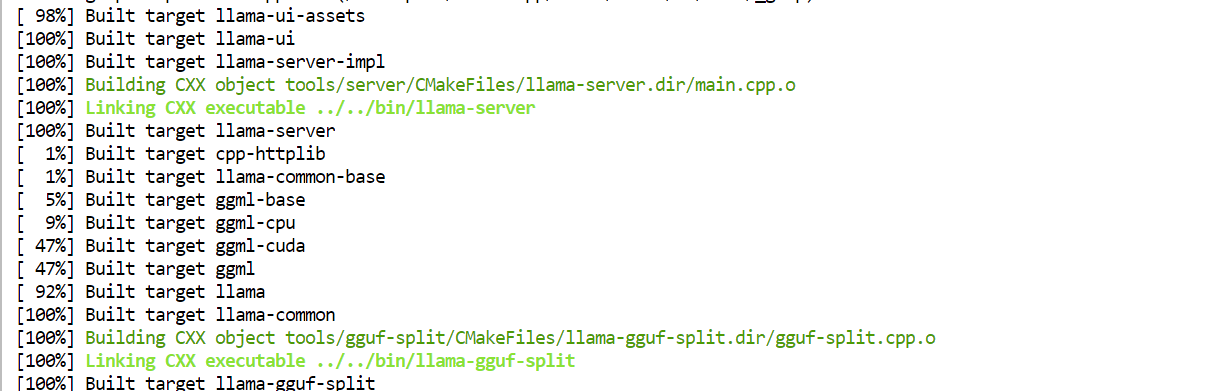
Enfin, copiez les exécutables compilés dans le répertoire principal de llama.cpp pour y accéder plus facilement :
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Installez la CLI Hugging Face et le support de téléchargement Xet :
pip install -U huggingface_hub hf_xetLe jeton Hugging Face a déjà été ajouté aux variables d’environnement du Pod RunPod lors du déploiement, aucune connexion supplémentaire n’est nécessaire.
Créez des répertoires sur le disque de 500 Go pour le cache Hugging Face et le modèle Inkling :
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Définissez l’emplacement du cache et activez les téléchargements haute performance :
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
Téléchargez uniquement la quantification UD-Q2_K_XL :
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
La durée du téléchargement dépendra de votre connexion.
Dans mon cas, le débit était limité à environ 130 Mo/s, et le téléchargement a pris environ 42 minutes.
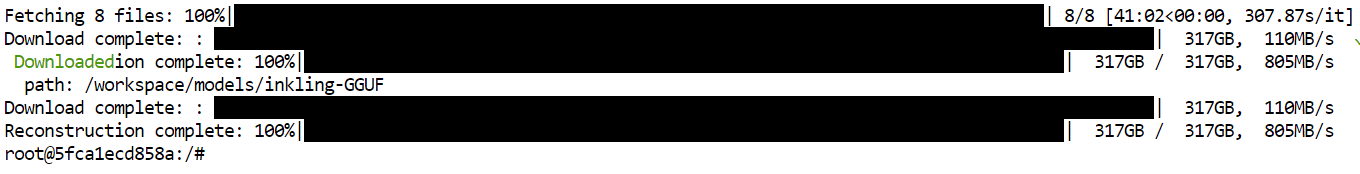
Exécutez la commande suivante pour charger Inkling sur les quatre GPU et lancer un serveur d’inférence compatible OpenAI :
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja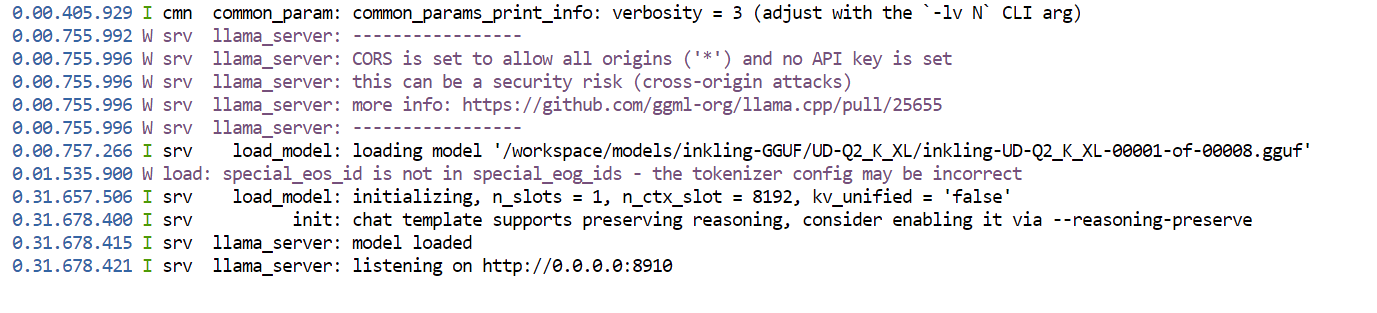
Cette commande :
llama.cpp détecte et charge automatiquement les sept autres.8910.Ouvrez un autre terminal Jupyter et vérifiez l’utilisation des GPU :
nvidia-smi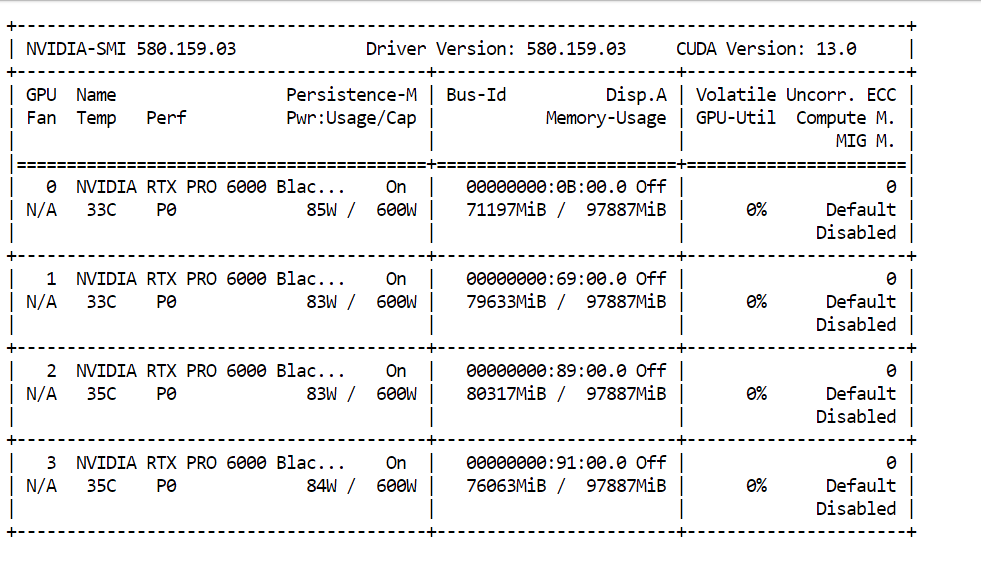
Dans cette configuration, environ 85 % de la mémoire GPU disponible est utilisée après le chargement du modèle avec une fenêtre de 8 192 tokens.
Des fenêtres de contexte plus grandes nécessitent davantage de mémoire de KV-cache ; exécuter Inkling avec, par exemple, 100 000 tokens demanderait beaucoup plus de mémoire disponible.
L’API locale compatible OpenAI est disponible à l’adresse :
http://127.0.0.1:8910/v1Avant de tester Inkling via l’UI Web, confirmez que le serveur d’inférence est actif et renvoie des réponses. Ouvrez un nouveau terminal et envoyez une requête de test à l’API locale :
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
L’API a répondu avec succès, en traitant le prompt à 81,1 tokens/s et en générant à 37,2 tokens/s.
La requête a utilisé 25 tokens de prompt et 256 tokens de complétion, mais s’est arrêtée en atteignant la limite de sortie avant la fin de la réponse. Augmenter max_tokens permet au modèle de terminer sa réponse.
Revenez au tableau de bord RunPod, ouvrez l’onglet Connect, puis cliquez sur le lien listé dans HTTP Services pour le port 8910.
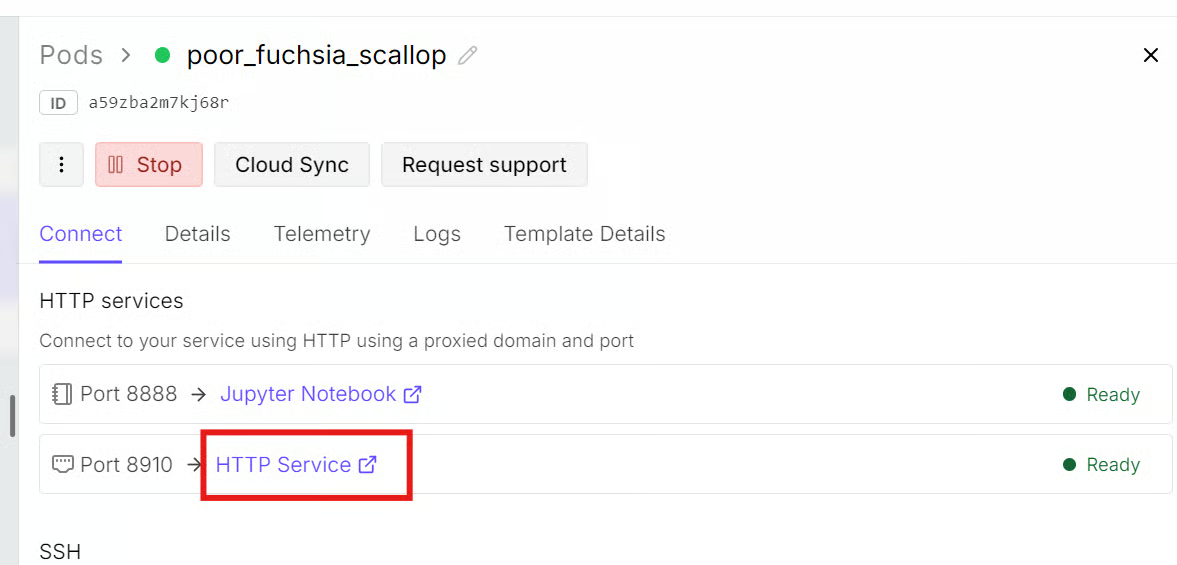
L’interface Web intégrée de llama.cpp propose une interface de type ChatGPT pour envoyer des prompts, ajuster les paramètres de génération et visualiser les réponses.
Le même serveur expose aussi une API compatible OpenAI pour connecter des applications et outils externes.
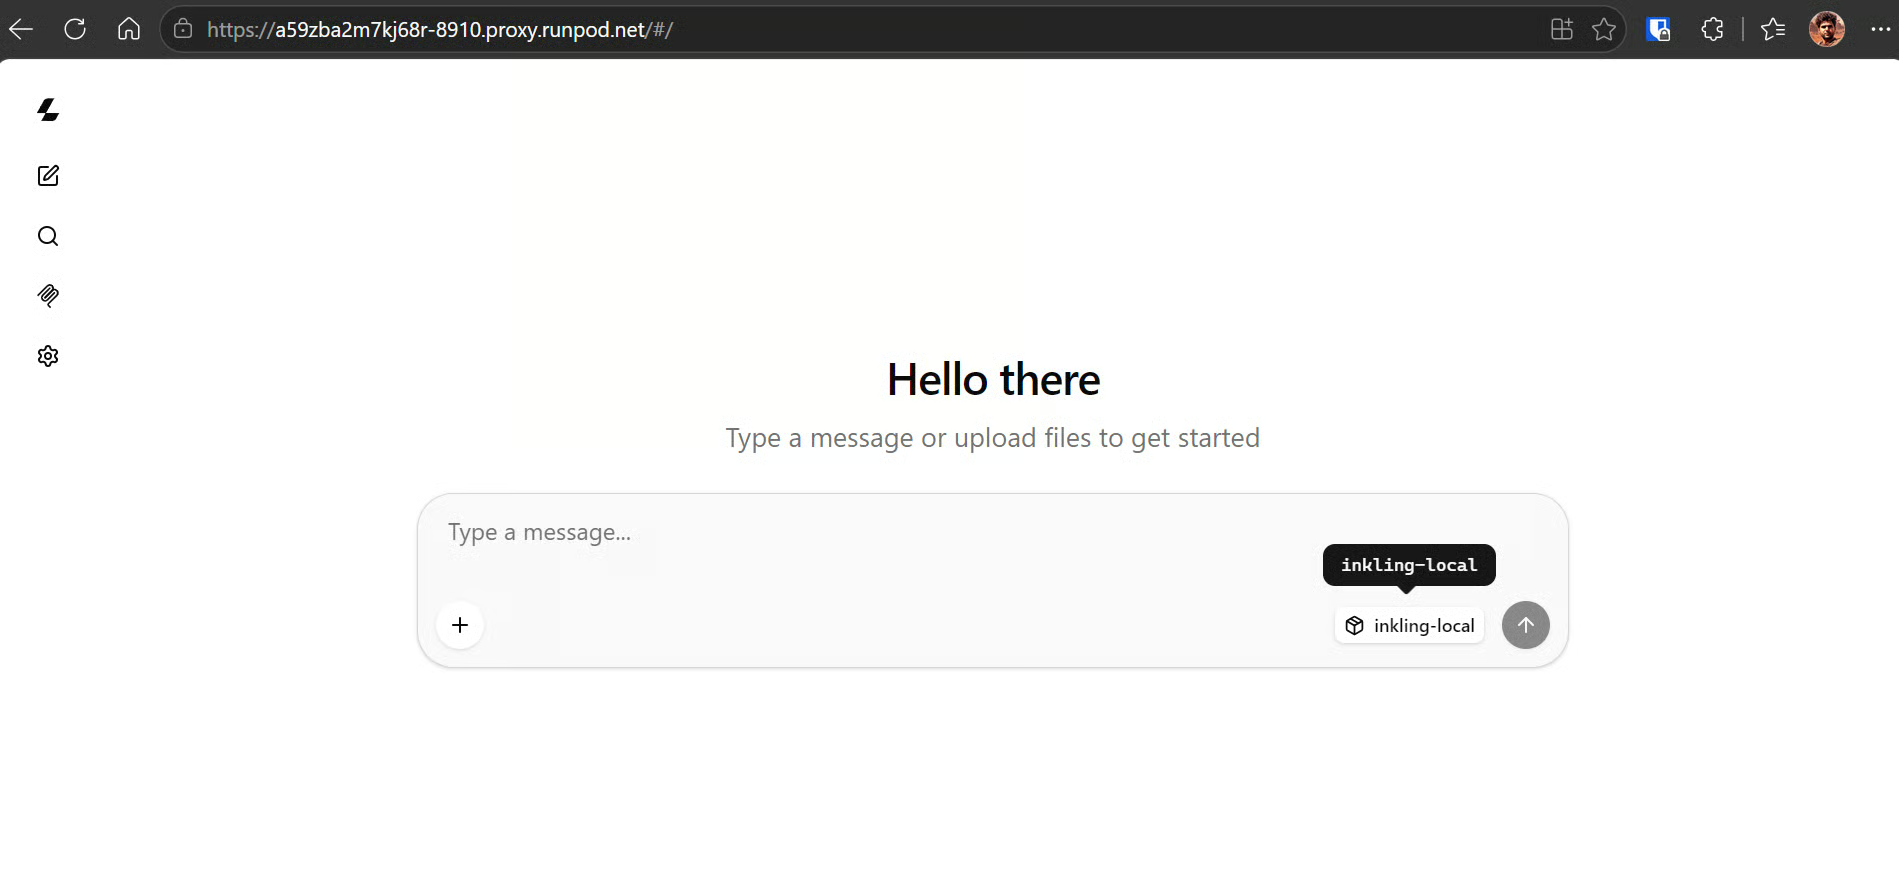
Commencez par un prompt de code :
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling a produit une explication complète et un code fonctionnel à une vitesse moyenne d’environ 37,5 tokens/s.
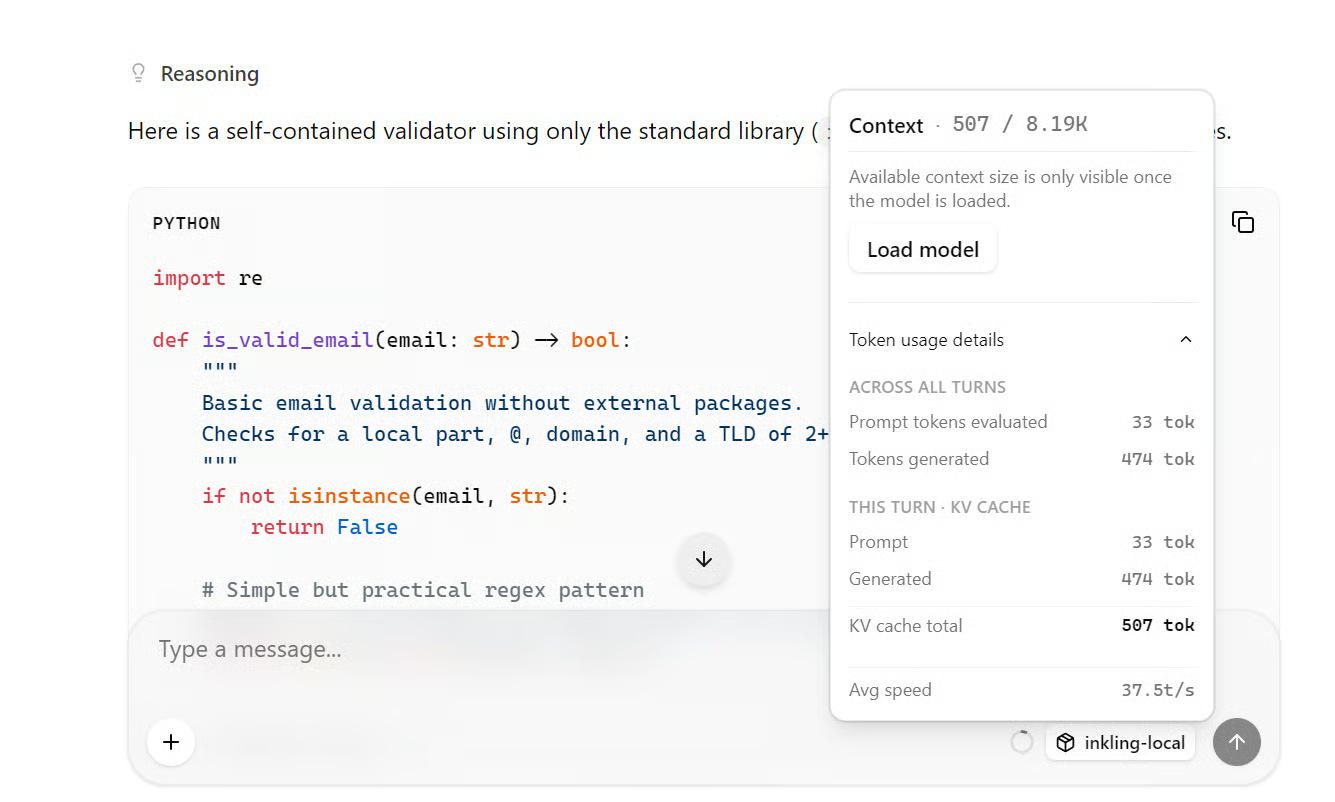
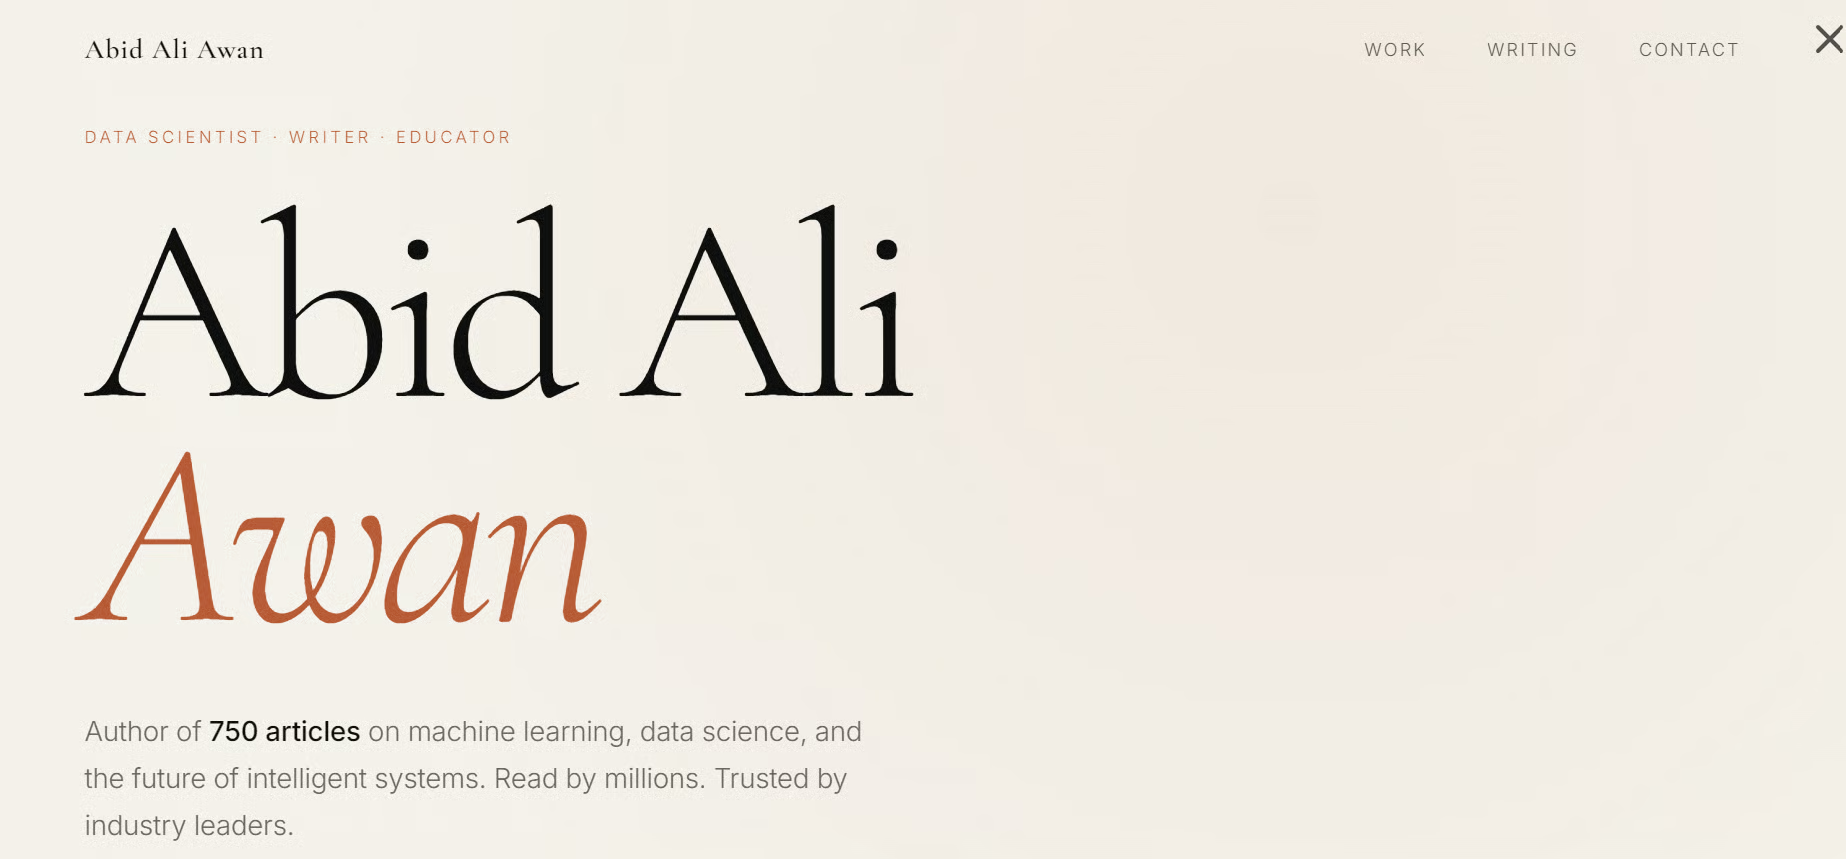
Ensuite, je lui ai demandé de créer un site personnel. Malgré une quantification très agressive, Inkling a proposé une mise en page soignée, une interface claire et un code de site fonctionnel.
Inkling ne m’a pas particulièrement impressionné, ni en local ni dans le Playground en ligne.
Les réponses étaient exploitables mais quelconques, et plusieurs modèles open source plus petits ont donné de meilleurs résultats sur des tâches similaires.
Cependant, Inkling n’a pas vocation à dominer une catégorie unique.
C’est un modèle généraliste équilibré qui combine code, rédaction, raisonnement, multilingue, vision et audio. Il offre des performances correctes sur de nombreux benchmarks, plutôt que de viser la première place sur un domaine précis.
Pour des besoins dédiés en code, recherche ou rédaction, il existe des alternatives open source et propriétaires plus performantes.
La valeur d’Inkling réside dans sa flexibilité : poids ouverts, multimodal, personnalisable, et entraînable ou ajustable via Tinker, la plateforme open source de Thinking Machines pour l’entraînement et la personnalisation de modèles.
Cette sortie a peut-être tempéré une partie du battage initial, mais elle a aussi clarifié l’orientation de l’entreprise.
Thinking Machines ne semble pas courir uniquement après les meilleurs scores de benchmark. L’entreprise bâtit plutôt un écosystème plus large autour de modèles adaptables que les organisations peuvent affiner et utiliser sur de multiples tâches.
Meilleures formations DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Adel Nehme
3 min
Tutoriel
Mark Pedigo
10 min