
Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
11.6K
Thinking Machines Lab ist ein KI-Forschungs- und Produktunternehmen, gegründet von Mira Murati, der ehemaligen Chief Technology Officer von OpenAI und kurzzeitig Interims-CEO. Nach ihrem Weggang von OpenAI im September 2024 stellte Murati ein Team erfahrener KI-Forschender zusammen und sammelte rund 2 Milliarden US-Dollar bei einer Bewertung von 12 Milliarden US-Dollar ein. Umfang und Qualität von Finanzierung und Talent weckten hohe Erwartungen, dass Thinking Machines ein ernstzunehmender Wettbewerber für etablierte KI-Labore wie OpenAI werden könnte.
Inkling ist das erste große hauseigene Modell und der Auftakt einer geplanten Modellfamilie. Es handelt sich um ein Open-Weights-Multimodalmodell für Reasoning, Coding, Toolnutzung und Anpassung – und bietet damit den ersten klaren Blick darauf, woran Murati und ihr Team gearbeitet haben.
In diesem Leitfaden zeige ich dir, wie du Inkling lokal ausführen kannst – zuerst per Test im kostenlosen Tinker Playground. Anschließend erkläre ich, wie du eine Unsloth-GGUF-Quantisierung herunterlädst, den experimentellen Inkling-Branch von llama.cpp baust, das Modell über vier NVIDIA RTX PRO 6000 GPUs betreibst und über die integrierte Weboberfläche sowie eine OpenAI-kompatible API damit interagierst.
Inkling ist ein Open-Weights-Universalmultimodalmodell von Thinking Machines Lab.
Es nutzt eine Mixture-of-Experts-Architektur mit insgesamt 975 Milliarden Parametern und 41 Milliarden aktiven Parametern, unterstützt Text-, Bild- und Audioeingaben und bietet ein Kontextfenster von bis zu einer Million Tokens.
Das Modell ist ausgelegt auf Reasoning, Coding, Toolnutzung, das Befolgen von Anweisungen und Fine-Tuning über verschiedene Domänen.
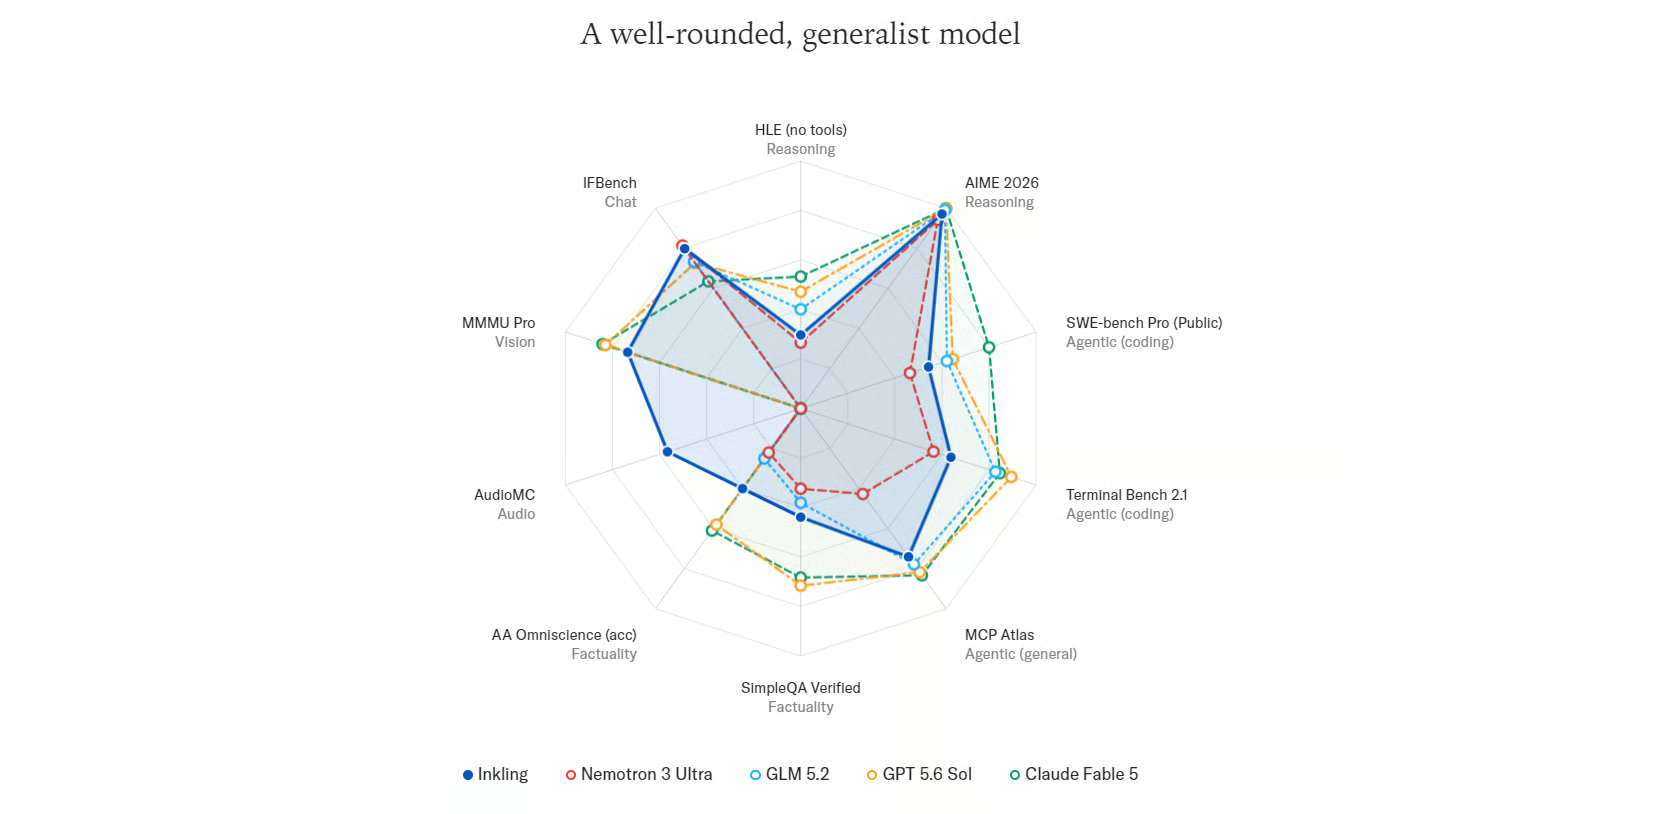
Quelle: Inkling - Thinking Machines Lab
Inkling ist ein ausgewogenes Generalistenmodell, das in Reasoning, agentischem Coding, Faktentreue sowie Vision- und Audio-Benchmarks solide Ergebnisse liefert.
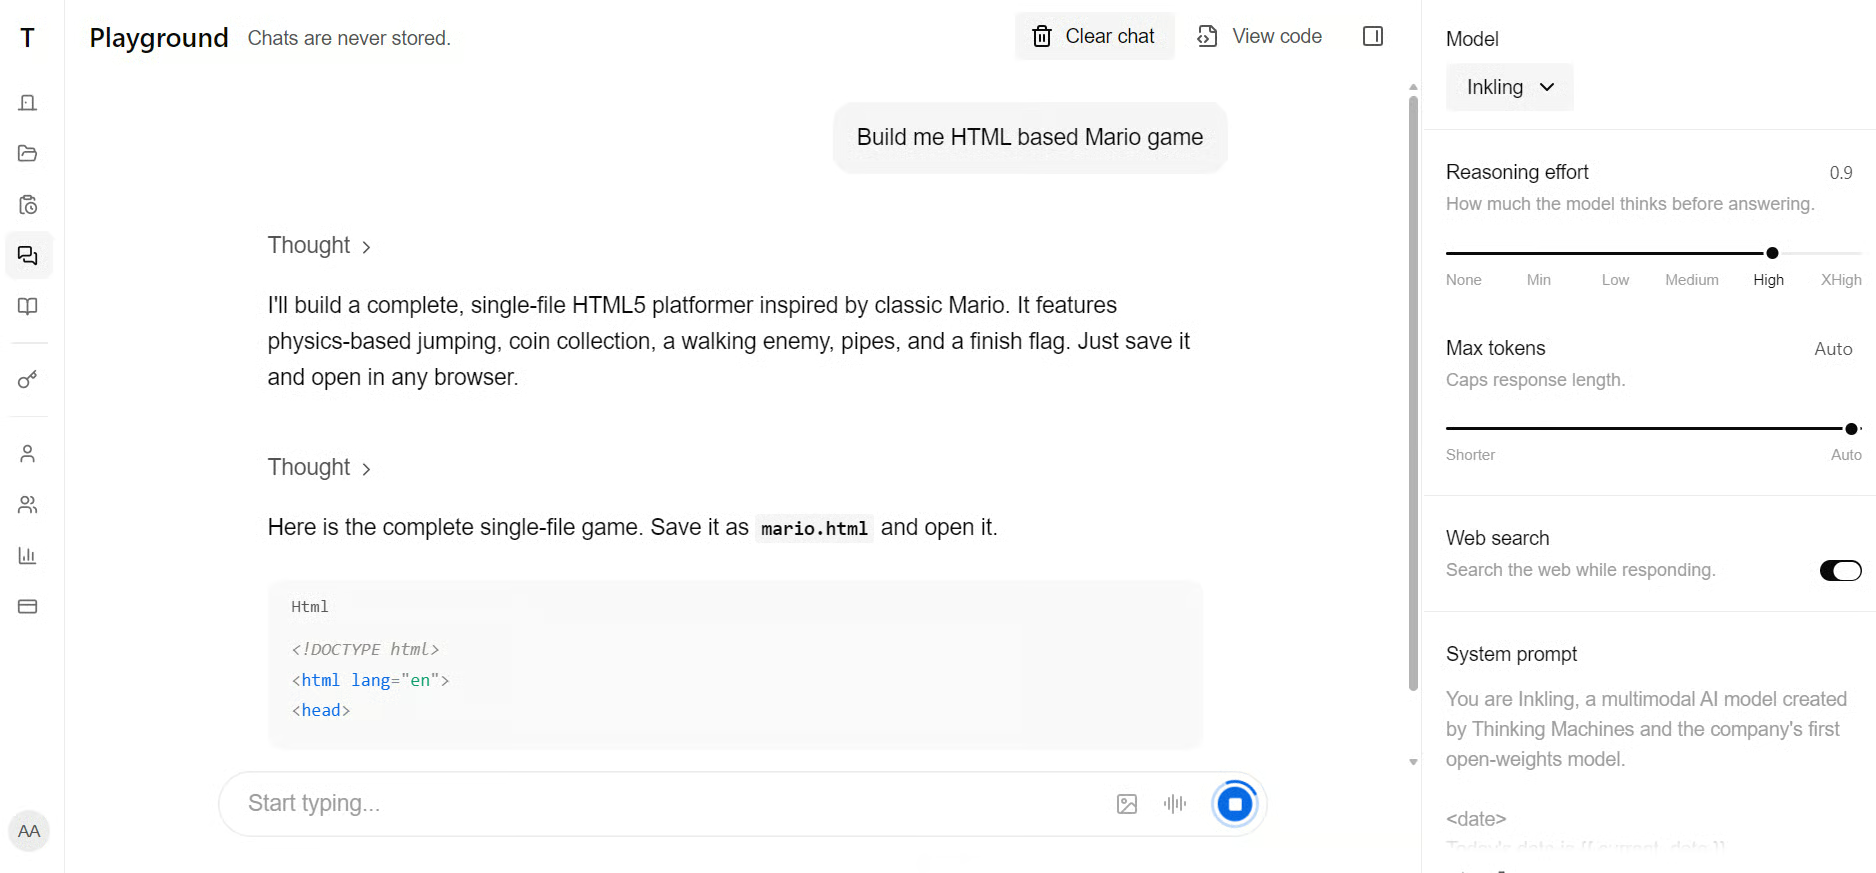
Bevor du Inkling lokal startest, probiere es im Inkling Playground aus, um die Antworten zu erkunden und das Modellverhalten zu verstehen. Derzeit ist der Zugang für kurze Zeit kostenlos.
Inkling lokal auszuführen erfordert Hardware auf Enterprise-Niveau.
Unsloths UD-Q4_K_XL-Quantisierung ist etwa 587 GB groß, während das vollpräzise BF16-Modell rund 1,89 TB benötigt.
Dieser Speicher kann aus kombiniertem RAM und VRAM, Unified Memory oder reinem RAM stammen – wobei reine CPU-Inferenz deutlich langsamer ist.
Zusätzlicher Speicher wird für das Kontextfenster und Laufzeit-Overhead benötigt.
Für diesen Leitfaden nutzen wir die kleinere UD-Q2_K_XL-Quantisierung mit etwa 317 GB auf einem RunPod-Server mit folgender Konfiguration:
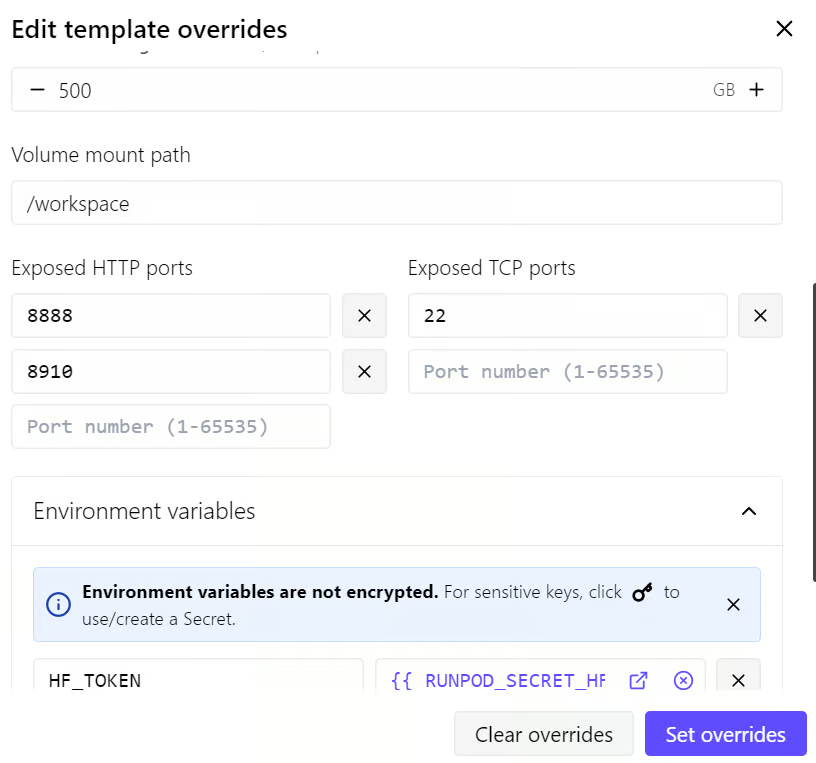
Die großen Modelldateien und der Hugging Face-Cache werden auf der 500 GB-Volume-Disk gespeichert, damit sie nach einem Neustart des Pods erhalten bleiben.
Die 100 GB Container-Disk nutzen wir für Systempakete, Build-Abhängigkeiten und weitere Laufzeitanforderungen.
Wir richten außerdem vor dem Download von Inkling ein Hugging Face-Zugriffstoken ein.
Authentifizierte Downloads helfen, anonyme Ratenlimits zu vermeiden, und können schnellere, stabilere Übertragungen ermöglichen – wichtig bei einem Modell dieser Größe.
Die Standard-Binaries von llama.cpp, die du per curl installierst, funktionieren mit Inkling nicht, da die Unterstützung für dessen Architektur noch nicht in den Main-Branch gemergt wurde.
Inkling-Support ist derzeit über den experimentellen Pull Request #25731 verfügbar, daher muss llama.cpp aus diesem Branch kompiliert werden.
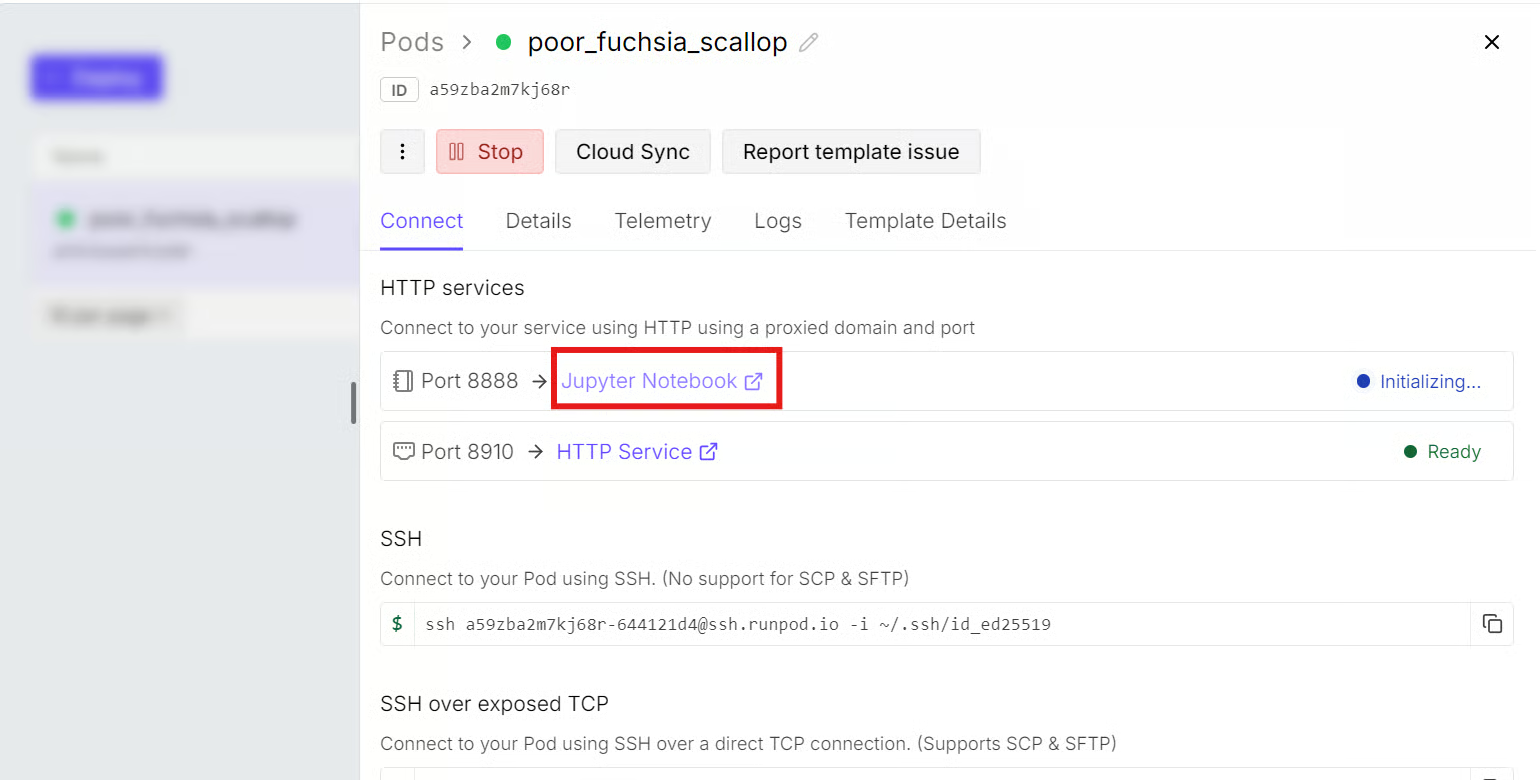
Öffne nach dem Bereitstellen des RunPod-Pods den Tab Connect und klicke auf den Link Jupyter Notebook.
Starte in JupyterLab ein neues Terminal und installiere die benötigten Systempakete:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Klonen anschließend llama.cpp ins /workspace-Volume und wechsle in den Branch mit Inkling-Support:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Inkling-Unterstützung ist derzeit in einem experimentellen Draft-Pull-Request statt im Hauptbranch von llama.cpp verfügbar. Hole dir diesen Branch und wechsle hinein:
git fetch origin pull/25731/head:inkling
git switch inkling
Baue llama.cpp mit aktivierter CUDA-Beschleunigung:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Kompiliere die Kommandozeilen-Tools, das Multimodal-Interface, den Server und die GGUF-Utilities:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"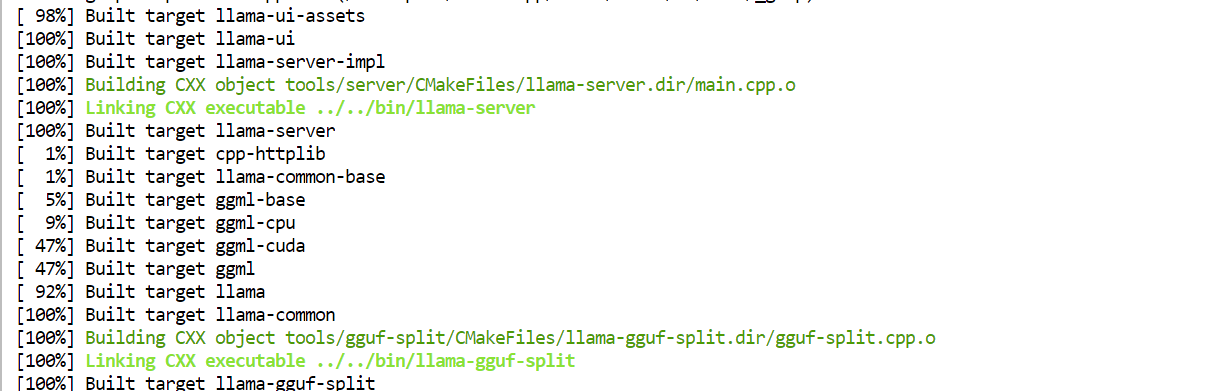
Kopiere zum Schluss die kompilierten Executables in das Hauptverzeichnis von llama.cpp, um sie leichter aufzurufen:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Installiere die Hugging Face CLI und Xet-Download-Unterstützung:
pip install -U huggingface_hub hf_xetDas Hugging Face-Token wurde beim Bereitstellen des Pods bereits als Umgebungsvariable in RunPod hinterlegt, daher ist kein zusätzlicher Login nötig.
Lege Verzeichnisse auf der 500 GB-Volume-Disk für den Hugging Face-Cache und das Inkling-Modell an:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Setze den Cache-Speicherort und aktiviere performante Downloads:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
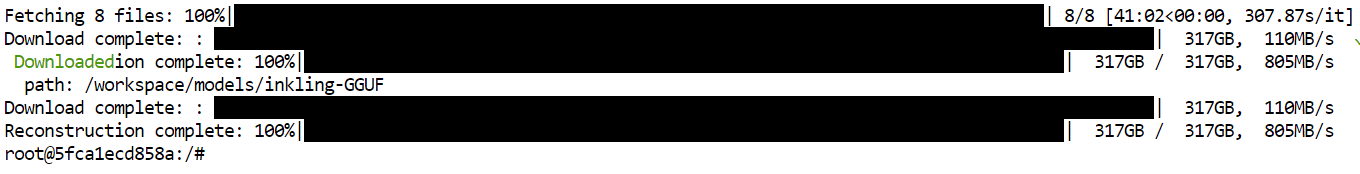
Lade ausschließlich die UD-Q2_K_XL-Quantisierung herunter:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
Die Downloadzeit hängt von deiner Internetverbindung ab.
Bei mir war die Geschwindigkeit auf etwa 130 MB/s begrenzt, der Download dauerte rund 42 Minuten.
Führe folgenden Befehl aus, um Inkling über alle vier GPUs zu laden und einen OpenAI-kompatiblen Inferenzserver zu starten:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja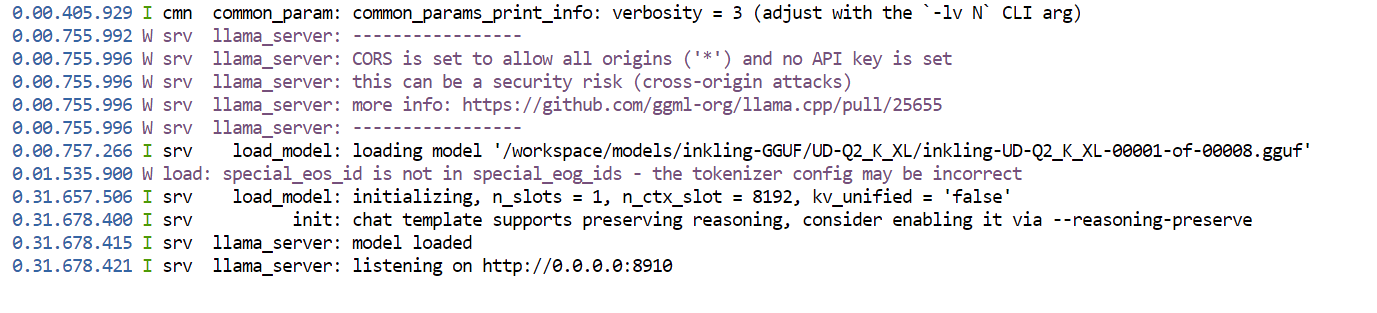
Der Befehl:
llama.cpp erkennt und lädt die weiteren sieben automatisch.8910.Öffne ein weiteres Jupyter-Terminal und prüfe die GPU-Auslastung:
nvidia-smi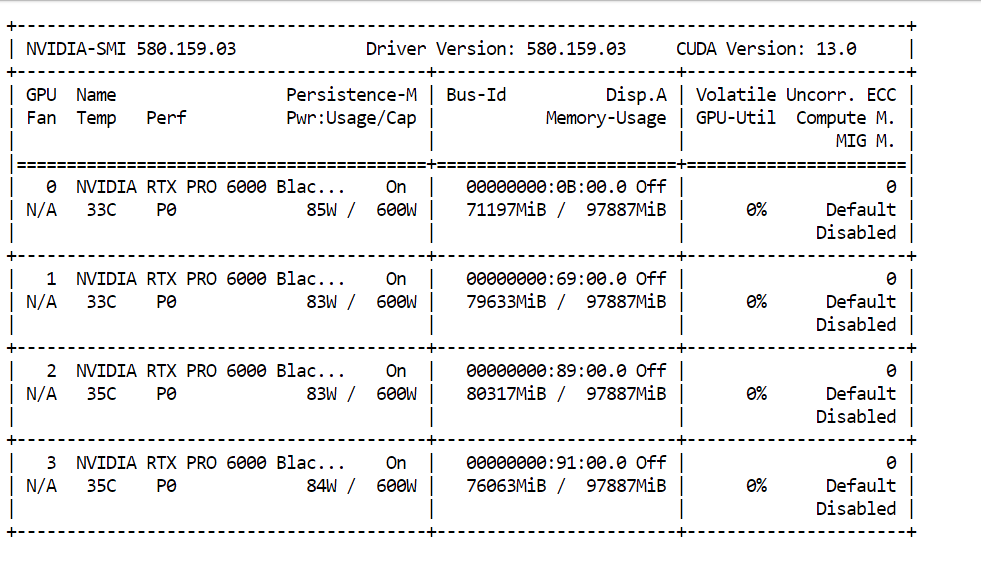
In diesem Setup wurden nach dem Laden mit einem 8.192-Token-Kontextfenster rund 85 % des verfügbaren GPU-Speichers genutzt.
Größere Kontextfenster benötigen zusätzliche KV-Cache-Speicher. Ein Kontext von etwa 100.000 Tokens würde daher deutlich mehr freien Speicher erfordern.
Die lokale OpenAI-kompatible API ist verfügbar unter:
http://127.0.0.1:8910/v1Bevor du die Weboberfläche testest, prüfe zunächst, ob der Inferenzserver läuft und Antworten liefert. Öffne ein neues Terminal und sende eine Testanfrage an die lokale API:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
Die API antwortete erfolgreich, verarbeitete den Prompt mit 81,1 Tokens pro Sekunde und generierte mit 37,2 Tokens pro Sekunde.
Es wurden 25 Prompt-Tokens und 256 Completion-Tokens genutzt, die Ausgabe stoppte jedoch am Limit, bevor die finale Antwort fertiggestellt wurde. Durch Erhöhen von max_tokens kann das Modell die Antwort vollständig abschließen.
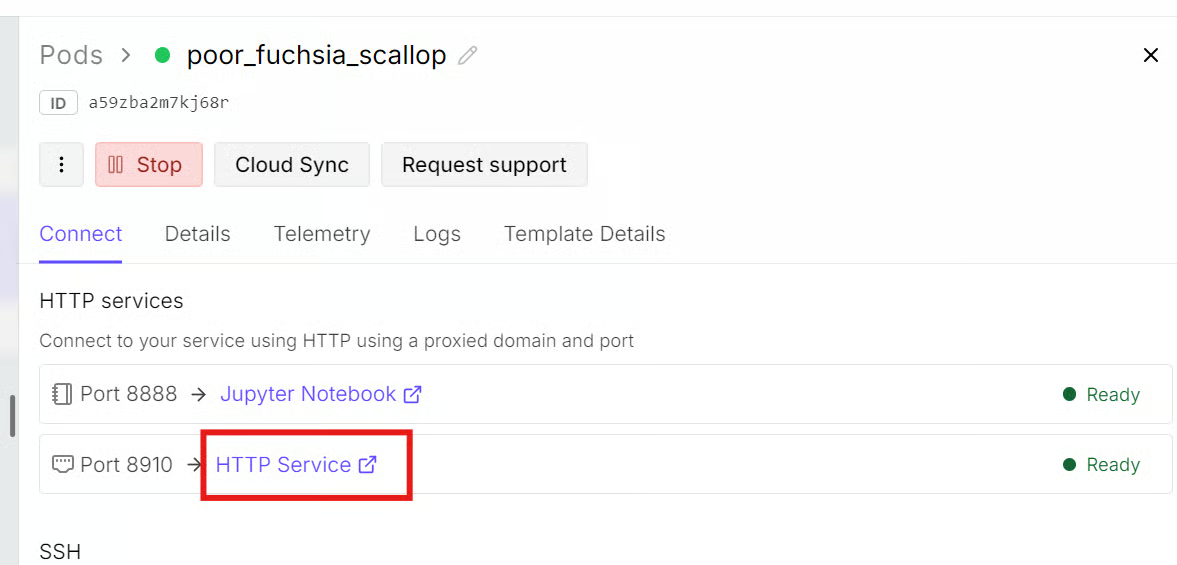
Wechsle zurück ins RunPod-Dashboard, öffne den Tab Connect und klicke auf den Link unter HTTP Services für Port 8910.
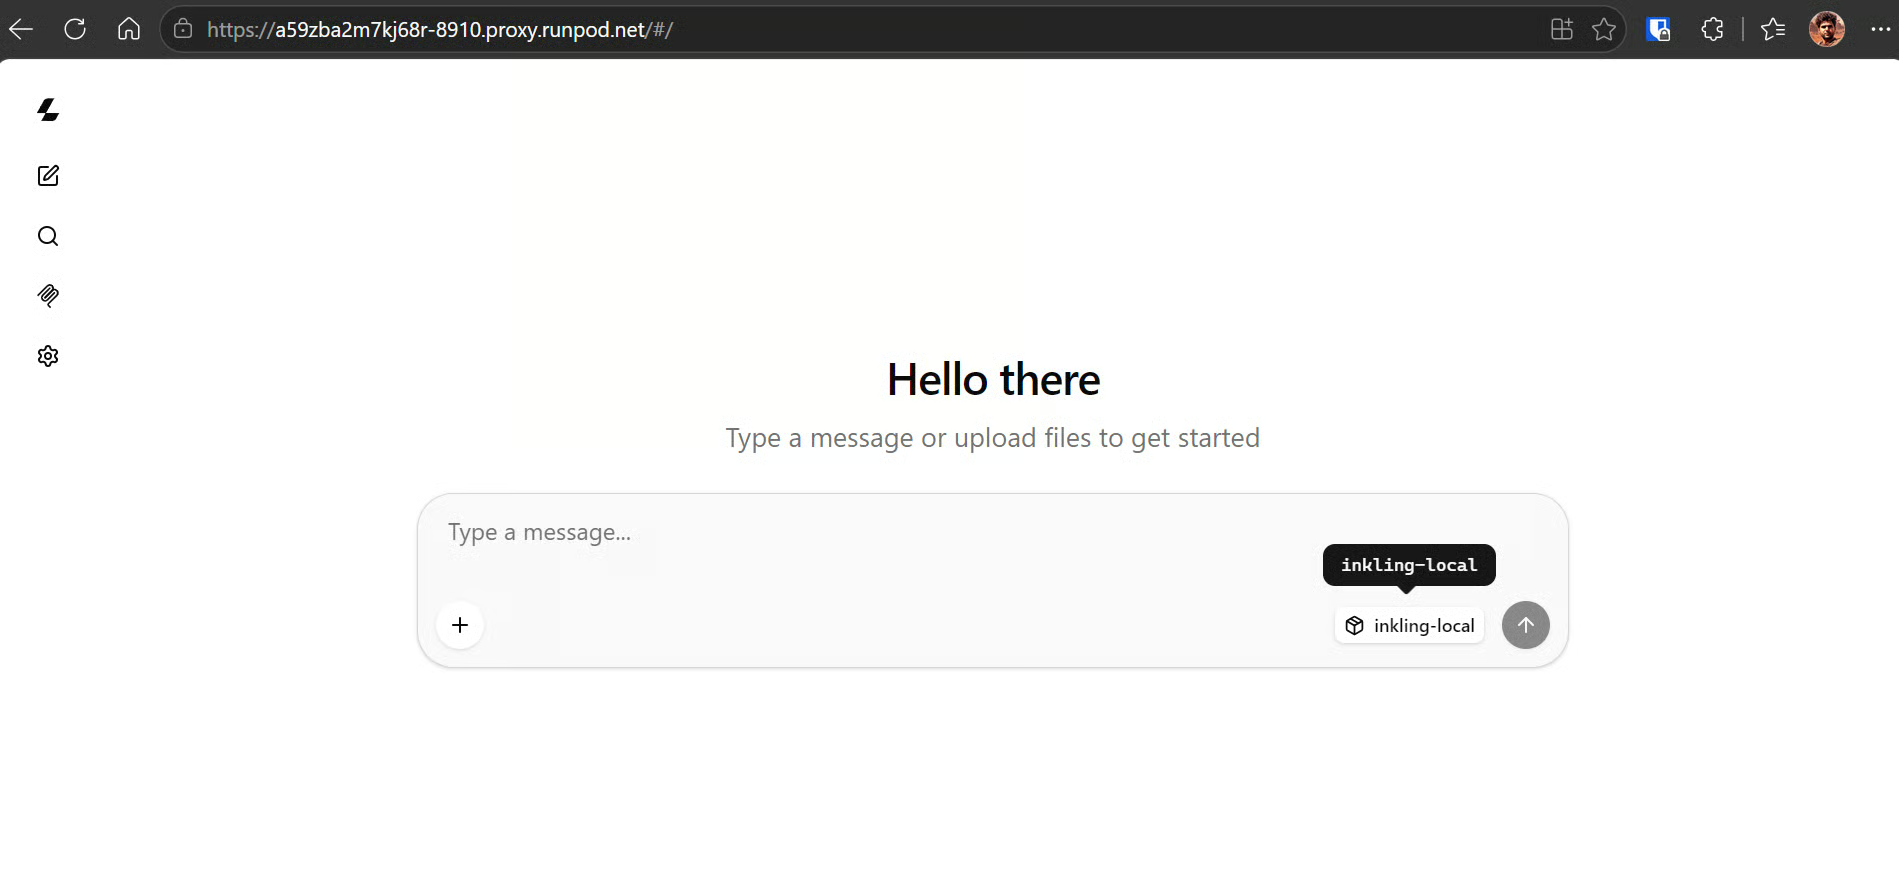
Die integrierte llama.cpp Web-UI bietet eine einfache ChatGPT-ähnliche Oberfläche zum Senden von Prompts, Anpassen der Generierungseinstellungen und Anzeigen der Antworten.
Der gleiche Server stellt zudem eine OpenAI-kompatible API bereit, um externe Anwendungen und Tools anzubinden.
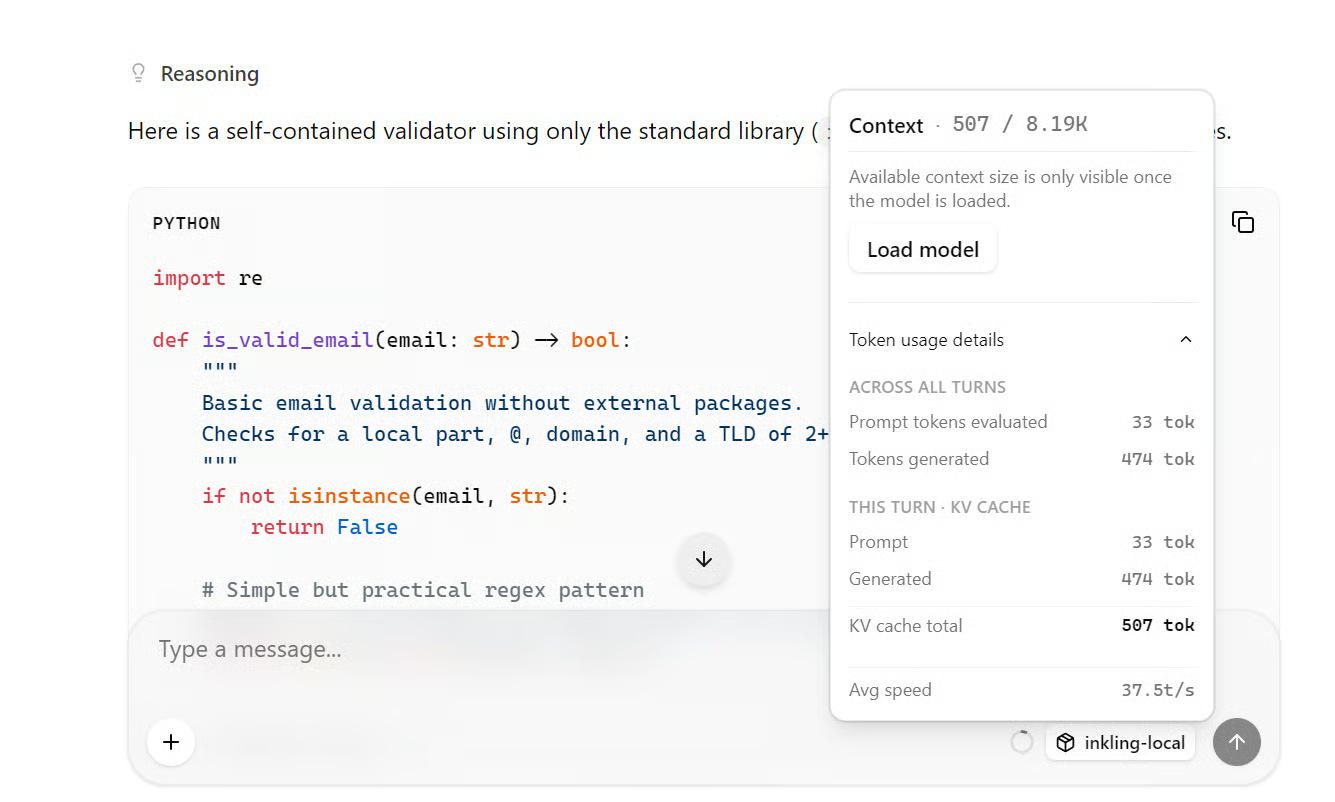
Starte mit einem Coding-Prompt:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling erzeugte eine vollständige Erklärung und lauffähigen Code mit einer durchschnittlichen Geschwindigkeit von etwa 37,5 Tokens pro Sekunde.
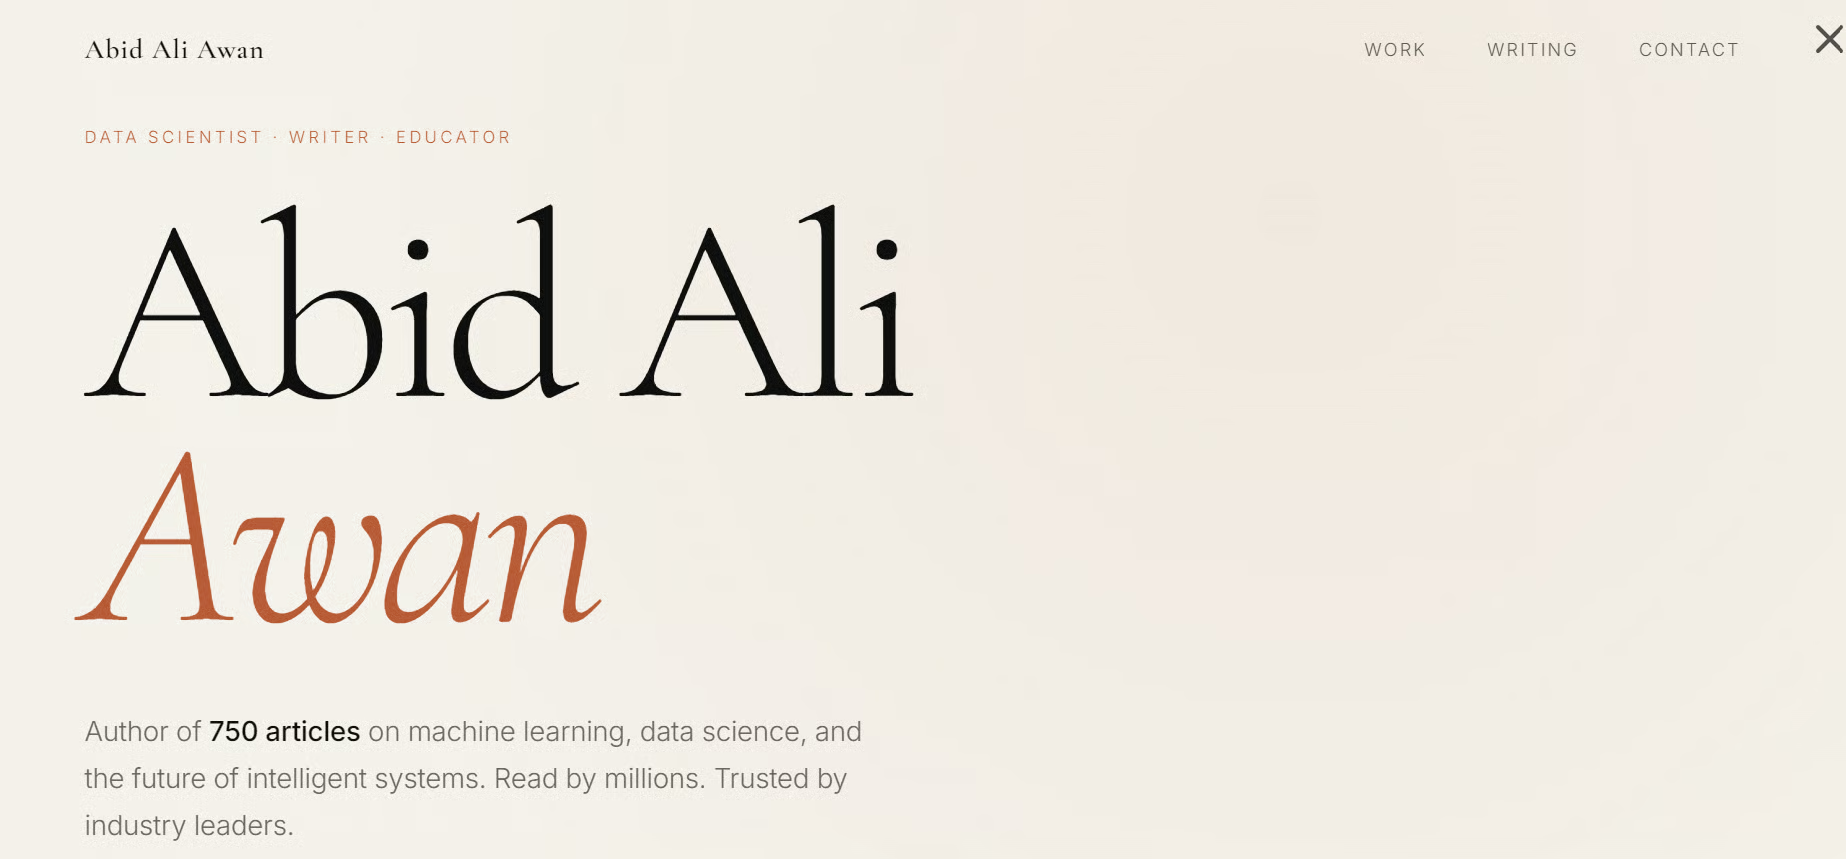
Als Nächstes bat ich es, eine persönliche Website zu erstellen. Trotz der starken Quantisierung lieferte Inkling ein sauberes Layout, eine aufgeräumte Oberfläche und funktionierenden Website-Code.
Inkling hat mich weder im lokalen Setup noch im Online-Playground wirklich beeindruckt.
Die Antworten waren brauchbar, aber mittelmäßig – mehrere kleinere Open-Source-Modelle lieferten für ähnliche Aufgaben bessere Ergebnisse.
Allerdings ist Inkling nicht darauf ausgelegt, eine einzelne Kategorie zu dominieren.
Es ist ein ausgewogenes Allzweckmodell, das Coding, Schreiben, Reasoning, Mehrsprachigkeit sowie Vision- und Audiokompetenzen kombiniert. Es liefert in vielen Benchmarks solide Leistungen, statt in einem Bereich die Führung zu übernehmen.
Für reine Coding-, Research- oder Schreibaufgaben gibt es stärkere Open-Source- wie auch Closed-Source-Alternativen.
Der Wert von Inkling liegt in der Flexibilität: Es ist Open-Weight, multimodal, anpassbar und kann über Tinker, die Open-Source-Plattform von Thinking Machines für Modelltraining und -anpassung, trainiert oder feinabgestimmt werden.
Diese Veröffentlichung hat den anfänglichen Hype vielleicht etwas relativiert, aber auch die Richtung des Unternehmens klarer gemacht.
Thinking Machines scheint nicht nur um die höchsten Benchmarkwerte zu konkurrieren, sondern baut ein breiteres Ökosystem rund um anpassbare Modelle auf, die Unternehmen für viele unterschiedliche Aufgaben feinabstimmen und einsetzen können.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Adel Nehme
3 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Matt Crabtree
5 Min.




