
Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
11.7K
Thinking Machines Lab adalah perusahaan riset dan produk AI yang didirikan oleh Mira Murati, mantan Chief Technology Officer OpenAI dan sempat menjabat sebagai CEO interim. Setelah meninggalkan OpenAI pada September 2024, Murati membentuk tim peneliti AI berpengalaman dan menghimpun pendanaan sekitar $2 miliar dengan valuasi $12 miliar. Skala pendanaan dan talenta tersebut memunculkan ekspektasi kuat bahwa Thinking Machines dapat menjadi pesaing serius bagi lab AI mapan seperti OpenAI.
Inkling adalah rilis model in-house utama pertama perusahaan dan model pertama dalam keluarga yang direncanakan. Ini adalah model multimodal open-weights yang dirancang untuk penalaran, pengodean, penggunaan alat, dan kustomisasi, memberikan gambaran pertama yang jelas tentang apa yang dibangun Murati dan timnya.
Dalam panduan ini, saya akan menunjukkan cara menjalankan Inklink secara lokal, pertama dengan menguji Inkling melalui Tinker Playground gratis. Saya kemudian akan menunjukkan cara mengunduh kuantisasi Unsloth GGUF, membangun branch eksperimental Inkling dari llama.cpp, menjalankan model di empat GPU NVIDIA RTX PRO 6000, dan berinteraksi dengannya melalui Web UI bawaan dan API yang kompatibel dengan OpenAI.
Inkling adalah model multimodal serbaguna dengan bobot terbuka (open-weights) dari Thinking Machines Lab.
Model ini menggunakan arsitektur Mixture-of-Experts dengan total 975 miliar parameter dan 41 miliar parameter aktif, mendukung input teks, gambar, dan audio, serta menawarkan jendela konteks hingga satu juta token.
Model ini dirancang untuk penalaran, pengodean, penggunaan alat, mengikuti instruksi, dan fine-tuning di berbagai domain.
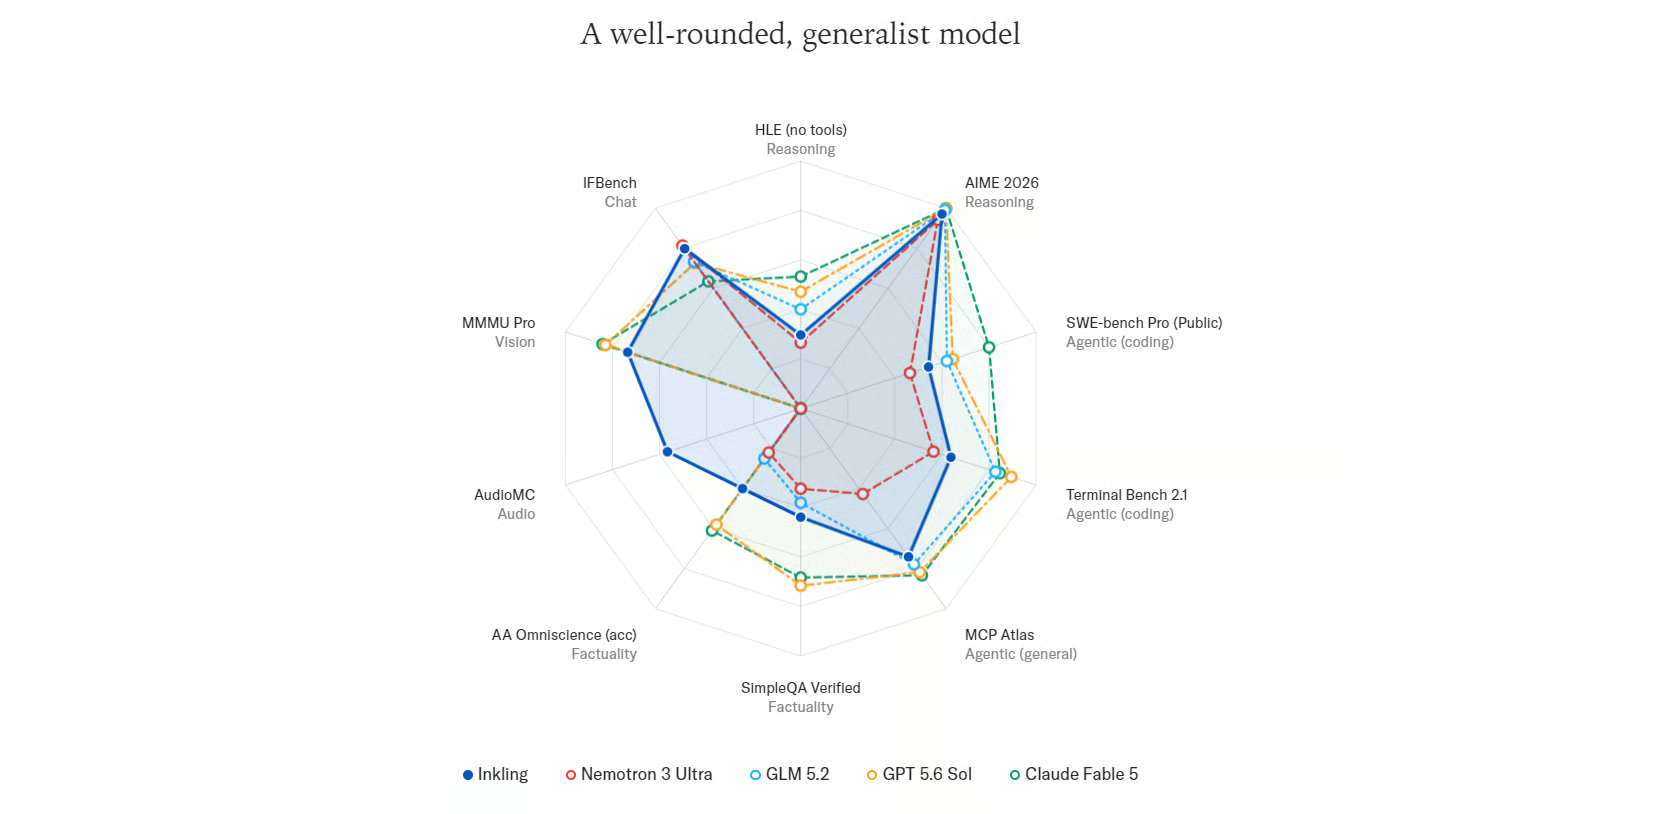
Sumber: Inkling - Thinking Machines Lab
Inkling adalah model generalis yang solid, menghadirkan kinerja seimbang di berbagai tolok ukur penalaran, agentic coding, faktualitas, visi, dan audio.
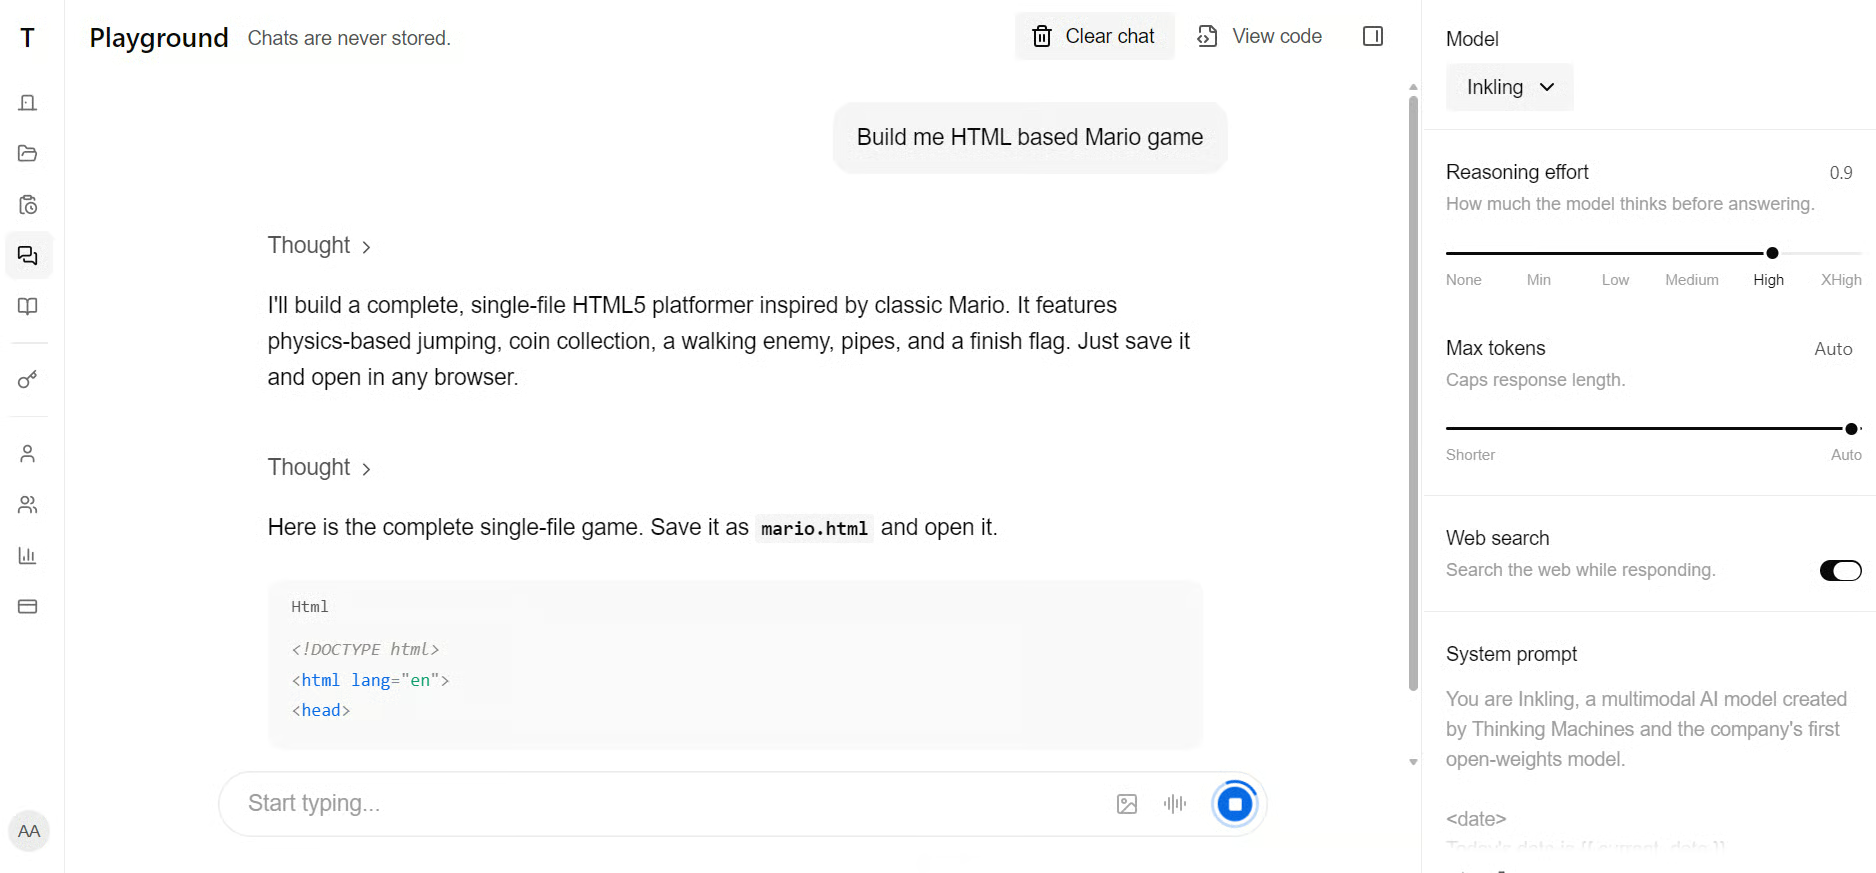
Sebelum menjalankan Inkling secara lokal, coba melalui Inkling Playground untuk mengeksplor responsnya dan memahami cara kerja model. Akses gratis saat ini tersedia untuk waktu terbatas.
Menjalankan Inkling secara lokal membutuhkan perangkat keras kelas enterprise.
Kuantisasi UD-Q4_K_XL milik Unsloth ukurannya sekitar 587 GB, sedangkan model presisi penuh BF16 memerlukan sekitar 1,89 TB.
Memori ini bisa berasal dari gabungan RAM dan VRAM, unified memory, atau hanya RAM, meski inferensi hanya-CPU akan jauh lebih lambat.
Memori tambahan juga diperlukan untuk jendela konteks dan overhead runtime.
Untuk panduan ini, kami menggunakan kuantisasi UD-Q2_K_XL yang lebih kecil, sekitar 317 GB, pada server RunPod yang dikonfigurasi dengan:
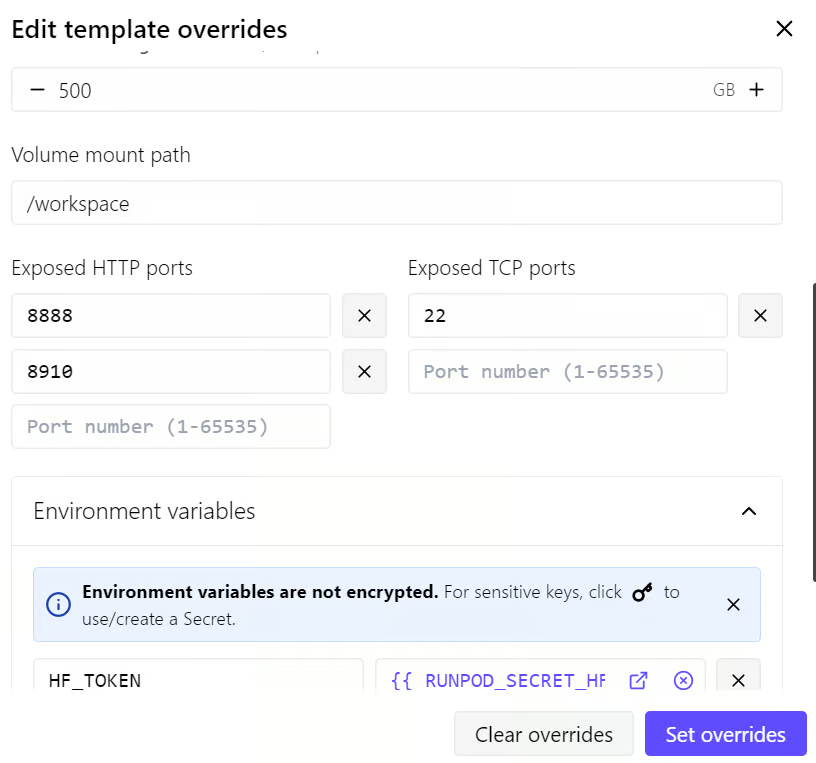
Berkas model yang besar dan cache Hugging Face akan disimpan pada disk volume 500 GB agar tetap tersedia jika Pod dimulai ulang.
Disk container 100 GB akan digunakan untuk paket sistem, dependensi build, dan kebutuhan runtime lainnya.
Kami juga akan mengonfigurasi token akses Hugging Face sebelum mengunduh Inkling.
Unduhan terautentikasi membantu menghindari batas laju anonim dan dapat memberikan kecepatan unduh yang lebih cepat dan andal, yang penting saat mengunduh model sebesar ini.
Biner standar llama.cpp yang diinstal melalui perintah curl biasa tidak akan berfungsi dengan Inkling karena dukungan untuk arsitekturnya belum digabungkan ke branch utama.
Dukungan Inkling saat ini tersedia melalui pull request eksperimental #25731, jadi llama.cpp harus dikompilasi dari branch tersebut.
Setelah mendeploy Pod RunPod, buka tab Connect dan klik tautan Jupyter Notebook.
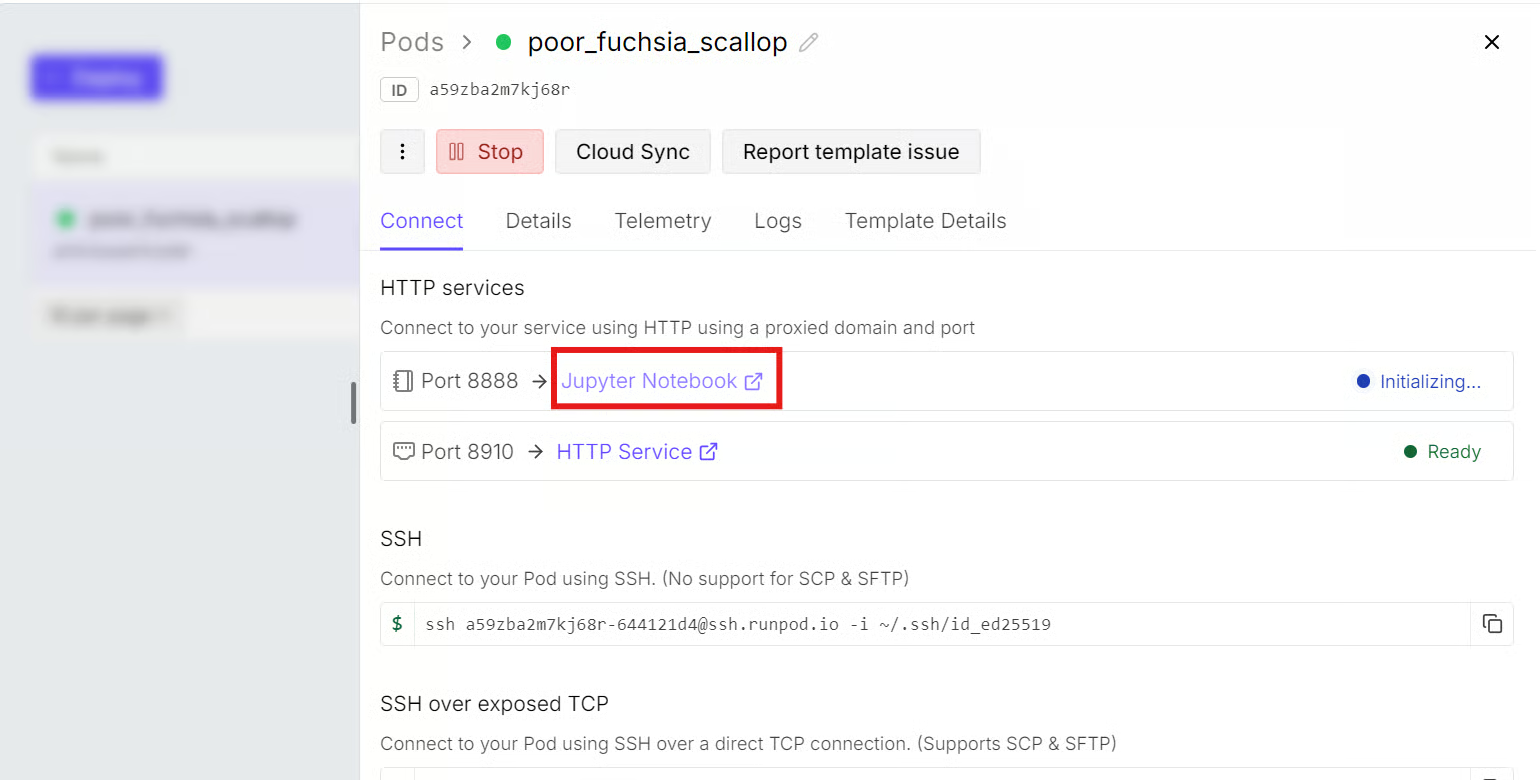
Dari JupyterLab, buka terminal baru dan instal paket sistem yang diperlukan:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Selanjutnya, clone llama.cpp ke volume /workspace dan beralih ke branch yang memuat dukungan Inkling:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Dukungan Inkling saat ini tersedia melalui draft pull request eksperimental, bukan di branch utama llama.cpp. Ambil dan beralih ke branch tersebut:
git fetch origin pull/25731/head:inkling
git switch inkling
Build llama.cpp dengan akselerasi CUDA diaktifkan:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Kompilasikan antarmuka baris perintah, antarmuka multimodal, server, dan utilitas GGUF:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"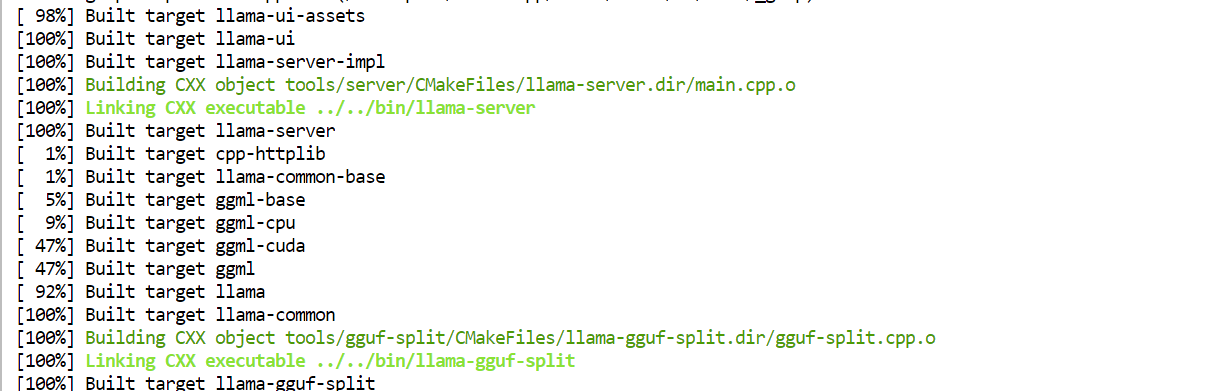
Terakhir, salin executable yang telah dikompilasi ke direktori utama llama.cpp agar lebih mudah diakses:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Instal Hugging Face CLI dan dukungan unduhan Xet:
pip install -U huggingface_hub hf_xetToken Hugging Face sudah ditambahkan ke variabel lingkungan RunPod saat Pod dideploy, jadi tidak diperlukan login tambahan.
Buat direktori pada disk volume 500 GB untuk cache Hugging Face dan model Inkling:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Atur lokasi cache dan aktifkan unduhan berperforma tinggi:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
Unduh hanya kuantisasi UD-Q2_K_XL:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
Waktu unduh akan bergantung pada koneksi internet Anda.
Kecepatan unduh saya dibatasi sekitar 130 MB/dtk, dan model memerlukan sekitar 42 menit untuk terunduh.
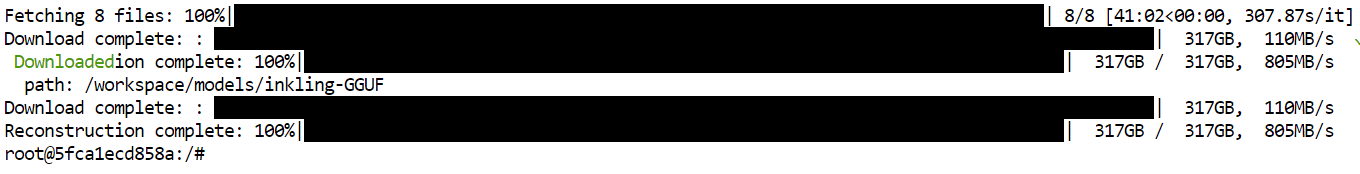
Jalankan perintah berikut untuk memuat Inkling di keempat GPU dan meluncurkan server inferensi yang kompatibel dengan OpenAI:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja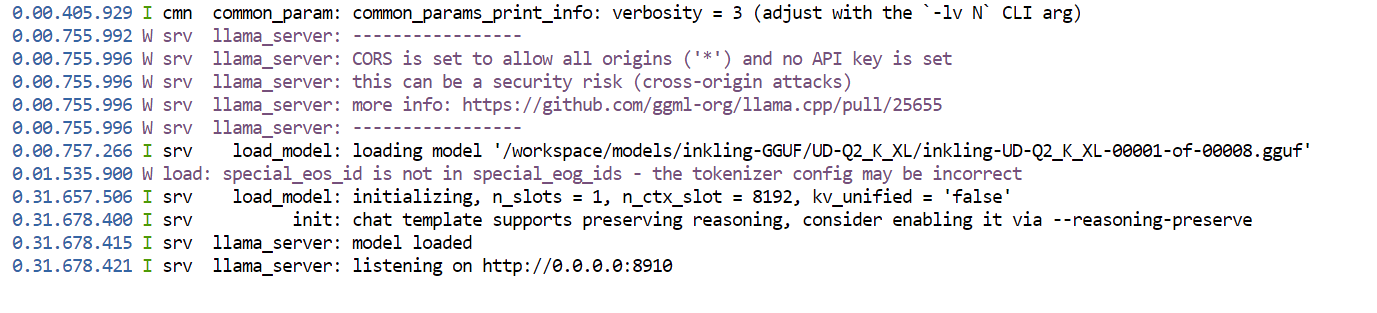
Perintah ini:
llama.cpp secara otomatis mendeteksi dan memuat tujuh shard lainnya.8910.Buka terminal Jupyter lain dan periksa penggunaan GPU:
nvidia-smi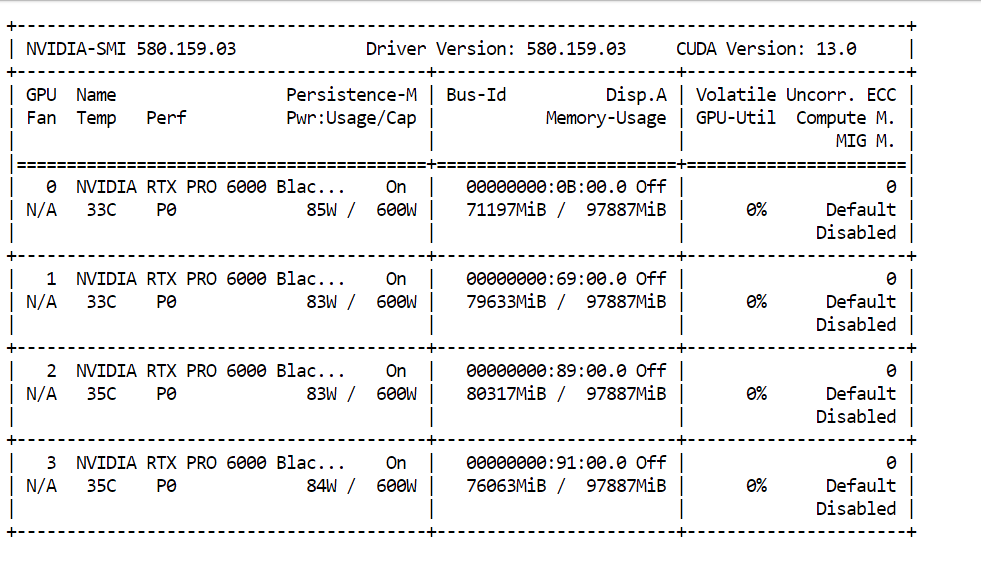
Dalam setup ini, sekitar 85% memori GPU yang tersedia terpakai setelah memuat model dengan jendela konteks 8.192 token.
Jendela konteks yang lebih besar memerlukan memori KV-cache tambahan, jadi menjalankan Inkling dengan konteks misalnya 100.000 token akan memerlukan memori yang tersedia jauh lebih besar.
API lokal yang kompatibel dengan OpenAI tersedia di:
http://127.0.0.1:8910/v1Sebelum menguji Inkling melalui Web UI, pastikan terlebih dahulu server inferensi berjalan dan mengembalikan respons. Buka terminal baru dan kirim permintaan uji ke API lokal:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
API berhasil merespons, memproses prompt pada kecepatan 81,1 token per detik dan menghasilkan pada 37,2 token per detik.
Digunakan 25 token prompt dan 256 token completion, tetapi berhenti karena mencapai batas output sebelum menghasilkan jawaban akhir. Meningkatkan max_tokens memungkinkan model menyelesaikan responsnya.
Kembali ke dasbor RunPod, buka tab Connect, lalu klik tautan di bawah HTTP Services untuk port 8910.
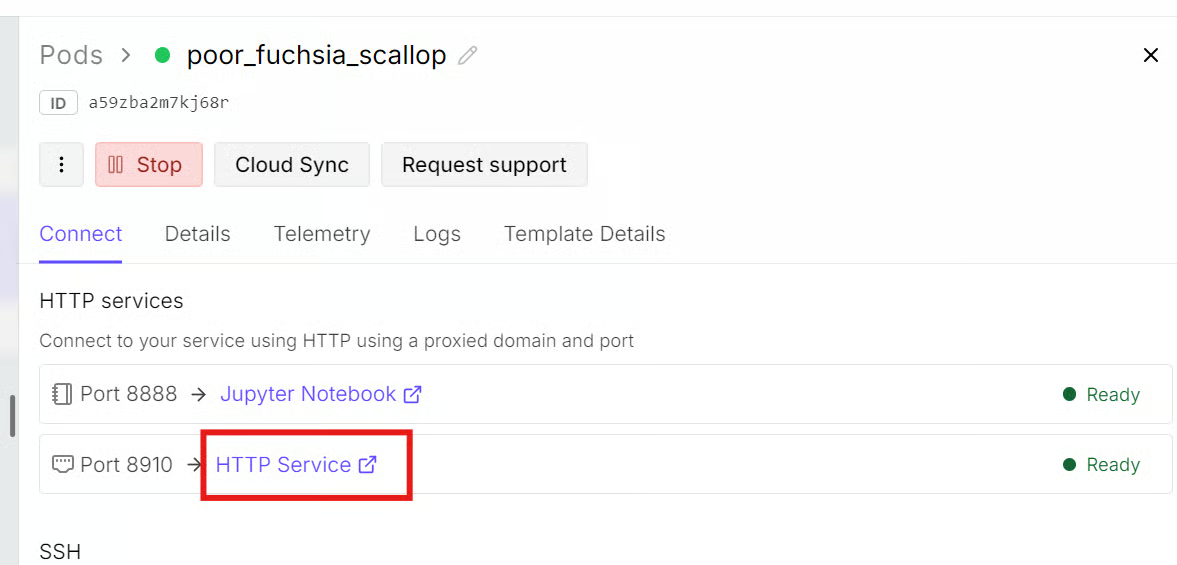
Web UI bawaan llama.cpp menyediakan antarmuka sederhana ala ChatGPT untuk mengirim prompt, menyesuaikan pengaturan generasi, dan melihat respons.
Server yang sama juga mengekspos API yang kompatibel dengan OpenAI untuk menghubungkan aplikasi dan alat eksternal.
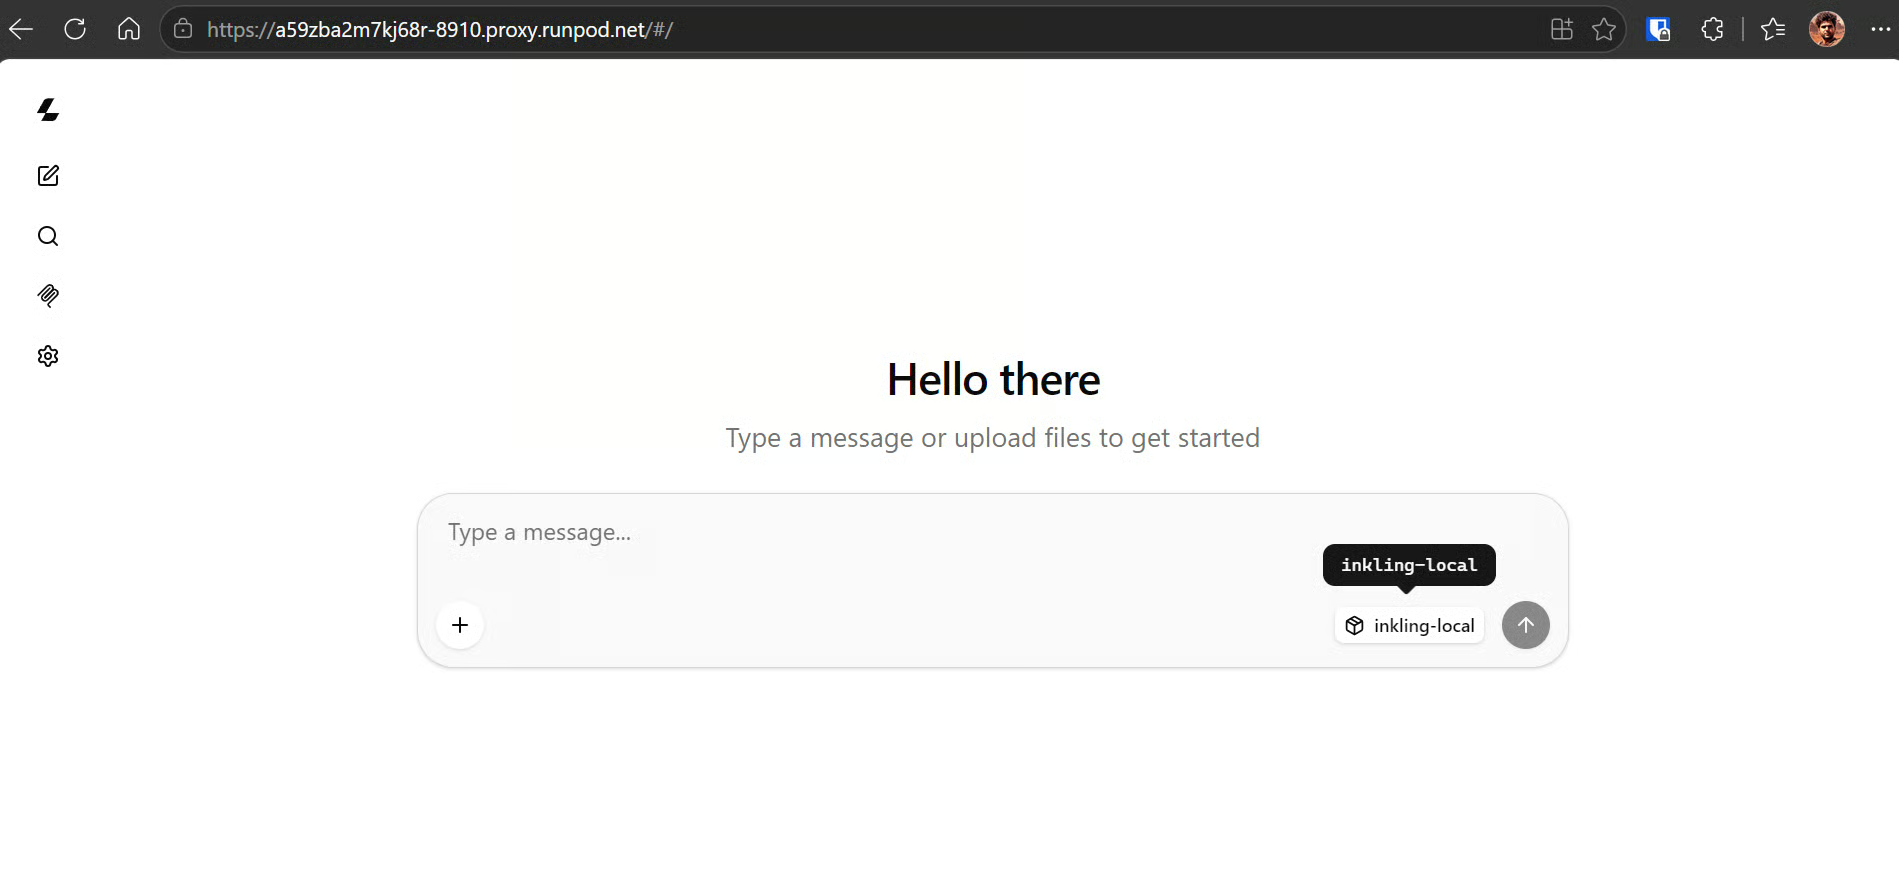
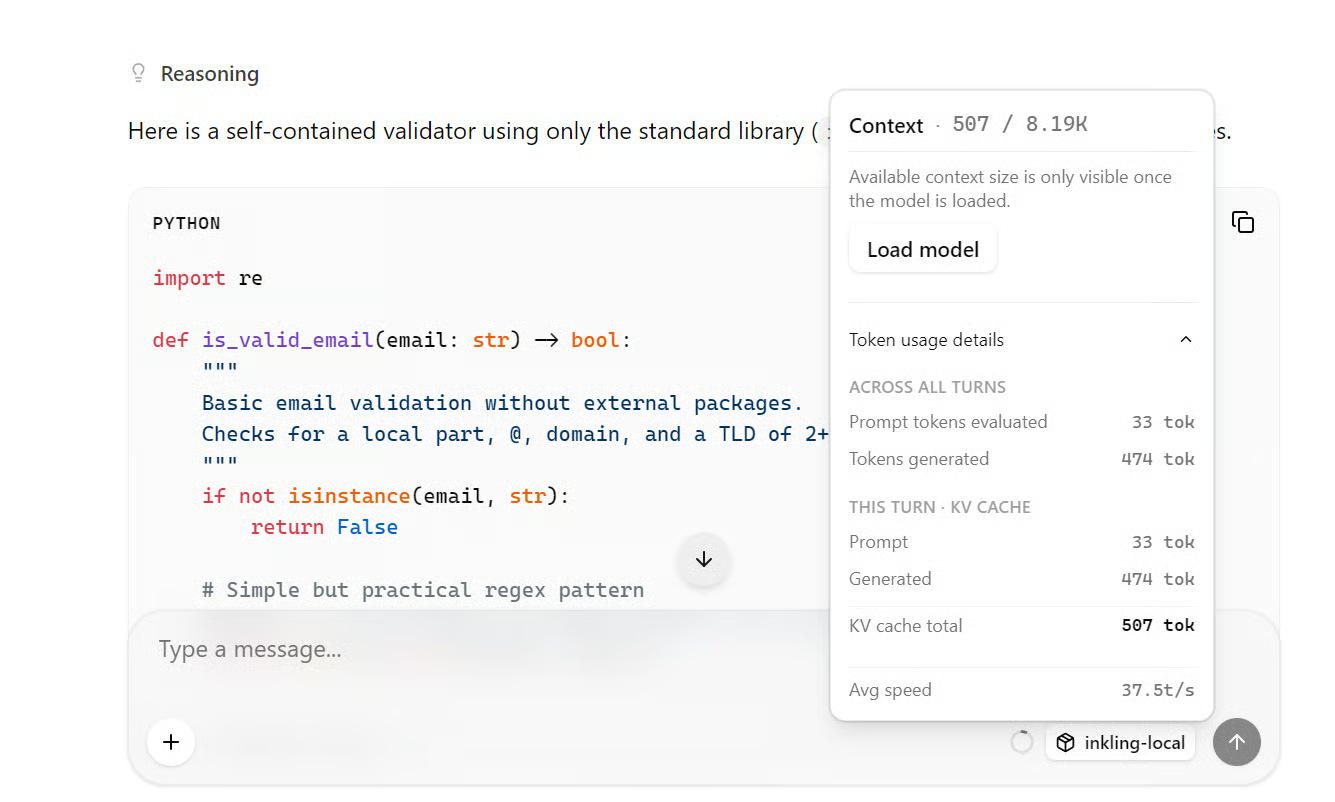
Mulailah dengan prompt pengodean:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling menghasilkan penjelasan lengkap dan kode yang berfungsi dengan kecepatan rata-rata sekitar 37,5 token per detik.
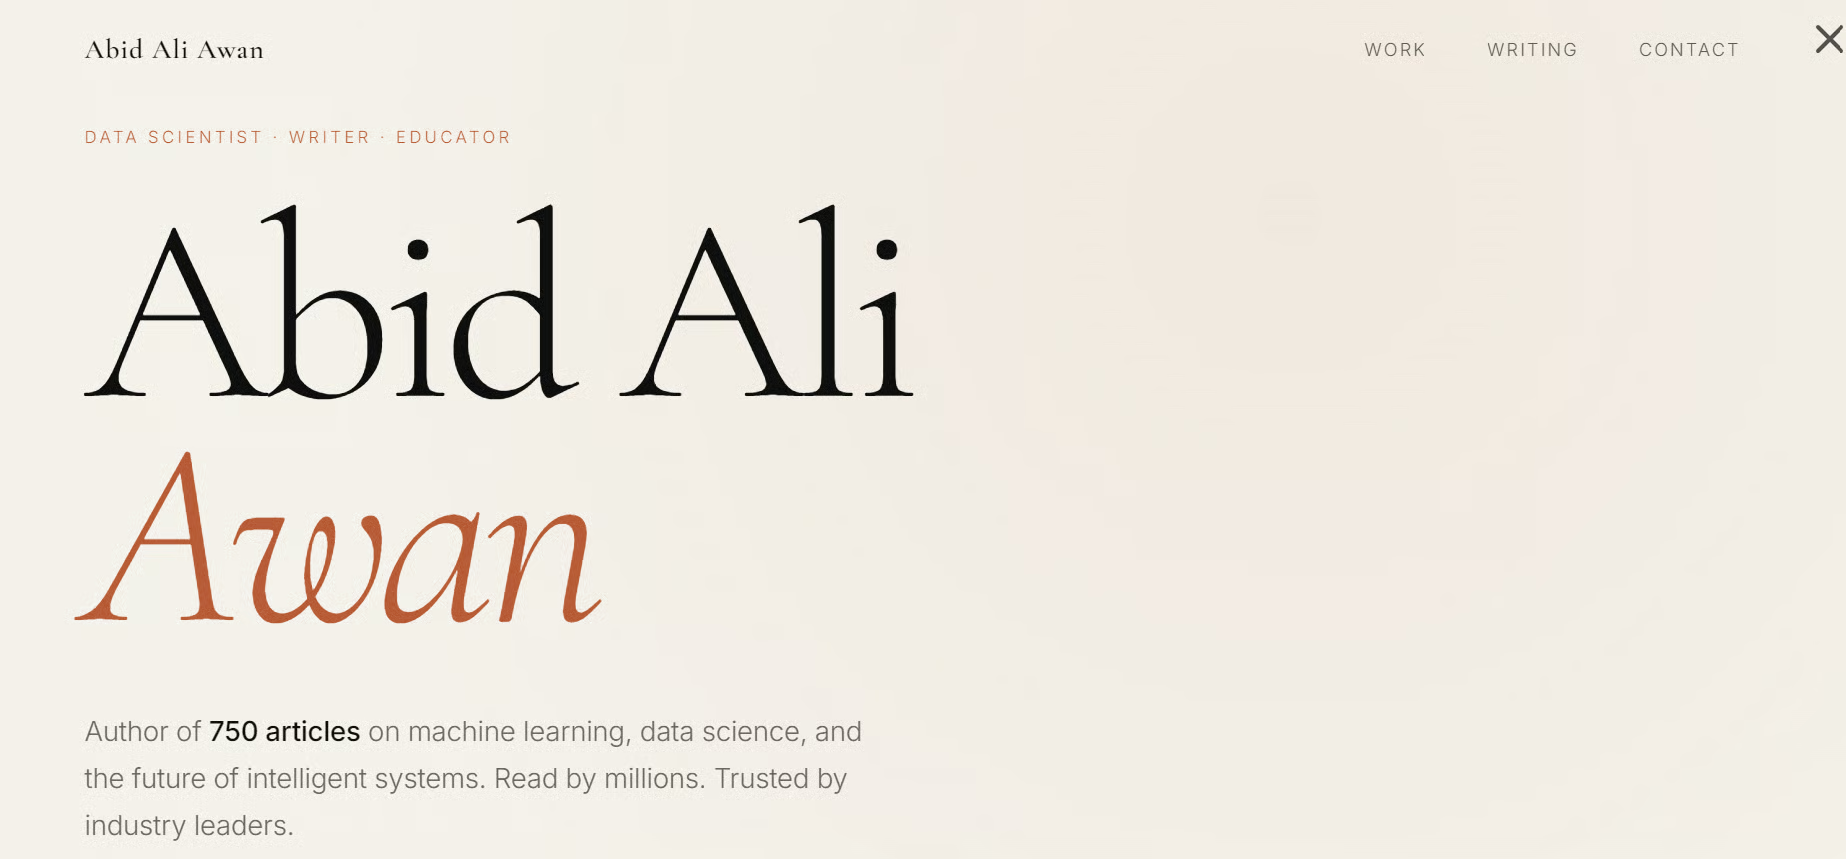
Selanjutnya, saya meminta dibuatkan situs web pribadi. Meski menggunakan model yang sangat dikuantisasi, Inkling menghasilkan tata letak yang rapi, antarmuka bersih, dan kode situs yang fungsional.
Inkling tidak membuat saya terkesan baik pada setup lokal maupun Playground daring.
Responsnya dapat digunakan tetapi biasa saja, dan beberapa model open-source yang lebih kecil menghasilkan hasil yang lebih baik untuk tugas serupa.
Namun, Inkling tidak dirancang untuk mendominasi satu kategori.
Ini adalah model serbaguna yang seimbang yang menggabungkan kemampuan pengodean, penulisan, penalaran, multibahasa, visi, dan audio. Kinerjanya cukup baik di banyak tolok ukur alih-alih memimpin satu bidang spesifik.
Untuk tugas pengodean, riset, atau penulisan yang khusus, tersedia alternatif open-source dan closed-source yang lebih kuat.
Nilai Inkling terletak pada fleksibilitasnya: berbobot terbuka, multimodal, dapat dikustomisasi, dan dapat dilatih atau di-fine-tune melalui Tinker, platform open-source Thinking Machines untuk pelatihan dan kustomisasi model.
Rilis ini mungkin mengurangi sebagian hype awal, tetapi juga memperjelas arah perusahaan.
Thinking Machines tampaknya tidak hanya bersaing untuk skor tolok ukur tertinggi. Sebaliknya, perusahaan membangun ekosistem yang lebih luas di sekitar model adaptif yang dapat di-fine-tune oleh organisasi dan digunakan di berbagai tugas.
Kursus Top DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



