
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
11.7K
Thinking Machines Lab एक AI रिसर्च और प्रोडक्ट कंपनी है, जिसकी स्थापना Mira Murati—OpenAI की पूर्व Chief Technology Officer और कुछ समय के लिए interim CEO—ने की थी। सितंबर 2024 में OpenAI छोड़ने के बाद, Murati ने अनुभवी AI शोधकर्ताओं की टीम बनाई और लगभग $2 बिलियन फंडिंग $12 बिलियन वैल्यूएशन पर जुटाई। फंडिंग और प्रतिभा के इस स्तर ने यह अपेक्षा पैदा की कि Thinking Machines, OpenAI जैसी स्थापित AI लैब्स का गंभीर प्रतिद्वंद्वी बन सकता है।
Inkling कंपनी का पहला बड़ा इन-हाउस मॉडल रिलीज़ है और नियोजित फैमिली का पहला मॉडल भी। यह reasoning, coding, tool use, और customization के लिए डिज़ाइन किया गया open-weights मल्टीमॉडल मॉडल है, जो यह पहली स्पष्ट झलक देता है कि Murati और उनकी टीम क्या बना रही थी।
इस गाइड में, मैं आपको दिखाऊंगा कि Inkling को लोकल पर कैसे चलाएँ—पहले फ्री Tinker Playground के जरिए Inkling को टेस्ट करके। उसके बाद मैं दिखाऊंगा कि Unsloth GGUF quantization कैसे डाउनलोड करें, llama.cpp की experimental Inkling ब्रांच कैसे बिल्ड करें, मॉडल को चार NVIDIA RTX PRO 6000 GPUs पर कैसे चलाएँ, और बिल्ट-इन Web UI तथा OpenAI-compatible API के जरिए इसके साथ कैसे इंटरेक्ट करें।
Inkling, Thinking Machines Lab का open-weights, general-purpose मल्टीमॉडल मॉडल है।
यह Mixture-of-Experts आर्किटेक्चर का उपयोग करता है, जिसमें कुल 975 बिलियन पैरामीटर्स और 41 बिलियन एक्टिव पैरामीटर्स हैं; यह टेक्स्ट, इमेज, और ऑडियो इनपुट को सपोर्ट करता है और अधिकतम एक मिलियन टोकन तक का कॉन्टेक्स्ट विंडो प्रदान करता है।
यह मॉडल reasoning, coding, tool use, instruction following, और अलग-अलग डोमेन्स में fine-tuning के लिए डिज़ाइन किया गया है।
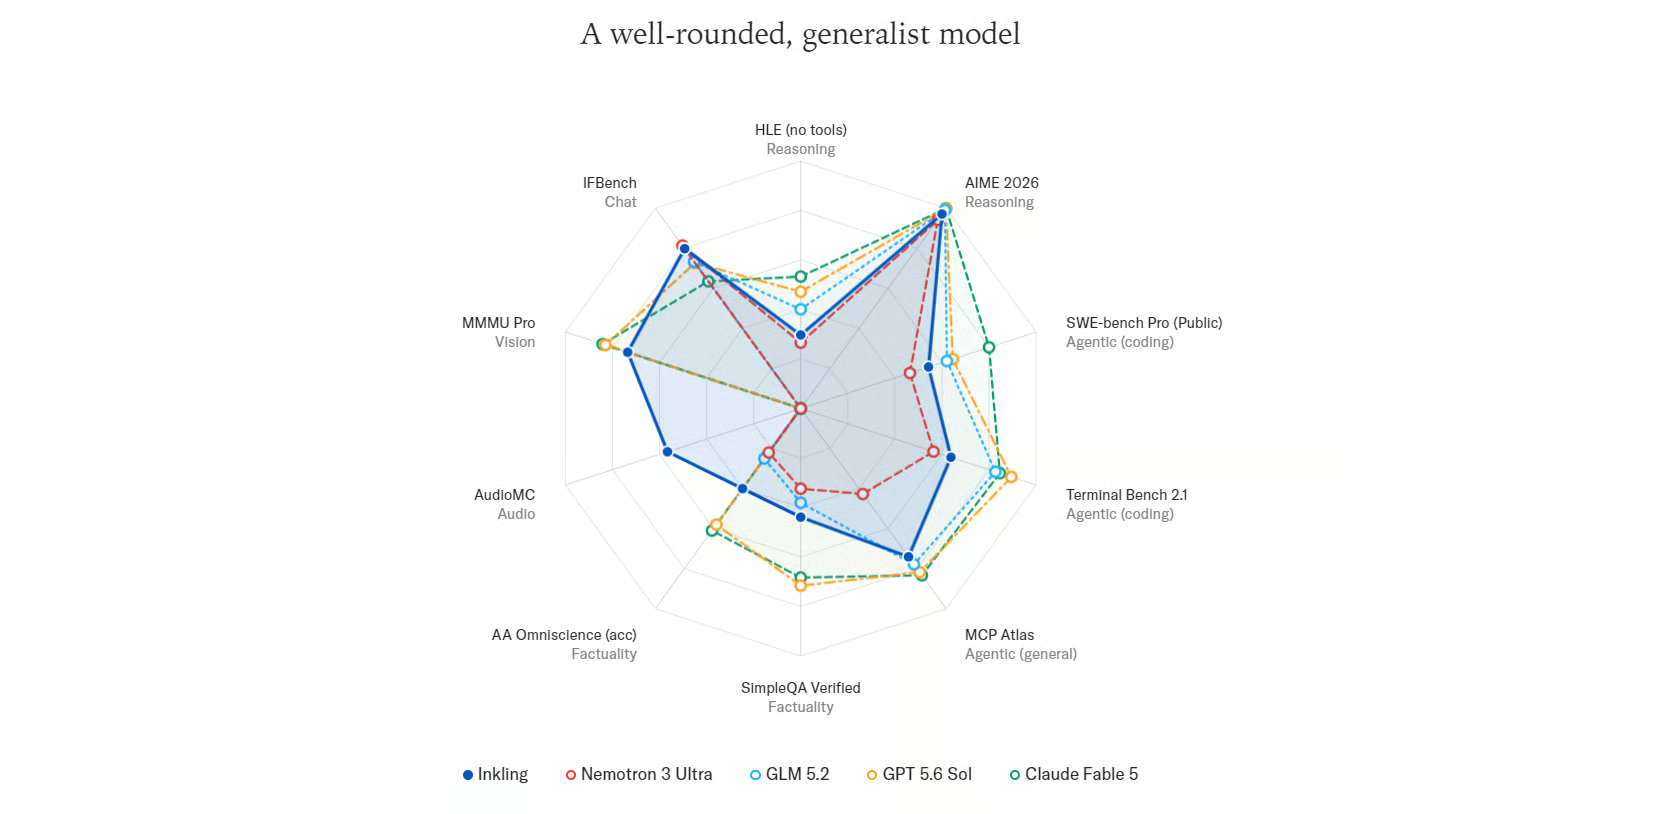
स्रोत: Inkling - Thinking Machines Lab
Inkling एक संतुलित जनरलिस्ट मॉडल है, जो reasoning, agentic coding, factuality, vision, और audio बेंचमार्क्स में संतुलित प्रदर्शन देता है।
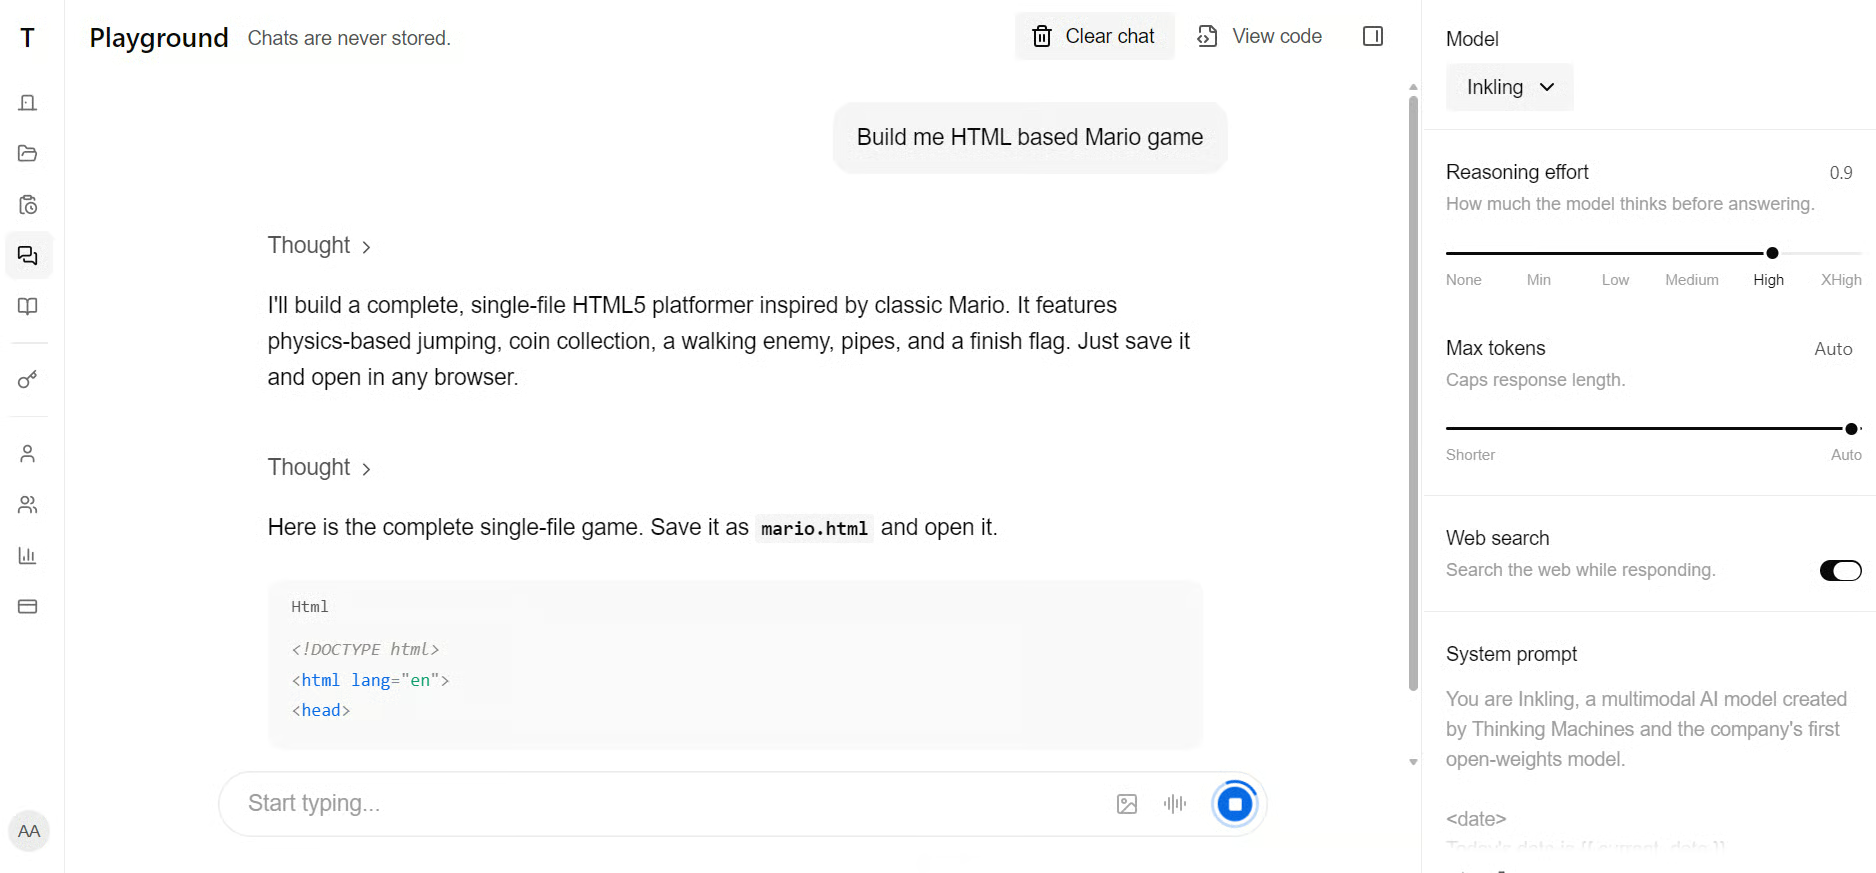
Inkling को लोकल पर चलाने से पहले, Inkling Playground के जरिए इसे आज़माएँ ताकि इसके उत्तरों का पता चले और समझें कि मॉडल कैसे काम करता है। फिलहाल सीमित समय के लिए निःशुल्क एक्सेस उपलब्ध है।
Inkling को लोकल पर चलाने के लिए एंटरप्राइज़-ग्रेड हार्डवेयर की आवश्यकता होती है।
Unsloth की UD-Q4_K_XL quantization लगभग 587 GB की है, जबकि फुल-प्रिसीजन BF16 मॉडल को लगभग 1.89 TB की ज़रूरत होती है।
यह मेमोरी RAM और VRAM के संयोजन, unified memory, या केवल RAM से आ सकती है, हालांकि केवल CPU पर inference काफी धीमा होगा।
कॉन्टेक्स्ट विंडो और runtime ओवरहेड के लिए भी अतिरिक्त मेमोरी की आवश्यकता होती है।
इस गाइड के लिए, हम छोटे UD-Q2_K_XL quantization का उपयोग करते हैं, जो लगभग 317 GB का है, एक RunPod सर्वर पर जो इस प्रकार कॉन्फ़िगर्ड है:
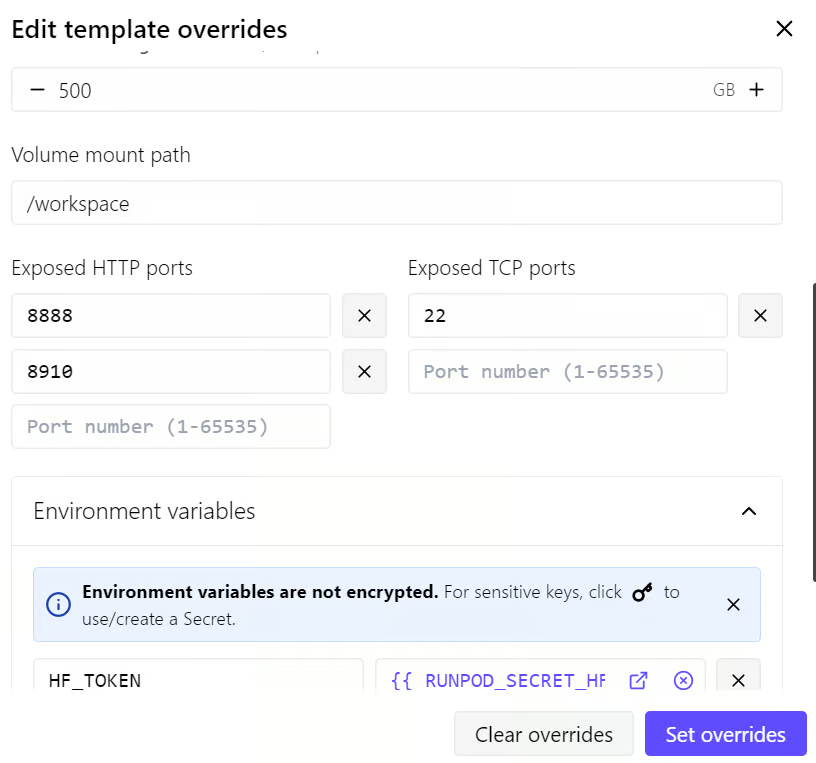
बड़े मॉडल फाइलें और Hugging Face cache 500 GB volume disk पर स्टोर की जाएँगी ताकि Pod रीस्टार्ट होने पर भी वे उपलब्ध रहें।
जबकि 100 GB container disk का उपयोग सिस्टम पैकेज, build dependencies, और अन्य runtime आवश्यकताओं के लिए होगा।
हम Inkling डाउनलोड करने से पहले एक Hugging Face access token भी कॉन्फ़िगर करेंगे।
Authenticated डाउनलोड्स anonymous rate limits से बचने में मदद करते हैं और तेज़ व अधिक विश्वसनीय स्पीड दे सकते हैं—जो इस आकार के मॉडल को डाउनलोड करते समय महत्वपूर्ण है।
सामान्य llama.cpp बायनरी, जिन्हें प्रचलित curl कमांड से इंस्टॉल किया जाता है, Inkling के साथ काम नहीं करेंगी क्योंकि इसकी आर्किटेक्चर का सपोर्ट अभी मुख्य ब्रांच में मर्ज नहीं हुआ है।
Inkling सपोर्ट फिलहाल experimental pull request #25731 के जरिए उपलब्ध है, इसलिए llama.cpp को उसी ब्रांच से कंपाइल करना होगा।
RunPod Pod को डिप्लॉय करने के बाद, Connect टैब खोलें और Jupyter Notebook लिंक पर क्लिक करें।
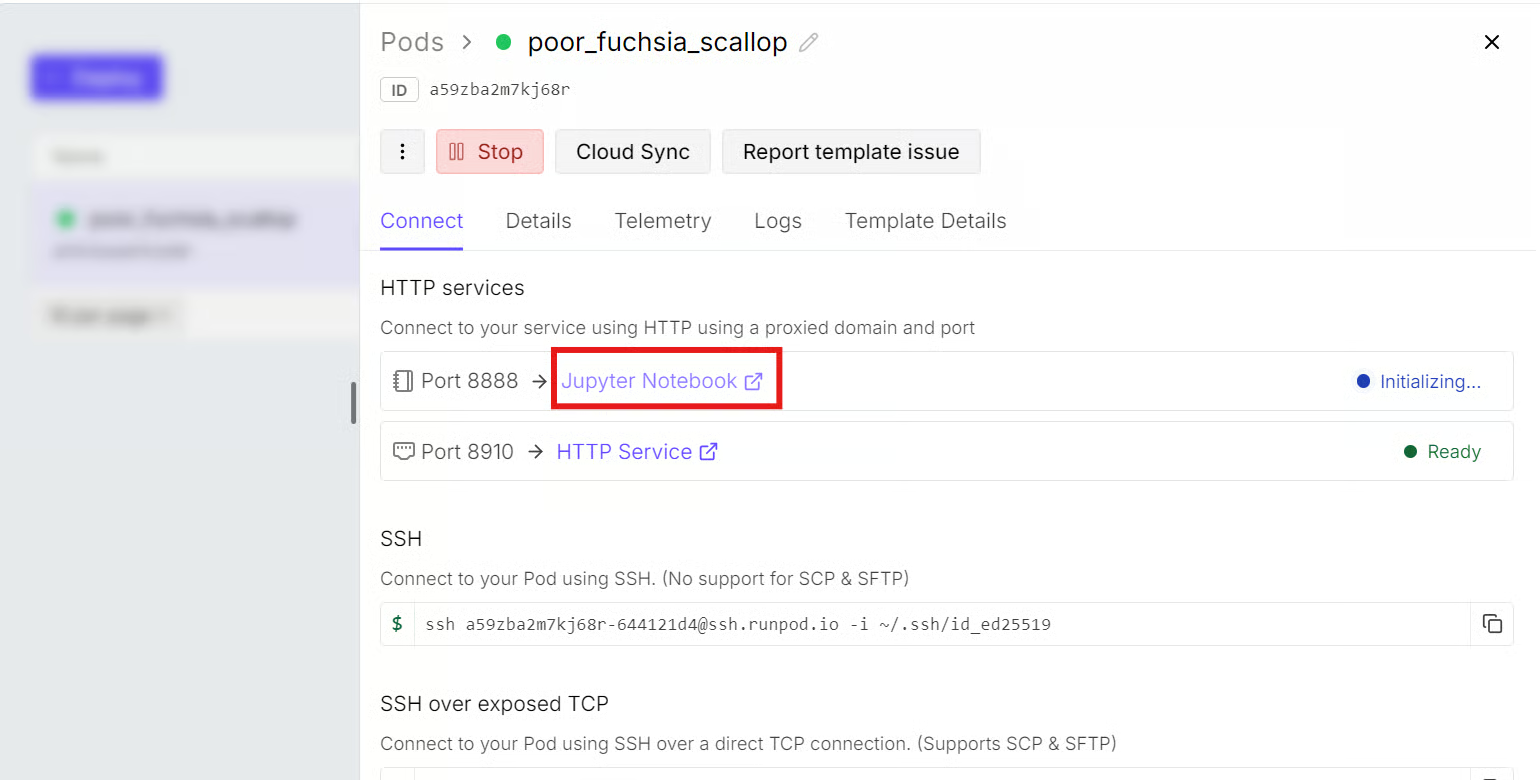
JupyterLab से, एक नया टर्मिनल लॉन्च करें और आवश्यक सिस्टम पैकेज इंस्टॉल करें:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
इसके बाद, llama.cpp को /workspace वॉल्यूम में क्लोन करें और उस ब्रांच पर स्विच करें जिसमें Inkling सपोर्ट है:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Inkling सपोर्ट फिलहाल मुख्य llama.cpp ब्रांच के बजाय एक experimental draft pull request के माध्यम से उपलब्ध है। उस ब्रांच को fetch करें और स्विच करें:
git fetch origin pull/25731/head:inkling
git switch inkling
CUDA acceleration सक्षम करके llama.cpp बिल्ड करें:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
कमांड-लाइन इंटरफ़ेस, मल्टीमॉडल इंटरफ़ेस, सर्वर, और GGUF यूटिलिटीज़ को कंपाइल करें:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"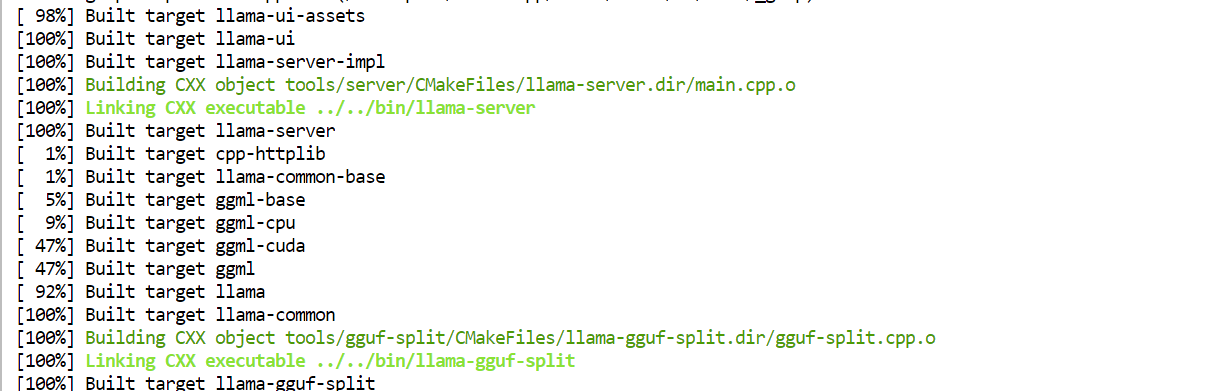
अंत में, कंपाइल किए गए executables को मुख्य llama.cpp डायरेक्टरी में कॉपी करें ताकि उन तक पहुँचना आसान हो:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Hugging Face CLI और Xet डाउनलोड सपोर्ट इंस्टॉल करें:
pip install -U huggingface_hub hf_xetHugging Face टोकन, Pod डिप्लॉय करते समय ही RunPod environment variables में जोड़ दिया गया था, इसलिए अतिरिक्त लॉगिन की आवश्यकता नहीं है।
Hugging Face cache और Inkling मॉडल के लिए 500 GB volume disk पर डायरेक्टरी बनाएँ:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
कैश लोकेशन सेट करें और high-performance डाउनलोड्स सक्षम करें:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
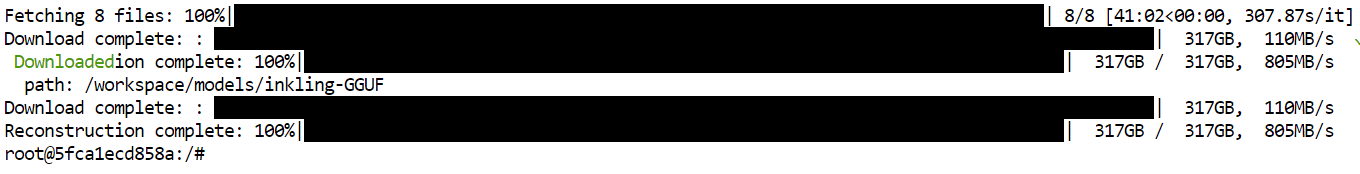
केवल UD-Q2_K_XL quantization डाउनलोड करें:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
डाउनलोड समय आपकी इंटरनेट कनेक्शन पर निर्भर करेगा।
मेरी डाउनलोड स्पीड लगभग 130 MB/s तक सीमित थी, और मॉडल को डाउनलोड होने में लगभग 42 मिनट लगे।
निम्न कमांड चलाएँ ताकि Inkling चारों GPUs पर लोड हो जाए और एक OpenAI-compatible inference सर्वर लॉन्च हो:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja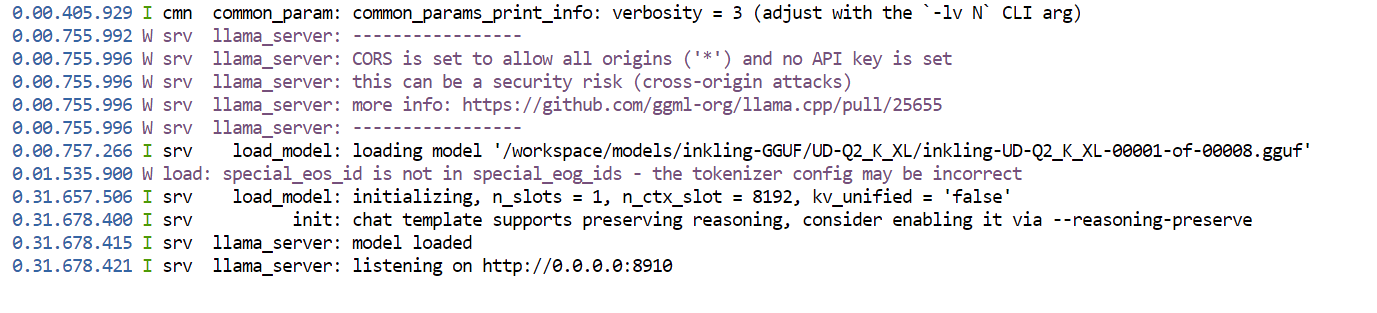
यह कमांड:
llama.cpp बाकी सात shards को स्वतः पहचानकर लोड कर लेता है।8910 पर लॉन्च करती है।एक और Jupyter टर्मिनल खोलें और GPU उपयोग जाँचें:
nvidia-smi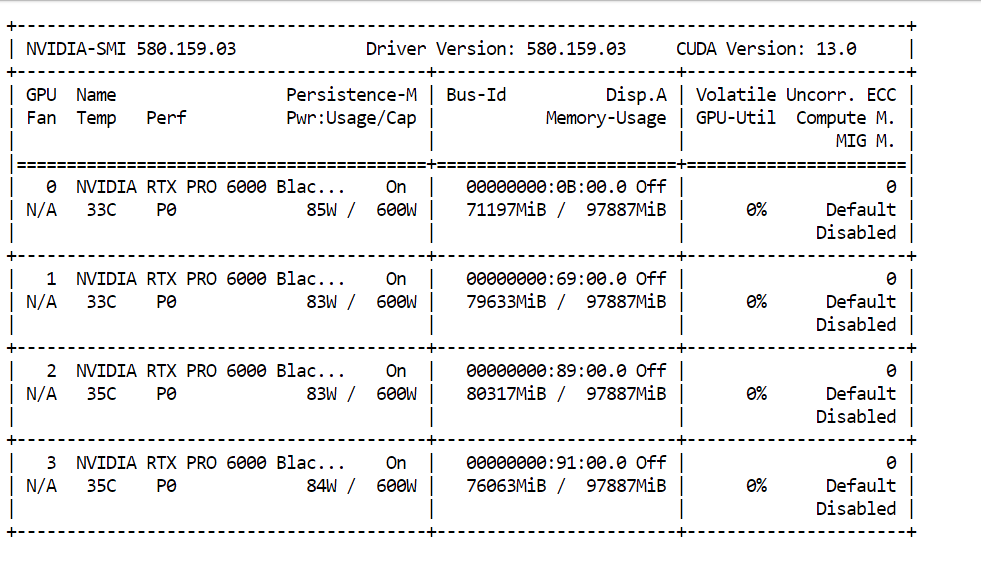
इस सेटअप में, मॉडल को 8,192-टोकन कॉन्टेक्स्ट विंडो के साथ लोड करने के बाद उपलब्ध GPU मेमोरी का लगभग 85% उपयोग हुआ।
बड़े कॉन्टेक्स्ट विंडो के लिए अतिरिक्त KV-cache मेमोरी चाहिए, इसलिए 100,000 टोकन्स जैसे कॉन्टेक्स्ट के साथ Inkling चलाने के लिए काफी अधिक मेमोरी उपलब्ध होना आवश्यक होगा।
लोकल OpenAI-compatible API यहाँ उपलब्ध है:
http://127.0.0.1:8910/v1Web UI के जरिए Inkling को टेस्ट करने से पहले, सुनिश्चित करें कि inference सर्वर चल रहा है और उत्तर दे रहा है। एक नया टर्मिनल खोलें और लोकल API पर एक टेस्ट रिक्वेस्ट भेजें:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
API सफलतापूर्वक लौटा—प्रॉम्प्ट को 81.1 tokens per second की दर से प्रोसेस किया और 37.2 tokens per second की दर से जेनरेट किया।
इसने 25 प्रॉम्प्ट टोकन और 256 completion टोकन उपयोग किए, लेकिन आउटपुट सीमा पर पहुँचने के कारण अंतिम उत्तर देने से पहले रुक गया। max_tokens बढ़ाने से मॉडल अपना उत्तर पूरा कर सकेगा।
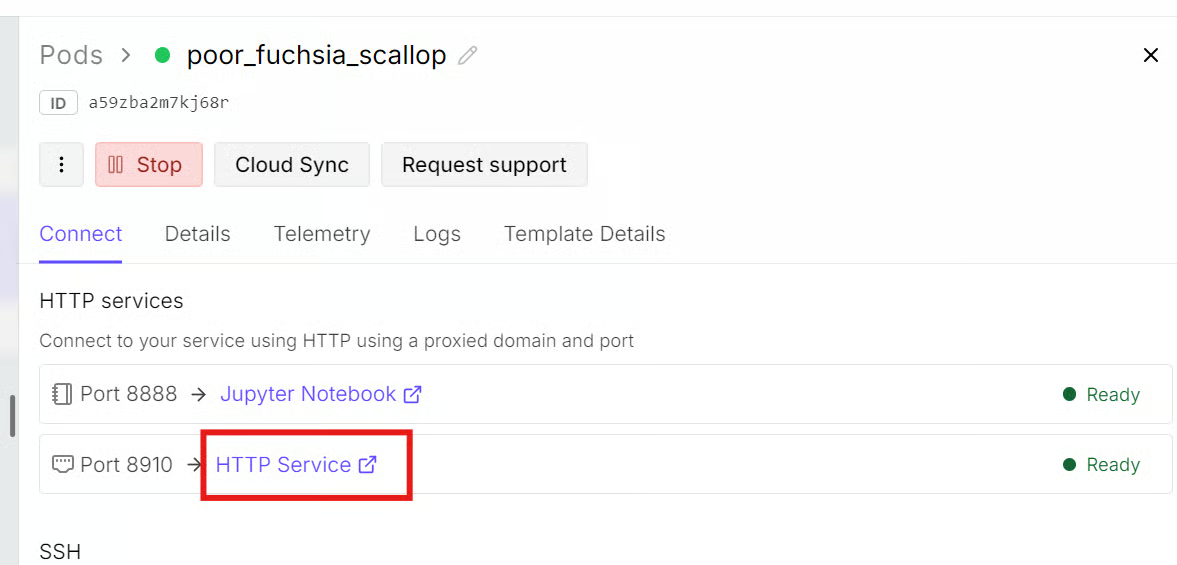
RunPod डैशबोर्ड पर लौटें, Connect टैब खोलें, और HTTP Services के अंतर्गत पोर्ट 8910 पर सूचीबद्ध लिंक पर क्लिक करें।
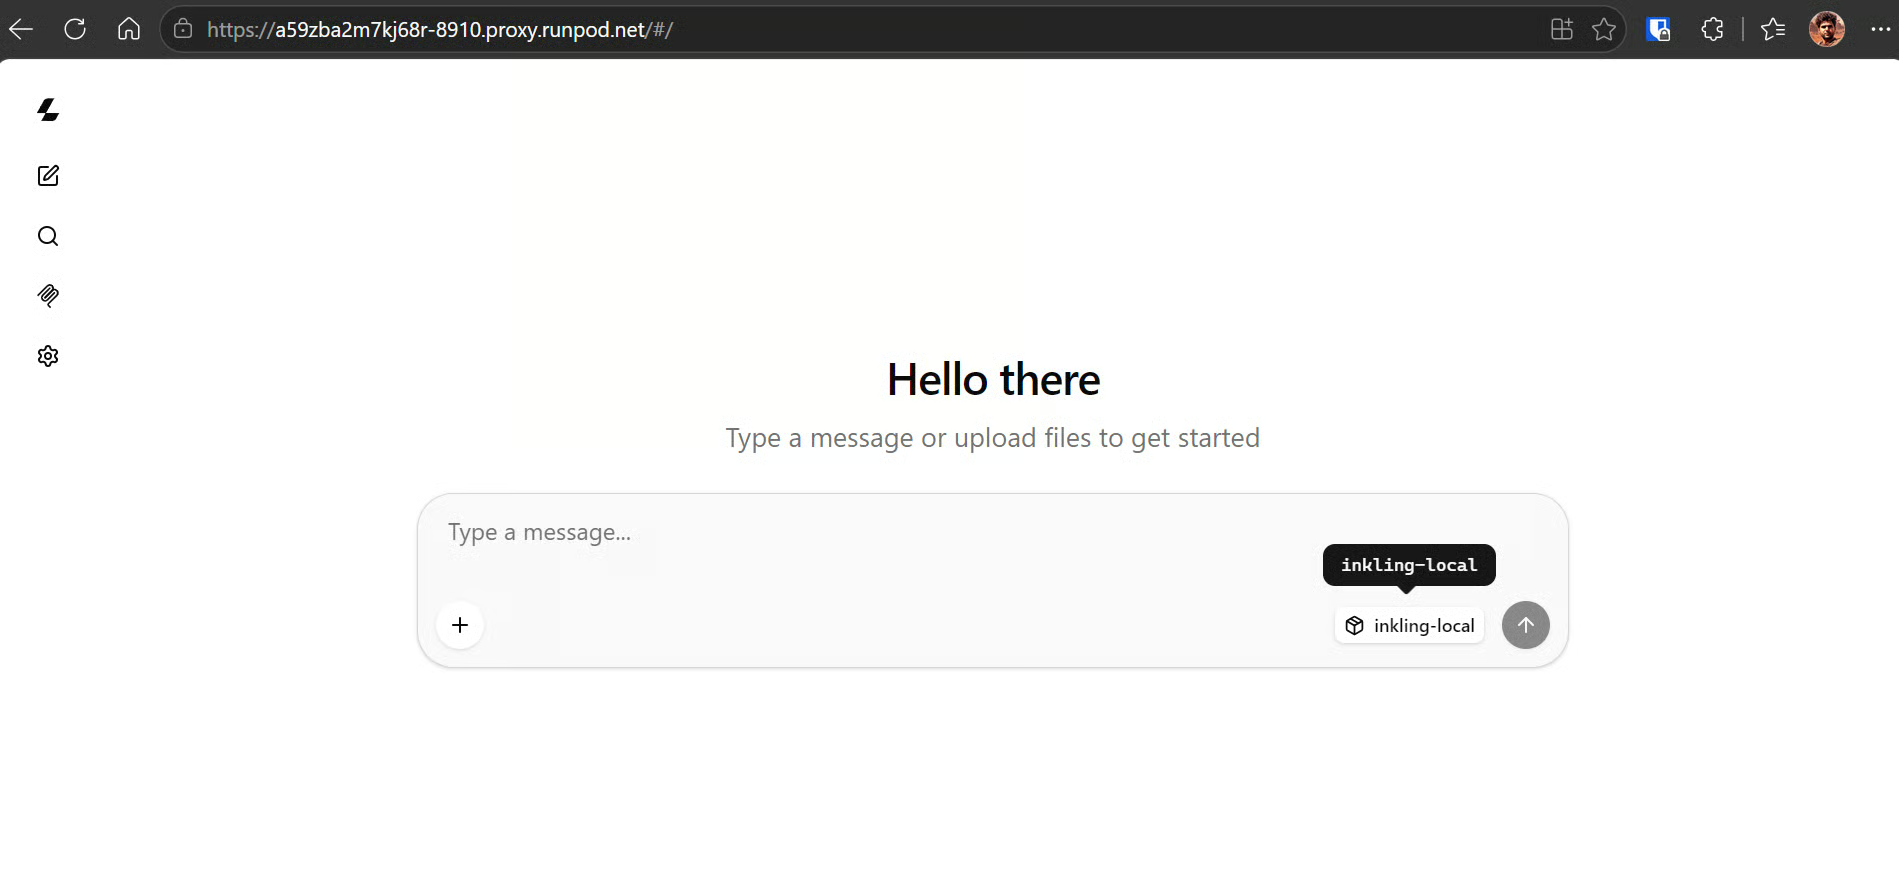
बिल्ट-इन llama.cpp Web UI प्रॉम्प्ट भेजने, जेनरेशन सेटिंग्स समायोजित करने, और प्रतिक्रियाएँ देखने के लिए एक सरल ChatGPT-शैली इंटरफ़ेस प्रदान करता है।
यही सर्वर बाहरी एप्लिकेशनों और टूल्स से कनेक्ट होने के लिए OpenAI-compatible API भी उपलब्ध कराता है।
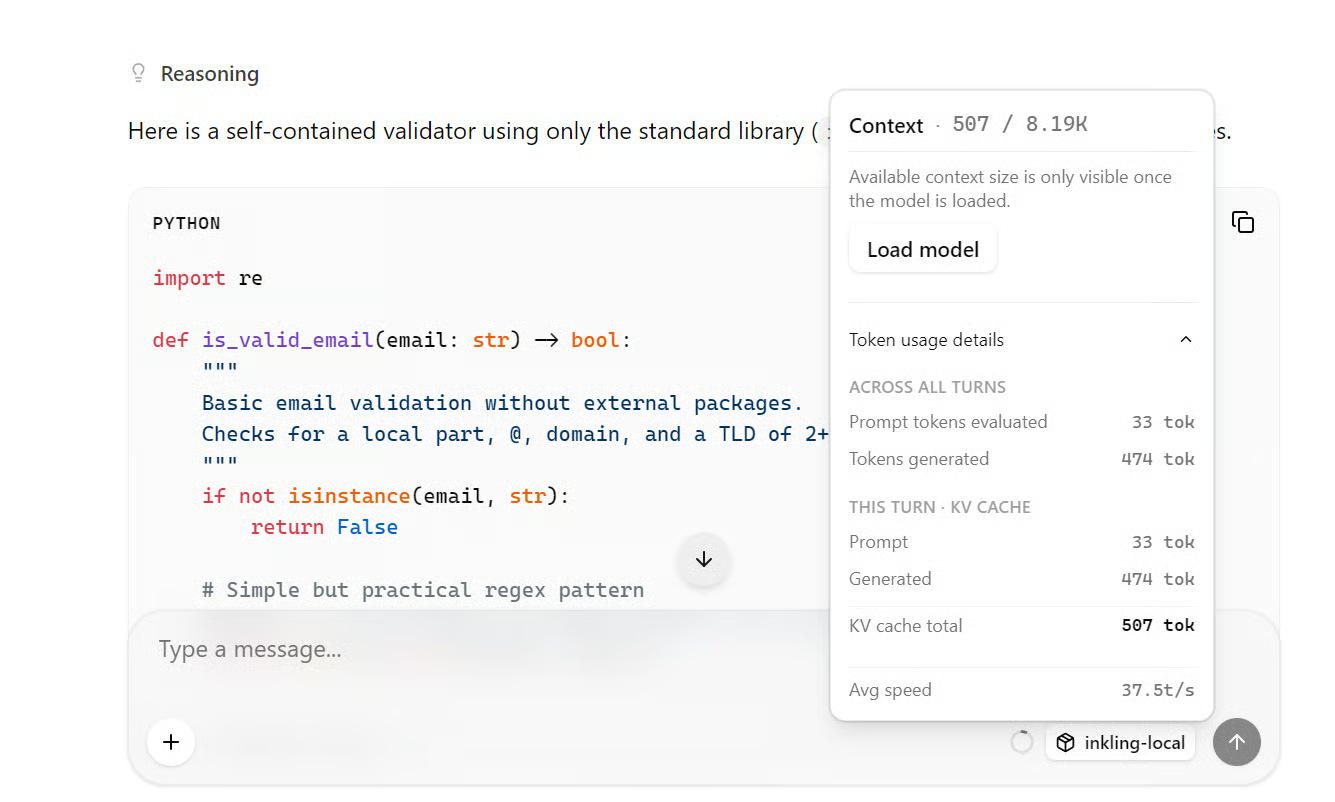
कोडिंग प्रॉम्प्ट से शुरुआत करें:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling ने लगभग 37.5 tokens per second की औसत गति से एक पूर्ण व्याख्या और काम करने वाला कोड जनरेट किया।
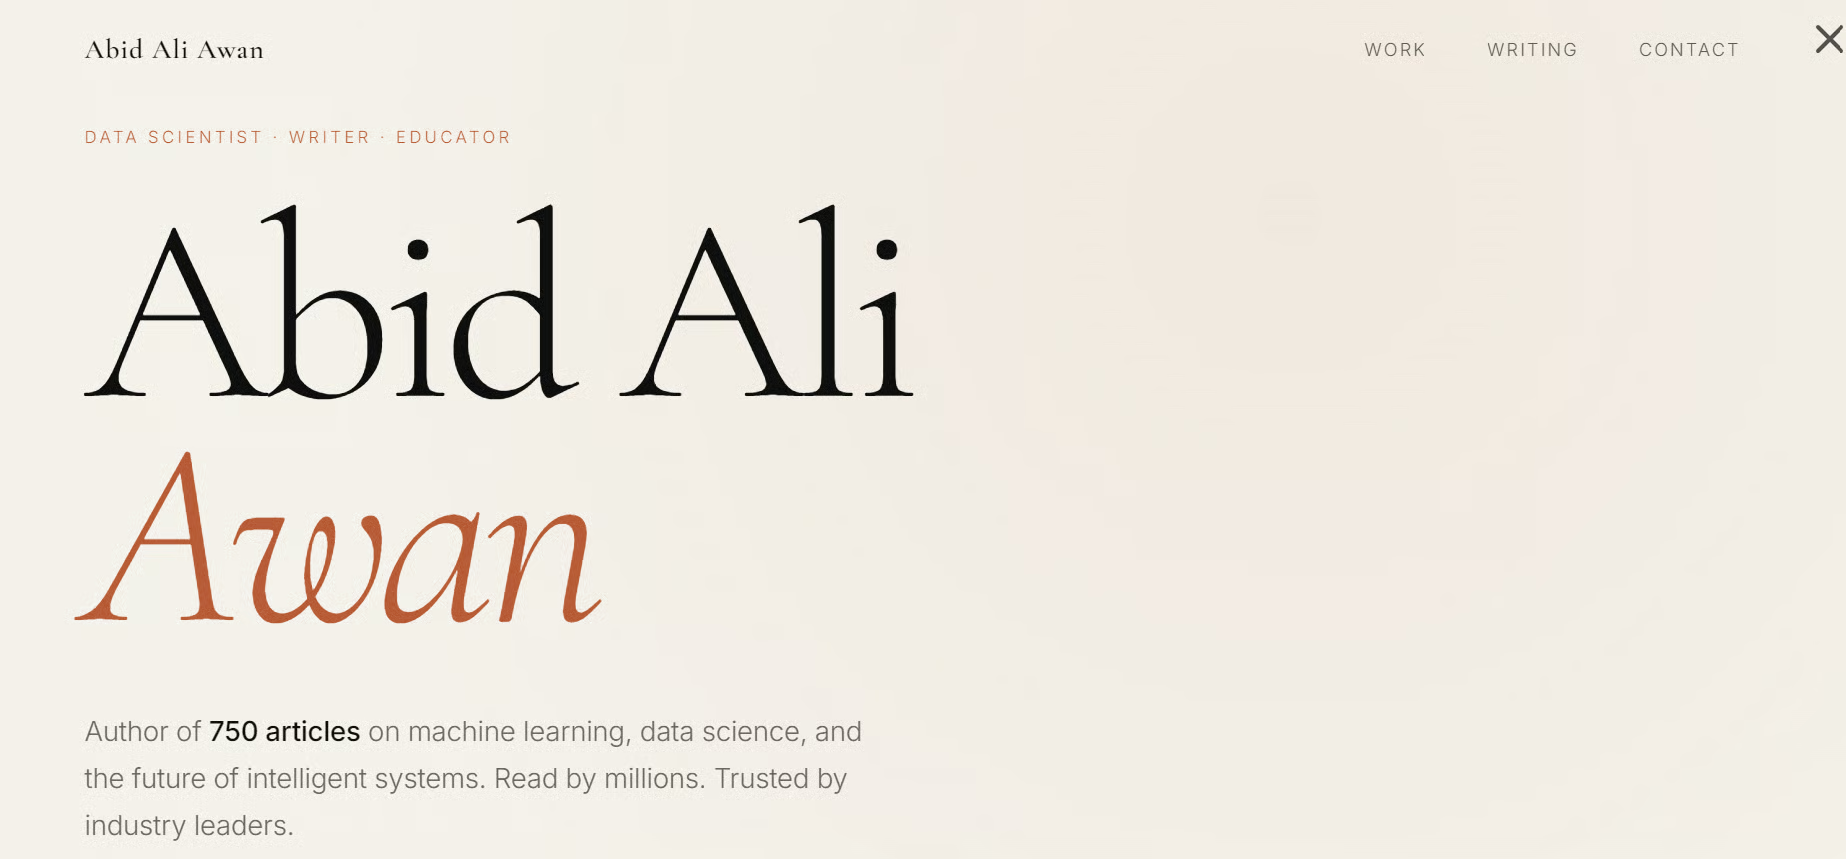
इसके बाद, मैंने उससे एक व्यक्तिगत वेबसाइट बनाने के लिए कहा। भारी quantized मॉडल होने के बावजूद, Inkling ने एक परिष्कृत लेआउट, साफ-सुथरा इंटरफ़ेस, और कार्यशील वेबसाइट कोड तैयार किया।
लोकल सेटअप या ऑनलाइन Playground—दोनों में Inkling ने मुझे प्रभावित नहीं किया।
उत्तर उपयोगी थे लेकिन औसत दर्जे के; इसी तरह के कार्यों पर कई छोटे open-source मॉडल बेहतर परिणाम दे पाए।
हालाँकि, Inkling का उद्देश्य किसी एक श्रेणी में प्रभुत्व जमाना नहीं है।
यह एक संतुलित, general-purpose मॉडल है जो coding, writing, reasoning, multilingual, vision, और audio क्षमताओं को जोड़ता है। यह किसी एक विशिष्ट क्षेत्र में अग्रणी होने के बजाय कई बेंचमार्क्स पर उचित प्रदर्शन करता है।
समर्पित coding, research, या writing कार्यों के लिए, मजबूत open-source और closed-source विकल्प उपलब्ध हैं।
Inkling का मूल्य इसकी लचीलापन में है: यह open-weight, मल्टीमॉडल, कस्टमाइज़ेबल है और Tinker, Thinking Machines का open-source प्लेटफ़ॉर्म, के माध्यम से ट्रेन या फाइन-ट्यून किया जा सकता है।
इस रिलीज़ ने शुरुआती hype को कुछ कम किया हो सकता है, लेकिन इसने कंपनी की दिशा भी स्पष्ट कर दी है।
Thinking Machines केवल उच्चतम बेंचमार्क स्कोर्स के लिए प्रतिस्पर्धा करता नहीं दिखता। इसके बजाय, यह अनुकूलनशील मॉडलों के व्यापक इकोसिस्टम का निर्माण कर रहा है, जिन्हें संगठन विभिन्न कार्यों में फाइन-ट्यून कर उपयोग कर सकें।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
कोर्स