
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
11.6K
Thinking Machines Lab is een AI-onderzoeks- en productbedrijf opgericht door Mira Murati, OpenAI’s voormalige Chief Technology Officer en korte tijd interim-CEO. Na haar vertrek bij OpenAI in september 2024 stelde Murati een team samen van ervaren AI-onderzoekers en haalde ongeveer $2 miljard op bij een waardering van $12 miljard. De schaal van de financiering en het talent wekte hoge verwachtingen dat Thinking Machines een serieuze concurrent kon worden van gevestigde AI-labs zoals OpenAI.
Inkling is de eerste grote in-house modelrelease van het bedrijf en het eerste model in een geplande familie. Het is een open-weights multimodaal model ontworpen voor redeneren, coderen, toolgebruik en maatwerk, en biedt de eerste duidelijke blik op wat Murati en haar team hebben gebouwd.
In deze gids laat ik je zien hoe je Inklink lokaal draait, eerst door Inkling te testen via de gratis Tinker Playground. Daarna laat ik je zien hoe je een Unsloth GGUF-kwantisatie downloadt, de experimentele Inkling-branch van llama.cpp bouwt, het model over vier NVIDIA RTX PRO 6000 GPU’s draait en ermee werkt via de ingebouwde web-UI en OpenAI-compatibele API.
Inkling is een open-weights, algemeen toepasbaar multimodaal model van Thinking Machines Lab.
Het gebruikt een Mixture-of-Experts-architectuur met in totaal 975 miljard parameters en 41 miljard actieve parameters, ondersteunt tekst-, beeld- en audio-invoer en biedt een contextvenster tot één miljoen tokens.
Het model is ontworpen voor redeneren, coderen, toolgebruik, het opvolgen van instructies en fine-tuning in verschillende domeinen.
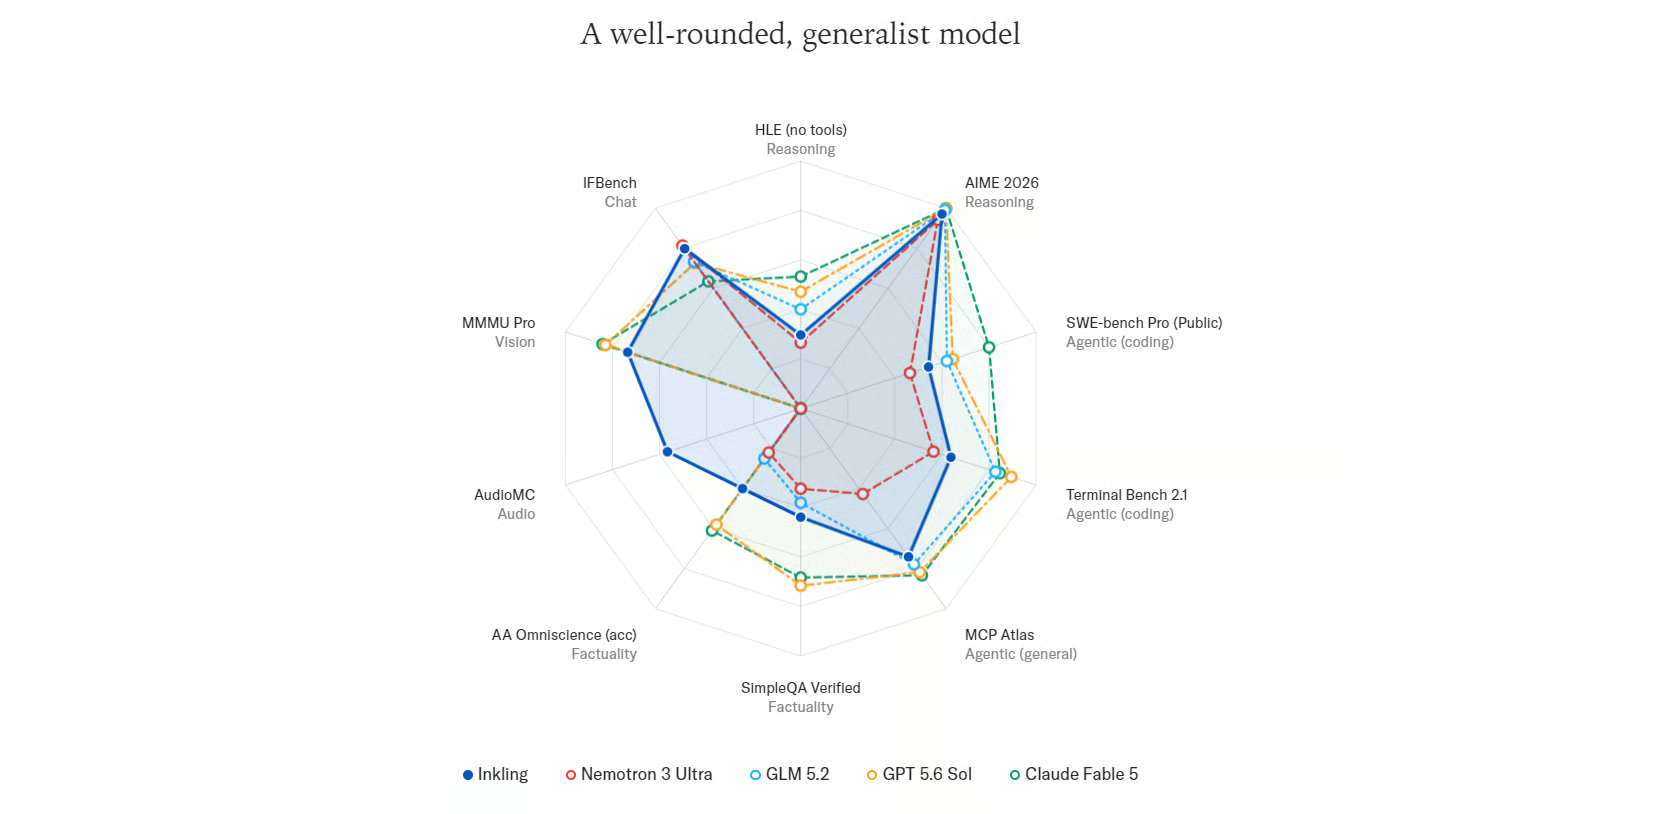
Bron: Inkling - Thinking Machines Lab
Inkling is een veelzijdig generalistisch model dat gebalanceerde prestaties levert over benchmarks voor redeneren, agentisch coderen, factualiteit, visie en audio.
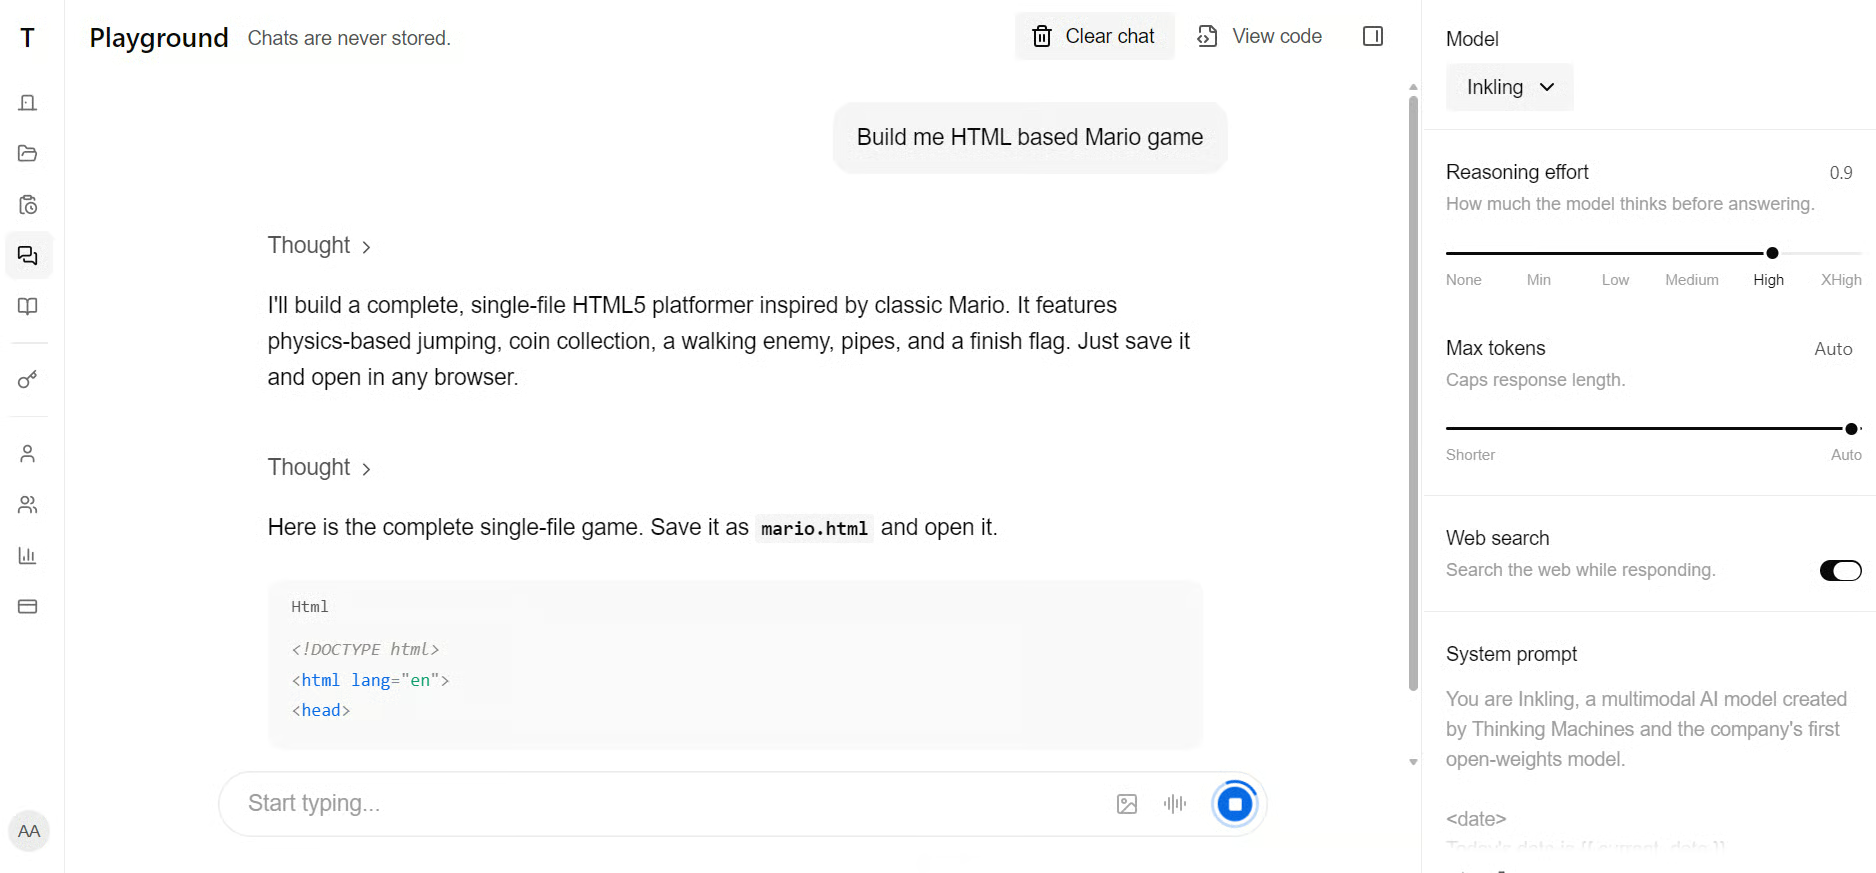
Voordat je Inkling lokaal draait, kun je het proberen via de Inkling Playground om de reacties te verkennen en te begrijpen hoe het model werkt. Gratis toegang is momenteel tijdelijk beschikbaar.
Inkling lokaal draaien vereist hardware op ondernemingsniveau.
Unsloth’s UD-Q4_K_XL-kwantisatie is ongeveer 587 GB, terwijl het full-precision BF16-model ongeveer 1,89 TB vereist.
Dit geheugen kan komen uit gecombineerde RAM en VRAM, unified memory of alleen RAM, al zal inference op alleen CPU veel trager zijn.
Er is ook extra geheugen nodig voor het contextvenster en runtime-overhead.
Voor deze gids gebruiken we de kleinere UD-Q2_K_XL-kwantisatie, die ongeveer 317 GB is, op een RunPod-server geconfigureerd met:
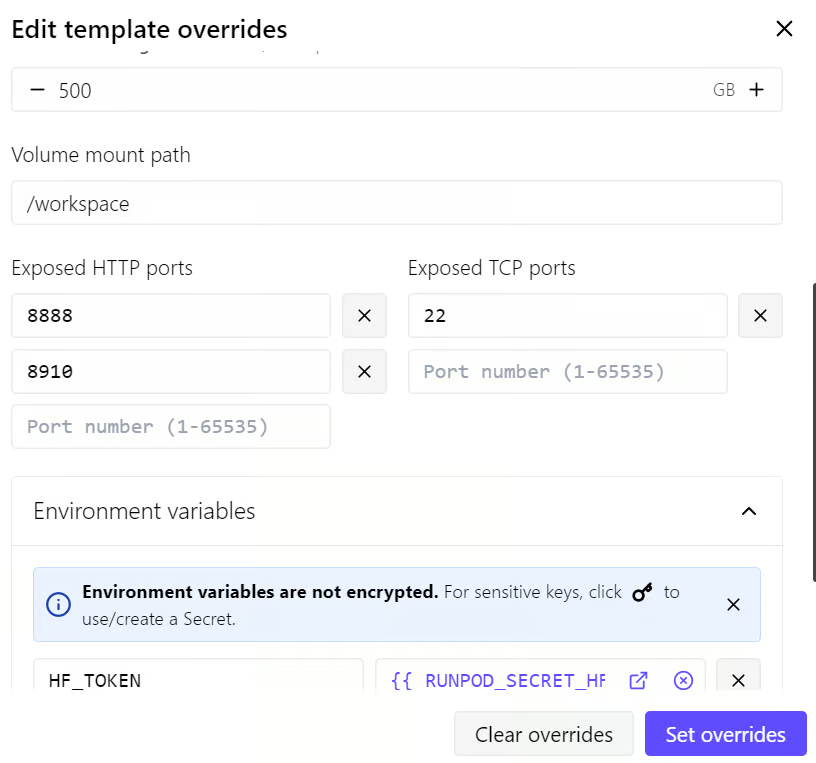
De grote modelbestanden en de Hugging Face-cache worden opgeslagen op de 500 GB volume-schijf zodat ze beschikbaar blijven als de Pod opnieuw start.
De 100 GB container-schijf wordt gebruikt voor systeempakketten, build-afhankelijkheden en andere runtimevereisten.
We configureren ook een Hugging Face-toegangstoken voordat we Inkling downloaden.
Geauthenticeerde downloads helpen anonieme snelheidslimieten te vermijden en kunnen snellere, betrouwbaardere downloads bieden, wat belangrijk is bij het downloaden van een model van deze omvang.
De standaard llama.cpp-binaries die je via het gebruikelijke curl-commando installeert, werken niet met Inkling omdat ondersteuning voor de architectuur nog niet is samengevoegd in de main branch.
Inkling-ondersteuning is momenteel beschikbaar via de experimentele pull request #25731, dus llama.cpp moet vanaf die branch gecompileerd worden.
Open na het deployen van de RunPod Pod het tabblad Connect en klik op de link Jupyter Notebook.
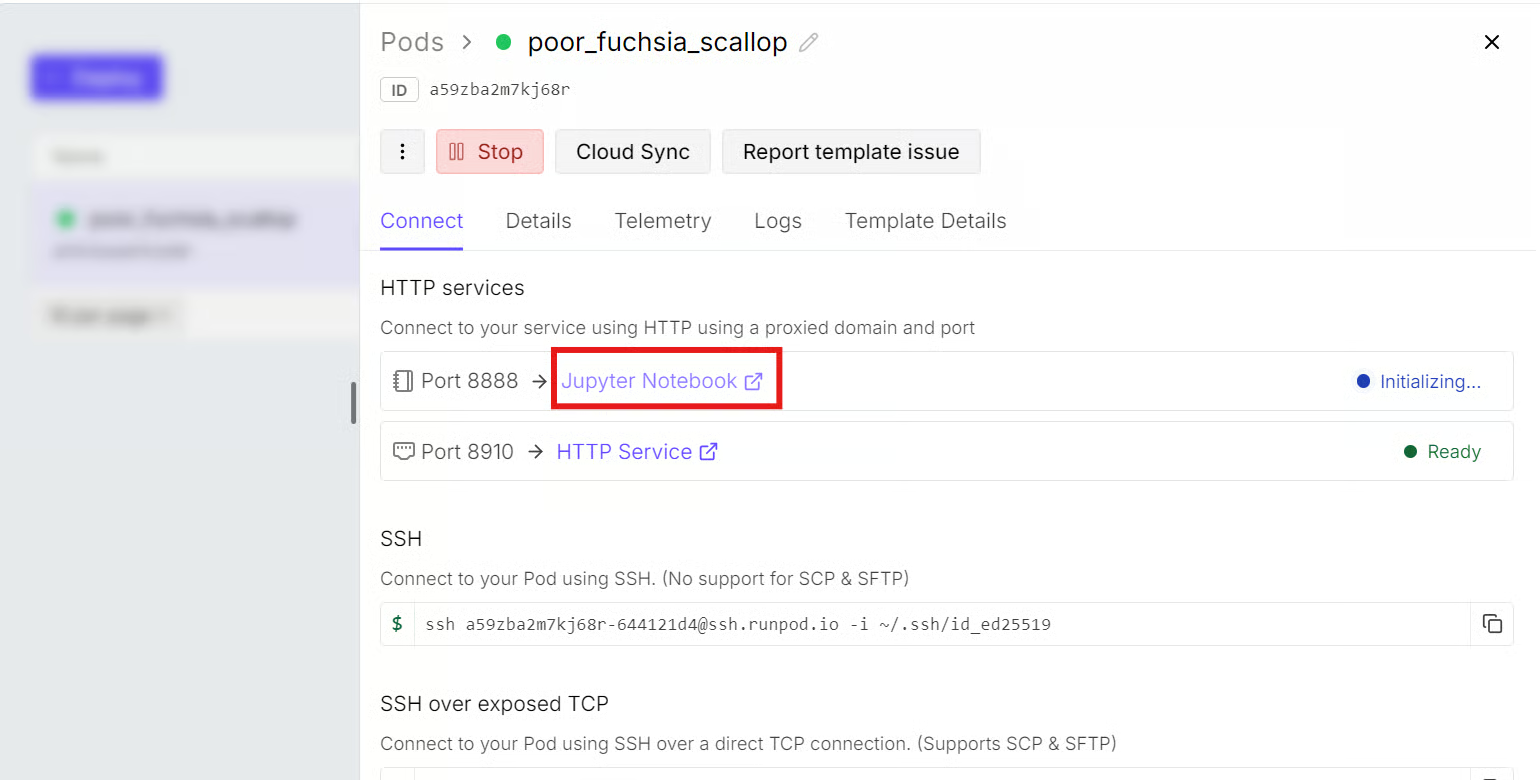
Start vanuit JupyterLab een nieuwe terminal en installeer de vereiste systeempakketten:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Kloon vervolgens llama.cpp naar het /workspace-volume en schakel over naar de branch met Inkling-ondersteuning:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Inkling-ondersteuning is momenteel beschikbaar via een experimentele concept-pull request in plaats van de main-branch van llama.cpp. Haal die branch op en schakel ernaar over:
git fetch origin pull/25731/head:inkling
git switch inkling
Bouw llama.cpp met ingeschakelde CUDA-versnelling:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Compileer de command-line interface, multimodale interface, server en GGUF-hulpprogramma’s:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"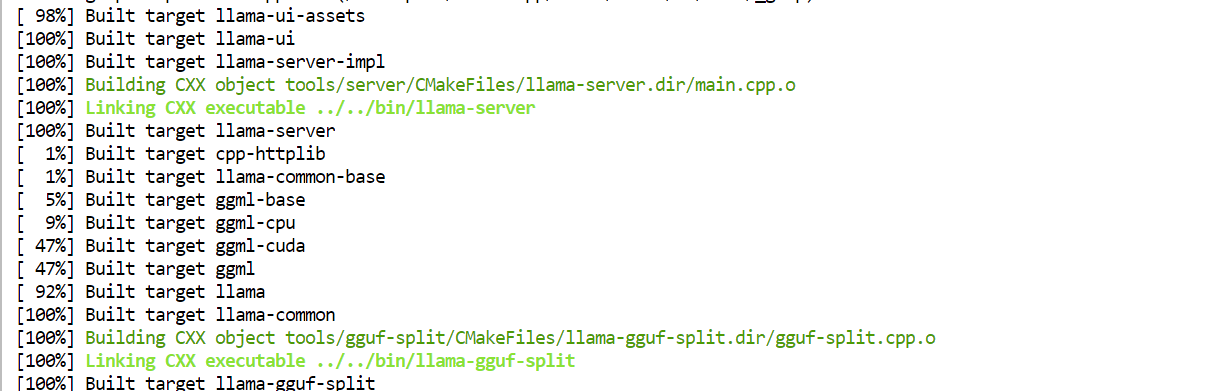
Kopieer ten slotte de gecompileerde uitvoerbare bestanden naar de hoofdmap van llama.cpp zodat ze makkelijker toegankelijk zijn:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Installeer de Hugging Face CLI en Xet-downloadondersteuning:
pip install -U huggingface_hub hf_xetHet Hugging Face-token is al toegevoegd aan de RunPod-omgevingsvariabelen toen de Pod werd gedeployed, dus extra inloggen is niet nodig.
Maak mappen aan op de 500 GB volume-schijf voor de Hugging Face-cache en het Inkling-model:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Stel de cachelocatie in en schakel high-performance downloads in:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
Download alleen de UD-Q2_K_XL-kwantisatie:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
De downloadtijd is afhankelijk van je internetverbinding.
Mijn downloadsnelheid was beperkt tot ongeveer 130 MB/s, en het model duurde ongeveer 42 minuten om te downloaden.
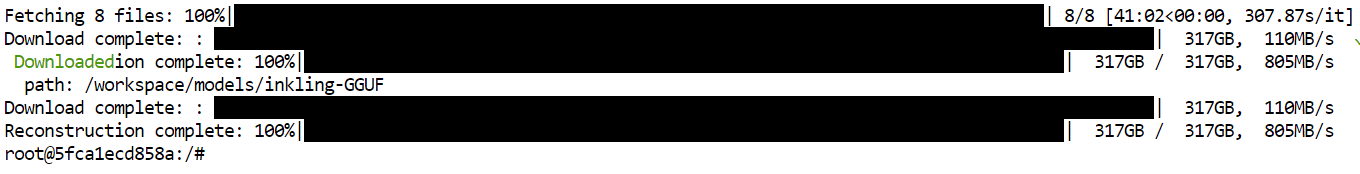
Voer het volgende commando uit om Inkling over alle vier GPU’s te laden en een OpenAI-compatibele inference-server te starten:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja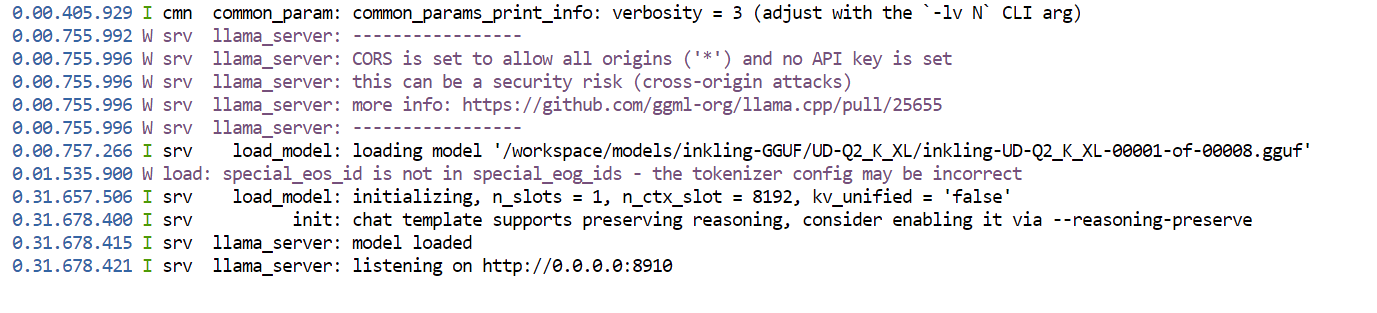
Het commando:
llama.cpp detecteert en laadt de andere zeven shards automatisch.8910.Open een andere Jupyter-terminal en controleer het GPU-gebruik:
nvidia-smi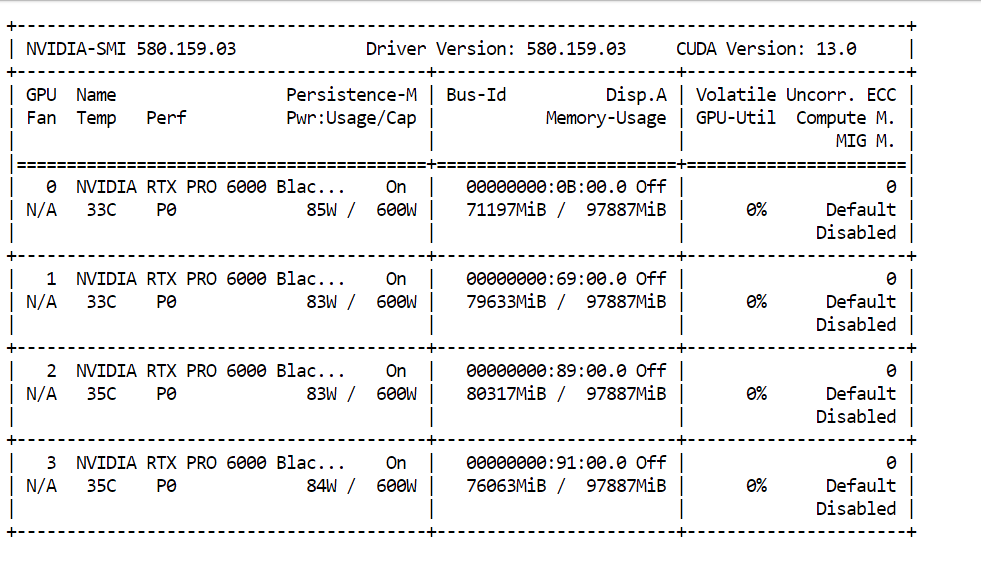
In deze setup werd ongeveer 85% van het beschikbare GPU-geheugen gebruikt na het laden van het model met een contextvenster van 8.192 tokens.
Grotere contextvensters vereisen extra KV-cachegeheugen, dus Inkling draaien met bijvoorbeeld 100.000 tokens context vraagt aanzienlijk meer beschikbaar geheugen.
De lokale OpenAI-compatibele API is beschikbaar op:
http://127.0.0.1:8910/v1Bevestig voordat je Inkling via de web-UI test eerst dat de inference-server draait en antwoorden teruggeeft. Open een nieuwe terminal en stuur een testverzoek naar de lokale API:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
De API antwoordde succesvol, verwerkte de prompt met 81,1 tokens per seconde en genereerde met 37,2 tokens per seconde.
Er werden 25 prompttokens en 256 completiontokens gebruikt, maar het stopte omdat de outputlimiet werd bereikt voordat het eindantwoord werd geproduceerd. Een hogere max_tokens laat het model de reactie afmaken.
Ga terug naar het RunPod-dashboard, open het tabblad Connect en klik op de link onder HTTP Services voor poort 8910.
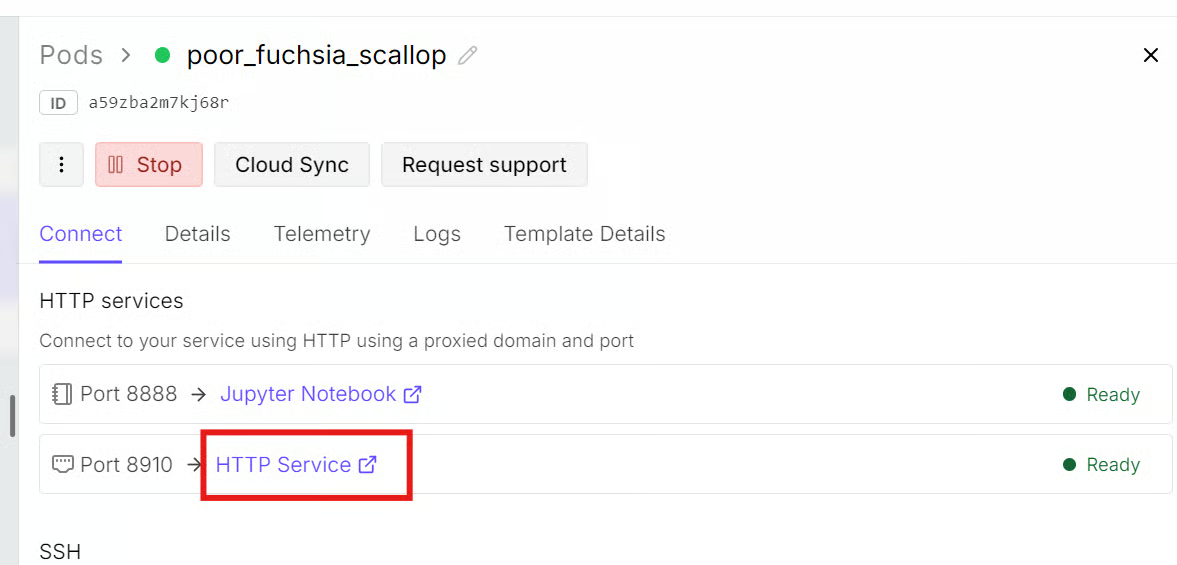
De ingebouwde web-UI van llama.cpp biedt een eenvoudige ChatGPT-achtige interface om prompts te sturen, generatie-instellingen aan te passen en reacties te bekijken.
Dezelfde server stelt ook een OpenAI-compatibele API bloot om externe applicaties en tools te koppelen.
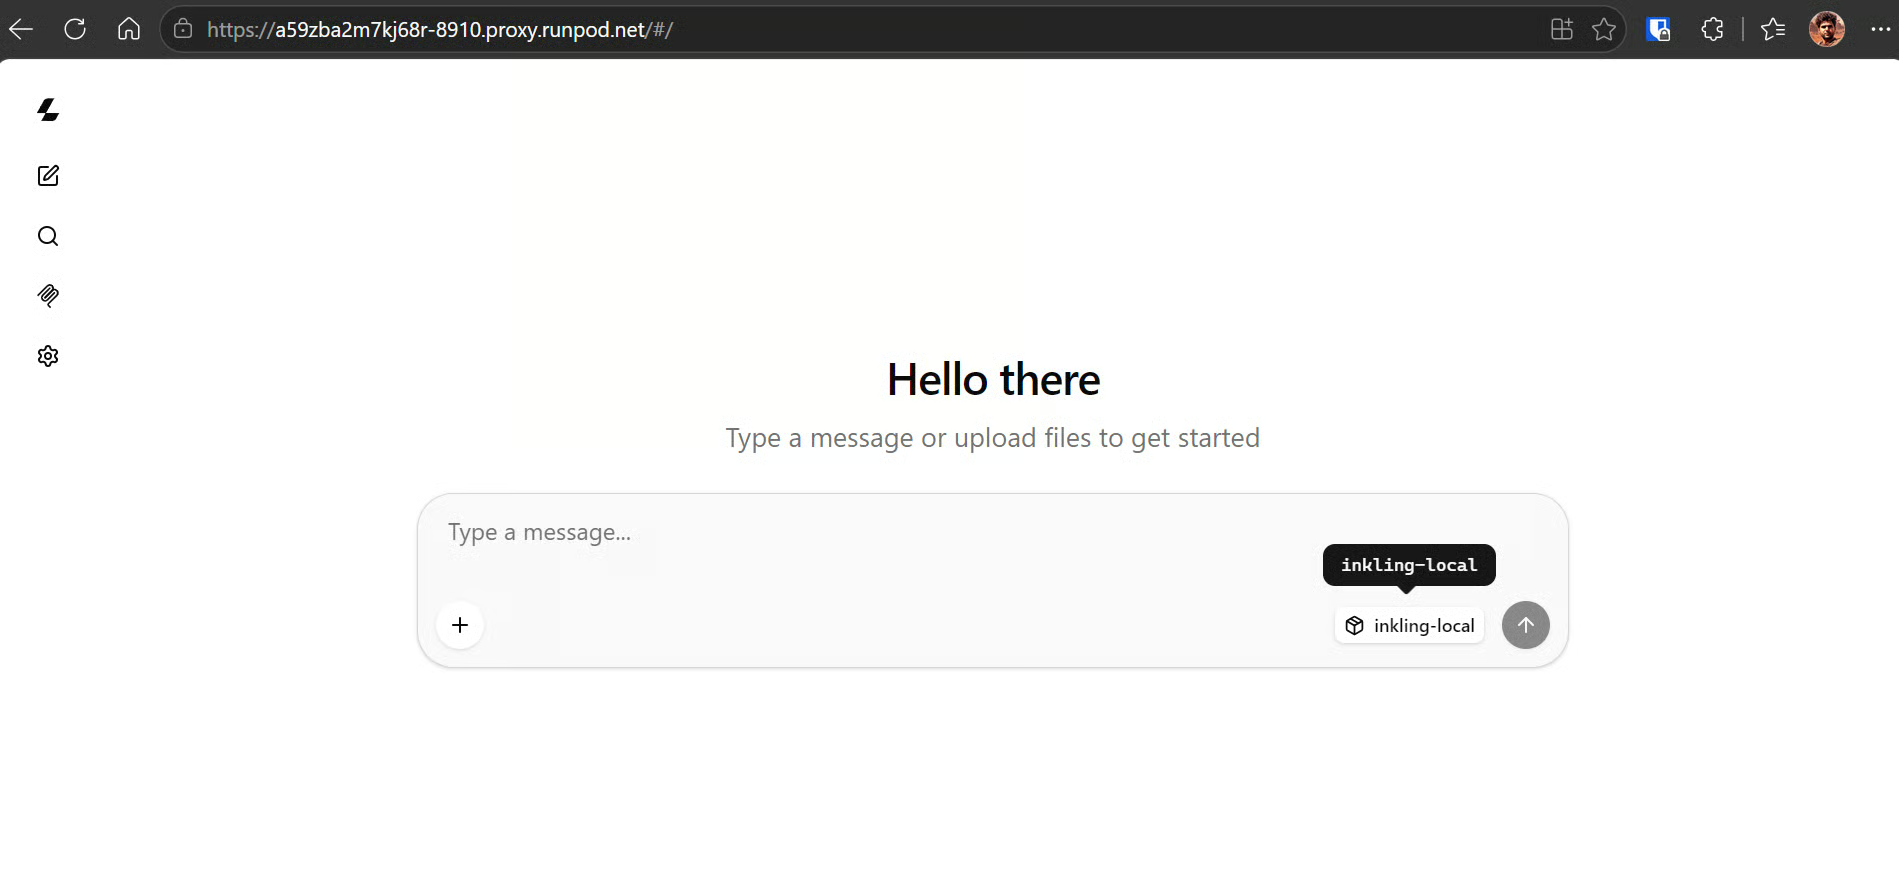
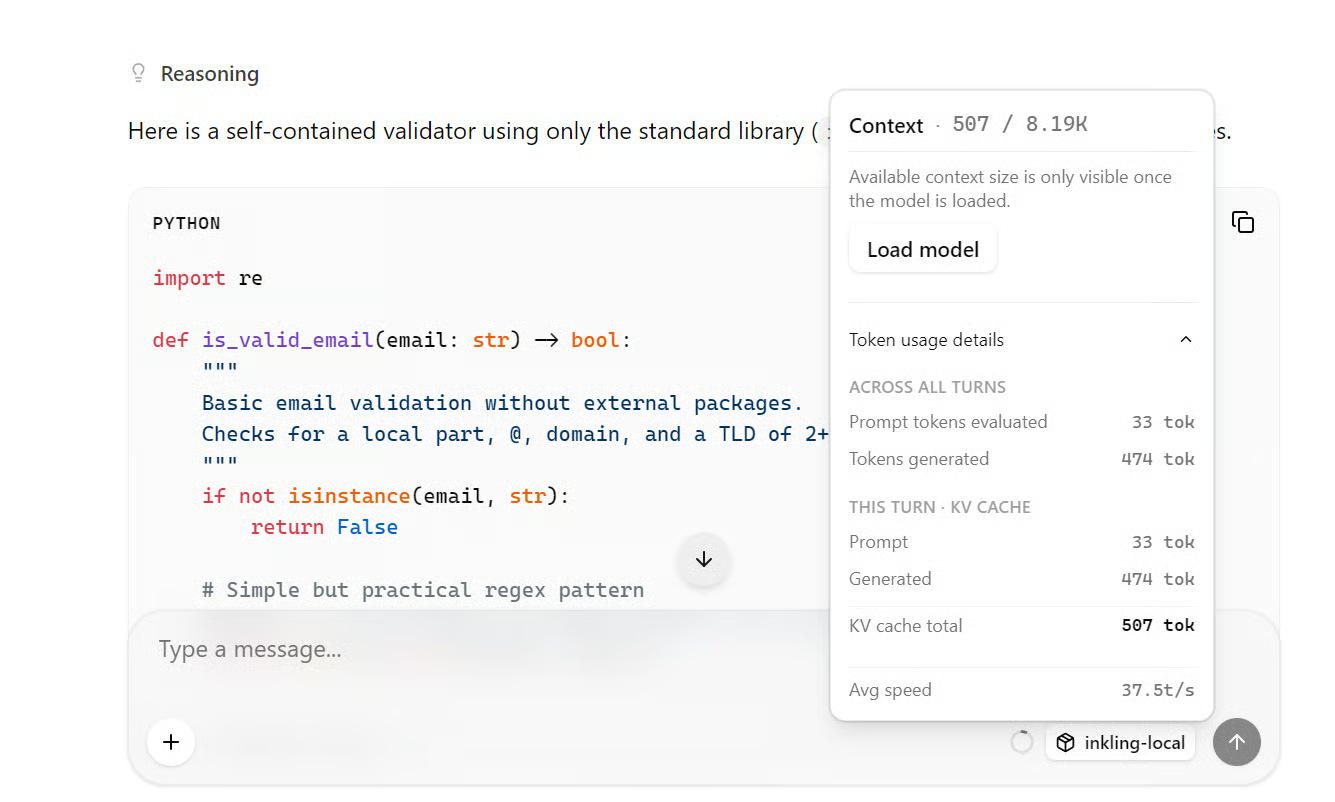
Begin met een codeprompt:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling genereerde een volledige uitleg en werkende code met een gemiddelde snelheid van ongeveer 37,5 tokens per seconde.
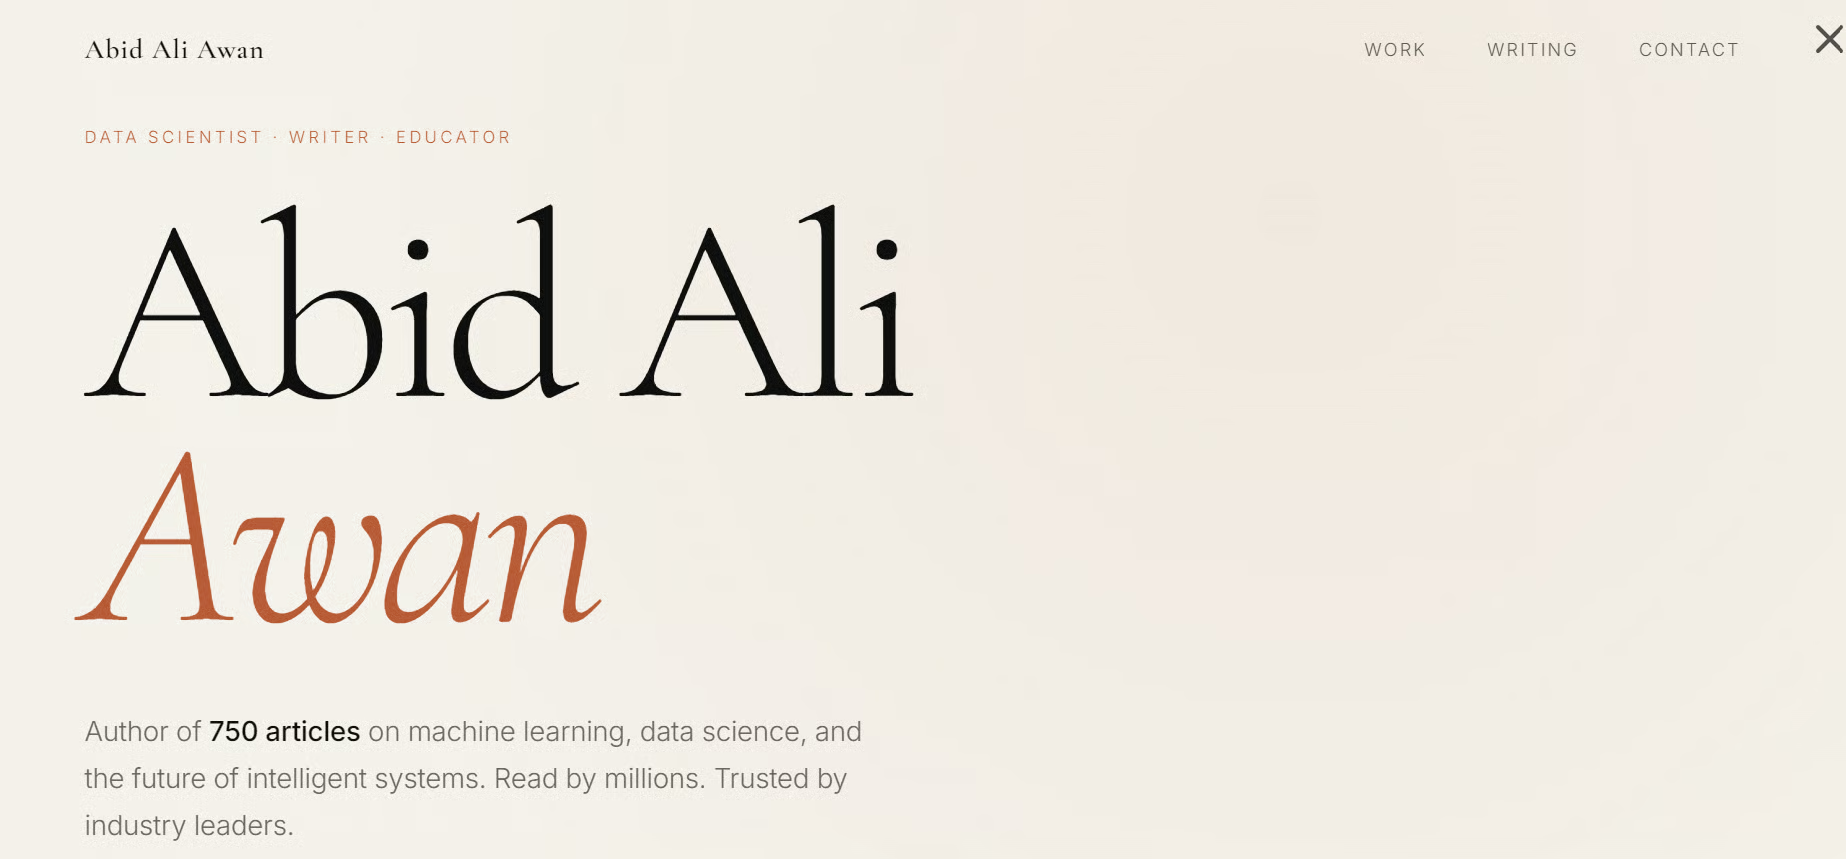
Vervolgens vroeg ik het om een persoonlijke website te maken. Ondanks het gebruik van een zwaar gekwantiseerd model produceerde Inkling een verzorgde layout, een strakke interface en functionele websitecode.
Inkling maakte op mij geen grote indruk, noch in de lokale setup, noch in de online Playground.
De reacties waren bruikbaar maar gemiddeld, en verschillende kleinere open-sourcemodellen gaven betere resultaten voor vergelijkbare taken.
Inkling is echter niet ontworpen om één categorie te domineren.
Het is een gebalanceerd, algemeen toepasbaar model dat codeer-, schrijf-, redeneer-, meertalige, visuele en audiocapaciteiten combineert. Het presteert redelijk over veel benchmarks in plaats van één specifiek gebied aan te voeren.
Voor toegewijde taken op het gebied van coderen, research of schrijven zijn er sterkere open- en closed-sourcealternatieven beschikbaar.
De waarde van Inkling zit in de flexibiliteit: het is open-weight, multimodaal, aanpasbaar en kan worden getraind of fijn-afgesteld via Tinker, het open-sourceplatform van Thinking Machines voor modeltraining en maatwerk.
Deze release heeft misschien wat van de initiële hype getemperd, maar maakte ook de koers van het bedrijf duidelijker.
Thinking Machines lijkt niet alleen te concurreren om de hoogste benchmarkscores. In plaats daarvan bouwt het aan een breder ecosysteem rond aanpasbare modellen die organisaties kunnen fine-tunen en inzetten voor veel verschillende taken.
Top DataCamp Courses
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

