Curso
Programación asistida por IA para desarrolladores
1 h 30 min
11.7K
Thinking Machines Lab es una empresa de investigación y producto en IA fundada por Mira Murati, ex directora de tecnología de OpenAI y, brevemente, su CEO interina. Tras salir de OpenAI en septiembre de 2024, Murati reunió a un equipo de investigadores de IA con amplia experiencia y levantó aproximadamente 2.000 millones de dólares con una valoración de 12.000 millones. La magnitud de la financiación y el talento generó grandes expectativas de que Thinking Machines pudiera convertirse en un serio competidor de laboratorios de IA establecidos como OpenAI.
Inkling es el primer gran modelo propio de la compañía y el primero de una familia planificada. Es un modelo multimodal de pesos abiertos diseñado para razonamiento, programación, uso de herramientas y personalización, que ofrece la primera visión clara de lo que Murati y su equipo han estado construyendo.
En esta guía, te mostraré cómo ejecutar Inkling en local, primero probándolo en el Tinker Playground gratuito. Después te enseñaré a descargar una cuantización GGUF de Unsloth, compilar la rama experimental de llama.cpp, ejecutar el modelo en cuatro GPU NVIDIA RTX PRO 6000 y a interactuar con él a través de la interfaz web integrada y la API compatible con OpenAI.
Inkling es un modelo multimodal de propósito general con pesos abiertos de Thinking Machines Lab.
Emplea una arquitectura de Mixture-of-Experts con 975.000 millones de parámetros totales y 41.000 millones activos, admite entradas de texto, imagen y audio, y ofrece una ventana de contexto de hasta un millón de tokens.
El modelo está pensado para razonamiento, programación, uso de herramientas, seguimiento de instrucciones y ajuste fino en distintos dominios.
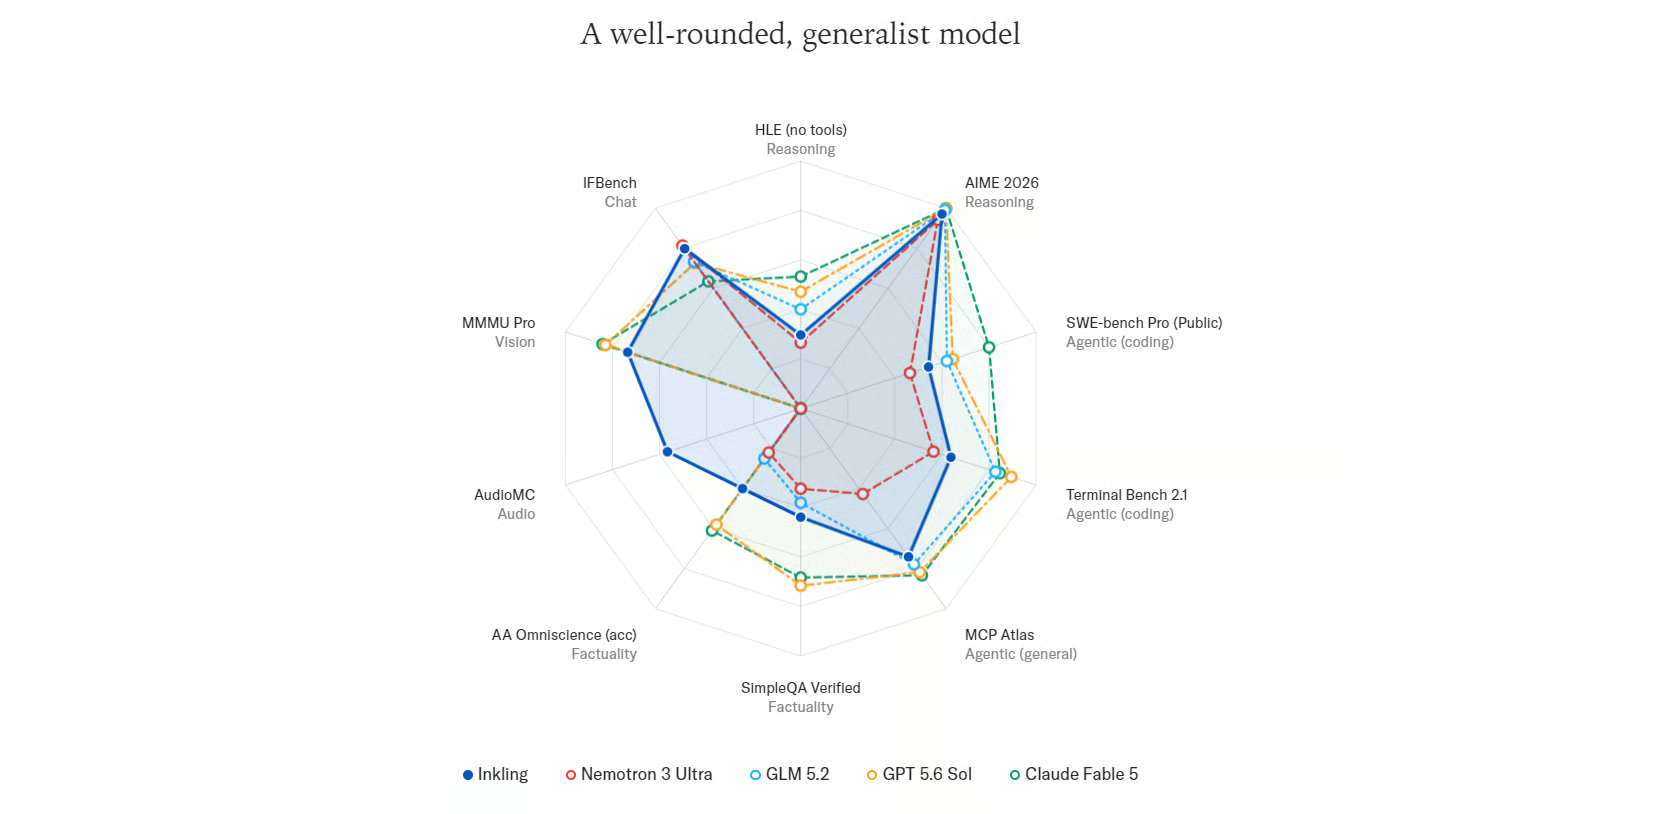
Fuente: Inkling - Thinking Machines Lab
Inkling es un modelo generalista muy completo, con un rendimiento equilibrado en benchmarks de razonamiento, programación con agentes, factualidad, visión y audio.
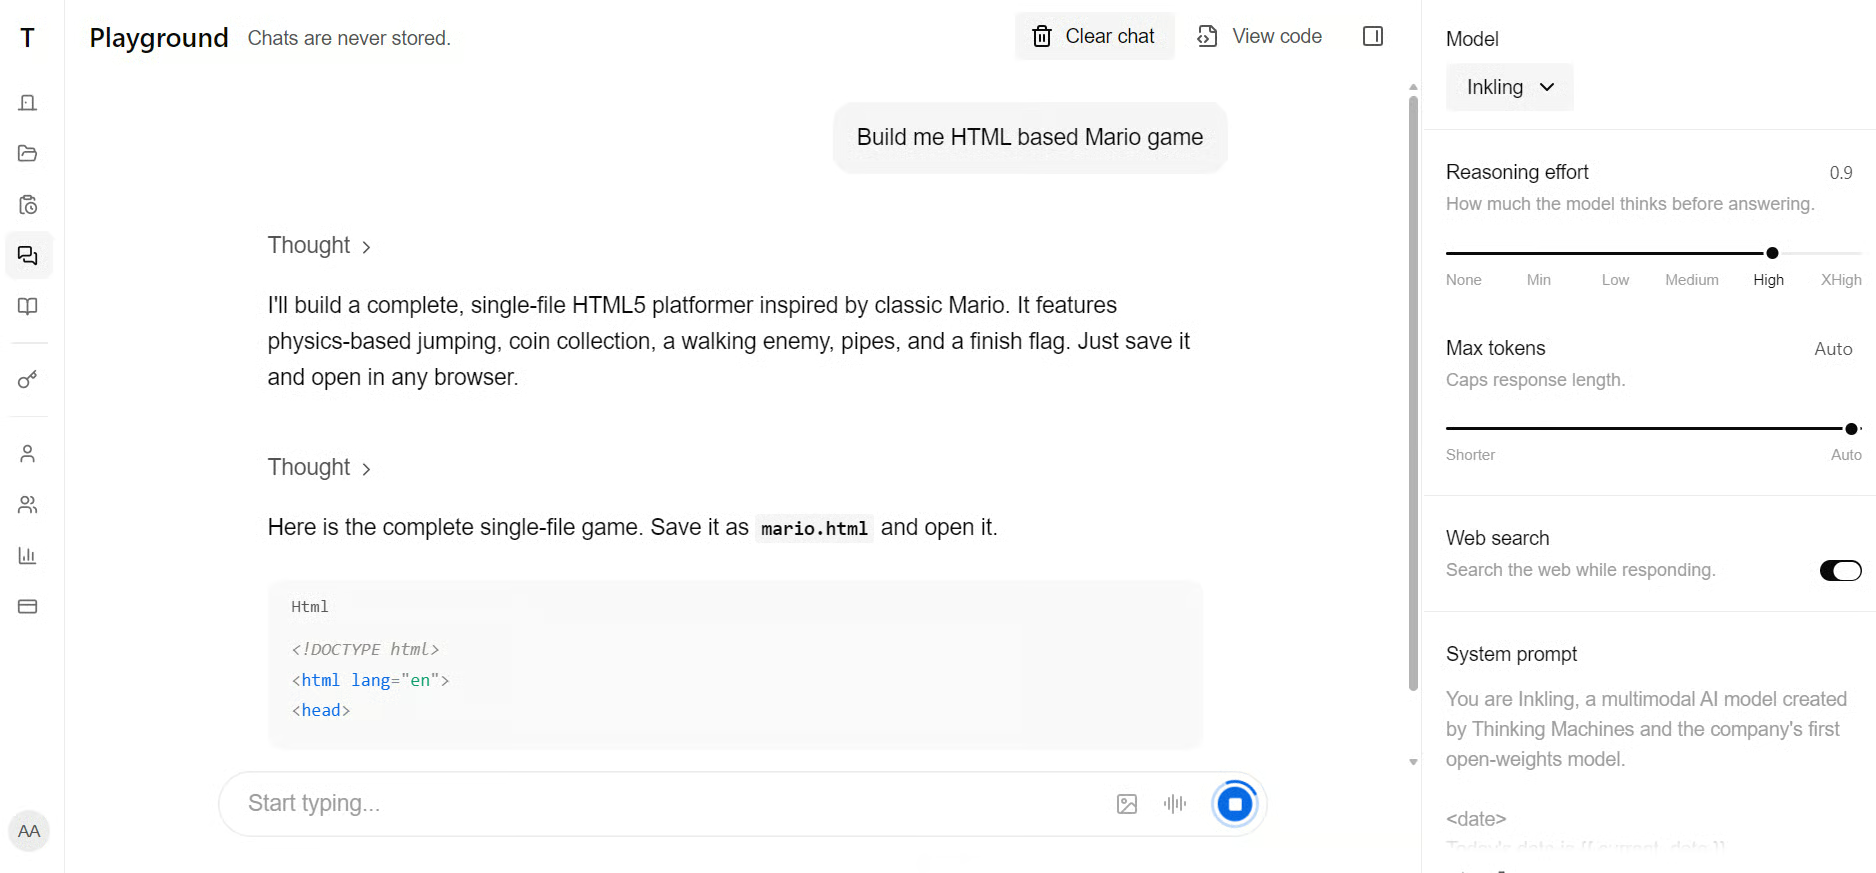
Antes de ejecutarlo en local, pruébalo en el Inkling Playground para explorar sus respuestas y entender cómo funciona el modelo. El acceso gratuito está disponible por tiempo limitado.
Ejecutar Inkling en local requiere hardware de nivel empresarial.
La cuantización UD-Q4_K_XL de Unsloth ocupa aproximadamente 587 GB, mientras que el modelo en precisión completa BF16 requiere en torno a 1,89 TB.
Esta memoria puede venir de RAM y VRAM combinadas, memoria unificada o solo RAM, aunque la inferencia solo con CPU será mucho más lenta.
También se necesita memoria adicional para la ventana de contexto y la sobrecarga en tiempo de ejecución.
Para esta guía, usamos la cuantización UD-Q2_K_XL, más pequeña, que ocupa aproximadamente 317 GB, en un servidor de RunPod configurado con:
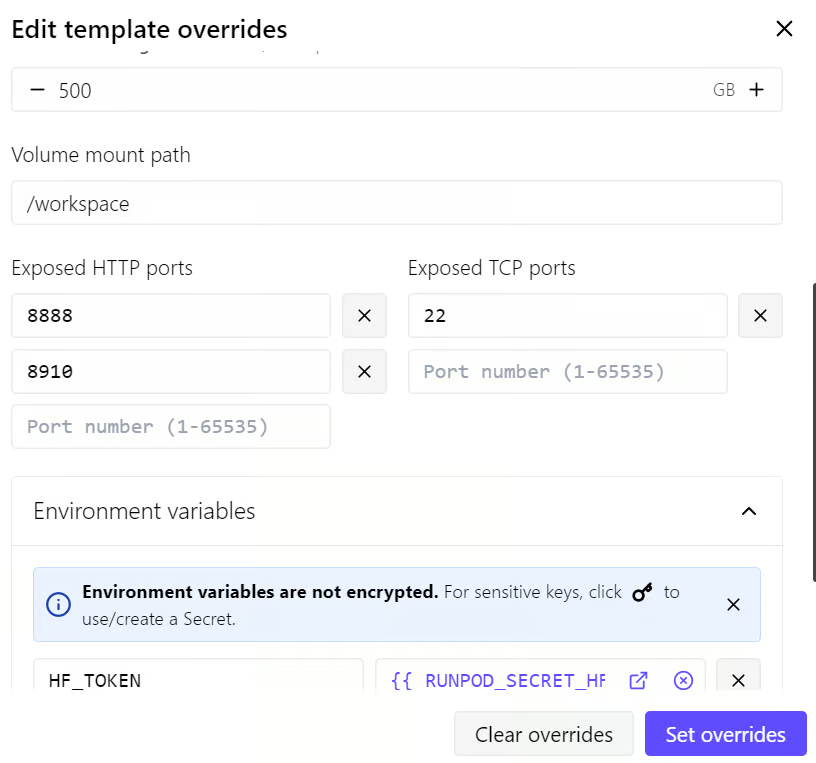
Los archivos de modelo grandes y la caché de Hugging Face se almacenarán en el disco de 500 GB para que sigan disponibles si el Pod se reinicia.
El disco del contenedor de 100 GB se usará para paquetes del sistema, dependencias de compilación y otros requisitos de ejecución.
También configuraremos un token de acceso de Hugging Face antes de descargar Inkling.
Las descargas autenticadas ayudan a evitar límites para anónimos y pueden ofrecer velocidades más rápidas y estables, algo importante al descargar un modelo de este tamaño.
Los binarios estándar de llama.cpp instalados con el comando habitual curl no funcionan con Inkling porque el soporte para su arquitectura aún no se ha fusionado en la rama principal.
Actualmente, el soporte para Inkling está disponible a través de la pull request experimental #25731, así que hay que compilar llama.cpp desde esa rama.
Tras desplegar el Pod en RunPod, abre la pestaña Connect y haz clic en el enlace de Jupyter Notebook.
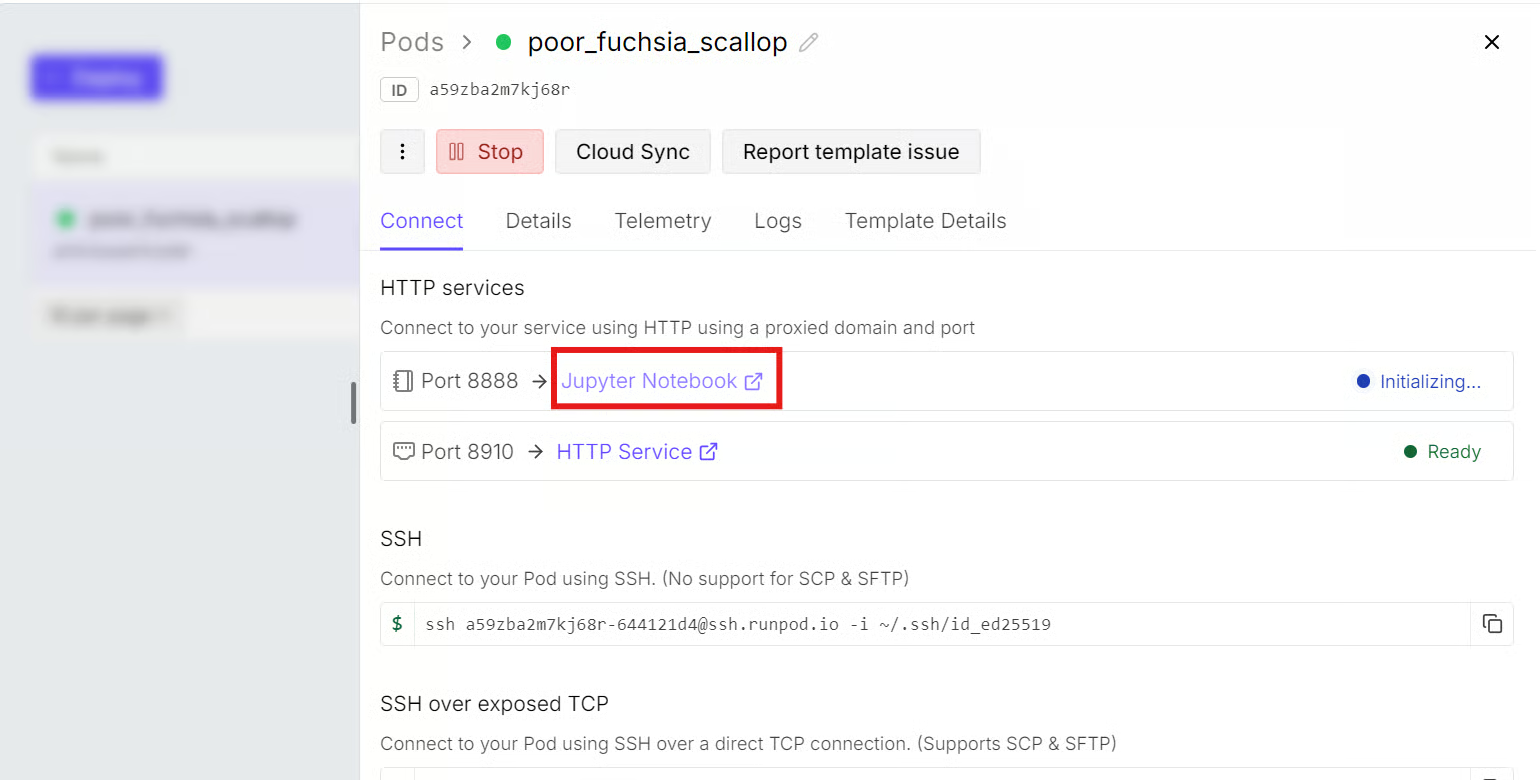
Desde JupyterLab, abre un terminal nuevo e instala los paquetes de sistema necesarios:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
A continuación, clona llama.cpp en el volumen /workspace y cambia a la rama con soporte para Inkling:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
El soporte de Inkling está disponible ahora mismo en una pull request en borrador, no en la rama principal de llama.cpp. Descarga esa rama y cámbiate a ella:
git fetch origin pull/25731/head:inkling
git switch inkling
Compila llama.cpp con aceleración CUDA activada:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Compila la interfaz de línea de comandos, la interfaz multimodal, el servidor y las utilidades GGUF:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"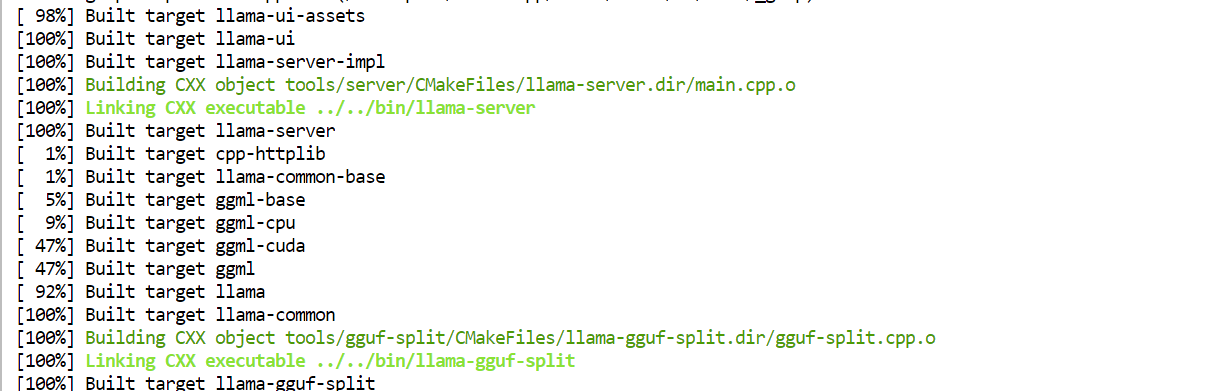
Por último, copia los ejecutables compilados al directorio principal de llama.cpp para tenerlos más a mano:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Instala la CLI de Hugging Face y el soporte de descarga Xet:
pip install -U huggingface_hub hf_xetEl token de Hugging Face ya se añadió a las variables de entorno de RunPod cuando se desplegó el Pod, así que no es necesario iniciar sesión.
Crea directorios en el disco de 500 GB para la caché de Hugging Face y el modelo de Inkling:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Define la ubicación de la caché y activa las descargas de alto rendimiento:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
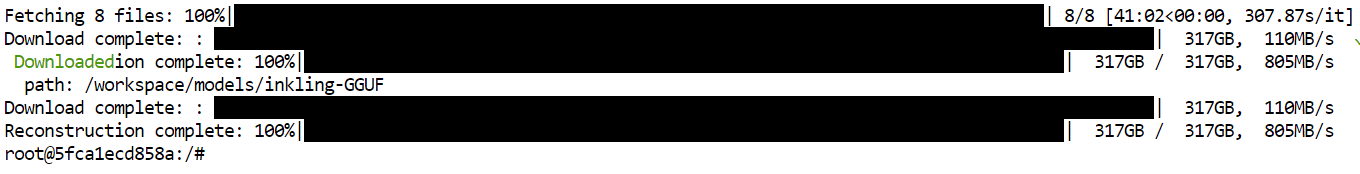
Descarga solo la cuantización UD-Q2_K_XL:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
El tiempo de descarga dependerá de tu conexión a internet.
Mi velocidad estuvo limitada a aproximadamente 130 MB/s, y el modelo tardó alrededor de 42 minutos en descargarse.
Ejecuta este comando para cargar Inkling en las cuatro GPU y lanzar un servidor de inferencia compatible con OpenAI:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja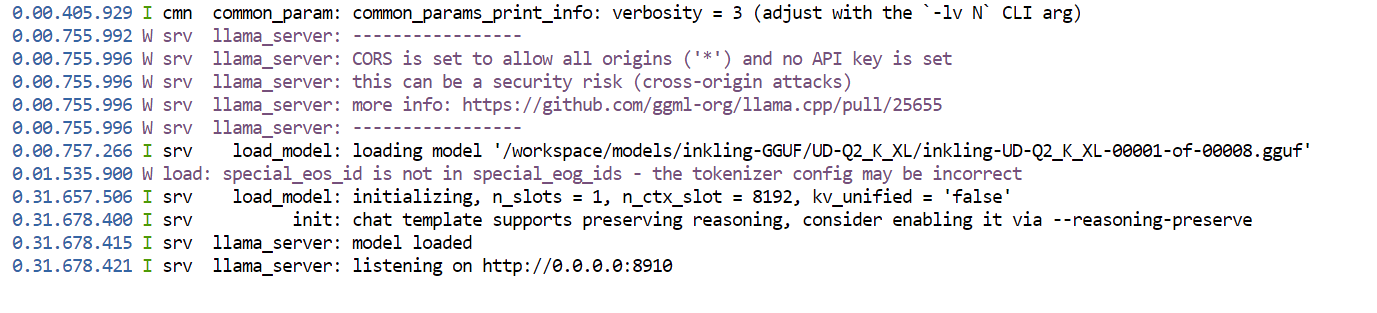
El comando:
llama.cpp detecta y carga automáticamente los otros siete.8910.Abre otro terminal de Jupyter y comprueba el uso de la GPU:
nvidia-smi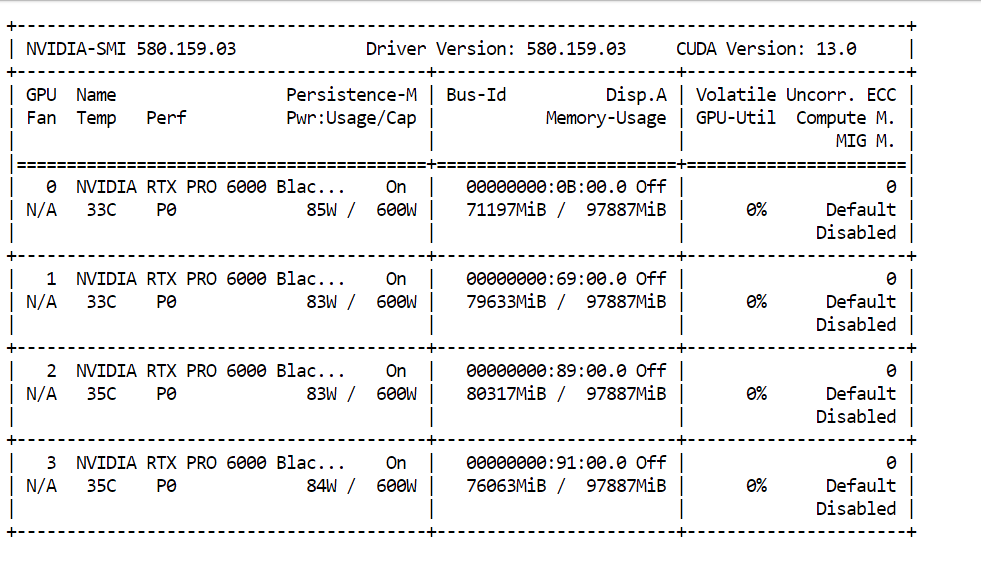
En esta configuración, aproximadamente el 85% de la memoria de GPU disponible se utilizó tras cargar el modelo con una ventana de contexto de 8.192 tokens.
Las ventanas de contexto más grandes requieren memoria adicional para la KV-cache, por lo que ejecutar Inkling con un contexto de, por ejemplo, 100.000 tokens exigiría bastante más memoria disponible.
La API local compatible con OpenAI está disponible en:
http://127.0.0.1:8910/v1Antes de probar Inkling desde la Web UI, confirma que el servidor de inferencia está en marcha y devuelve respuestas. Abre un terminal nuevo y envía una solicitud de prueba a la API local:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
La API respondió correctamente, procesando el prompt a 81,1 tokens por segundo y generando a 37,2 tokens por segundo.
Usó 25 tokens de prompt y 256 tokens de respuesta, pero se detuvo al alcanzar el límite de salida antes de producir la respuesta final. Aumentar max_tokens permite al modelo completar su respuesta.
Vuelve al panel de RunPod, abre la pestaña Connect y haz clic en el enlace listado en HTTP Services para el puerto 8910.
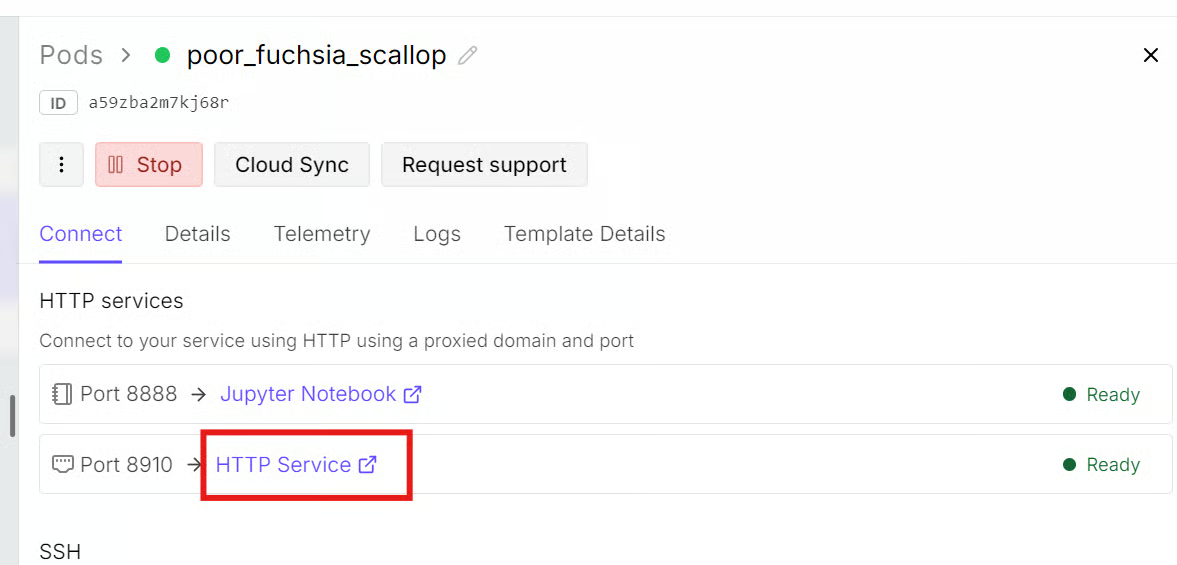
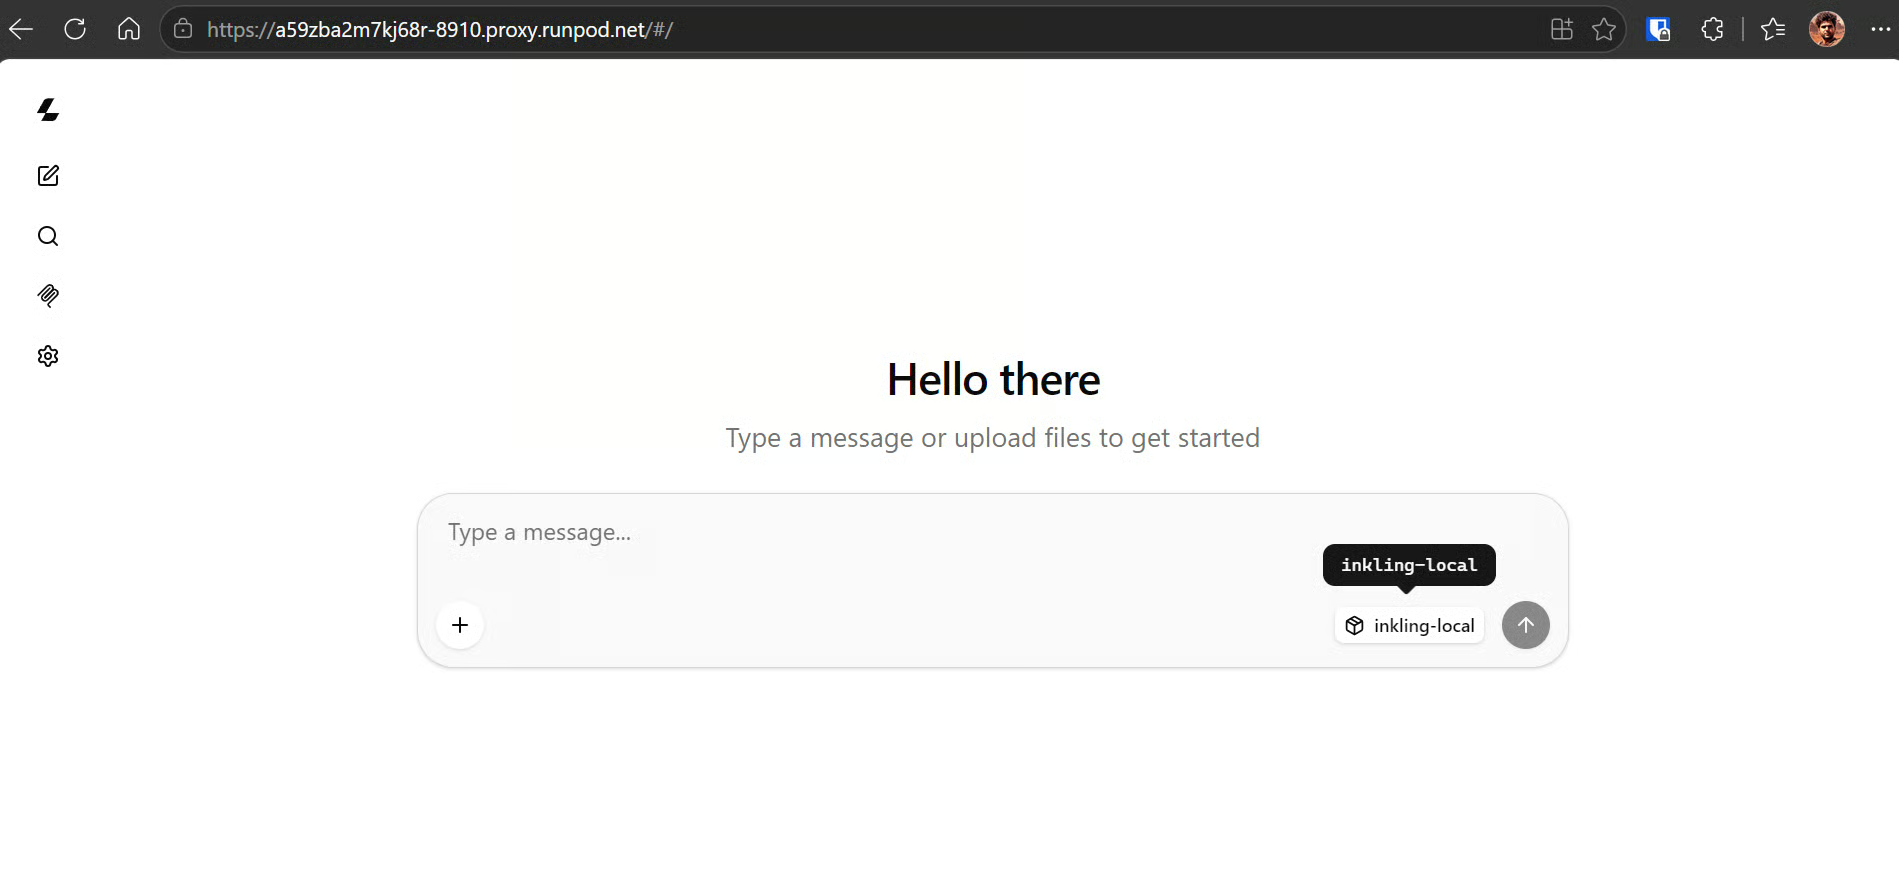
La Web UI integrada de llama.cpp ofrece una interfaz tipo ChatGPT para enviar prompts, ajustar los parámetros de generación y ver las respuestas.
El mismo servidor también expone una API compatible con OpenAI para conectar aplicaciones y herramientas externas.
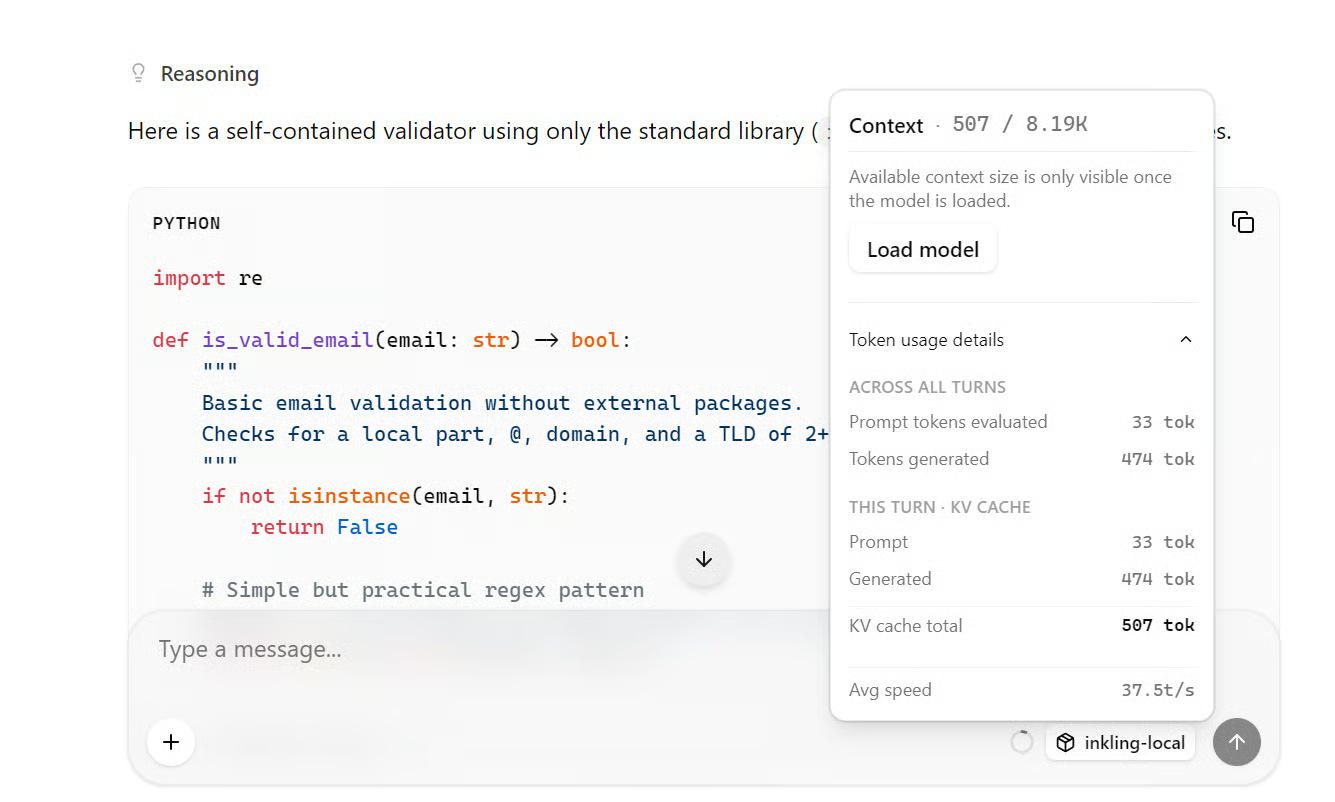
Empieza con un prompt de programación:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling generó una explicación completa y código funcional a una velocidad media de aproximadamente 37,5 tokens por segundo.
Después, le pedí que creara una web personal. A pesar de usar un modelo muy cuantizado, Inkling produjo un diseño pulido, una interfaz limpia y código funcional para la web.
Inkling no me dejó una gran impresión ni en el entorno local ni en el Playground online.
Las respuestas eran utilizables pero normales, y varios modelos open-source más pequeños ofrecieron mejores resultados en tareas similares.
Sin embargo, Inkling no está pensado para dominar una sola categoría.
Es un modelo equilibrado y de propósito general que combina capacidades de programación, escritura, razonamiento, multilingüe, visión y audio. Rinde de forma razonable en muchos benchmarks en lugar de liderar un área concreta.
Para tareas específicas de programación, investigación o escritura, hay alternativas open-source y de pago más potentes.
El valor de Inkling está en su flexibilidad: es de pesos abiertos, multimodal, personalizable y puede entrenarse o ajustarse fino a través de Tinker, la plataforma open-source de Thinking Machines para entrenamiento y personalización de modelos.
Este lanzamiento puede haber bajado parte del hype inicial, pero también ha aclarado la dirección de la empresa.
Parece que Thinking Machines no compite solo por las máximas puntuaciones en benchmarks. Está construyendo un ecosistema más amplio en torno a modelos adaptables que las organizaciones pueden ajustar y usar en multitud de tareas.
Top DataCamp Courses
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Tutorial
Zoumana Keita
11 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min