
Kurs
Geliştiriciler için Yapay Zeka Destekli Kodlama
1 sa 30 dk
11.7K
Thinking Machines Lab, OpenAI’nin eski Teknoloji Direktörü ve kısa bir süreliğine geçici CEO’su olan Mira Murati tarafından kurulan bir yapay zeka araştırma ve ürün şirketidir. Murati, Eylül 2024’te OpenAI’den ayrıldıktan sonra deneyimli bir araştırma ekibi kurdu ve 12 milyar dolarlık değerleme üzerinden yaklaşık 2 milyar dolar topladı. Bu ölçekte fon ve yetenek, Thinking Machines’in OpenAI gibi köklü yapay zeka laboratuvarlarıyla ciddi biçimde rekabet edebileceğine dair güçlü beklentiler yarattı.
Inkling şirketin ilk büyük yerli model sürümü ve planlanan bir ailenin ilk üyesidir. Akıl yürütme, kodlama, araç kullanımı ve özelleştirme için tasarlanmış, açık ağırlıklı çok modlu bir modeldir; Murati ve ekibinin ne üzerinde çalıştığına dair net bir ilk bakış sunar.
Bu kılavuzda, önce ücretsiz Tinker Playground üzerinden Inkling’i test ederek, ardından bir Unsloth GGUF kantizasyonunu indirip llama.cpp’nin deneysel Inkling dalını derleyerek, modeli dört NVIDIA RTX PRO 6000 GPU üzerinde çalıştırıp yerleşik Web UI ve OpenAI uyumlu API üzerinden etkileşim kurarak Inkling’i yerelde nasıl çalıştıracağınızı göstereceğim.
Inkling, Thinking Machines Lab’in açık ağırlıklı, genel amaçlı çok modlu bir modelidir.
Mixture-of-Experts mimarisi kullanır; toplam 975 milyar parametreye ve 41 milyar etkin parametreye sahiptir, metin, görsel ve ses girdilerini destekler ve bir milyon tokene kadar bağlam penceresi sunar.
Model; akıl yürütme, kodlama, araç kullanımı, yönerge izleme ve farklı alanlarda ince ayar için tasarlanmıştır.
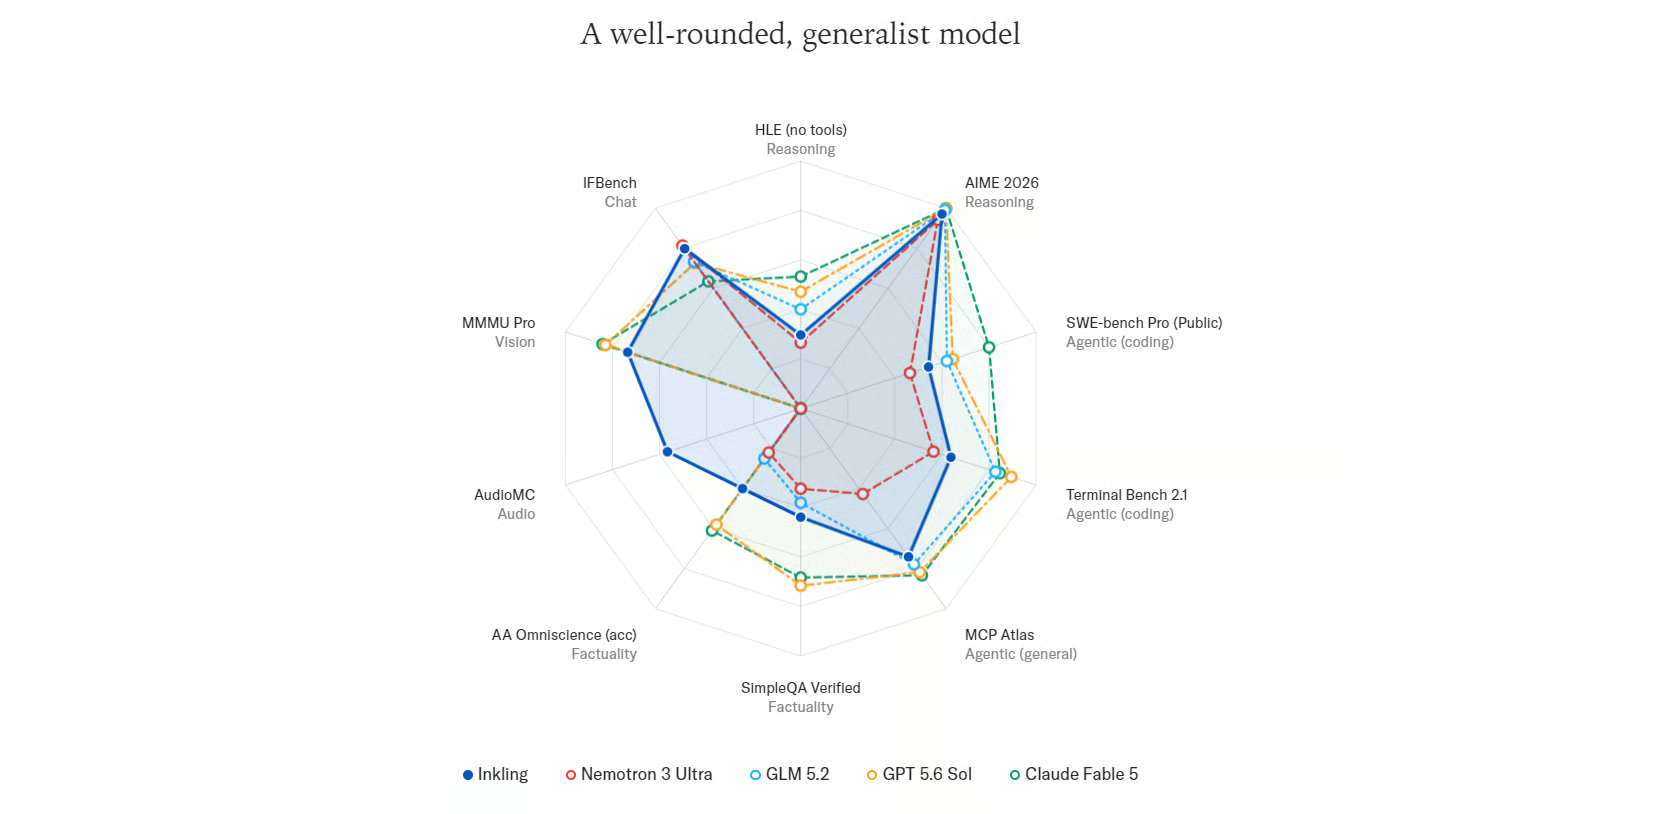
Kaynak: Inkling - Thinking Machines Lab
Inkling, akıl yürütme, özerk kodlama, olgusal doğruluk, görsel ve ses kıyaslarında dengeli performans veren, çok yönlü bir genelci modeldir.
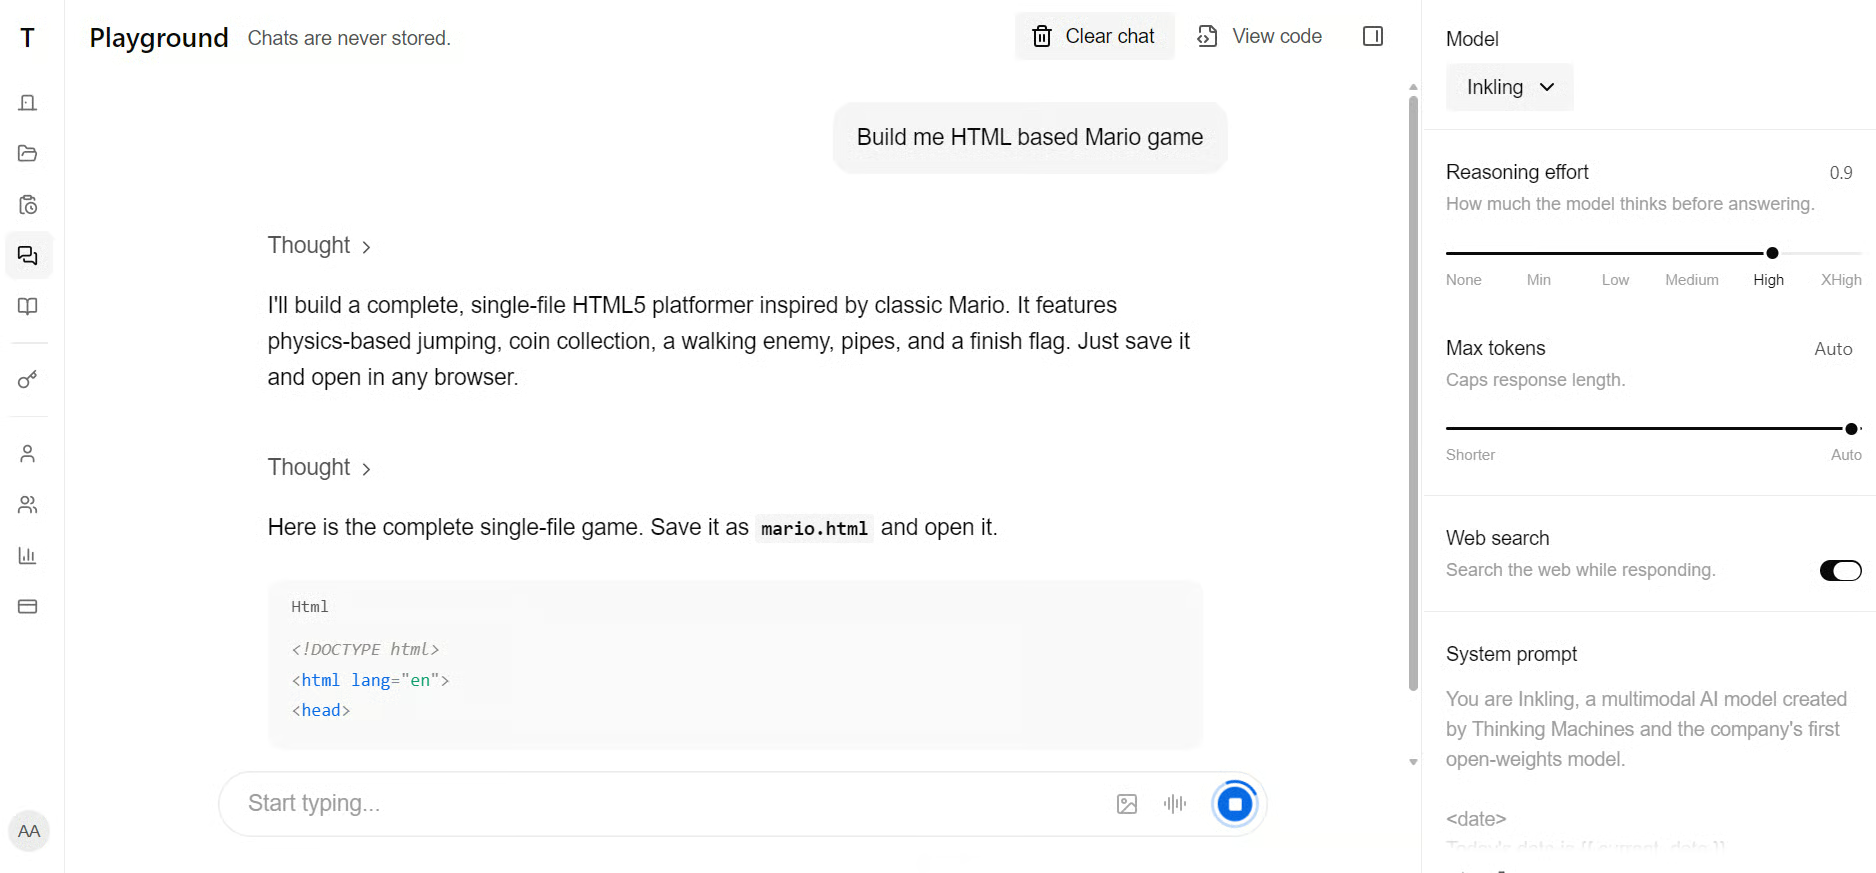
Inkling’i yerelde çalıştırmadan önce, yanıtlarını keşfetmek ve modelin nasıl çalıştığını anlamak için Inkling Playground üzerinden deneyin. Şu anda sınırlı bir süre için ücretsiz erişim mevcuttur.
Inkling’i yerelde çalıştırmak kurumsal düzeyde donanım gerektirir.
Unsloth’un UD-Q4_K_XL kantizasyonu yaklaşık 587 GB iken, tam hassasiyetli BF16 model yaklaşık 1,89 TB gerektirir.
Bu bellek birleşik RAM ve VRAM’den, birleşik bellekten veya yalnızca RAM’den gelebilir; ancak yalnızca CPU ile çıkarım çok daha yavaş olacaktır.
Bağlam penceresi ve çalışma zamanı üstverileri için de ek belleğe ihtiyaç vardır.
Bu kılavuzda, UD-Q2_K_XL kantizasyonu gibi daha küçük bir sürümü kullanacağız; bu yaklaşık 317 GB’dır ve şu yapılandırmaya sahip bir RunPod sunucusunda çalıştırılacaktır:
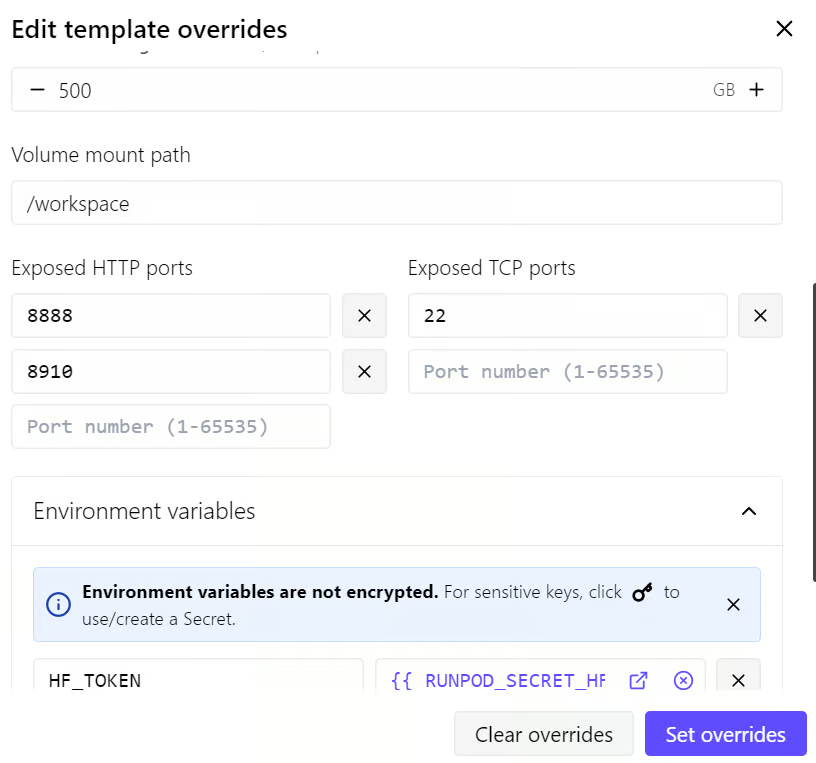
Büyük model dosyaları ve Hugging Face önbelleği, Pod yeniden başlatılırsa kullanılabilir kalmaları için 500 GB’lık hacim diskinde saklanacaktır.
100 GB’lık konteyner diski ise sistem paketleri, derleme bağımlılıkları ve diğer çalışma zamanı gereksinimleri için kullanılacaktır.
Inkling’i indirmeden önce bir Hugging Face erişim belirteci de yapılandıracağız.
Kimlik doğrulamalı indirmeler anonim hız sınırlamalarından kaçınmaya yardımcı olur ve bu boyutta bir modeli indirirken önemli olan daha hızlı ve güvenilir indirme hızları sağlayabilir.
Alışıldık curl komutu ile kurulan standart llama.cpp ikilileri, mimarisine yönelik destek henüz ana dala eklenmediğinden Inkling ile çalışmayacaktır.
Inkling desteği şu anda deneysel #25731 numaralı çekme isteği üzerinden mevcuttur; bu nedenle llama.cpp’nin bu daldan derlenmesi gerekir.
RunPod Pod’unu dağıttıktan sonra Connect sekmesini açın ve Jupyter Notebook bağlantısına tıklayın.
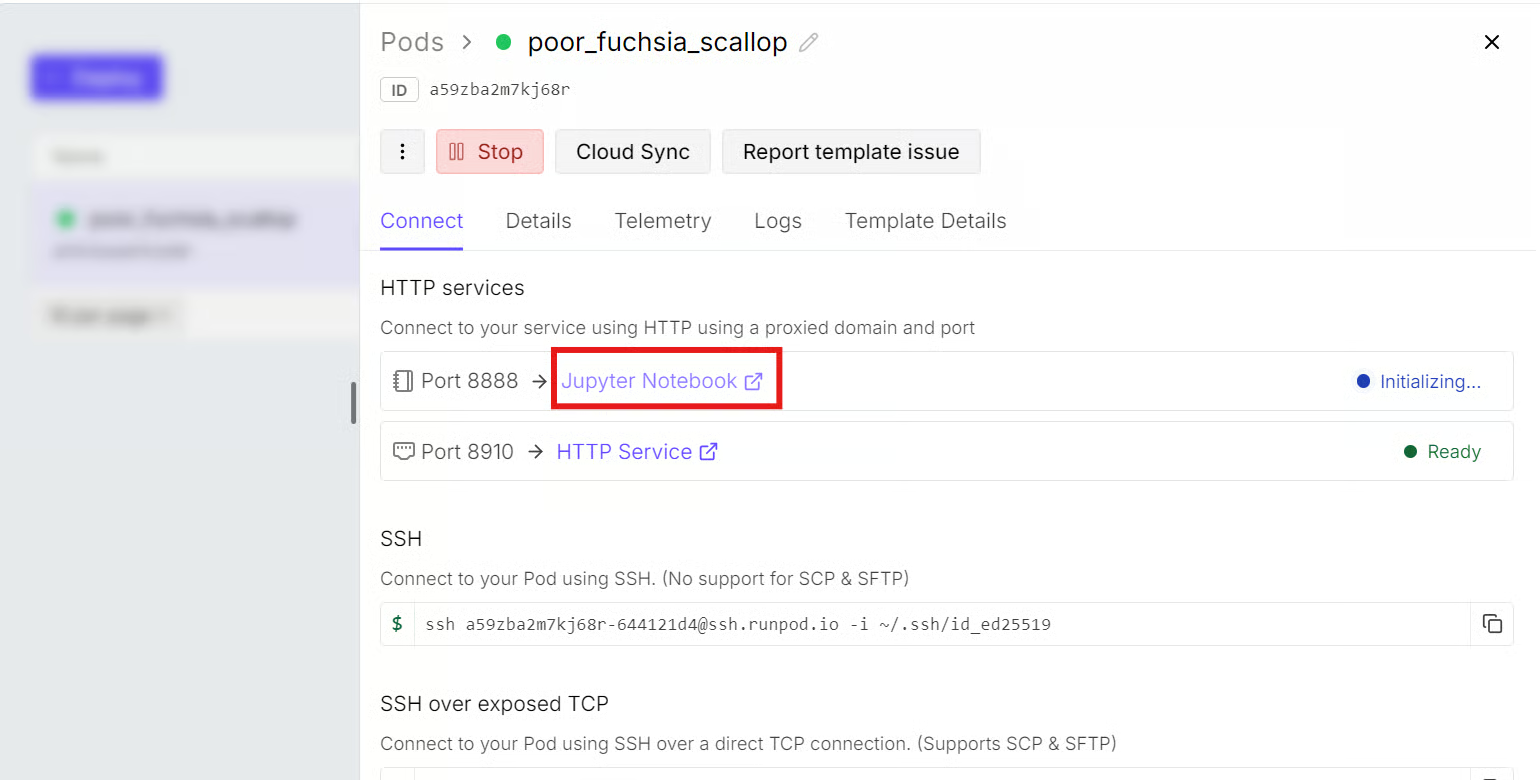
JupyterLab’den yeni bir terminal başlatın ve gerekli sistem paketlerini kurun:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
Ardından, llama.cpp’yi /workspace hacmine klonlayın ve Inkling desteği içeren dala geçin:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Inkling desteği şu anda ana llama.cpp dalından ziyade deneysel bir taslak çekme isteği ile sunulmaktadır. Bu dalı alın ve ona geçin:
git fetch origin pull/25731/head:inkling
git switch inkling
CUDA hızlandırması etkinleştirilmiş şekilde llama.cpp derleyin:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
Komut satırı arayüzünü, çok modlu arayüzü, sunucuyu ve GGUF yardımcı programlarını derleyin:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"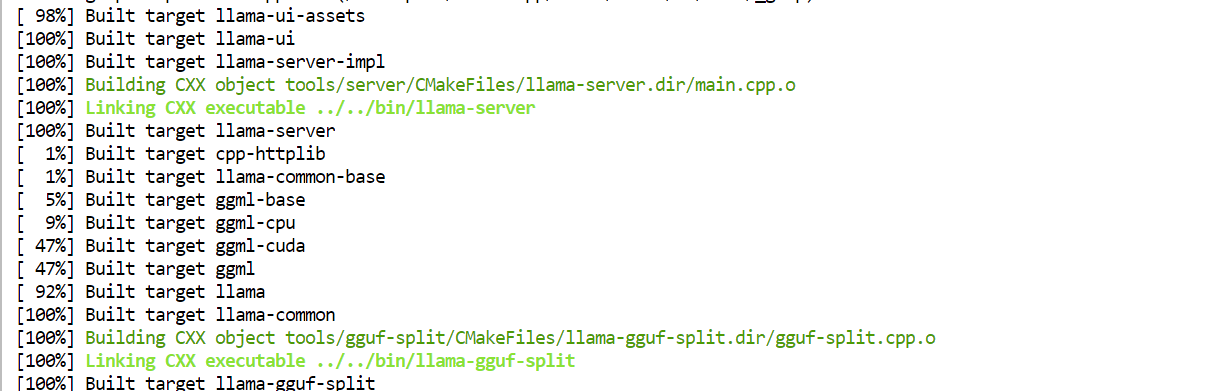
Son olarak, derlenen yürütülebilir dosyaları erişimi kolaylaştırmak için ana llama.cpp dizinine kopyalayın:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/Hugging Face CLI ve Xet indirme desteğini kurun:
pip install -U huggingface_hub hf_xetHugging Face belirteci, Pod dağıtılırken zaten RunPod ortam değişkenlerine eklendi; bu nedenle ek bir oturum açma gerekmez.
Hugging Face önbelleği ve Inkling modeli için 500 GB’lık hacim diskinde dizinler oluşturun:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
Önbellek konumunu ayarlayın ve yüksek performanslı indirmeleri etkinleştirin:
export HF_HOME=/workspace/models/huggingface
export HF_XET_HIGH_PERFORMANCE=1
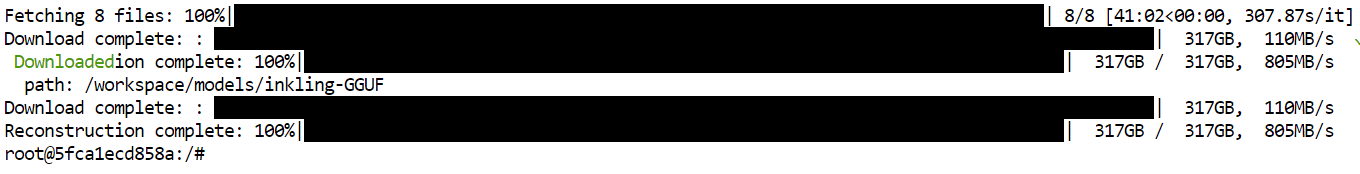
Yalnızca UD-Q2_K_XL kantizasyonunu indirin:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
İndirme süresi internet bağlantınıza bağlı olacaktır.
Benim indirme hızım yaklaşık 130 MB/sn ile sınırlıydı ve modelin inmesi yaklaşık 42 dakika sürdü.
Inkling’i tüm dört GPU’ya yüklemek ve OpenAI uyumlu bir çıkarım sunucusu başlatmak için aşağıdaki komutu çalıştırın:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja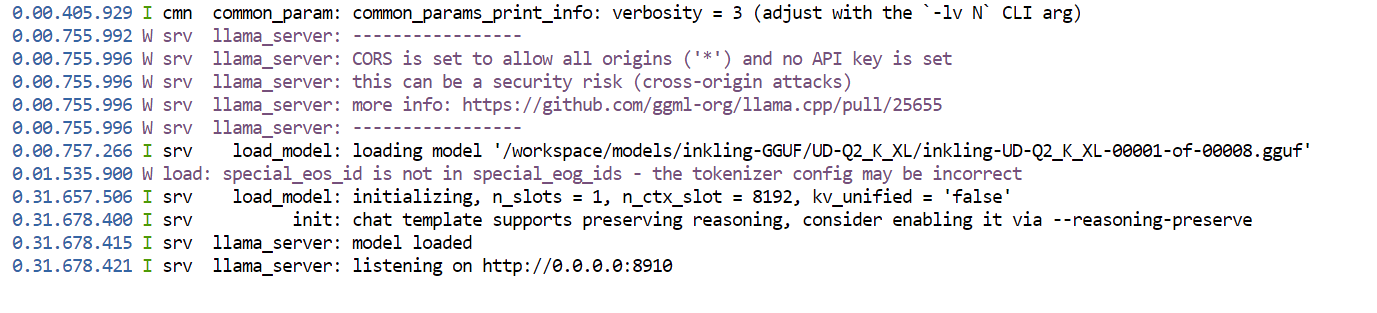
Bu komut:
llama.cpp diğer yedi parçayı otomatik olarak algılar ve yükler.8910 portunda başlatır.Başka bir Jupyter terminali açın ve GPU kullanımını kontrol edin:
nvidia-smi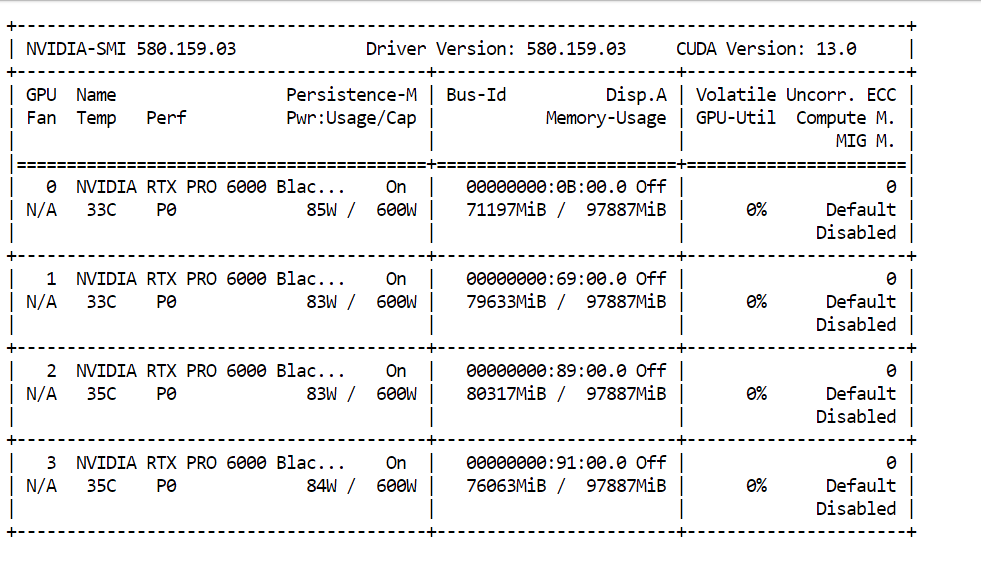
Bu kurulumda, model 8.192 tokenlık bağlam penceresiyle yüklendikten sonra mevcut GPU belleğinin yaklaşık %85’i kullanıldı.
Daha büyük bağlam pencereleri ek KV-önbellek belleği gerektirir; dolayısıyla Inkling’i 100.000 token gibi bir bağlamla çalıştırmak kayda değer ölçüde daha fazla bellek gerektirecektir.
Yerel OpenAI uyumlu API şu adreste kullanılabilir:
http://127.0.0.1:8910/v1Inkling’i Web UI üzerinden test etmeden önce, çıkarım sunucusunun çalıştığını ve yanıt döndürdüğünü doğrulayın. Yeni bir terminal açın ve yerel API’ye bir test isteği gönderin:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
API başarıyla yanıt döndürdü; istemi saniyede 81,1 token hızında işledi ve saniyede 37,2 token hızında çıktı üretti.
25 istem tokenı ve 256 tamamlanma tokenı kullandı; ancak nihai yanıtı üretmeden önce çıktı sınırına ulaştığı için durdu. max_tokens değerini artırmak modelin yanıtını tamamlamasına olanak tanır.
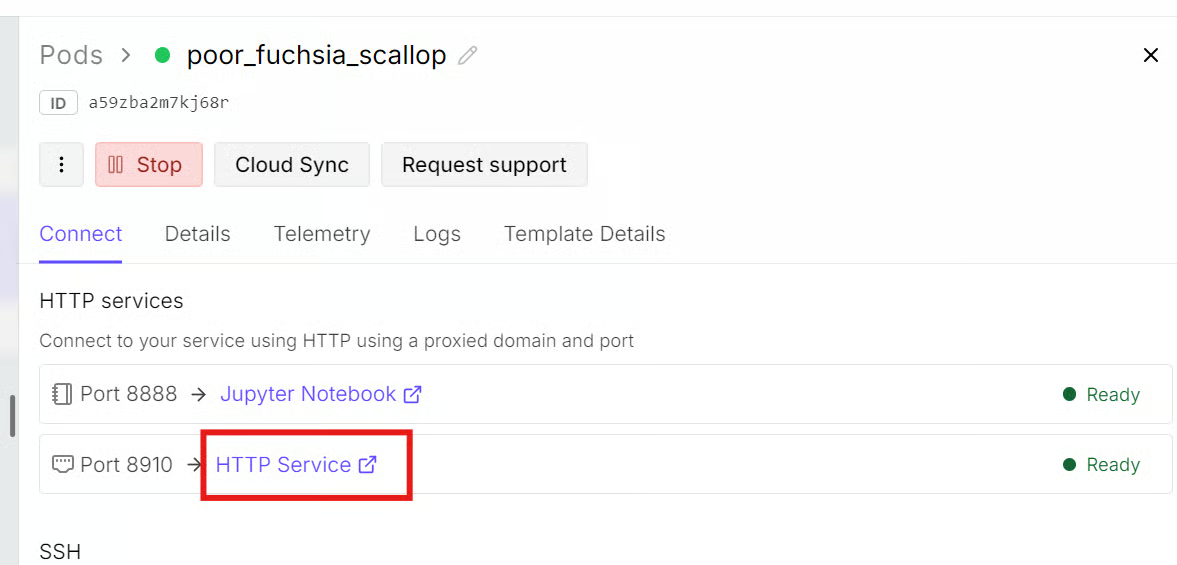
RunPod panosuna dönün, Connect sekmesini açın ve 8910 portu için HTTP Services altında listelenen bağlantıya tıklayın.
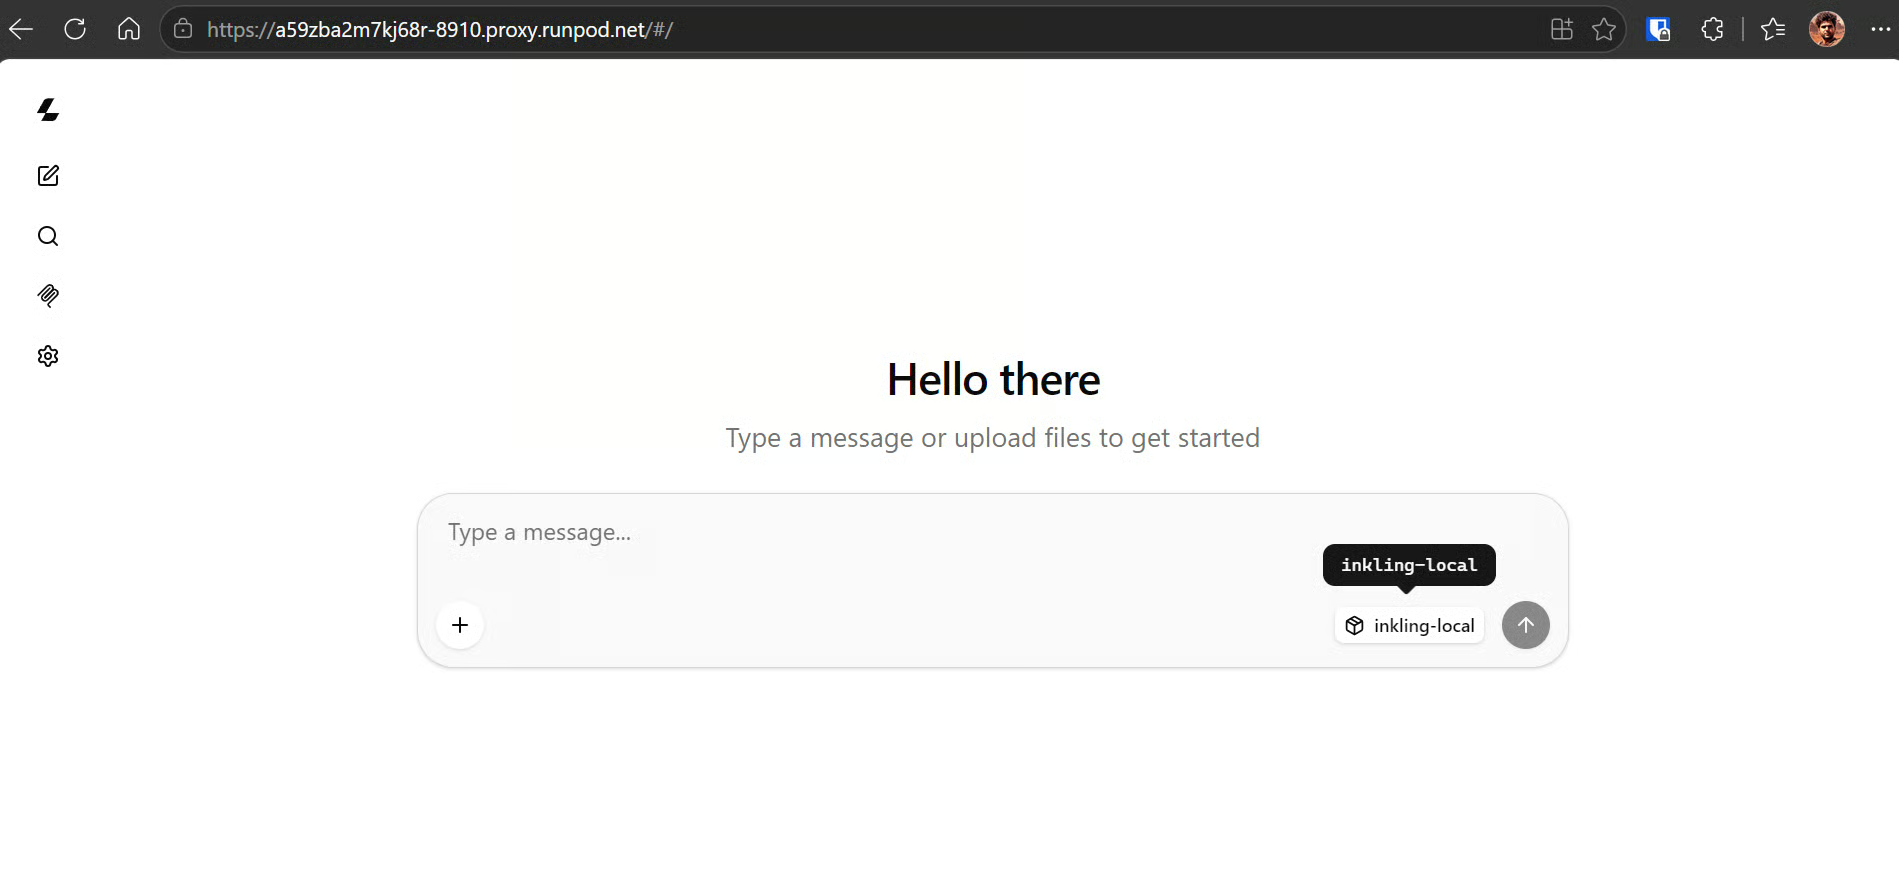
Yerleşik llama.cpp Web UI, istem göndermek, üretim ayarlarını değiştirmek ve yanıtları görüntülemek için basit, ChatGPT tarzı bir arayüz sağlar.
Aynı sunucu, harici uygulama ve araçları bağlamak için OpenAI uyumlu bir API de sunar.
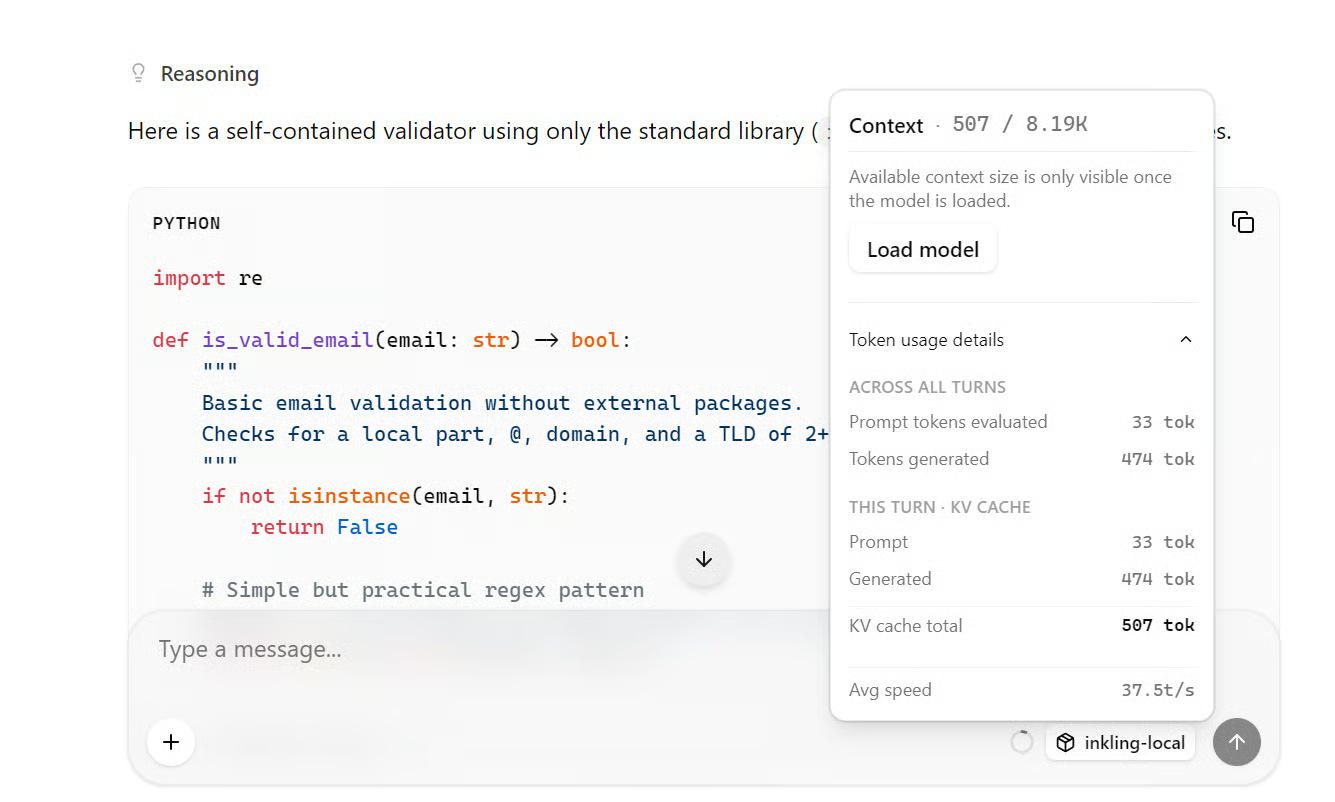
Bir kodlama istemiyle başlayın:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling, ortalama yaklaşık saniyede 37,5 token hızında, eksiksiz bir açıklama ve çalışan kod üretti.
Sonraki adımda, ondan kişisel bir web sitesi oluşturmasını istedim. Ağır şekilde kantize edilmiş bir model kullanılmasına rağmen Inkling, cilalı bir düzen, temiz bir arayüz ve işlevsel bir web sitesi kodu üretti.
Inkling beni ne yerel kurulumda ne de çevrimiçi Playground’da etkiledi.
Yanıtlar kullanılabilir olsa da ortalamaydı; benzer görevlerde birkaç daha küçük açık kaynaklı model daha iyi sonuçlar üretti.
Bununla birlikte Inkling, tek bir kategoride zirveye oynamak üzere tasarlanmadı.
Kodlama, yazma, akıl yürütme, çok dilli yetenekler, görsel ve ses yeteneklerini birleştiren dengeli, genel amaçlı bir model. Belirli tek bir alanda liderlik etmek yerine birçok kıyaslamada makul performans gösteriyor.
Özel kodlama, araştırma veya yazı görevleri için hem açık kaynaklı hem de kapalı kaynaklı daha güçlü alternatifler mevcut.
Inkling’in değeri esnekliğinde yatıyor: açık ağırlıklı, çok modlu, özelleştirilebilir ve Thinking Machines’in model eğitimi ve özelleştirmesi için açık kaynaklı platformu olan Tinker üzerinden eğitilebilir veya ince ayar yapılabilir.
Bu sürüm, başlangıçtaki abartıyı bir ölçüde azaltmış olabilir, ancak şirketin yönünü de netleştirdi.
Thinking Machines yalnızca en yüksek kıyas puanları için yarışıyor gibi görünmüyor. Bunun yerine, kurumların pek çok farklı görevde ince ayar yapıp kullanabileceği uyarlanabilir modeller etrafında daha geniş bir ekosistem inşa ediyor.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



