
课程
使用 pandas 进行数据处理
4 小时
567.5K
实践并学习路径你的进步。
使用 Google 继续当您需要在 Pandas DataFrame 中逐行执行操作时,就需要使用行迭代。尽管 Pandas 针对向量化操作进行了优化,但在应用非向量化逻辑时(尤其是复杂数据处理或条件式逐行处理),行迭代仍然必不可少。
您可以对 Pandas DataFrame 使用多种方法来进行行迭代。
.iterrows():适用于简单的逐行操作,需要同时获得索引与行数据。它返回索引-序列(Series)对,对于大型数据帧可能较慢,不适合重计算任务。
.itertuples():当您不需要 Pandas Series 时,可作为 .iterrows() 的更快替代。它返回包含行值的 namedtuple,比 .iterrows() 更省内存。
.apply(axis=1):对每一行应用函数,通常与参数 axis = 1 一起使用。它比向量化方法慢,但往往快于显式循环。
尽管 Pandas 被设计为通过基于列的操作来实现最佳运行,但在处理单独行时,各种 Python 方法可以实现逐行迭代。
Pandas 以列式格式处理 DataFrame,因此能够高效地同时对列应用变换。
这也是为什么向量化操作在 Pandas 中高效,并通常优于行迭代的原因之一;在处理大型 DataFrame 时,行迭代可能变慢。
以下是主要的行迭代方法:
.iterrows():将每一行作为 (index, Series) 元组返回。
.itertuples():比 .iterrows() 更快,以 namedtuple 的形式产出每一行。
.items():不是行迭代,而是迭代 DataFrame 的列,返回列标签与 Series,通常用于按列操作。
基于含 100,000 行的中等规模 DataFrame 的基准测试,.itertuples() 在速度与内存效率上通常比 .iterrows() 快 5-10 倍。这是因为 .itertuples() 避免为每一行创建 Series 对象,而是返回轻量的 namedtuple。
向量化操作由于采用了优化的 C 代码实现,速度快于任何形式的迭代。它们消除了 Python 层循环,降低了开销。例如,使用 datacamp_rows[“A”] + 相加两列,比结合 datacamp_rows[“B”].iterrows() 的 for 循环更快。
.iterrows() 的内存占用较大,因为它为每行返回完整的 Pandas Series 对象,而且这些 Series 源自不同列、数据类型各异,可能出现 dtype 不一致的问题。
对于较小数据集,建议使用 .iterrows();对于较大数据集,可以使用 .itertuples()。
有时您无法应用向量化操作,可能不得不退回到行迭代。本节将说明在这种情况下何时应使用或不应使用行迭代。
行迭代的典型场景包括:
尽管有这些用例,但在某些情况下应避免按行迭代,例如:
替代迭代的方法包括:
尽可能使用向量化操作。
对于复杂但仍可向量化的任务,结合优化函数使用 .apply()。
在必须迭代但受性能约束时,考虑批处理或并行化。
您需要避免以下按行循环的常见陷阱:
.iterrows() 返回的是副本而非对原行的引用;因此修改它不会改变原 DataFrame。
与向量化操作相比,可读性与可维护性更差。
您可以根据用例或 DataFrame 的特性,使用多种方法在 Pandas DataFrame 中实现按行迭代。以下是迭代 DataFrame 行的方法。
.iterrows() 方法涉及对 DataFrame 的每一行进行迭代。语法如下:
for index, row in datacamp_rows.iterrows():
	# code to process each row
其中 datacamp_rows 是被迭代的数据帧,index 为行索引,row 为包含该行数据的 Pandas Series。
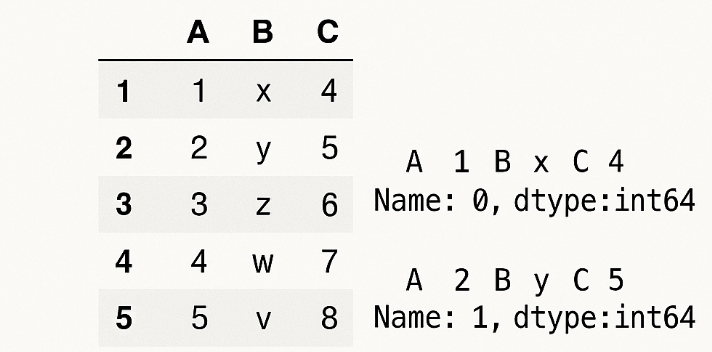
以下是一个基本用例:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.iterrows() 返回一个生成器,依次产出行索引以及表示该行的 Series 对象。该 Series 的键为列名,值为该行对应的数据。
其内部返回形式如下:
(index_0, Series_0)
(index_1, Series_1).itertuples() 比 .iterrows() 更快且更省内存,它将每一行作为 namedtuple 返回,可通过点号访问列值。语法如下:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
其中 index=True 表示将 DataFrame 索引作为每个元组的第一个元素,name="Pandas" 设置返回的 namedtuple 类名。若 name=None,则 for 循环返回常规元组,无法通过属性访问。
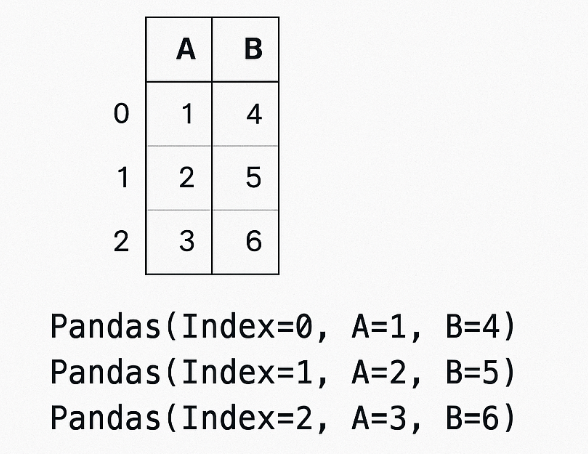
以下示例展示了 .itertuples() 的实际用法:
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() 返回一个生成器,产出 namedtuple,每一行被表示为一个轻量对象。
您可以通过点号访问每行字段,如 row.Name 与 row.age,其前面带有索引。
其内部返回形式如下:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30).apply() 方法在应用函数到行以执行逐行迭代时很有用,通常搭配 axis=1 参数使用。语法如下:
df.apply(func, axis=1)其中 func 为应用在行上的函数,参数 axis=1 需要设置。
下面是一个展示其用法的实际示例。
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()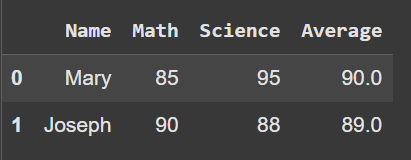
当基于现有列创建新列,或应用自定义计算或变换时,使用 .apply() 方法。
在行迭代方面,您可以用它为每一行创建条件逻辑,例如 if-else。设置 axis=1 时,函数接收到的对象为以列名为索引的 Series。该函数处理行并返回标量值写入新列,或返回多列的 Series。
尽管 .apply(axis=1) 比向量化操作慢,但通常比 .iterrows() 更快且更简洁。
另一种行迭代变通做法是,您可以在 for 循环中手动使用 .loc[] 或 .iloc[] 迭代 Pandas DataFrame。
其工作方式与 .iterrows() 或 .itertuples() 类似。该方法的一个优点是您可以完全掌控行。语法如下:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
下面是其实现方式的一个示例。
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30该方法的一个用例是当您需要精确控制行顺序,或在为调试编写逐步逻辑时。尽管这种方法在大型数据帧上会变得低效,它也比向量化操作更慢。
当您需要基于标签的查找时应使用 .loc[],需要基于位置的访问时使用 .iloc[],尤其是在基于范围的循环中。
下表总结了这三种方法的差异。
|
特性 |
iterows() |
itertuples() |
apply(axis=1) |
|
语法 |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
输出 |
(index, Series) |
namedtuple |
返回函数的值(标量或 Series) |
|
速度 |
慢 |
最快 |
中等 |
|
内存使用 |
中等 |
低 |
中等 |
|
可读性 |
中等 |
高 |
高 |
|
最佳用例 |
快速原型或调试 |
大型数据集 |
派生新列 |
|
局限性 |
较慢 |
难以处理复杂行逻辑 |
慢于完全向量化 |
尽管 .iterrows() 是遍历 Pandas DataFrame 行的直接方式,但它存在影响性能的限制。
使用 .iterrows() 迭代会将 DataFrame 的每一行产出为包含行索引(即表的索引)与该行数据 Series 的元组。
尽管简单,但它在 dtype 转换方面存在缺点;例如,当 Series 需要容纳混合类型时,可能会将整数转换为浮点数,从而在计算或比较中引发隐蔽的错误。
此外,由于 .iterrows() 为每行返回一个 Series,这会带来内存开销,与向量化操作相比会降低性能。
不建议在使用 .iterrows() 的循环中修改数据,因为对 Series 的更改不会回写到 DataFrame。
尽管有上述限制,.iterrows() 在以下场景仍然有用:
.iterrows()。.iterrows()。为保持 dtype 一致性,考虑切换到 .itertuples(),它返回不进行类型转换的 namedtuple。
.itertuples() 方法由于返回 namedtuple,因此比 .iterrows() 更快且更省内存。下面看看它的一些特性如何使其优于 .iterrows()。
.itertuples() 的一些优势包括:
性能提升:不同于 .iterrows() 创建占用内存、降低性能的 Series 对象,.itertuples() 通过生成 namedtuple 的生成器避免了内存开销并提升了性能。
可定制性:在 .itertuples() 中使用 index=False 可从元组中省略索引,设置 name='Custom' 可自定义 namedtuple 类名,从而提升可读性或便于与其他系统集成。
在使用 .itertuples() 时,需要注意以下局限:
列名限制:包含特殊字符或空格的列名可能不是有效的 Python 标识符。这些名称要么被修改为有效名称,要么需要通过基于索引的元组解包来访问。
不可变性:Namedtuple 是不可变的,无法就地修改其值。这意味着任何变换都需要构建新结构,或将所需值收集到单独的列表或 DataFrame 中。
使用 .itertuples() 的一些最佳实践:
虽然行迭代的主要方法是 .iterrows() 与 .itertuples(),但 pandas 还提供了更适合大规模数据处理的替代方案,如向量化,它既省内存又更快。
向量化操作是一次性对整个数组或 DataFrame 列应用操作,利用 NumPy 与 Pandas 的底层优化。其写法更简洁、可读性更好,并能显著缩短执行时间。
以下是一些常见的向量化技巧与示例:
算术操作: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
条件逻辑: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
字符串方法: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
日期时间处理: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
向量化操作由编译的 C 代码与优化的内存管理支撑,尤其在大型 DataFrame 上,常较 Python 循环快出几个数量级。
当实现逐行逻辑时,建议使用 .apply(axis=1)。虽然不如向量化快,但比行迭代更高效也更具表达力。.apply() 在大型 DataFrame 上有时仍会较慢,因为其内部依然在 C 层循环。但对于中等复杂度逻辑,它是可控的。
可用于优化 .apply() 的一些工具包括:
Swifter:自动选择执行 .apply() 的最快方式。
Pandarallel:让您仅用一行代码即可在多个 CPU 核心上并行执行 .apply()。
Numba:JIT 编译器,可加速数值型 Python 函数。在 .apply() 中使用它,能大幅降低数值密集型运算的计算时间。
在 Pandas 中,一个强大的策略是创建临时列,将复杂操作分解为若干易于向量化的步骤,从而避免显式的逐行迭代。
有多种优化策略与对比基准可供参考,确保在处理大型数据集时实现可扩展、内存高效的处理。
Python 中不同的迭代方法性能各异。例如,将 for 与 while 循环与 Pandas 方法 .itertuples()、.iterrows() 结合使用时,通常明显慢于向量化操作。
基准测试通常表明,.itertuples() 比 .iterrows() 更快且更省内存,因为它返回的是 namedtuple 而非 Series。向量化操作由于底层基于 C 的实现,性能优于所有其他迭代形式。
随着数据规模扩展到数百万行,这些差异变得至关重要,低效方法会导致瓶颈和更高的内存消耗。
对于更大的数据集,可考虑使用以下技巧:
分块处理:在 .read_csv() 中使用 chunksize 参数,将数据按可管理的块处理,而非一次性全部载入内存。
dtype 优化:尝试使用不同数据类型,如用 float32 替代 float64 以减少内存占用。
内存管理:尽早删除未使用列、合并前先筛选数据,并定期使用 gc.collect() 释放内存。
在多种场景中,迭代都很实用。以下是一些实用示例,展示在 Pandas 中处理迭代的常见模式与最佳实践。
下面的示例展示了 .iterrows()、.itertuples() 与 .apply(axis=1) 的基础用法。
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old您可以使用行迭代方法在循环中修改 DataFrame 的值;但在处理大型数据集时,这种方法效率不高。
以下示例展示了如何实现。
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()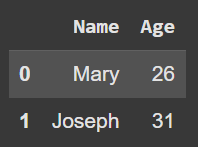
在处理大型数据帧时,考虑使用向量化操作以提高性能,如下例所示。
# Better approach using a vectorized method
students["age"] = students["age"] + 1若只处理特定行,可在循环中加入条件判断,如下例所示,打印 age 大于 25 的行。
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25不过,下方的向量化方案更好、更高效。
students_greater_than_5 = students[students["age"] > 25]在逐行处理过程中也可以计算汇总统计量;不过 Pandas 提供了 .sum() 与 .mean() 等内置方法,速度更快。
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5在 Pandas 中进行行迭代时,理解不同方法之间的权衡至关重要。
当您需要简单方案且数据集不大时使用 .iterrows();当需要更快的替代与更佳性能时使用 .itertuples()。
在适用时,尤其是处理大型数据集时,应优先考虑向量化操作,因为其基于 C 的实现通常更快、更高效。
当需要无法轻易向量化的逐行或逐列操作时,使用 .apply() 作为折中方案。
以下是我们关于 Pandas 的更多学习资源:
您也可以查看以下课程页面,加速学习:
通过 DataCamp 学习 Python
课程
课程
实践并学习路径你的进步。
使用 Google 继续