Kurs
pandas ile Veri İşleme
4 sa
566K
Bir Pandas DataFrame’inde işlemleri satır satır gerçekleştirmeniz gerektiğinde, satır yinelemesi kullanmanız gerekir. Pandas vektörleştirilmiş işlemler için optimize edilmiş olsa da, özellikle karmaşık veri düzenlemelerinde veya koşullu satır işleme durumlarında vektörleştirilemeyen mantığı uygularken satır yinelemeleri gereklidir.
Bir Pandas DataFrame’ine satır yinelemesi uygulamak için kullanabileceğiniz çeşitli yöntemler vardır.
.iterrows(): Dizin ve satır verilerine ihtiyaç duyduğunuz basit satır bazlı işlemler için kullanın. Dizin-seri çiftleri döndürür; büyük veri çerçeveleri için yavaş olabilir ve ağır hesaplamalara uygun değildir.
.itertuples(): Özellikle bir Pandas Series’e ihtiyacınız olmadığında, .iterrows()’a daha hızlı bir alternatiftir. Satır değerlerini namedtuple olarak döndürür ve .iterrows()’tan daha bellek verimlidir.
.apply(axis=1): Her satıra bir fonksiyon uygular ve genellikle axis = 1 bağımsız değişkeni ile kullanılır. Vektörleştirilmiş yöntemlerden yavaştır, ancak çoğu zaman açık döngülerden daha hızlıdır.
Pandas sütun tabanlı işlemlerle en verimli şekilde çalışacak şekilde tasarlanmıştır; bu nedenle dönüşümleri DataFrame sütunlarına eşzamanlı uygulamak etkilidir.
Bu, vektörleştirilmiş işlemlerin Pandas’ta neden verimli olduğunun ve genellikle, özellikle büyük DataFrame’lerle çalışırken yavaşlayabilen satır yinelemelerine tercih edilmesinin nedenlerinden biridir.
Aşağıdakiler temel satır yineleme yöntemleridir:
.iterrows(): Her satırı (index, Series) ikilisi olarak döndürür.
.itertuples(): .iterrows()’tan daha hızlıdır ve her satırı namedtuple olarak verir.
.items(): Satır yinelemesi değildir; bir Pandas DataFrame’inin sütunları üzerinde yineleme yapar, bir sütun etiketi ve Series döndürür ve genellikle sütun bazlı işlemler için kullanılır.
100.000 satırlık orta büyüklükte DataFrame’ler üzerinde yapılan kıyaslamalara göre, .itertuples() hız ve bellek verimliliği açısından .iterrows()’tan 5-10 kat daha hızlıdır. Bunun nedeni, .itertuples()’ın her satır için Series nesneleri oluşturmaktan kaçınması ve bunun yerine hafif namedtuple’lar üretmesidir.
Vektörleştirilmiş işlemler, optimize edilmiş C kodunda uygulandıkları için her türlü yinelemeden daha hızlıdır. Python düzeyindeki döngüleri ortadan kaldırarak ek yükü azaltırlar. Örneğin, datacamp_rows[“A”] + ile iki sütunun toplanması, datacamp_rows[“B”].iterrows() ile bir for döngüsü kullanmaktan daha hızlıdır.
.iterrows() büyük bir bellek ayak izine sahiptir; çünkü tam bir Pandas Series nesnesi döndürür ve bu Series’ler farklı veri türlerine sahip farklı sütunlardan türetildikleri için dtype tutarsızlıklarından muzdarip olabilirler.
Daha küçük bir veri kümesi için .iterrows() kullanmanız önerilir; daha büyük veri kümeleri için ise .itertuples() kullanabilirsiniz.
Bazı durumlarda vektörleştirilmiş işlemleri uygulayamayabilir ve satır yinelemesine geri dönmeniz gerekebilir. Bu gibi durumlarda, bu bölümde satır yinelemelerini ne zaman kullanmanız ve ne zaman kullanmamanız gerektiğini öğreneceksiniz.
Satır yinelemesi için tipik senaryolar şunlardır:
Satır bazlı yinelemelerin kullanım durumlarına rağmen, aşağıdaki gibi durumlarda bunlardan kaçınmalısınız:
Yinelemek yerine şu alternatifleri değerlendirin:
Mümkün olan her yerde vektörleştirilmiş işlemleri kullanın.
Karmaşık ama hâlâ vektörleştirilebilir görevler için optimize edilmiş fonksiyonlarla .apply()’dan yararlanın.
Yinelemeniz gerekiyorsa ve performans kısıtları varsa toplu işleme veya paralelleştirmeyi düşünün.
Aşağıdaki yaygın satır bazlı döngü tuzaklarından kaçınmalısınız:
.iterrows() orijinal satıra referans değil, bir kopya döndürür; bu nedenle üzerinde yapılan değişiklikler orijinal DataFrame’i etkilemez.
Vektörleştirilmiş işlemlerle karşılaştırıldığında okumak ve sürdürmek daha zordur.
Pandas DataFrame’lerinde satır yinelemesini, kullanım durumunuza veya DataFrame’in doğasına bağlı olarak çeşitli yöntemlerle uygulayabilirsiniz. İşte Pandas DataFrame satırları üzerinde yinelemek için yöntemler.
.iterrows() yöntemi, bir DataFrame’in tek tek satırları üzerinde yinelemeyi içerir. Söz dizimi aşağıdaki gibidir:
for index, row in datacamp_rows.iterrows():
	# code to process each row
Burada datacamp_rows yineleme yapılan dataframe’dir, index satır dizinidir ve row satır verilerini içeren Pandas Series’tir.
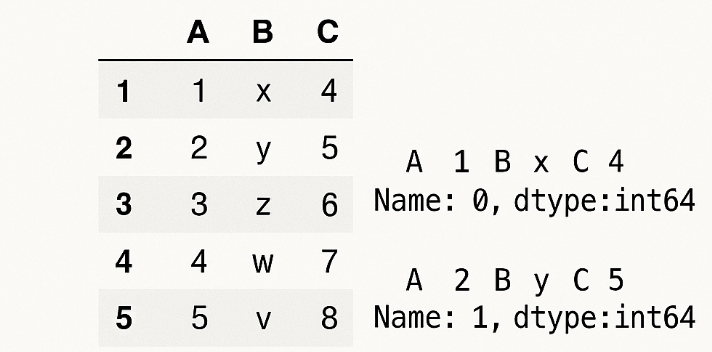
Temel bir kullanım örneği:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.iterrows() yöntemi, bir satırın dizinini ve satırları temsil eden bir Series nesnesini veren bir üreteç döndürür. Bu Series nesnesinin anahtarları sütun adlarıdır ve değerler her satırdaki karşılık gelen verilerdir.
Dahili olarak, .iterrows() şunu döndürür:
(index_0, Series_0)
(index_1, Series_1).itertuples(), .iterrows()’tan daha hızlı ve daha bellek verimlidir ve her satırı namedtuple olarak döndürür; nokta gösterimiyle sütun değerlerine erişmenizi sağlar. Söz dizimi şu şekildedir:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
index=True her tuple’ın ilk öğesi olarak DataFrame dizinini içerir ve name="Pandas" döndürülen namedtuple sınıfının adını ayarlar. name=None ise for döngüsü özniteliklerine erişim olmayan normal bir tuple döndürür.
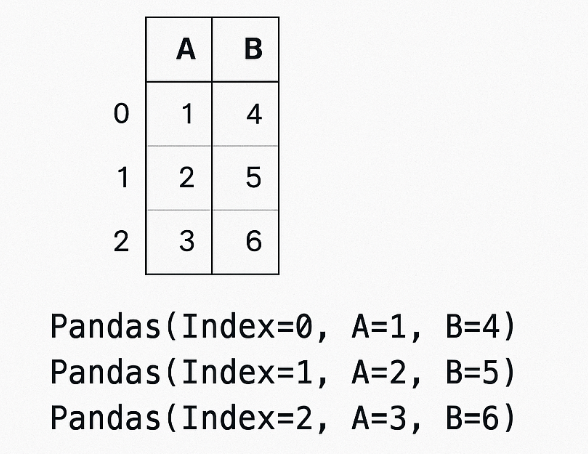
.itertuples()’ın nasıl çalıştığına dair pratik bir örnek:
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples(), her satırın hafif bir nesne olarak temsil edildiği namedtuple’lar üreten bir üreteç döndürür.
Her bir satır alanına row.Name ve row.age gibi nokta gösterimiyle erişebilirsiniz; bunlardan önce dizin gelir.
Dahili olarak şunu döndürür:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30).apply() yöntemi, axis=1 bağımsız değişkeni kullanıldığında görüldüğü gibi, satırlara fonksiyon uygularken satır bazlı yinelemeler için kullanışlıdır. Söz dizimi aşağıdaki gibidir:
df.apply(func, axis=1)Burada satır üzerinde uygulanacak fonksiyon func’tır ve axis=1 bağımsız değişkeni ayarlanır.
Uygulamasını gösteren pratik bir örnek aşağıdadır.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()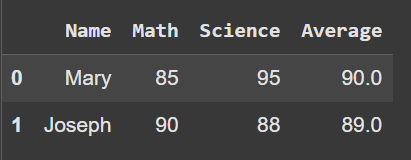
.apply() yöntemini, mevcut sütunlara dayanarak yeni sütunlar oluştururken veya özel hesaplamalar ya da dönüşümler uygularken kullanın.
Satır yinelemesi bağlamında, satır başına if-else ifadeleri gibi koşullu mantık oluşturmak için kullanabilirsiniz. axis=1 ayarlandığında, fonksiyon satırları sütun adları indeks olacak şekilde bir Series olarak alır. Bu fonksiyon satırları işler ve tek bir sütunda skaler bir değer veya birden fazla sütunda bir series döndürür.
Her ne kadar .apply(axis=1) vektörleştirilmiş işlemlerden yavaş olsa da, .iterrows()’tan daha hızlı ve daha derlidir.
Satır yinelemeleri için başka bir yöntem de bir Pandas DataFrame üzerinde yineleme yapmak üzere .loc[] veya .iloc[]’u for döngüleriyle manuel olarak kullanmaktır.
Bu, .iterrows() veya .itertuples() yöntemlerine benzer şekilde çalışır. Bu yaklaşımın bir avantajı, satırlar üzerinde tam kontrol sağlamanızdır. Söz dizimi aşağıdaki gibidir:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Nasıl uygulandığını gösteren pratik bir örnek:
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Bu yöntem, satır sırası üzerinde hassas kontrole ihtiyaç duyduğunuzda veya hata ayıklama için adım adım mantık yazarken uygundur. Büyük veri çerçeveleri için verimsizleşir ve vektörleştirilmiş işlemlerden daha yavaştır.
Etiket tabanlı arama gerektiğinde .loc[]’u, konum tabanlı erişim gerektiğinde ise özellikle aralık tabanlı döngülerle .iloc[]’u kullanmak esastır.
Üç yöntem arasındaki farkları özetleyen bir tablo aşağıdadır.
|
Özellikler |
iterrows() |
itertuples() |
apply(axis=1) |
|
Söz dizimi |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Çıktı |
(index, Series) |
namedtuple |
Fonksiyonun değeri (skaler veya Series) döner |
|
Hız |
Yavaş |
En hızlı |
Orta |
|
Bellek Kullanımı |
Orta |
Düşük |
Orta |
|
Okunabilirlik |
Orta |
Yüksek |
Yüksek |
|
En iyi kullanım durumları |
Hızlı prototipleme veya hata ayıklama |
Büyük veri kümeleri |
Sütun türetimi |
|
Sınırlamalar |
Daha yavaş |
Karmaşık satır mantığını kaldıramaz |
Tam vektörleştirmeden daha yavaş |
.iterrows() yöntemi, bir Pandas DataFrame’inin satırları üzerinde yinelemenin doğrudan bir yolu olsa da, performansı etkileyebilecek sınırlamaları vardır.
.iterrows() ile yineleme, bir DataFrame’in her satırını, tablodaki satır dizinini ve satırdaki verileri içeren bir Series nesnesini barındıran bir ikili olarak verir.
Basitliğine rağmen, dtype dönüşümü açısından bir dezavantajı vardır; örneğin, Series karışık türlere uyum sağlamak zorunda kalırsa tamsayıları float’a dönüştürür; bu da hesaplamalarda veya karşılaştırmalarda ince hatalara yol açabilir.
Ayrıca, .iterrows() her satır için bir Series döndürdüğünden, bu durum bellek ek yüküne neden olur ve vektörleştirilmiş işlemlerle karşılaştırıldığında performansı yavaşlatır.
.iterrows() kullanılarak bir döngü içinde veri değiştirilmesi önerilmez; çünkü Series nesnesine yapılan değişiklikler dataframe’e yansımaz.
Yukarıdaki sınırlamalara rağmen, .iterrows() şu gibi bazı senaryolarda yararlıdır:
.iterrows() yöntemini kullanabilirsiniz..iterrows() yöntemini kullanabilirsiniz.Dtype tutarlılığını korumak için, tür dönüşümü yapmadan namedtuple döndüren .itertuples()’a geçmeyi düşünün.
.itertuples() yöntemi, namedtuple döndürdüğü için .iterrows()’tan daha hızlı ve daha bellek verimlidir. Bazı özelliklerinin .iterrows() yöntemine kıyasla nasıl üstünlük sağladığını inceleyelim.
.itertuples()’ın bazı avantajları şunlardır:
Performans artışları: .iterrows() gibi Series nesneleri oluşturmak yerine, ki bu bellek tüketir ve performansı düşürür, .itertuples() namedtuple üreten bir üreteç kullanarak bellek ek yükünden kaçınır ve performansı iyileştirir.
Özelleştirilebilirlik: .itertuples() içindeki index=False bağımsız değişkeni dizini tuple’dan çıkarır ve name= 'Custom' argümanının ayarlanması, okunabilirliği veya diğer sistemlerle entegrasyonu artıracak şekilde özel bir namedtuple sınıf adı belirlemeye olanak tanır.
.itertuples() kullanırken aşağıdaki sınırlamaların farkında olmak önemlidir.
Sütun adlandırma kısıtları: Özel karakterler veya boşluk içeren sütun adları geçersiz Python tanımlayıcılarıyla sonuçlanabilir. Bunlar geçerli adlara dönüştürülür veya indeks tabanlı tuple açma yöntemiyle erişilir.
Değişmezlik: Namedtuple’lar değişmezdir; yani değerlerini yerinde değiştiremezsiniz. Bu da, herhangi bir dönüşüm için yeni bir yapı kurmayı veya istenen değerleri ayrı bir listeye ya da dataframe’e toplamayı gerektirir.
.itertuples() kullanırken uymanız gereken bazı en iyi uygulamalar şunlardır:
Satır yinelemesi için birincil yöntemler .iterrows() ve .itertuples() olsa da, pandas büyük ölçekli veri işlemede daha verimli diğer alternatifler sunar; örneğin bellek verimli ve daha hızlı olan vektörleştirme.
Vektörleştirilmiş işlemler, NumPy ve Pandas’taki düşük seviyeli optimizasyonlardan yararlanarak tüm diziler veya DataFrame sütunları üzerinde işlemleri bir seferde uygulamayı içerir. Daha temiz ve okunabilirdir ve çalışma süresini ciddi ölçüde azaltır.
Aşağıda bazı yaygın vektörleştirme teknikleri ve örnekler yer alır:
Aritmetik işlemler: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Koşullu mantık: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Metin metotları: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Tarih-saat işlemleri: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Vektörleştirilmiş işlemler derlenmiş C kodu ve optimize edilmiş bellek yönetimi ile desteklenir; özellikle büyük DataFrame’ler için Python döngülerinden katbekat daha iyi performans gösterir.
Satır bazlı mantık uygularken, .apply(axis=1) yöntemini kullanmanız önerilir. Vektörleştirme kadar hızlı olmasa da, satır yinelemesinden daha verimli ve daha ifade edilebilirdir. .apply() büyük DataFrame’lerde bazen yavaştır; çünkü hâlâ C içinde dahili olarak döngü yapar. Ancak orta derecede karmaşık mantık için yönetilebilir.
.apply() optimizasyonu için düşünebileceğiniz çeşitli araçlar vardır:
Swifter: .apply() için en hızlı yürütme yöntemini otomatik olarak seçer.
Pandarallel: .apply()’ın birden çok CPU çekirdeği arasında paralel yürütülmesini tek satırlık bir kodla kolayca sağlar.
Numba: Sayısal Python fonksiyonlarını hızlandıran bir JIT derleyicisidir. .apply() içinde kullandığınızda, sayısal açıdan yoğun işlemlerin hesaplama süresini ciddi ölçüde azaltabilir.
Pandas’taki güçlü bir strateji, karmaşık işlemleri yönetilebilir vektörleştirilmiş adımlara bölmek için geçici sütunlar oluşturmaktır; bu da açıkça satır satır yineleme ihtiyacını ortadan kaldırır.
Özellikle büyük veri kümeleriyle çalışırken ölçeklenebilir ve bellek açısından verimli bir yönetim sağlamak için keşfedilecek çeşitli optimizasyon stratejileri ve karşılaştırmalı kıyaslamalar vardır.
Python’daki farklı yineleme yöntemleri değişen performanslara sahip olabilir. Örneğin, .itertuples() ve .iterrows() gibi Pandas yöntemleriyle birlikte kullanılan for ve while döngüleri, vektörleştirilmiş işlemlerden önemli ölçüde daha yavaştır.
Kıyaslamalar genellikle .itertuples()’ın, Series yerine namedtuple döndürdüğü için .iterrows()’tan daha hızlı ve daha bellek verimli olduğunu gösterir. Vektörleştirilmiş işlemler, alttaki C tabanlı uygulamaları nedeniyle tüm yineleme biçimlerinden daha iyi performans gösterir.
Veriler milyonlarca satıra ölçeklendikçe bu farklar kritik hâle gelir; verimsiz yöntemler darboğazlara ve artan bellek kullanımına yol açabilir.
Daha büyük veri kümeleri için şu teknikleri kullanmayı düşünün:
Parça parça işleme: Verileri bir seferde tümünü belleğe yüklemek yerine yönetilebilir bloklar hâlinde işlemek için .read_csv() içindeki chunksize parametresini kullanın.
Dtype optimizasyonu: Bellek kullanımını azaltmak için float64 yerine float32 gibi farklı veri türlerini kullanmayı deneyin.
Bellek yönetimi: Kullanılmayan sütunları erken bırakın, birleştirmeden önce verileri filtreleyin ve gc.collect() ile periyodik olarak belleği boşaltın.
Çekirdek dışı hesaplama: Şu araçları kullanın: Dask ve Vaex; belleği aşan veri kümelerinde paralel, çekirdek dışı hesaplamaları etkinleştirmek için.
Yinelemenin işe yaradığı çeşitli senaryolar vardır. İşte Pandas ile çalışırken yaygın yineleme kalıplarını ve en iyi uygulamaları gösteren bazı pratik örnekler.
Aşağıda .iterrows(), .itertuples() ve .apply(axis=1) yöntemlerinin temel kullanımını gösteren bir örnek yer alır.
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldDataFrame değerlerini bir döngü içinde değiştirmek için satır yineleme yöntemlerini kullanabilirsiniz; ancak bu yaklaşım büyük veri kümeleriyle çalışırken verimli değildir.
Aşağıdaki örnekler bunun nasıl uygulanacağını gösterir.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()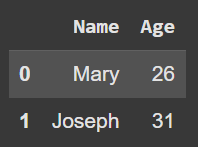
Büyük veri çerçeveleriyle çalışırken performansı artırmak için aşağıdaki örnekte gösterildiği gibi vektörleştirilmiş bir yöntem kullanmayı düşünün.
# Better approach using a vectorized method
students["age"] = students["age"] + 1Yalnızca belirli satırları işlemek için döngü içinde koşullu bir kontrol kullanmayı düşünün; aşağıdaki örnekte age değeri 25’ten büyük olan satırlar yazdırılır.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Yine de aşağıdaki vektörleştirilmiş seçenek daha iyi ve daha performanslıdır.
students_greater_than_5 = students[students["age"] > 25]Satır bazlı işlem sırasında özet istatistikleri hesaplamak da mümkündür; ancak Pandas .sum() ve .mean() gibi daha hızlı yerleşik yöntemler sunar.
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Pandas’ta satır yinelemesi yaparken mevcut farklı yöntemler arasındaki ödünleşimleri anlamak önemlidir.
Küçük veri kümeleri ve basit çözümler için .iterrows()’u, daha hızlı bir alternatif ve iyileştirilmiş performansa ihtiyaç duyduğunuzda .itertuples()’ı kullanın.
Özellikle daha büyük veri kümelerinde, altta yatan C tabanlı işlemler sayesinde daha hızlı ve verimli oldukları için mümkün olduğunda vektörleştirilmiş işlemleri ilk tercihiniz yapın.
Kolayca vektörleştirilemeyen satır veya sütun bazlı bir işlem gerektiğinde orta yol sağlamak için .apply() kullanın.
Pandas hakkında daha fazla bilgi edinmek için kaynaklarımızdan bazıları:
Öğreniminizi hızlandırmak için aşağıdaki kurs sayfalarımıza da göz atabilirsiniz:
DataCamp ile Python Öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




