
课程
面向表格用户的 pandas 连接
4 小时
4.6K
实践并学习路径你的进步。
使用 Google 继续在上一篇文章中,您看到 groupby 操作 如何从“拆分-应用-合并”的原则中自然而然地出现。您查看了一个 Netflix 用户评分数据集,并按电影的上映年份对行进行分组,生成了下图:
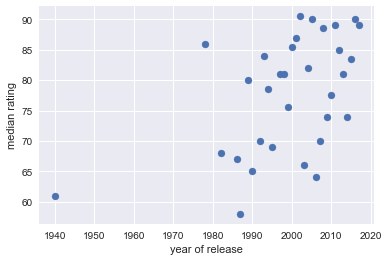
这是通过按单个列进行分组实现的。我顺带提到,您可能需要按多个列进行分组,这种情况下结果 pandas DataFrame 将具有多重索引或分层索引。在本文中,您将了解什么是分层索引,并看看当按数据的多个特征分组时它们如何产生。关于这些概念与实践的更多内容,请参阅我们的 使用 pandas 操作 DataFrame 课程。
那么首先:什么是分层索引?
在介绍分层索引之前,我想请您回忆一下 pandas DataFrame 的索引是什么。DataFrame 的索引是一组为每一行提供标签的集合。我们来看一个示例。我将先导入一个关于假想的 DataCamp 学生 Ellie 在 DataCamp 上学习活动的合成数据集。列包括日期、编程语言,以及 Ellie 当天在该语言中完成的练习数量。加载数据:
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
在线运行和编辑此教程中的代码
运行代码| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
您可以在 DataFrame 左侧看到 Index,它由整数构成。这是一个 RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
我们可以使用该索引来切片出 df 的一行或多行:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
不过,这个索引并不那么有信息量。如果您要为 DataFrame 的行加上标签,最好尽可能以有意义的方式标注。针对本数据集,您能这样做吗?一个好的思路是:您需要为每一行提供一个唯一且有意义的标识符。检查各列,看看是否有符合这些标准的。注意到 date 列包含唯一日期,因此用日期列来标注每行是合理的。也就是说,您可以使用 .set_index() 方法将 date 列设为 DataFrame 的索引(注意:inplace=True 表示您确实在原地修改 DataFrame df):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
这为 df 带来了一个 DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
现在,您可以使用刚创建的 DateTimeIndex 对行进行切片:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
另外请注意,.columns 属性会返回包含 df 列名的索引:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
这可能会有点让人困惑,因为这表示 df.columns 的类型是 Index。这并不意味着列就是 DataFrame 的索引。df 的索引始终由 df.index 给出。有关索引的更多内容,请查看我们的 pandas DataFrame 教程。现在是时候认识分层索引了。
如果我们的数据集中有多种语言,就像在 DataCamp 一样,会怎样?来看一下:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
每个日期现在对应多行,每种语言一行。比如,日期“2017-01-02”分别出现在第 1 行和第 4 行,对应语言 Python 和 R。因此,日期不再能唯一地指定一行。然而,“date”与“language”组合起来可以唯一指定行。基于此,我们将二者都用作索引:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
您现在创建了一个多重索引(或分层索引,建议对这两个术语都熟悉,因为它们可互换使用),可以如下检查索引来确认:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
上述信息表明,您的 DataFrame df 现在有一个包含两级的 MultiIndex,第一层为日期,第二层为语言。回忆一下,上面您可以使用索引与 .loc 访问器来切片 DataFrame:df.loc['2017-01-02']。若要用多重索引进行切片,您需要先对索引排序:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
现在,您可以通过向 .loc 访问器传递一个元组,切片出 2017-01-02 这天完成的 R 练习数量:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
多重索引是在 pandas 中进行数据分析和组织的强大工具。它允许用户创建分层索引,可用于跨多个维度对数据进行分组和聚合。在处理具有多级分类的复杂数据集(例如金融或时间序列数据)时,多重索引尤为有用。
通过创建多重索引,用户可以同时按多个变量对数据进行分组,从而揭示单层分组可能无法显现的洞见。比如,可以同时按时间与地点对数据分组,使分析人员能够查看特定地区随时间的趋势。
此外,多重索引还可用于高效选择和子集化数据,因为索引提供了便捷的方式来访问数据的特定子集。总体而言,多重索引是组织、分组和分析 pandas 中复杂数据集的强大工具,对于任何处理分层数据的数据分析师或数据科学家都至关重要。
您现在已经了解了一些关于分层索引(或多重索引)的知识。接下来看看在处理 groupby 对象时它们如何产生。
在上一篇文章中,我们使用 Netflix 数据探讨了 groupby 对象与“拆分-应用-合并”的数据分析原则。现在用一个不同的数据集做个快速回顾,即内置于 seaborn 包的 tips 数据集。“Tips”包含小费、总账单、星期几以及用餐时间段等特征。首先加载并探索数据:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
注意 tips 的索引是一个 RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
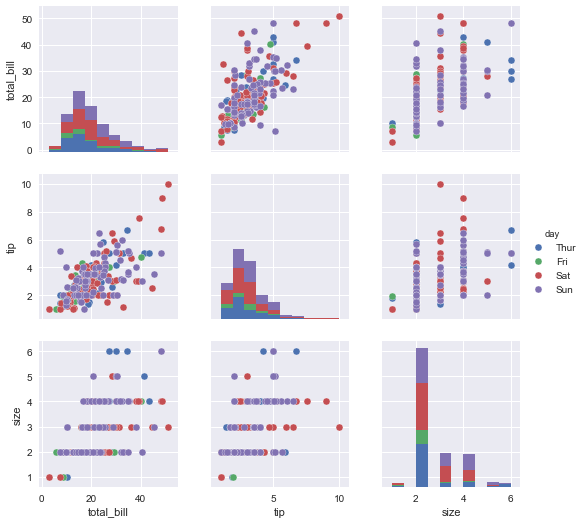
在深入计算之前,做一些可视化的探索性数据分析总是有帮助的,seaborn 的 pairplot 函数可以让您总览所有数值变量:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
如果您想查看“吸烟者”和“非吸烟者”之间的平均小费差异,可以按“smoker”(使用 groupby)对原始 DataFrame 进行拆分,应用函数“mean”,并合并为一个新的 DataFrame:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
结果 DataFrame df 的索引是原始 tips DataFrame 的“smoker”列/特征:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
如有需要,您可以重置索引,使“smoker”变为 DataFrame 的一列:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
现在来看看分层索引如何从“拆分-应用-合并”和 groupby 操作中产生。
上面,您根据特征“smoker”对 tips 数据集进行了分组。有时您需要根据两个特征对数据集进行分组。例如,将 tips 数据集按 吸烟/不吸烟 与 晚餐/午餐 分组是很自然的。为此,您将希望分组的列名作为列表传入:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
观察以上结果,您也许能看出“smoker”和“time”都是 df 的索引。确实如此,也合情合理:如果按“smoker”分组会使索引变为原始的“smoker”列,那么按两列分组就会得到两个索引。检查索引以确认它是分层的:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
确实如此。现在您可以做许多有用的事情,比如获取各分组中的计数:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
您还可以交换分层索引的层级,使得索引中“time”出现在“smoker”之前:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
接着,您可能希望从分层索引中移除其中一个特征,并相对于该特征形成不同的列。可以使用 unstack 方法实现:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
您可以使用关键字参数“level”在索引的外层进行 unstack:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
正如您所料,unstack 的结果具有非分层索引:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
因此,您现在可以围绕这些分组开展各种数据分析。我鼓励您动手实践。
在本文中,您认识了分层索引(或多重索引),并看到它们是如何作为希望用唯一且有意义的索引来标注 DataFrame 行的自然结果而产生的。您也看到了,当需要按多列对数据进行分组、调用“拆分-应用-合并”原则时,它们如何出现。希望您在工作中能乐于使用分层索引。
本文由 Jupyter Notebook 生成;您可以在此仓库中找到它。如果您有任何想法、反馈或感想,欢迎在 Twitter 上联系我:@hugobowne。
看看 DataCamp 其他实用的 pandas 教程,包括:
进一步学习 Python 与 pandas
课程
课程
实践并学习路径你的进步。
使用 Google 继续