Kursus
Manipulasi Data dengan pandas
4 jam
565.8K
Ketika Anda perlu melakukan operasi pada Pandas DataFrame baris demi baris, Anda perlu menggunakan iterasi baris. Meskipun Pandas dioptimalkan untuk operasi vektorisasi, iterasi baris penting saat menerapkan logika yang tidak tervektorisasi, terutama dalam manipulasi data yang kompleks atau pemrosesan baris secara kondisional.
Ada berbagai metode yang dapat Anda terapkan pada Pandas DataFrame untuk melakukan iterasi baris.
.iterrows(): Gunakan ini untuk operasi sederhana per baris, ketika indeks dan data baris diperlukan. Mengembalikan pasangan indeks-series, yang bisa lambat untuk dataframe besar dan tidak cocok untuk komputasi berat.
.itertuples(): Gunakan ini sebagai alternatif yang lebih cepat dari .iterrows(), terutama ketika Anda tidak memerlukan Pandas Series. Mengembalikan namedtuple dari nilai baris dan lebih efisien memori dibandingkan .iterrows().
.apply(axis=1): Menerapkan fungsi ke setiap baris, dan biasanya digunakan dengan argumen axis = 1. Lebih lambat daripada metode vektorisasi, tetapi sering kali lebih cepat daripada loop eksplisit.
Meskipun Pandas dirancang untuk berjalan optimal menggunakan operasi berbasis kolom, berbagai metode Python memfasilitasi iterasi per baris, terutama saat bekerja dengan baris individual.
Pandas bekerja dengan DataFrame dalam format kolumnar, sehingga efisien dalam menerapkan transformasi ke kolom DataFrame secara bersamaan.
Ini juga salah satu alasan mengapa operasi vektorisasi efisien di Pandas dan biasanya lebih disarankan dibanding iterasi baris, yang dapat menjadi lambat saat bekerja dengan DataFrame besar.
Berikut ini adalah metode utama iterasi baris:
.iterrows(): Ini mengembalikan setiap baris sebagai tuple (index, Series).
.itertuples(): Lebih cepat daripada .iterrows() dan menghasilkan setiap baris sebagai namedtuple.
.items(): Bukan iterasi baris, tetapi mengiterasi kolom Pandas DataFrame, mengembalikan label kolom dan Series, dan biasanya digunakan untuk operasi per kolom.
Berdasarkan benchmark pada DataFrame berukuran sedang dengan 100.000 baris, .itertuples() 5-10 kali lebih cepat daripada .iterrows() dalam hal kecepatan dan efisiensi memori. Ini karena .itertuples() menghindari pembuatan objek Series untuk setiap baris dan sebagai gantinya menghasilkan namedtuple yang ringan.
Operasi vektorisasi lebih cepat daripada bentuk iterasi apa pun karena diimplementasikan dalam kode C yang dioptimalkan. Mereka menghilangkan loop tingkat Python, sehingga mengurangi overhead. Misalnya, menambahkan dua kolom menggunakan datacamp_rows[“A”] + lebih cepat daripada menggunakan loop datacamp_rows[“B”]for dengan .iterrows().
.iterrows() memiliki jejak memori yang besar karena mengembalikan objek Pandas Series lengkap, dan Series ini dapat mengalami ketidakkonsistenan dtype karena berasal dari kolom berbeda dengan tipe data yang bervariasi.
Untuk dataset yang lebih kecil, disarankan Anda menggunakan .iterrows(), sementara untuk dataset yang lebih besar, Anda dapat menggunakan .itertuples().
Anda mungkin berada dalam situasi di mana Anda tidak bisa menerapkan operasi vektorisasi, dan harus kembali ke iterasi baris. Pada situasi seperti itu, Anda akan mempelajari di bagian ini kapan sebaiknya menggunakan dan tidak menggunakan iterasi baris.
Skenario umum untuk iterasi baris meliputi:
Terlepas dari kasus penggunaan iterasi per baris, Anda sebaiknya menghindarinya dalam beberapa kasus, seperti:
Alih-alih melakukan iterasi, pertimbangkan alternatif berikut:
Gunakan operasi vektorisasi sebisa mungkin.
Manfaatkan .apply() dengan fungsi yang dioptimalkan untuk tugas kompleks namun masih dapat divektorisasi.
Pertimbangkan pemrosesan batch atau paralelisasi jika Anda harus mengiterasi tetapi memiliki kendala kinerja.
Anda harus menghindari jebakan umum dari loop per baris berikut ini, seperti:
.iterrows() mengembalikan salinan, bukan referensi ke baris asli; sehingga memodifikasinya tidak mengubah DataFrame asli.
Lebih sulit dibaca dan dirawat dibandingkan operasi vektorisasi.
Anda dapat mengimplementasikan iterasi baris di Pandas DataFrame menggunakan berbagai metode, yang bergantung pada kasus penggunaan Anda atau sifat DataFrame. Berikut adalah metode untuk mengiterasi baris Pandas DataFrame.
Metode .iterrows() melibatkan iterasi atas baris individual dari sebuah DataFrame. Sintaksnya sebagai berikut:
for index, row in datacamp_rows.iterrows():
	# code to process each row
Di mana datacamp_rows adalah dataframe yang diiterasi, index adalah indeks baris, dan row adalah Pandas Series yang berisi data baris.
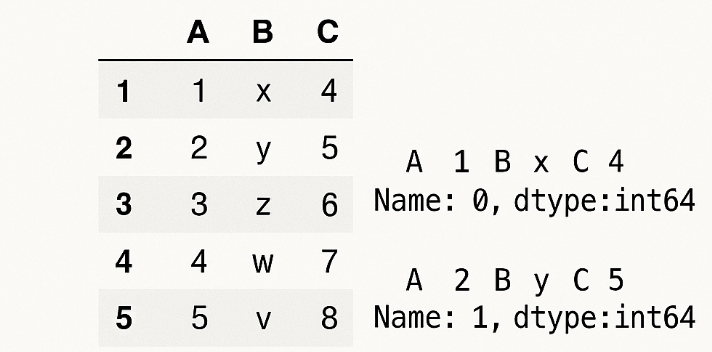
Berikut contoh penggunaan dasar:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30Metode .iterows() mengembalikan generator yang menghasilkan indeks suatu baris, beserta objek Series yang merepresentasikan baris. Kunci dari objek Series ini adalah nama kolom, dan nilainya adalah data yang sesuai di setiap baris.
Secara internal, ini yang dikembalikan oleh .iterrows().
(index_0, Series_0)
(index_1, Series_1).itertuples() lebih cepat dan lebih efisien memori daripada .iterrows(), dan mengembalikan setiap baris sebagai namedtuple, memungkinkan akses ke nilai kolom menggunakan notasi titik. Sintaksnya sebagai berikut:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
Di mana index=True menyertakan indeks DataFrame sebagai elemen pertama dari setiap tuple, dan name="Pandas" menetapkan nama kelas namedtuple yang dikembalikan. Jika name=None, loop for mengembalikan tuple biasa tanpa akses ke atributnya.
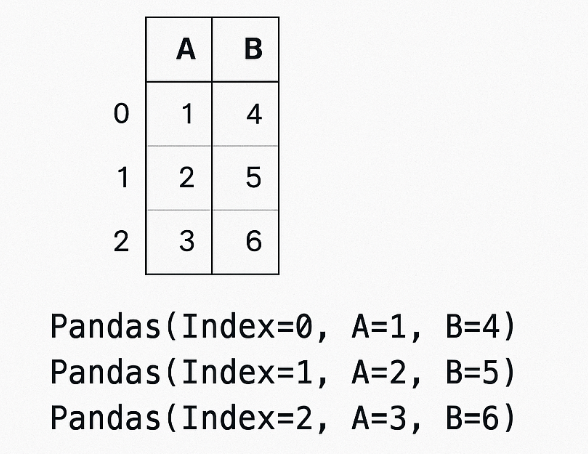
Berikut contoh praktis cara kerja .itertuples():
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() mengembalikan generator yang menghasilkan namedtuple, di mana setiap baris direpresentasikan sebagai objek ringan.
Anda dapat mengakses setiap field baris menggunakan notasi titik, seperti row.Name dan row.age, yang didahului oleh indeks.
Secara internal, ini yang dikembalikan:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)Metode .apply() di Pandas berguna saat menerapkan fungsi ke baris untuk melakukan iterasi per baris, seperti saat menggunakan argumen axis=1. Sintaksnya sebagai berikut:
df.apply(func, axis=1)Di mana fungsi yang diterapkan pada baris adalah func, sementara argumen axis=1 disetel.
Berikut contoh praktis yang menggambarkan penerapannya.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()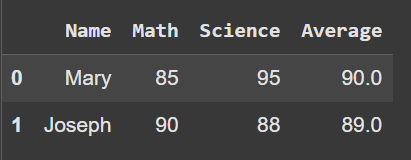
Gunakan metode .apply() saat membuat kolom baru berdasarkan kolom yang sudah ada, atau saat menerapkan perhitungan atau transformasi kustom.
Dalam hal iterasi baris, Anda dapat menggunakannya untuk membuat logika kondisional per baris, seperti pernyataan if-else. Saat axis=1 disetel, fungsi diteruskan sebagai Series dengan nama kolom sebagai indeks. Fungsi ini memproses baris dan mengembalikan nilai skalar di kolom baru atau series di beberapa kolom.
Meskipun .apply(axis=1) lebih lambat daripada operasi vektorisasi, ini lebih cepat dan lebih rapi daripada .iterrows().
Solusi lain untuk iterasi baris adalah Anda menggunakan .loc[] atau .iloc[] secara manual dengan loop for untuk mengiterasi Pandas DataFrame.
Ini bekerja mirip dengan metode .iterrows() atau .itertuples(). Keuntungan pendekatan ini adalah Anda mendapatkan kendali penuh atas baris. Sintaksnya sebagai berikut:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Berikut contoh praktis yang menunjukkan cara penerapannya.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Salah satu kasus penggunaan metode iterasi baris ini adalah saat Anda memerlukan kendali yang presisi atas urutan baris, atau saat menulis logika langkah demi langkah untuk debugging. Meskipun pendekatan ini menjadi tidak efisien untuk dataframe besar, ini juga lebih lambat daripada operasi vektorisasi.
Penting untuk menggunakan .loc[] saat Anda memerlukan pencarian berbasis label atau .iloc[] saat Anda memerlukan akses berbasis posisi, terutama dengan loop berbasis rentang.
Berikut tabel yang merangkum perbedaan ketiga metode tersebut.
|
Fitur |
iterows() |
itertuples() |
apply(axis=1) |
|
Sintaks |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Keluaran |
(index, Series) |
namedtuple |
Mengembalikan nilai dari fungsi (skalar atau Series) |
|
Kecepatan |
Lambat |
Paling cepat |
Sedang |
|
Penggunaan Memori |
Sedang |
Rendah |
Sedang |
|
Keterbacaan |
Sedang |
Tinggi |
Tinggi |
|
Kasus penggunaan terbaik |
Prototipe cepat atau debugging |
Dataset besar |
Turunan kolom |
|
Keterbatasan |
Lebih lambat |
Tidak bisa menangani logika baris yang kompleks |
Lebih lambat daripada vektorisasi penuh |
Walaupun metode .iterrows() merupakan cara yang lugas untuk mengiterasi baris Pandas DataFrame, ada keterbatasan yang dapat memengaruhi kinerja.
Iterasi dengan .iterrows() menghasilkan setiap baris DataFrame sebagai tuple yang berisi indeks baris, yaitu tabel, dan objek Series yang berisi data dalam baris tersebut.
Terlepas dari kesederhanaannya, ada kelemahan dalam hal konversi dtype; misalnya, mengonversi integer menjadi float jika Series perlu menampung tipe campuran, yang dapat menyebabkan bug halus dalam perhitungan atau perbandingan.
Selain itu, karena .iterrows() mengembalikan Series untuk setiap baris, ini mengakibatkan overhead memori, yang memperlambat kinerja dibandingkan operasi vektorisasi.
Modifikasi data di dalam loop menggunakan .iterrows() tidak disarankan, karena perubahan pada objek Series tidak diteruskan kembali ke dataframe.
Terlepas dari keterbatasan di atas, .iterrows() tetap berguna dalam beberapa skenario, seperti:
.iterrows() untuk operasi yang tidak dapat divektorisasi, seperti melakukan panggilan API, menulis ke file, atau berinteraksi dengan basis data secara baris demi baris..iterrows().Untuk menjaga konsistensi dtype, pertimbangkan untuk beralih ke .itertuples(), karena ini mengembalikan namedtuple tanpa konversi tipe.
.itertuples() lebih cepat dan lebih efisien memori daripada .iterrows() karena mengembalikan namedtuple. Mari kita lihat bagaimana beberapa fiturnya membuatnya lebih unggul daripada metode .iterrows().
Beberapa keunggulan .itertuples() meliputi:
Peningkatan kinerja: Alih-alih membuat objek Series seperti .iterrows() yang mengonsumsi memori dan menurunkan kinerja, .itertuples() menghindari overhead memori dan meningkatkan kinerja dengan menggunakan generator yang menghasilkan namedtuple.
Kustomisasi: Argumen index=False pada .itertuples() menghilangkan indeks dari tuple, dan menyetel argumen name= 'Custom' memungkinkan penetapan nama kelas namedtuple kustom, meningkatkan keterbacaan atau integrasi dengan sistem lain.
Saat menggunakan .itertuples(), penting untuk menyadari keterbatasan berikut.
Kendala penamaan kolom: Nama kolom yang berisi karakter khusus atau spasi dapat menghasilkan identifier Python yang tidak valid. Ini akan dimodifikasi menjadi nama yang valid atau diakses menggunakan pembongkaran tuple berbasis indeks.
Imutabilitas: Namedtuple bersifat immutable, yang berarti Anda tidak dapat mengubah nilainya secara in-place. Ini menyiratkan bahwa transformasi apa pun memerlukan pembuatan struktur baru atau mengumpulkan nilai yang diinginkan ke dalam daftar atau dataframe terpisah.
Berikut beberapa praktik terbaik yang perlu dipatuhi saat menggunakan .itertuples():
Walaupun metode utama iterasi baris adalah .iterrows() dan .itertuples(), pandas menyediakan alternatif lain yang lebih efisien untuk manipulasi data skala besar, seperti vektorisasi, yang efisien memori dan lebih cepat.
Operasi vektorisasi melibatkan penerapan operasi pada seluruh array atau kolom DataFrame sekaligus, memanfaatkan optimasi level rendah di NumPy dan Pandas. Ini lebih bersih dan mudah dibaca, serta secara drastis mengurangi waktu eksekusi.
Di bawah ini beberapa teknik vektorisasi umum dan contohnya:
Operasi aritmetika: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Logika kondisional: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Metode string: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Manipulasi datetime: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Operasi vektorisasi didukung oleh kode C terkompilasi dan manajemen memori yang dioptimalkan, sering kali mengungguli loop Python berkali-kali lipat, terutama untuk DataFrame besar.
Saat menerapkan logika per baris, disarankan Anda menggunakan metode .apply(axis=1). Meskipun tidak secepat vektorisasi, ini lebih efisien dan ekspresif daripada iterasi baris. .apply() terkadang lambat pada DataFrame besar karena masih melakukan loop secara internal di C. Namun, masih memadai untuk logika yang cukup kompleks.
Ada berbagai alat yang dapat Anda pertimbangkan untuk mengoptimalkan .apply(), seperti:
Swifter: Ini secara otomatis menentukan metode eksekusi .apply() yang tercepat.
Pandarallel: Memungkinkan Anda dengan mudah melakukan eksekusi paralel .apply() di banyak inti CPU hanya dengan satu baris kode.
Numba: Adalah compiler JIT yang mempercepat fungsi numerik Python. Saat Anda menggunakannya di dalam .apply(), ini dapat sangat mengurangi waktu komputasi untuk operasi numerik intensif.
Strategi yang kuat di Pandas adalah membuat kolom sementara untuk memecah operasi kompleks menjadi langkah-langkah vektorisasi yang dapat dikelola, yang menghindari kebutuhan akan iterasi eksplisit baris demi baris.
Ada berbagai strategi optimasi dan benchmark perbandingan untuk dieksplorasi, memastikan penanganan yang skalabel dan efisien memori, terutama saat bekerja dengan dataset besar.
Metode iterasi yang berbeda di Python dapat memiliki kinerja yang bervariasi. Misalnya, loop for dan while, ketika digunakan bersama metode Pandas seperti .itertuples() dan .iterrows(), secara signifikan lebih lambat daripada operasi vektorisasi.
Benchmark biasanya menunjukkan bahwa .itertuples() lebih cepat dan lebih efisien memori daripada .iterrows() karena mengembalikan namedtuple alih-alih Series. Operasi vektorisasi mengungguli semua bentuk iterasi lainnya karena implementasinya berbasis C.
Saat data meningkat hingga jutaan baris, perbedaan ini menjadi kritis karena metode yang tidak efisien dapat menyebabkan bottleneck dan peningkatan konsumsi memori.
Untuk dataset yang lebih besar, pertimbangkan menggunakan beberapa teknik berikut:
Pemrosesan per potongan (chunk): Gunakan parameter chunksize di .read_csv() untuk memproses data dalam blok yang dapat dikelola alih-alih memuat semuanya ke memori sekaligus.
Optimasi dtype: Cobalah menggunakan tipe data berbeda, seperti float32 alih-alih float64, untuk mengurangi penggunaan memori.
Manajemen memori: Hapus kolom yang tidak digunakan sejak awal, filter data sebelum menggabungkan, dan bebaskan memori secara berkala dengan gc.collect().
Komputasi out-of-core: Gunakan alat seperti Dask dan Vaex untuk memungkinkan komputasi paralel, out-of-core pada dataset yang melampaui kapasitas memori.
Ada berbagai skenario di mana penggunaan iterasi sangat berguna. Berikut beberapa contoh praktis yang menunjukkan pola iterasi umum dan praktik terbaik saat bekerja dengan Pandas.
Berikut contoh yang menunjukkan penggunaan dasar .iterrows(), .itertuples(), dan .apply(axis=1).
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldAnda dapat menggunakan metode iterasi baris untuk memodifikasi nilai DataFrame dalam loop; namun, pendekatan ini tidak efisien saat bekerja dengan dataset besar.
Contoh berikut menunjukkan cara mengimplementasikannya.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()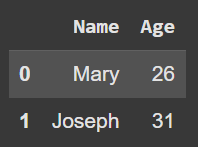
Saat bekerja dengan dataframe besar, pertimbangkan menggunakan operasi vektorisasi untuk meningkatkan kinerja, seperti pada contoh di bawah.
# Better approach using a vectorized method
students["age"] = students["age"] + 1Untuk memproses hanya baris tertentu, pertimbangkan menggunakan pemeriksaan kondisional di dalam loop, seperti pada contoh berikut, di mana baris dengan age lebih besar dari 25 dicetak.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Namun opsi vektorisasi di bawah ini lebih baik dan lebih berkinerja.
students_greater_than_5 = students[students["age"] > 25]Menghitung statistik ringkas selama pemrosesan per baris juga dimungkinkan; namun, Pandas menawarkan metode bawaan seperti .sum() dan .mean(), yang lebih cepat.
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Saat melakukan iterasi baris di Pandas, penting untuk memahami kompromi antara berbagai metode yang tersedia.
Gunakan .iterrows() saat Anda memerlukan solusi sederhana dan tidak bekerja dengan dataset besar, dan .itertuples() saat Anda memerlukan alternatif yang lebih cepat dan peningkatan kinerja.
Selalu jadikan operasi vektorisasi sebagai pilihan pertama saat memungkinkan, terutama dengan dataset yang lebih besar, karena lebih cepat dan lebih efisien berkat operasi berbasis C di baliknya.
Gunakan .apply() sebagai jalan tengah saat diperlukan operasi per baris atau per kolom yang tidak mudah divektorisasi.
Berikut beberapa sumber kami untuk mempelajari lebih lanjut tentang Pandas:
Anda juga dapat melihat halaman kursus berikut untuk mempercepat pembelajaran Anda:
Belajar Python bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



