Cursus
Datamanipulatie met pandas
4 uur
566.1K
Als je bewerkingen in een Pandas DataFrame rij voor rij moet uitvoeren, heb je rij-iteratie nodig. Hoewel Pandas is geoptimaliseerd voor gevectoriseerde bewerkingen, zijn rij-iteraties essentieel wanneer je logica toepast die niet gevectoriseerd is, vooral bij complexe datamanipulaties of conditionele rijverwerking.
Er zijn verschillende methoden die je op een Pandas DataFrame kunt toepassen om over rijen te itereren.
.iterrows(): Gebruik dit voor eenvoudige rijgewijze bewerkingen, waarbij index en rijkgegevens nodig zijn. Het retourneert index-serie-paren, wat traag kan zijn voor grote dataframes en niet geschikt is voor zware berekeningen.
.itertuples(): Gebruik dit als een sneller alternatief voor .iterrows(), vooral wanneer je geen Pandas Series nodig hebt. Het retourneert een namedtuple van rijwaarden en is geheugen-efficiënter dan .iterrows().
.apply(axis=1): Dit past een functie toe op elke rij, en wordt meestal gebruikt met het argument axis = 1. Het is trager dan gevectoriseerde methoden, maar vaak sneller dan expliciete lussen.
Hoewel Pandas is ontworpen om optimaal te werken met kolomgebaseerde bewerkingen, bieden verschillende Python-methoden ondersteuning voor rijgewijze iteratie, vooral wanneer je met individuele rijen werkt.
Pandas werkt met DataFrames in kolomformaat, waardoor het efficiënt is om transformaties tegelijk op DataFrame-kolommen toe te passen.
Dit is ook een van de redenen waarom gevectoriseerde bewerkingen efficiënt zijn in Pandas en doorgaans de voorkeur hebben boven rij-iteraties, die traag kunnen worden bij grote DataFrames.
De primaire methoden voor rij-iteratie zijn de volgende:
.iterrows(): Dit retourneert elke rij als een tuple van (index, Series).
.itertuples(): Sneller dan .iterrows() en levert elke rij op als een namedtuple.
.items(): Geen rij-iteratie, maar itereert over de kolommen van een Pandas DataFrame, retourneert een kolomlabel en Series, en wordt meestal gebruikt voor kolomgewijze bewerkingen.
Op basis van benchmarks van middelgrote DataFrames met 100.000 rijen is .itertuples() 5–10 keer sneller dan .iterrows() qua snelheid en geheugenefficiëntie. Dit komt omdat .itertuples() het aanmaken van Series-objecten per rij vermijdt en in plaats daarvan lichte namedtuples oplevert.
Gevectoriseerde bewerkingen zijn sneller dan elke vorm van iteratie omdat ze zijn geïmplementeerd in geoptimaliseerde C-code. Ze elimineren lussen op Python-niveau en verminderen de overhead. Zo is het optellen van twee kolommen met datacamp_rows[“A”] + sneller dan een datacamp_rows[“B”]for-lus met .iterrows().
.iterrows() heeft een grote geheugenvraag, omdat het een volledig Pandas Series-object retourneert, en deze Series kunnen last hebben van dtype-inconsistenties doordat ze afkomstig zijn uit verschillende kolommen met uiteenlopende datatypes.
Voor een kleinere dataset is het aan te raden .iterrows() te gebruiken, terwijl je voor grotere datasets .itertuples() kunt gebruiken.
Je kunt in situaties terechtkomen waarin je geen gevectoriseerde bewerkingen kunt toepassen en terug moet vallen op rij-iteratie. In dit gedeelte leer je wanneer je rij-iteraties wel en niet moet gebruiken.
Typische scenario’s voor rij-iteraties zijn:
Ondanks de use-cases van rijgewijze iteraties, moet je ze in sommige gevallen vermijden, zoals:
In plaats van te itereren, overweeg de volgende alternatieven:
Gebruik waar mogelijk gevectoriseerde bewerkingen.
Maak gebruik van .apply() met geoptimaliseerde functies voor complexe maar nog steeds vectoriseerbare taken.
Overweeg batchverwerking of parallelisatie als je móét itereren maar prestatiebeperkingen hebt.
Vermijd de volgende veelvoorkomende valkuilen van rijgewijze lussen, zoals:
.iterrows() retourneert een kopie, geen referentie naar de oorspronkelijke rij; het wijzigen ervan past dus de oorspronkelijke DataFrame niet aan.
Het is lastiger te lezen en onderhouden vergeleken met gevectoriseerde bewerkingen.
Je kunt rij-iteratie in Pandas DataFrames implementeren met verschillende methoden, afhankelijk van je use-case of de aard van de DataFrame. Dit zijn de methoden om over rijen van Pandas DataFrames te itereren.
De methode .iterrows() omvat het itereren over individuele rijen van een DataFrame. De syntaxis is als volgt:
for index, row in datacamp_rows.iterrows():
	# code to process each row
Waarbij datacamp_rows de DataFrame is waarover wordt geïtereerd, index de rij-index is en row de Pandas Series met de rijgegevens.
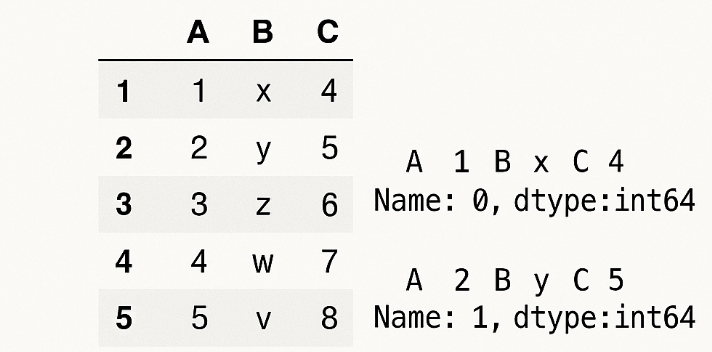
Hier is een eenvoudig voorbeeld van gebruik:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30De methode .iterrows() retourneert een generator die de index van een rij oplevert, samen met een Series-object dat de rijen vertegenwoordigt. De keys van dit Series-object zijn kolomnamen en de waarden zijn de bijbehorende gegevens in elke rij.
Intern geeft .iterrows() het volgende terug.
(index_0, Series_0)
(index_1, Series_1)
.itertuples() is sneller en geheugen-efficiënter dan .iterrows(), en retourneert elke rij als een namedtuple, zodat je kolomwaarden met dot-notatie kunt benaderen. De syntaxis is als volgt weergegeven:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
Waarbij index=True de DataFrame-index als eerste element van elke tuple opneemt, en name="Pandas" de naam instelt van de geretourneerde namedtuple-klasse. Als name=None, retourneert de for-lus een reguliere tuple zonder toegang tot attributen.
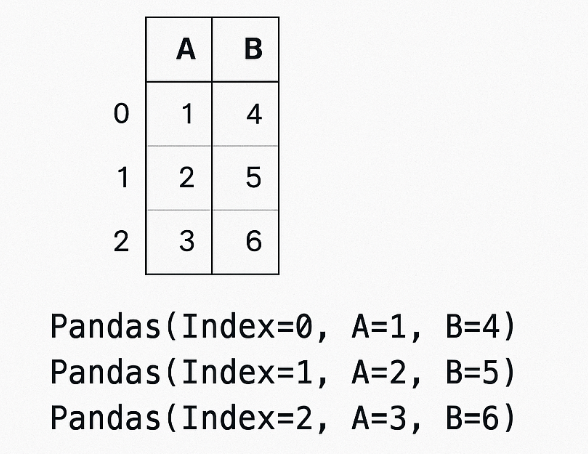
Hier is een praktisch voorbeeld van hoe .itertuples() werkt:
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() retourneert een generator die namedtuples oplevert, waarbij elke rij wordt weergegeven als een lichtgewicht object.
Je kunt elk veld van de rij met dot-notatie benaderen, zoals row.Name en row.age, voorafgegaan door de index.
Intern geeft het dit terug:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)De methode .apply() in Pandas is handig bij het toepassen van functies op rijen om rijgewijze iteraties uit te voeren, zoals wanneer je het argument axis=1 gebruikt. De syntaxis is als volgt:
df.apply(func, axis=1)Waarbij de functie die op de rij wordt toegepast func is, terwijl het argument axis=1 is ingesteld.
Hier is een praktisch voorbeeld ter illustratie.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()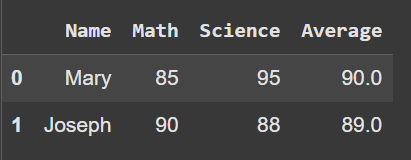
Gebruik de methode .apply() bij het maken van nieuwe kolommen op basis van bestaande, of bij het toepassen van aangepaste berekeningen of transformaties.
Wat rij-iteratie betreft, kun je deze gebruiken om conditionele logica per rij te maken, zoals if-else-instructies. Wanneer axis=1 is ingesteld, wordt de functie doorgegeven als een Series met kolomnamen als index. Deze functie verwerkt de rijen en retourneert een scalair in een nieuwe kolom of een Series in meerdere kolommen.
Hoewel .apply(axis=1) trager is dan gevectoriseerde bewerkingen, is het sneller en schoner dan .iterrows().
Een andere workaround voor rij-iteraties is dat je .loc[] of .iloc[] handmatig met for-lussen gebruikt om over een Pandas DataFrame te itereren.
Dit werkt vergelijkbaar met de methoden .iterrows() of .itertuples(). Een voordeel van deze aanpak is dat je volledige controle over de rijen krijgt. De syntaxis is als volgt:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Hier is een praktisch voorbeeld van de implementatie.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Een van de use-cases voor deze methode van rij-iteratie is wanneer je nauwkeurige controle over de rijvolgorde nodig hebt, of wanneer je stap-voor-stap logica schrijft voor debugging. Hoewel deze aanpak inefficiënt wordt voor grote dataframes, is hij ook trager dan gevectoriseerde bewerkingen.
Het is essentieel om .loc[] te gebruiken wanneer je labelgebaseerde lookup nodig hebt of .iloc[] wanneer je positiegebaseerde toegang nodig hebt, vooral met bereikgebaseerde lussen.
Hier is een tabel die de verschillen tussen de drie methoden samenvat.
|
Functies |
iterows() |
itertuples() |
apply(axis=1) |
|
Syntaxis |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Output |
(index, Series) |
namedtuple |
Retourneert een waarde van de functie (scalair of Series) |
|
Snelheid |
Traag |
Snelst |
Gemiddeld |
|
Geheugengebruik |
Middel |
Laag |
Middel |
|
Leesbaarheid |
Gemiddeld |
Hoog |
Hoog |
|
Beste use-cases |
Snel prototypen of debuggen |
Grote datasets |
Afgeleide kolommen |
|
Beperkingen |
Trager |
Kan geen complexe rijlogica aan |
Trager dan volledige vectorisatie |
Hoewel de methode .iterrows() een eenvoudige manier is om over de rijen van een Pandas DataFrame te itereren, heeft ze beperkingen die de prestaties kunnen beïnvloeden.
Iteratie met .iterrows() levert elke rij van een DataFrame op als een tuple die de rij-index bevat, dat is de tabel, en een Series-object dat de gegevens in de rij bevat.
Ondanks de eenvoud heeft het een nadeel qua dtype-conversie; zo zet het gehele getallen om in floats als de Series gemengde types moet bevatten, wat kan leiden tot subtiele bugs in berekeningen of vergelijkingen.
Daarnaast zorgt .iterrows() voor geheugenoverhead omdat het voor elke rij een Series retourneert, wat de prestaties vertraagt vergeleken met gevectoriseerde bewerkingen.
Gegevens wijzigen binnen een lus met .iterrows() wordt afgeraden, omdat wijzigingen aan het Series-object niet worden teruggeschreven naar de DataFrame.
Ondanks bovenstaande beperkingen blijft .iterrows() nuttig in sommige scenario’s, zoals:
.iterrows() gebruiken voor niet-vectoriseerbare bewerkingen, zoals API-calls, schrijven naar bestanden of interactie met databases op rijbasis..iterrows() gebruiken.Om dtype-consistentie te behouden, kun je overstappen op .itertuples(), omdat die named tuples retourneert zonder typeconversie.
.itertuples() is sneller en geheugen-efficiënter dan .iterrows() omdat het een namedtuple retourneert. Laten we bekijken hoe enkele van de kenmerken het superieur maken aan de methode .iterrows().
Enkele voordelen van .itertuples() zijn:
Prestatievoordelen: In plaats van Series-objecten te maken zoals .iterrows(), die geheugen verbruiken en prestaties verminderen, vermijdt .itertuples() geheugenoverhead en verbetert het de prestaties door een generator te gebruiken die namedtuples oplevert.
Aanpasbaarheid: Het argument index=False in .itertuples() laat de index weg uit de tuple, en met het argument name='Custom' kun je een aangepaste namedtuple-klassenaam instellen, wat de leesbaarheid of integratie met andere systemen verbetert.
Bij het gebruik van .itertuples() is het belangrijk om de volgende beperkingen te kennen.
Beperkingen in kolomnamen: Kolomnamen met speciale tekens of spaties kunnen resulteren in ongeldige Python-identifiers. Deze worden aangepast naar geldige namen of benaderd via indexgebaseerde tuple-unpacking.
Onveranderlijkheid: Namedtuples zijn immutable, wat betekent dat je hun waarden niet in-place kunt wijzigen. Dit impliceert dat elke transformatie vereist dat je een nieuwe structuur opbouwt of de gewenste waarden verzamelt in een aparte lijst of dataframe.
Hier zijn enkele best practices om te volgen bij het gebruik van .itertuples():
Hoewel de primaire methoden voor rij-iteraties .iterrows() en .itertuples() zijn, biedt pandas andere alternatieven die efficiënter zijn voor grootschalige datamanipulatie, zoals vectorisatie, die geheugen-efficiënt en sneller is.
Gevectoriseerde bewerkingen passen operaties in één keer toe op volledige arrays of DataFrame-kolommen, waarbij gebruik wordt gemaakt van low-level optimalisaties in NumPy en Pandas. Het is schoner en leesbaarder en verkort de uitvoeringstijd drastisch.
Hieronder staan enkele veelvoorkomende vectorisatietechnieken en voorbeelden:
Rekenkundige bewerkingen: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Conditionele logica: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Stringmethoden: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Datetime-manipulaties: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Gevectoriseerde bewerkingen worden ondersteund door gecompileerde C-code en geoptimaliseerd geheugengebruik, en presteren vaak ordes van grootte beter dan Python-lussen, vooral voor grote DataFrames.
Bij het implementeren van rijgewijze logica wordt aangeraden de methode .apply(axis=1) te gebruiken. Hoewel het niet zo snel is als vectorisatie, is het efficiënter en expressiever dan rij-iteratie. .apply() is soms traag op grote DataFrames omdat het intern nog in C loopt. Voor matig complexe logica is het echter goed hanteerbaar.
Er zijn verschillende tools die je kunt overwegen om .apply() te optimaliseren, zoals:
Swifter: Bepaalt automatisch de snelste manier om .apply() uit te voeren.
Pandarallel: Maakt het eenvoudig om .apply() parallel uit te voeren over meerdere CPU-cores met slechts één regel code.
Numba: Is een JIT-compiler die numerieke Python-functies versnelt. Wanneer je het binnen .apply() gebruikt, kan het de rekentijd voor numeriek intensieve operaties drastisch verminderen.
Een krachtige strategie in Pandas is om tijdelijke kolommen te maken om complexe bewerkingen op te delen in hanteerbare gevectoriseerde stappen, waardoor expliciete rij-voor-rij-iteratie niet nodig is.
Er zijn verschillende optimalisatiestrategieën en vergelijkende benchmarks te verkennen, om schaalbare en geheugen-efficiënte verwerking te waarborgen, vooral bij grote datasets.
Verschillende iteratiemethoden in Python kunnen uiteenlopende prestaties hebben. Zo zijn for- en while-lussen, in combinatie met Pandas-methoden zoals .itertuples() en .iterrows(), aanzienlijk trager dan gevectoriseerde bewerkingen.
Benchmarks tonen doorgaans aan dat .itertuples() sneller en geheugen-efficiënter is dan .iterrows() omdat het namedtuples retourneert in plaats van Series. Gevectoriseerde bewerkingen presteren beter dan alle andere vormen van iteratie vanwege hun onderliggende C-implementaties.
Wanneer data opschaalt naar miljoenen rijen, worden deze verschillen cruciaal, omdat inefficiënte methoden kunnen leiden tot knelpunten en verhoogd geheugengebruik.
Voor grotere datasets kun je enkele van deze technieken overwegen:
Chunks verwerken: Gebruik de parameter chunksize in .read_csv() om data in beheersbare blokken te verwerken in plaats van alles in één keer in het geheugen te laden.
Dtype-optimalisatie: Probeer andere datatypes te gebruiken, zoals float32 in plaats van float64, om geheugengebruik te verminderen.
Geheugenbeheer: Laat ongebruikte kolommen vroegtijdig vallen, filter data vóór het mergen en maak periodiek geheugen vrij met gc.collect().
Out-of-core computing: Gebruik tools zoals Dask en Vaex om parallelle, out-of-core-berekeningen mogelijk te maken op datasets die het geheugen overschrijden.
Er zijn verschillende scenario’s waarin iteratie goed van pas komt. Hier zijn enkele praktische voorbeelden die veelvoorkomende iteratiepatronen en best practices laten zien bij het werken met Pandas.
Hier is een voorbeeld dat het basisgebruik van .iterrows(), .itertuples() en .apply(axis=1) laat zien.
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldJe kunt methoden voor rij-iteratie gebruiken om DataFrame-waarden in een lus te wijzigen; deze aanpak is echter niet efficiënt bij grote datasets.
De volgende voorbeelden laten zien hoe je dit implementeert.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()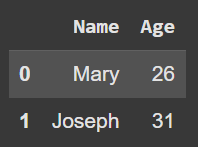
Bij grote dataframes kun je beter een gevectoriseerde bewerking gebruiken om de prestaties te verhogen, zoals in het onderstaande voorbeeld.
# Better approach using a vectorized method
students["age"] = students["age"] + 1Om alleen specifieke rijen te verwerken, kun je een voorwaardelijke check in de lus gebruiken, zoals in het volgende voorbeeld, waar rijen met age groter dan 25 worden afgedrukt.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Hoewel de gevectoriseerde optie hieronder beter en performanter is.
students_greater_than_5 = students[students["age"] > 25]Het is ook mogelijk om samenvattende statistieken te berekenen tijdens rijgewijze verwerking; Pandas biedt echter ingebouwde methoden zoals .sum() en .mean(), die sneller zijn.
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Bij het uitvoeren van rij-iteratie in Pandas is het essentieel om de afwegingen tussen de verschillende beschikbare methoden te begrijpen.
Gebruik .iterrows() wanneer je een eenvoudige oplossing nodig hebt en niet met een grote dataset werkt, en .itertuples() wanneer je een sneller alternatief en betere prestaties nodig hebt.
Maak gevectoriseerde bewerkingen altijd je eerste keuze waar toepasselijk, vooral bij grotere datasets, omdat ze sneller en efficiënter zijn dankzij de onderliggende C-gebaseerde operaties.
Gebruik .apply() als middenweg wanneer een rij- of kolomgewijze bewerking nodig is die niet eenvoudig te vectoriseren is.
Hier zijn enkele van onze resources om meer te leren over Pandas:
Bekijk ook onze volgende cursuspagina’s om je leerproces te versnellen:
Leer Python met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

