
कोर्स
pandas के साथ Data Manipulation
4 घंटा
567.4K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंजब आपको Pandas DataFrame में पंक्तियों पर एक-एक करके ऑपरेशंस करने की आवश्यकता होती है, तो आपको रो इटरेशन का उपयोग करना पड़ता है। हालांकि Pandas को वेक्टराइज़्ड ऑपरेशंस के लिए अनुकूलित किया गया है, फिर भी ऐसी स्थितियों में रो इटरेशन आवश्यक होता है जहां लॉजिक वेक्टराइज़्ड नहीं है—खासकर जटिल डेटा बदलावों या कंडीशनल रो प्रोसेसिंग में।
DataFrame पर रो इटरेशन करने के लिए आप कई तरीके अपना सकते हैं।
.iterrows(): इसे साधारण रो-वार ऑपरेशंस के लिए उपयोग करें, जहां इंडेक्स और रो डेटा दोनों चाहिए। यह इंडेक्स-सीरीज़ जोड़े लौटाता है, जो बड़े डेटा फ्रेम्स के लिए धीमा हो सकता है और भारी कंप्यूटेशन के लिए उपयुक्त नहीं है।
.itertuples(): .iterrows() का तेज विकल्प, खासकर तब जब आपको Pandas Series की आवश्यकता नहीं है। यह हर रो के लिए namedtuple लौटाता है और .iterrows() की तुलना में अधिक मेमोरी-कुशल है।
.apply(axis=1): यह हर पंक्ति पर एक फ़ंक्शन लागू करता है, और आमतौर पर axis = 1 आर्ग्यूमेंट के साथ इस्तेमाल होता है। यह वेक्टराइज़्ड तरीकों से धीमा है, लेकिन अक्सर स्पष्ट लूप्स से तेज होता है।
हालांकि Pandas को कॉलम-आधारित ऑपरेशंस के साथ सर्वश्रेष्ठ रूप से चलने के लिए डिज़ाइन किया गया है, फिर भी व्यक्तिगत पंक्तियों पर काम करते समय कई Python तरीके रो-वार इटरेशन को आसान बनाते हैं।
Pandas DataFrames पर कॉलमनर फॉर्मेट में काम करता है, इसलिए एक साथ कॉलम-स्तरीय ट्रांसफॉर्मेशन लागू करना कुशल होता है।
इसी वजह से Pandas में वेक्टराइज़्ड ऑपरेशंस अत्यधिक प्रभावी हैं, और रो इटरेशन की तुलना में आमतौर पर इन्हीं को प्रोत्साहित किया जाता है—क्योंकि बड़े DataFrames पर रो इटरेशन धीमा पड़ सकता है।
प्रमुख रो इटरेशन तरीके निम्नलिखित हैं:
.iterrows(): यह प्रत्येक पंक्ति को (index, Series) ट्यूपल के रूप में लौटाता है।
.itertuples(): .iterrows() से तेज और प्रत्येक पंक्ति को namedtuple के रूप में देता है।
.items(): यह रो इटरेशन नहीं है—यह DataFrame के कॉलम्स पर इटरेट करता है, कॉलम लेबल और Series लौटाता है, और आमतौर पर कॉलम-वार ऑपरेशंस के लिए उपयोग होता है।
लगभग 100,000 पंक्तियों वाले मध्यम आकार के DataFrames के बेंचमार्क के आधार पर, गति और मेमोरी दक्षता के लिहाज से .itertuples() .iterrows() से 5–10 गुना तेज है। इसका कारण यह है कि .itertuples() हर पंक्ति के लिए Series ऑब्जेक्ट बनाने से बचता है और इसके बजाय हल्के namedtuples देता है।
वेक्टराइज़्ड ऑपरेशंस किसी भी प्रकार के इटरेशन से तेज होते हैं क्योंकि वे ऑप्टिमाइज़्ड C कोड में लागू होते हैं। ये Python-स्तर के लूप्स को हटाकर ओवरहेड कम करते हैं। उदाहरण के लिए, datacamp_rows[“A”] + से दो कॉलम जोड़ना datacamp_rows[“B”].iterrows() के साथ for लूप की तुलना में तेज है।
.iterrows() का मेमोरी फुटप्रिंट बड़ा होता है क्योंकि यह पूरी Pandas Series ऑब्जेक्ट लौटाता है, और अलग-अलग कॉलम्स के भिन्न dtypes के कारण इसमें dtype असंगतियां भी हो सकती हैं।
छोटे डेटासेट के लिए .iterrows() का उपयोग करने की सिफारिश है, जबकि बड़े डेटासेट के लिए आप .itertuples() का उपयोग कर सकते हैं।
आप ऐसी स्थितियों में हो सकते हैं जहां आप वेक्टराइज़्ड ऑपरेशंस लागू नहीं कर सकते, और आपको रो इटरेशन का सहारा लेना पड़ सकता है। इस खंड में आप जानेंगे कि रो इटरेशन कब करना चाहिए और कब नहीं।
रो इटरेशन के सामान्य परिदृश्य शामिल हैं:
रो-वार इटरेशन के उपयोग के बावजूद, कुछ स्थितियों में आपको इससे बचना चाहिए, जैसे:
इटरेट करने के बजाय, निम्न विकल्पों पर विचार करें:
जहां संभव हो, वेक्टराइज़्ड ऑपरेशंस का उपयोग करें।
जटिल परंतु अभी भी वेक्टराइज़ किए जा सकने वाले कार्यों के लिए अनुकूलित फ़ंक्शंस के साथ .apply() का लाभ उठाएं।
यदि इटरेशन अनिवार्य हो और परफॉर्मेंस बाधाएं हों, तो बैच प्रोसेसिंग या पैरेललाइज़ेशन पर विचार करें।
रो-वार लूप्स की निम्न सामान्य कमियों से बचना आवश्यक है:
.iterrows() एक कॉपी लौटाता है, मूल रो का रेफरेंस नहीं; इसलिए इसमें बदलाव करने से मूल DataFrame नहीं बदलता।
वेक्टराइज़्ड ऑपरेशंस की तुलना में इसे पढ़ना और मेंटेन करना कठिन होता है।
आप Pandas DataFrames में अपने उपयोग-केस या DataFrame की प्रकृति के आधार पर विभिन्न तरीकों से रो इटरेशन लागू कर सकते हैं। यहां Pandas DataFrames की पंक्तियों पर इटरेट करने के तरीके दिए गए हैं।
.iterrows() विधि में DataFrame की व्यक्तिगत पंक्तियों पर इटरेट करना शामिल है। इसका सिंटैक्स इस प्रकार है:
for index, row in datacamp_rows.iterrows():
	# code to process each row
जहां datacamp_rows वह DataFrame है जिस पर इटरेट किया जा रहा है, index रो का इंडेक्स है, और row वह Pandas Series है जिसमें रो का डेटा होता है।
यह एक बुनियादी उदाहरण है:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
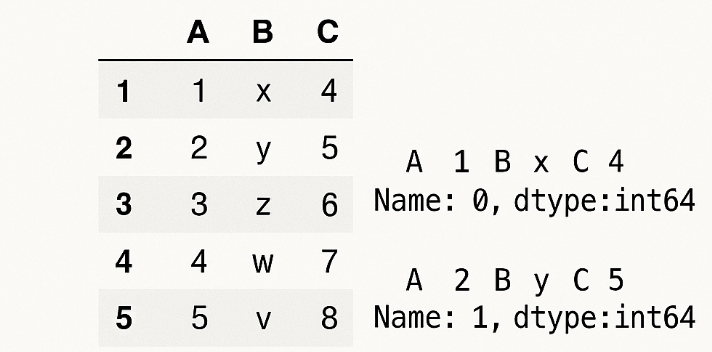
Index: 1, Name: Joseph, Age: 30.iterrows() एक जेनरेटर लौटाता है जो रो का इंडेक्स और उस रो का प्रतिनिधित्व करती Series देता है। इस Series की keys कॉलम नाम होते हैं, और values प्रत्येक रो में संबंधित डेटा।
आंतरिक रूप से, .iterrows() यह लौटाता है:
(index_0, Series_0)
(index_1, Series_1)
.itertuples() .iterrows() से तेज और अधिक मेमोरी-कुशल है, और यह प्रत्येक पंक्ति को namedtuple के रूप में लौटाता है, जिससे डॉट नोटेशन के जरिए कॉलम वैल्यूज़ एक्सेस की जा सकती हैं। सिंटैक्स इस प्रकार है:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
जहां index=True प्रत्येक ट्यूपल के पहले तत्व के रूप में DataFrame इंडेक्स को शामिल करता है, और name="Pandas" लौटाए गए namedtuple क्लास का नाम सेट करता है। यदि name=None दिया जाए, तो for लूप साधारण ट्यूपल लौटाएगा जिसके गुणों तक पहुंच नहीं होगी।
आइए देखें कि .itertuples() व्यावहारिक रूप से कैसे काम करता है:
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
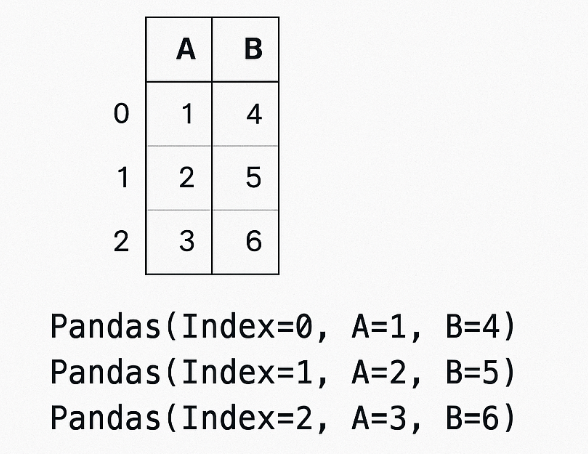
Index: 1, Name: Joseph, Age: 30.itertuples() एक जेनरेटर लौटाता है जो namedtuples देता है, जिनमें प्रत्येक पंक्ति को हल्के ऑब्जेक्ट के रूप में दर्शाया जाता है।
आप प्रत्येक रो फ़ील्ड को डॉट नोटेशन जैसे row.Name और row.age से एक्सेस कर सकते हैं, जो इंडेक्स से पहले होता है।
आंतरिक रूप से, यह यह लौटाता है:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)Pandas में .apply() मेथड रो-वार इटरेशन करने के लिए उपयोगी है, जैसा कि axis=1 आर्ग्यूमेंट के साथ देखा जाता है। सिंटैक्स इस प्रकार है:
df.apply(func, axis=1)जहां पंक्ति पर लागू किया जाने वाला फ़ंक्शन func है, और axis=1 आर्ग्यूमेंट सेट होता है।
यहां इसके उपयोग का एक व्यावहारिक उदाहरण है।
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()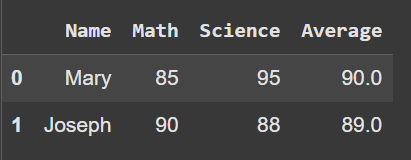
.apply() का उपयोग तब करें जब आपको मौजूदा कॉलम्स के आधार पर नए कॉलम बनाने हों, या कस्टम कैलकुलेशन/ट्रांसफॉर्मेशन लागू करने हों।
रो-इटरेशन के संदर्भ में, आप इसे प्रत्येक पंक्ति के लिए कंडीशनल लॉजिक (जैसे if-else) बनाने में उपयोग कर सकते हैं। जब axis=1 सेट होता है, तो फ़ंक्शन को Series के रूप में पास किया जाता है जिसमें कॉलम नाम इंडेक्स होते हैं। यह फ़ंक्शन पंक्तियों को प्रोसेस करता है और किसी नए कॉलम में scalar वैल्यू या कई कॉलम्स में series लौटाता है।
हालांकि .apply(axis=1) वेक्टराइज़्ड ऑपरेशंस से धीमा है, यह .iterrows() से अधिक तेज़ और साफ़-सुथरा होता है।
रो इटरेशन का एक और उपाय यह है कि आप Pandas DataFrame पर .loc[] या .iloc[] को for लूप्स के साथ मैन्युअली उपयोग करें।
यह .iterrows() या .itertuples() की तरह ही काम करता है। इस अप्रोच का एक लाभ यह है कि आपको पंक्तियों पर पूरा नियंत्रण मिलता है। सिंटैक्स इस प्रकार है:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
यहां इसका एक व्यावहारिक उदाहरण दिया गया है।
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30इस तरीके का उपयोग तब करें जब आपको रो ऑर्डर पर सटीक नियंत्रण चाहिए, या डिबगिंग के लिए स्टेप-बाय-स्टेप लॉजिक लिखना हो। हालांकि बड़े DataFrames के लिए यह तरीका अक्षम हो जाता है और वेक्टराइज़्ड ऑपरेशंस से धीमा होता है।
लेबल-आधारित खोज के लिए .loc[] और पोज़िशन-आधारित एक्सेस के लिए .iloc[] का उपयोग करना आवश्यक है, खासकर रेंज-आधारित लूप्स के साथ।
यहां इन तीनों तरीकों के बीच का अंतर संक्षेप में दिया गया है।
|
विशेषताएं |
iterrows() |
itertuples() |
apply(axis=1) |
|
सिंटैक्स |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
आउटपुट |
(index, Series) |
namedtuple |
फ़ंक्शन का रिटर्न वैल्यू (scalar या Series) |
|
गति |
धीमा |
सबसे तेज़ |
मध्य-स्तरीय |
|
मेमोरी उपयोग |
मध्यम |
कम |
मध्यम |
|
रीडेबिलिटी |
मध्यम |
उच्च |
उच्च |
|
सबसे उपयुक्त उपयोग |
त्वरित प्रोटोटाइपिंग या डिबगिंग |
बड़े डेटासेट |
कॉलम व्युत्पत्ति |
|
सीमाएं |
धीमा |
जटिल रो लॉजिक संभाल नहीं सकता |
पूर्ण वेक्टराइज़ेशन से धीमा |
हालांकि .iterrows() Pandas DataFrame की पंक्तियों पर इटरेट करने का सरल तरीका है, इसकी कुछ सीमाएं हैं जो परफॉर्मेंस को प्रभावित कर सकती हैं।
.iterrows() के साथ इटरेशन प्रत्येक पंक्ति को एक ट्यूपल के रूप में देता है जिसमें रो इंडेक्स (तालिका का इंडेक्स) और एक Series ऑब्जेक्ट होता है जो उस पंक्ति का डेटा रखता है।
इसके सरल होने के बावजूद, इसमें dtype रूपांतरण की कमी है; उदाहरण के लिए, यदि Series को मिश्रित प्रकारों को समायोजित करना हो, तो यह integers को floats में बदल सकता है, जो गणनाओं या तुलनाओं में सूक्ष्म बग ला सकता है।
इसके अलावा, क्योंकि .iterrows() हर पंक्ति के लिए Series लौटाता है, इससे मेमोरी ओवरहेड बढ़ता है, जो वेक्टराइज़्ड ऑपरेशंस की तुलना में परफॉर्मेंस को धीमा करता है।
लूप के भीतर .iterrows() का उपयोग करके डेटा संशोधित करना हतोत्साहित किया जाता है, क्योंकि Series ऑब्जेक्ट में किए गए बदलाव DataFrame में वापस लागू नहीं होते।
उपरोक्त सीमाओं के बावजूद, .iterrows() कुछ परिदृश्यों में उपयोगी रहता है, जैसे:
.iterrows() का उपयोग करें, जैसे API कॉल करना, फाइल में लिखना, या डेटाबेस से रो-बाय-रो इंटरैक्ट करना।.iterrows() उपयोगी है।dtype संगति बनाए रखने के लिए .itertuples() पर स्विच करने पर विचार करें, क्योंकि यह टाइप कन्वर्ज़न के बिना named tuples लौटाता है।
.itertuples() मेथड .iterrows() से तेज और अधिक मेमोरी-कुशल है क्योंकि यह namedtuple लौटाता है। आइए देखें कि इसकी कौन-सी विशेषताएं इसे .iterrows() से बेहतर बनाती हैं।
.itertuples() के कुछ लाभ शामिल हैं:
परफॉर्मेंस लाभ: .iterrows() की तरह Series ऑब्जेक्ट बनाने के बजाय—जो मेमोरी लेता है और परफॉर्मेंस घटाता है—.itertuples() जेनरेटर द्वारा namedtuples देता है, जिससे मेमोरी ओवरहेड से बचा जा सके और परफॉर्मेंस बेहतर हो।
कस्टमाइज़ेबिलिटी: .itertuples() में index=False आर्ग्यूमेंट ट्यूपल से इंडेक्स हटाता है, और name= 'Custom' सेट करने से लौटाए गए namedtuple क्लास का कस्टम नाम तय किया जा सकता है, जिससे रीडेबिलिटी या अन्य सिस्टम्स के साथ इंटीग्रेशन बेहतर होता है।
.itertuples() का उपयोग करते समय निम्न सीमाओं पर ध्यान देना आवश्यक है।
कॉलम नाम संबंधी बाधाएं: विशेष अक्षरों या स्पेस वाले कॉलम नाम अमान्य Python identifiers बन सकते हैं। इन्हें या तो मान्य नामों में बदला जाता है या इंडेक्स-आधारित ट्यूपल अनपैकिंग से एक्सेस किया जाता है।
Immutability: Namedtuples अपरिवर्तनीय होते हैं, यानी आप उनके मानों को इन-प्लेस नहीं बदल सकते। किसी भी ट्रांसफॉर्मेशन के लिए नया स्ट्रक्चर बनाना या इच्छित मानों को अलग सूची या DataFrame में इकट्ठा करना होगा।
.itertuples() का उपयोग करते समय कुछ सर्वोत्तम प्रथाएं:
हालांकि रो इटरेशन के प्राथमिक तरीके .iterrows() और .itertuples() हैं, pandas बड़े पैमाने पर डेटा मैनिपुलेशन के लिए अन्य अधिक कुशल विकल्प प्रदान करता है—जैसे वेक्टराइज़ेशन—जो मेमोरी-कुशल और तेज है।
वेक्टराइज़्ड ऑपरेशंस में पूरी ऐरेज़ या DataFrame कॉलम्स पर एक साथ ऑपरेशंस लागू करना शामिल है, जो NumPy और Pandas में निम्न-स्तरीय अनुकूलनों का लाभ उठाते हैं। यह अधिक साफ़-सुथरा और पढ़ने में आसान होता है और निष्पादन समय को काफी घटाता है।
नीचे कुछ सामान्य वेक्टराइज़ेशन तकनीकें और उदाहरण दिए गए हैं:
अंकगणितीय ऑपरेशंस: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
कंडीशनल लॉजिक: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
स्ट्रिंग मेथड्स: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Datetime संशोधन: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
वेक्टराइज़्ड ऑपरेशंस कंपाइल्ड C कोड और अनुकूलित मेमोरी प्रबंधन से समर्थित होते हैं, और बड़े DataFrames के लिए अक्सर Python लूप्स से कई गुना बेहतर प्रदर्शन करते हैं।
जब रो-वार लॉजिक लागू करना हो, तो .apply(axis=1) का उपयोग करने की सिफारिश की जाती है। यह वेक्टराइज़ेशन जितना तेज़ नहीं है, पर रो इटरेशन से अधिक कुशल और अभिव्यंजक है। बड़े DataFrames पर .apply() कभी-कभी धीमा हो सकता है क्योंकि यह अंदरूनी रूप से C में लूप करता है, लेकिन मध्यम जटिल लॉजिक के लिए यह प्रबंधनीय है।
.apply() के अनुकूलन के लिए आप निम्न टूल्स पर विचार कर सकते हैं:
Swifter: यह स्वतः .apply() के लिए सबसे तेज निष्पादन तरीका चुनता है।
Pandarallel: यह सिर्फ एक लाइन कोड से .apply() को कई CPU कोर्स पर पैरेलल रूप से चलाने देता है।
Numba: एक JIT कंपाइलर जो न्यूमेरिक Python फ़ंक्शंस को तेज करता है। इसे .apply() के अंदर उपयोग करने पर संख्यात्मक रूप से भारी ऑपरेशंस के समय में उल्लेखनीय कमी आ सकती है।
Pandas में एक शक्तिशाली रणनीति यह है कि जटिल ऑपरेशंस को प्रबंधन योग्य वेक्टराइज़्ड चरणों में तोड़ने के लिए अस्थायी कॉलम बनाएं, जिससे स्पष्ट रो-बाय-रो इटरेशन की आवश्यकता न रहे।
स्केलेबल और मेमोरी-कुशल हैंडलिंग सुनिश्चित करने के लिए—खासकर बड़े डेटासेट्स पर—विभिन्न ऑप्टिमाइज़ेशन रणनीतियां और तुलनात्मक बेंचमार्क्स देखने लायक हैं।
Python में अलग-अलग इटरेशन तरीके भिन्न परफॉर्मेंस दे सकते हैं। उदाहरण के लिए, for और while लूप्स, जब Pandas के .itertuples() और .iterrows() जैसे तरीकों के साथ उपयोग किए जाते हैं, तो वेक्टराइज़्ड ऑपरेशंस की तुलना में काफी धीमे होते हैं।
बेंचमार्क सामान्यतः दिखाते हैं कि .itertuples() .iterrows() से तेज और अधिक मेमोरी-कुशल है क्योंकि यह Series के बजाय namedtuples लौटाता है। वेक्टराइज़्ड ऑपरेशंस, अपने C-आधारित इम्प्लीमेंटेशंस के कारण, सभी प्रकार के इटरेशंस से बेहतर प्रदर्शन करते हैं।
जैसे-जैसे डेटा लाखों पंक्तियों तक बढ़ता है, ये अंतर महत्वपूर्ण हो जाते हैं—अक्षम तरीके बॉटलनेक्स और मेमोरी खपत में वृद्धि का कारण बनते हैं।
बड़े डेटासेट्स के लिए, इन तकनीकों पर विचार करें:
चंक प्रोसेसिंग: .read_csv() में chunksize पैरामीटर का उपयोग करके डेटा को एक साथ मेमोरी में लोड करने के बजाय प्रबंधनीय ब्लॉक्स में प्रोसेस करें।
dtype ऑप्टिमाइज़ेशन: मेमोरी उपयोग कम करने के लिए float64 के बजाय float32 जैसे विभिन्न डेटा प्रकार आज़माएं।
मेमोरी प्रबंधन: अनुपयोगी कॉलम्स को जल्दी ड्रॉप करें, मर्जिंग से पहले डेटा को फिल्टर करें, और समय-समय पर gc.collect() से मेमोरी फ्री करें।
आउट-ऑफ-कोर कंप्यूटिंग: समानांतर, आउट-ऑफ-कोर कंप्यूटेशन के लिए Dask और Vaex जैसे टूल्स का उपयोग करें—जब डेटासेट मेमोरी क्षमता से अधिक हो।
कई परिदृश्यों में इटरेशन काम आता है। यहां कुछ व्यावहारिक उदाहरण हैं जो Pandas के साथ काम करते समय सामान्य इटरेशन पैटर्न और सर्वोत्तम प्रथाओं को दर्शाते हैं।
यहां .iterrows(), .itertuples(), और .apply(axis=1) के बुनियादी उपयोग का उदाहरण है।
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldआप DataFrame मानों को लूप में संशोधित करने के लिए रो इटरेशन विधियों का उपयोग कर सकते हैं; हालांकि, बड़े डेटासेट्स पर यह तरीका कुशल नहीं है।
निम्न उदाहरण दिखाते हैं कि इसे कैसे लागू किया जाता है।
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()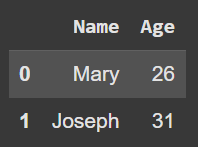
बड़े DataFrames पर काम करते समय, प्रदर्शन बढ़ाने के लिए वेक्टराइज़्ड ऑपरेशन का उपयोग करें, जैसा कि नीचे दिखाया गया है।
# Better approach using a vectorized method
students["age"] = students["age"] + 1केवल विशिष्ट पंक्तियों को प्रोसेस करने के लिए, लूप के अंदर कंडीशनल चेक का उपयोग करें। नीचे के उदाहरण में age 25 से अधिक होने पर पंक्तियां प्रिंट की जाती हैं।
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25हालांकि नीचे दिया गया वेक्टराइज़्ड विकल्प बेहतर और अधिक परफॉर्मेंट है।
students_greater_than_5 = students[students["age"] > 25]रो-वार प्रोसेसिंग के दौरान सारांश सांख्यिकी निकालना संभव है; हालांकि, Pandas .sum() और .mean() जैसे बिल्ट-इन तरीकों की पेशकश करता है जो तेज हैं।
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Pandas में रो इटरेशन करते समय, उपलब्ध विभिन्न तरीकों के बीच के ट्रेड-ऑफ को समझना आवश्यक है।
छोटे डेटासेट और सरल समाधान की आवश्यकता हो तो .iterrows() का उपयोग करें, और तेज विकल्प व बेहतर परफॉर्मेंस के लिए .itertuples() अपनाएं।
जहां भी संभव हो, खासकर बड़े डेटासेट्स के साथ, वेक्टराइज़्ड ऑपरेशंस को अपनी पहली पसंद बनाएं—वे अपने C-आधारित इम्प्लीमेंटेशंस के कारण तेज़ और अधिक कुशल हैं।
जब कोई ऑपरेशन आसानी से वेक्टराइज़ न हो पाए, तब .apply() रो-या कॉलम-वार लॉजिक के लिए मध्य रास्ता प्रदान करता है।
Pandas के बारे में और जानने के लिए हमारे ये संसाधन देखें:
अपनी लर्निंग तेज़ करने के लिए हमारे ये कोर्स पेज भी देखें:
DataCamp के साथ Python सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें