Corso
Manipolazione dei dati con pandas
4 ore
566K
Quando devi eseguire operazioni su un DataFrame pandas riga per riga, devi usare l’iterazione sulle righe. Anche se pandas è ottimizzato per operazioni vettorializzate, le iterazioni per riga sono essenziali quando applichi logiche non vettorializzate, soprattutto in manipolazioni complesse dei dati o nell’elaborazione condizionale delle righe.
Esistono vari metodi che puoi applicare a un DataFrame pandas per eseguire iterazioni sulle righe.
.iterrows(): Usalo per semplici operazioni per riga, quando servono indice e dati della riga. Restituisce coppie indice–Series; può essere lento per dataframe grandi e non è adatto a calcoli pesanti.
.itertuples(): Usalo come alternativa più veloce a .iterrows(), soprattutto quando non ti serve una Series di pandas. Restituisce un namedtuple con i valori della riga ed è più efficiente in memoria di .iterrows().
.apply(axis=1): Applica una funzione a ogni riga, di solito con l’argomento axis = 1. È più lento dei metodi vettorializzati, ma spesso più veloce di cicli espliciti.
Sebbene pandas sia progettato per funzionare al meglio con operazioni basate sulle colonne, vari metodi Python facilitano l’iterazione riga per riga, soprattutto quando lavori con singole righe.
Pandas lavora con i DataFrame in formato colonnare, il che lo rende efficiente nell’applicare trasformazioni alle colonne del DataFrame simultaneamente.
Questo è anche uno dei motivi per cui le operazioni vettorializzate sono efficienti in pandas e sono di solito preferite alle iterazioni per riga, che possono diventare lente con DataFrame di grandi dimensioni.
I principali metodi di iterazione per riga sono i seguenti:
.iterrows(): Restituisce ogni riga come tupla (index, Series).
.itertuples(): Più veloce di .iterrows() e restituisce ogni riga come namedtuple.
.items(): Non è un’iterazione per riga, ma itera sulle colonne di un DataFrame pandas, restituendo l’etichetta della colonna e la Series; di solito usato per operazioni per colonna.
In base a benchmark su DataFrame di dimensioni medio-grandi con 100.000 righe, .itertuples() è 5–10 volte più veloce di .iterrows() in termini di velocità ed efficienza di memoria. Questo perché .itertuples() evita di creare oggetti Series per ogni riga e al loro posto produce namedtuple leggeri.
Le operazioni vettorializzate sono più veloci di qualsiasi forma di iterazione perché sono implementate in codice C ottimizzato. Eliminano i cicli a livello Python, riducendo l’overhead. Per esempio, sommare due colonne con datacamp_rows[“A”] + è più veloce che usare un ciclo datacamp_rows[“B”]for con .iterrows().
.iterrows() ha un’impronta di memoria elevata perché restituisce un oggetto Series completo per ogni riga, e queste Series possono soffrire di inconsistenze di dtype dato che derivano da colonne diverse con tipi differenti.
Per dataset più piccoli è consigliabile usare .iterrows(), mentre per dataset più grandi puoi usare .itertuples().
Potresti trovarti in situazioni in cui non puoi applicare operazioni vettorializzate e devi ripiegare sull’iterazione per riga. In questa sezione vedrai quando usare e quando evitare le iterazioni per riga.
Gli scenari tipici per le iterazioni per riga includono:
Nonostante i casi d’uso, in alcuni casi dovresti evitare le iterazioni per riga, ad esempio:
Invece di iterare, considera le seguenti alternative:
Usa operazioni vettorializzate quando possibile.
Sfrutta .apply() con funzioni ottimizzate per compiti complessi ma ancora vettorializzabili.
Valuta l’elaborazione in batch o la parallelizzazione se devi iterare ma hai vincoli di prestazioni.
Evita i seguenti errori comuni dei cicli per riga, come:
.iterrows() restituisce una copia, non un riferimento alla riga originale; quindi modificarla non cambia il DataFrame originale.
È più difficile da leggere e mantenere rispetto alle operazioni vettorializzate.
Puoi implementare l’iterazione per riga nei DataFrame pandas usando vari metodi, a seconda del tuo caso d’uso o della natura del DataFrame. Ecco i metodi per iterare sulle righe dei DataFrame pandas.
Il metodo .iterrows() prevede l’iterazione sulle singole righe di un DataFrame. La sintassi è la seguente:
for index, row in datacamp_rows.iterrows():
	# code to process each row
Dove datacamp_rows è il dataframe iterato, index è l’indice della riga e row è la Series di pandas che contiene i dati della riga.
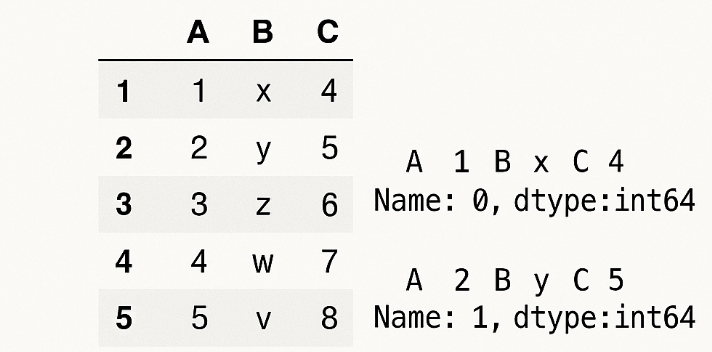
Ecco un esempio di utilizzo di base:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30Il metodo .iterrows() restituisce un generatore che produce l’indice di una riga insieme a un oggetto Series che rappresenta la riga. Le chiavi di questa Series sono i nomi delle colonne e i valori sono i dati corrispondenti in ciascuna riga.
Internamente, questo è ciò che restituisce .iterrows().
(index_0, Series_0)
(index_1, Series_1).itertuples() è più veloce e più efficiente in memoria di .iterrows() e restituisce ogni riga come namedtuple, consentendo di accedere ai valori delle colonne con la dot notation. La sintassi è la seguente:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
Dove index=True include l’indice del DataFrame come primo elemento di ogni tupla e name="Pandas" imposta il nome della classe namedtuple restituita. Se name=None, il ciclo for restituisce una tupla regolare senza accesso ai suoi attributi.
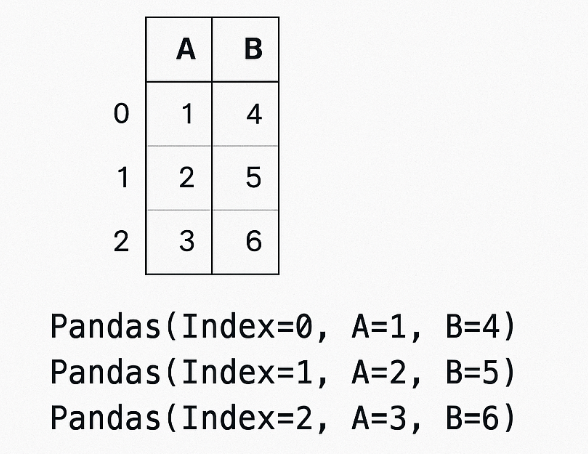
Ecco un esempio pratico di come funziona .itertuples():
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() restituisce un generatore che produce namedtuple, in cui ogni riga è rappresentata come un oggetto leggero.
Puoi accedere a ciascun campo della riga con la dot notation, come row.Name e row.age, preceduti dall’indice.
Internamente, questo è ciò che restituisce:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)Il metodo .apply() in pandas è utile quando si applicano funzioni alle righe per eseguire iterazioni per riga, come quando si usa l’argomento axis=1. La sintassi è la seguente:
df.apply(func, axis=1)Dove la funzione da applicare alla riga è func, mentre si imposta l’argomento axis=1.
Ecco un esempio pratico che ne illustra l’applicazione.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()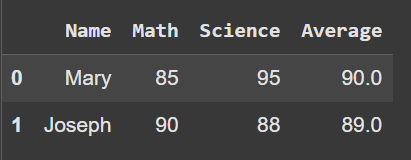
Usa il metodo .apply() quando crei nuove colonne a partire da quelle esistenti o quando applichi calcoli o trasformazioni personalizzate.
In termini di iterazione per riga, puoi usarlo per creare logiche condizionali per riga, come istruzioni if-else. Quando axis=1 è impostato, la funzione riceve la riga come Series con i nomi delle colonne come indici. Questa funzione elabora le righe e restituisce un valore scalare in una nuova colonna o una Series su più colonne.
Sebbene .apply(axis=1) sia più lento delle operazioni vettorializzate, è più veloce e più pulito di .iterrows().
Un’altra soluzione per le iterazioni per riga è usare manualmente .loc[] o .iloc[] con cicli for per iterare su un DataFrame pandas.
Questo funziona in modo simile ai metodi .iterrows() o .itertuples(). Un vantaggio di questo approccio è che ottieni il controllo completo sulle righe. La sintassi è la seguente:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Ecco un esempio pratico che mostra come viene implementato.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Uno dei casi d’uso per questo metodo di iterazione per riga è quando ti serve un controllo preciso sull’ordine delle righe o quando scrivi una logica passo-passo per il debug. Sebbene questo approccio diventi inefficiente per dataframe grandi, è anche più lento delle operazioni vettorializzate.
È fondamentale usare .loc[] quando ti serve una ricerca basata sulle etichette o .iloc[] quando ti serve un accesso basato sulla posizione, soprattutto con cicli basati su range.
Ecco una tabella che riassume le differenze tra i tre metodi.
|
Caratteristiche |
iterows() |
itertuples() |
apply(axis=1) |
|
Sintassi |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Output |
(index, Series) |
namedtuple |
Restituisce il valore della funzione (scalare o Series) |
|
Velocità |
Lenta |
Più veloce |
Moderata |
|
Uso di memoria |
Medio |
Basso |
Medio |
|
Leggibilità |
Moderata |
Alta |
Alta |
|
Migliori casi d’uso |
Prototipazione rapida o debug |
Dataset grandi |
Derivazione di colonne |
|
Limitazioni |
Più lenta |
Non gestisce logiche di riga complesse |
Più lenta della piena vettorializzazione |
Sebbene .iterrows() sia un modo semplice per iterare sulle righe di un DataFrame pandas, presenta limitazioni che possono incidere sulle prestazioni.
L’iterazione con .iterrows() produce ogni riga di un DataFrame come una tupla contenente l’indice della riga, ovvero la tabella, e un oggetto Series che contiene i dati della riga.
Nonostante la semplicità, ha uno svantaggio in termini di conversione dei dtype; ad esempio, converte gli interi in float se la Series deve accogliere tipi misti, il che può portare a bug sottili nei calcoli o nei confronti.
Inoltre, poiché .iterrows() restituisce una Series per ogni riga, ciò comporta un overhead di memoria che rallenta le prestazioni rispetto alle operazioni vettorializzate.
La modifica dei dati all’interno di un ciclo usando .iterrows() è sconsigliata, poiché le modifiche alla Series non si propagano al dataframe.
Nonostante le limitazioni sopra, .iterrows() resta utile in alcuni scenari, come:
.iterrows() per operazioni non vettorializzabili, come chiamate API, scrittura su file o interazione con database riga per riga..iterrows().Per mantenere la coerenza dei dtype, valuta il passaggio a .itertuples(), che restituisce namedtuple senza conversioni di tipo.
.itertuples() è più veloce e più efficiente in memoria di .iterrows() perché restituisce un namedtuple. Vediamo come alcune sue caratteristiche lo rendono superiore a .iterrows().
Alcuni dei vantaggi di .itertuples() includono:
Guadagni prestazionali: invece di creare oggetti Series come .iterrows(), che consumano memoria e riducono le prestazioni, .itertuples() evita l’overhead di memoria e migliora le prestazioni usando un generatore che produce namedtuple.
Personalizzazione: L’argomento index=False in .itertuples() omette l’indice dalla tupla e impostare name='Custom' consente di definire un nome personalizzato per la classe namedtuple, migliorando la leggibilità o l’integrazione con altri sistemi.
Quando usi .itertuples(), è importante conoscere le seguenti limitazioni.
Vincoli sui nomi delle colonne: nomi di colonna con caratteri speciali o spazi possono risultare in identificatori Python non validi. Questi vengono modificati in nomi validi oppure si accede ai valori con unpacking basato sugli indici della tupla.
Immutabilità: i namedtuple sono immutabili, quindi non puoi modificarne i valori in-place. Questo implica che qualsiasi trasformazione richiede di costruire una nuova struttura o raccogliere i valori desiderati in una lista o in un dataframe separato.
Ecco alcune buone pratiche da seguire quando usi .itertuples():
Sebbene i metodi principali per l’iterazione per riga siano .iterrows() e .itertuples(), pandas offre altre alternative più efficienti per la manipolazione su larga scala, come la vettorializzazione, che è più veloce ed efficiente in memoria.
Le operazioni vettorializzate applicano operazioni su interi array o colonne del DataFrame in una volta sola, sfruttando ottimizzazioni di basso livello in NumPy e pandas. Sono più pulite e leggibili e riducono drasticamente i tempi di esecuzione.
Di seguito alcune tecniche comuni di vettorializzazione ed esempi:
Operazioni aritmetiche: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Logiche condizionali: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Metodi per stringhe: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Manipolazioni datetime: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Le operazioni vettorializzate sono supportate da codice C compilato e gestione della memoria ottimizzata, superando spesso i cicli Python di ordini di grandezza, soprattutto per DataFrame grandi.
Quando implementi logiche per riga, è consigliabile usare il metodo .apply(axis=1). Anche se non è veloce quanto la vettorializzazione, è più efficiente ed espressivo dell’iterazione per riga. .apply() a volte è lento su DataFrame grandi perché internamente itera comunque in C. Tuttavia, è gestibile per logiche moderatamente complesse.
Ci sono vari strumenti che puoi considerare per ottimizzare .apply(), come:
Swifter: decide automaticamente i metodi più veloci per eseguire .apply().
Pandarallel: consente di eseguire facilmente in parallelo .apply() su più core CPU con una sola riga di codice.
Numba: è un compilatore JIT che accelera funzioni numeriche Python. Usandolo dentro .apply() può ridurre drasticamente i tempi di calcolo per operazioni numericamente intensive.
Una strategia potente in pandas è creare colonne temporanee per scomporre operazioni complesse in passaggi vettorializzati gestibili, evitando la necessità di un’iterazione esplicita riga per riga.
Esistono varie strategie di ottimizzazione e benchmark comparativi da esplorare per garantire una gestione scalabile ed efficiente della memoria, soprattutto con dataset grandi.
Diversi metodi di iterazione in Python possono avere prestazioni differenti. Ad esempio, i cicli for e while, quando usati insieme a metodi di pandas come .itertuples() e .iterrows(), sono significativamente più lenti delle operazioni vettorializzate.
I benchmark mostrano tipicamente che .itertuples() è più veloce e più efficiente in memoria di .iterrows() perché restituisce namedtuple invece di Series. Le operazioni vettorializzate superano tutte le altre forme di iterazione grazie alle implementazioni sottostanti in C.
Quando i dati crescono fino a milioni di righe, queste differenze diventano critiche, poiché metodi inefficienti possono creare colli di bottiglia e aumentare il consumo di memoria.
Per dataset più grandi, considera alcune di queste tecniche:
Elaborazione a chunk: usa il parametro chunksize in .read_csv() per elaborare i dati in blocchi gestibili invece di caricare tutto in memoria in una volta sola.
Ottimizzazione dei dtype: prova tipi di dato diversi, come float32 invece di float64, per ridurre l’uso di memoria.
Gestione della memoria: elimina presto le colonne inutilizzate, filtra i dati prima del merge e libera periodicamente memoria con gc.collect().
Calcolo out-of-core: usa strumenti come Dask e Vaex per abilitare calcoli paralleli out-of-core su dataset che superano la capacità di memoria.
Ci sono vari scenari in cui l’iterazione torna utile. Ecco alcuni esempi pratici che mostrano pattern comuni di iterazione e buone pratiche quando lavori con pandas.
Ecco un esempio che mostra l’uso di base di .iterrows(), .itertuples() e .apply(axis=1).
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldPuoi usare i metodi di iterazione per riga per modificare i valori di un DataFrame in un ciclo; tuttavia, questo approccio non è efficiente con dataset grandi.
Gli esempi seguenti mostrano come implementarlo.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()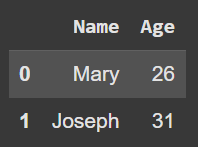
Quando lavori con dataframe grandi, considera l’uso di un’operazione vettorializzata per aumentare le prestazioni, come mostrato nell’esempio seguente.
# Better approach using a vectorized method
students["age"] = students["age"] + 1Per elaborare solo righe specifiche, valuta di usare un controllo condizionale all’interno del ciclo, come nel seguente esempio, in cui vengono stampate le righe con age maggiore di 25.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Anche se l’opzione vettorializzata qui sotto è migliore e più performante.
students_greater_than_5 = students[students["age"] > 25]È possibile anche calcolare statistiche di sintesi durante l’elaborazione riga per riga; tuttavia, pandas offre metodi integrati come .sum() e .mean(), che sono più veloci.
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Quando esegui iterazioni per riga in pandas, è essenziale capire i compromessi tra i diversi metodi disponibili.
Usa .iterrows() quando ti serve una soluzione semplice e non stai lavorando con un dataset grande, e .itertuples() quando ti serve un’alternativa più veloce e prestazioni migliori.
Scegli sempre le operazioni vettorializzate come prima opzione quando applicabili, soprattutto con dataset grandi, poiché sono più veloci ed efficienti grazie alle operazioni sottostanti in C.
Usa .apply() come via di mezzo quando serve un’operazione per riga o per colonna che non è facilmente vettorializzabile.
Ecco alcune nostre risorse per imparare meglio pandas:
Puoi anche consultare le seguenti pagine dei corsi per accelerare il tuo apprendimento:
Impara Python con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



